设计数据密集型应用(第二版)
设计数据密集型应用(第二版)
- 作者:Martin Kleppmann
- 译者:冯若航 / Vonng 与 DDIA 中文翻译贡献者
- 原作:Designing Data-Intensive Applications, Second Edition
不懂数据库的全栈工程师不是好架构师。
—— 冯若航 / Vonng
本书从数据模型与存储引擎出发,逐步进入复制、分片、事务、一致性、批处理与流处理,最后回到技术责任与社会影响。它关注的不是某一款产品,而是设计、实现和评价现代数据系统时可以反复使用的思维框架。
第二版中文译文按原书十四章持续校订。在线版本提供章节树导航、稳定图表编号与交叉引用、全文搜索、顺序阅读、整书打印以及适合工具读取的 Markdown / llms.txt 输出。
阅读本书
出版与授权说明
本译文仅供学习研究参考,不追求任何经济利益,不得公开传播发行或用于商业用途。译者保留译文署名权,其他权利以原作者与出版社的主张为准。有能力阅读英文的读者请购买正版支持作者与出版社。
序言
如果近几年从业于软件工程,特别是服务器端和后端系统开发,那么你很有可能已经被大量关于数据存储和处理的时髦词汇轰炸过了: NoSQL!大数据!Web-Scale!分片!最终一致性!ACID!CAP 定理!云服务!MapReduce!实时!
在最近十年中,我们看到了很多有趣的进展,关于数据库,分布式系统,以及在此基础上构建应用程序的方式。这些进展有着各种各样的驱动力:
- 谷歌、雅虎、亚马逊、脸书、领英、微软和推特等互联网公司正在和巨大的流量 / 数据打交道,这迫使他们去创造能有效应对如此规模的新工具。
- 企业需要变得敏捷,需要低成本地检验假设,需要通过缩短开发周期和保持数据模型的灵活性,快速地响应新的市场洞察。
- 免费和开源软件变得非常成功,在许多环境中比商业软件和定制软件更受欢迎。
- 处理器主频几乎没有增长,但是多核处理器已经成为标配,网络也越来越快。这意味着并行化程度只增不减。
- 即使你在一个小团队中工作,现在也可以构建分布在多台计算机甚至多个地理区域的系统,这要归功于譬如亚马逊网络服务(AWS)等基础设施即服务(IaaS)概念的践行者。
- 许多服务都要求高可用,因停电或维护导致的服务不可用,变得越来越难以接受。
数据密集型应用(data-intensive applications) 正在通过使用这些技术进步来推动可能性的边界。一个应用被称为 数据密集型 的,如果 数据是其主要挑战(数据量,数据复杂度或数据变化速度)—— 与之相对的是 计算密集型,即处理器速度是其瓶颈。
帮助数据密集型应用存储和处理数据的工具与技术,正迅速地适应这些变化。新型数据库系统(“NoSQL”)已经备受关注,而消息队列,缓存,搜索索引,批处理和流处理框架以及相关技术也非常重要。很多应用组合使用这些工具与技术。
这些生意盎然的时髦词汇体现出人们对新的可能性的热情,这是一件好事。但是作为软件工程师和架构师,如果要开发优秀的应用,我们还需要对各种层出不穷的技术及其利弊权衡有精准的技术理解。为了获得这种洞察,我们需要深挖时髦词汇背后的内容。
幸运的是,在技术迅速变化的背后总是存在一些持续成立的原则,无论你使用了特定工具的哪个版本。如果你理解了这些原则,就可以领会这些工具的适用场景,如何充分利用它们,以及如何避免其中的陷阱。这正是本书的初衷。
本书的目标是帮助你在飞速变化的数据处理和数据存储技术大观园中找到方向。本书并不是某个特定工具的教程,也不是一本充满枯燥理论的教科书。相反,我们将看到一些成功数据系统的样例:许多流行应用每天都要在生产中满足可伸缩性、性能、以及可靠性的要求,而这些技术构成了这些应用的基础。
我们将深入这些系统的内部,理清它们的关键算法,讨论背后的原则和它们必须做出的权衡。在这个过程中,我们将尝试寻找 思考 数据系统的有效方式 —— 不仅关于它们 如何 工作,还包括它们 为什么 以这种方式工作,以及哪些问题是我们需要问的。
阅读本书后,你能很好地决定哪种技术适合哪种用途,并了解如何将工具组合起来,为一个良好应用架构奠定基础。本书并不足以使你从头开始构建自己的数据库存储引擎,不过幸运的是这基本上很少有必要。你将获得对系统底层发生事情的敏锐直觉,这样你就有能力推理它们的行为,做出优秀的设计决策,并追踪任何可能出现的问题。
本书的目标读者
如果你开发的应用具有用于存储或处理数据的某种服务器 / 后端系统,而且使用网络(例如,Web 应用、移动应用或连接到互联网的传感器),那么本书就是为你准备的。
本书是为软件工程师,软件架构师,以及喜欢写代码的技术经理准备的。如果你需要对所从事系统的架构做出决策 —— 例如你需要选择解决某个特定问题的工具,并找出如何最好地使用这些工具,那么这本书对你尤有价值。但即使你无法选择你的工具,本书仍将帮助你更好地了解所使用工具的长处和短处。
你应当具有一些开发 Web 应用或网络服务的经验,且应当熟悉关系型数据库和 SQL。任何你了解的非关系型数据库和其他与数据相关工具都会有所帮助,但不是必需的。对常见网络协议如 TCP 和 HTTP 的大概理解是有帮助的。编程语言或框架的选择对阅读本书没有任何不同影响。
如果以下任意一条对你为真,你会发现这本书很有价值:
- 你想了解如何使数据系统可伸缩,例如,支持拥有数百万用户的 Web 或移动应用。
- 你需要提高应用程序的可用性(最大限度地减少停机时间),保持稳定运行。
- 你正在寻找使系统在长期运行过程易于维护的方法,即使系统规模增长,需求与技术也发生变化。
- 你对事物的运作方式有着天然的好奇心,并且希望知道一些主流网站和在线服务背后发生的事情。这本书打破了各种数据库和数据处理系统的内幕,探索这些系统设计中的智慧是非常有趣的。
有时在讨论可伸缩的数据系统时,人们会说:“你又不在谷歌或亚马逊,别操心可伸缩性了,直接上关系型数据库”。这个陈述有一定的道理:为了不必要的伸缩性而设计程序,不仅会浪费不必要的精力,并且可能会把你锁死在一个不灵活的设计中。实际上这是一种 “过早优化” 的形式。不过,选择合适的工具确实很重要,而不同的技术各有优缺点。我们将看到,关系数据库虽然很重要,但绝不是数据处理的终章。
本书涉及的领域
本书并不会尝试告诉读者如何安装或使用特定的软件包或 API,因为已经有大量文档给出了详细的使用说明。相反,我们会讨论数据系统的基础 —— 各种原则与利弊权衡,并探讨了不同产品所做出的不同设计决策。
在电子书中包含了在线资源全文的链接。所有链接在出版时都进行了验证,但不幸的是,由于网络的自然规律,链接往往会频繁地破损。如果你遇到链接断开的情况,或者正在阅读本书的打印副本,可以使用搜索引擎查找参考文献。对于学术论文,你可以在 Google 学术中搜索标题,查找可以公开获取的 PDF 文件。或者,你也可以在 https://github.com/ept/ddia-references 中找到所有的参考资料,我们在那儿维护最新的链接。
我们主要关注的是数据系统的 架构(architecture),以及它们被集成到数据密集型应用中的方式。本书没有足够的空间覆盖部署、运维、安全、管理等领域 —— 这些都是复杂而重要的主题,仅仅在本书中用粗略的注解讨论这些对它们很不公平。每个领域都值得用单独的书去讲。
本书中描述的许多技术都被涵盖在 大数据(Big Data) 这个时髦词的范畴中。然而 “大数据” 这个术语被滥用,缺乏明确定义,以至于在严肃的工程讨论中没有用处。这本书使用歧义更小的术语,如 “单节点” 之于 “分布式系统”,或 “在线 / 交互式系统” 之于 “离线 / 批处理系统”。
本书对 自由和开源软件(FOSS) 有一定偏好,因为阅读、修改和执行源码是了解某事物详细工作原理的好方法。开放的平台也可以降低供应商垄断的风险。然而在适当的情况下,我们也会讨论专利软件(闭源软件,软件即服务 SaaS,或一些在文献中描述过但未公开发行的公司内部软件)。
本书纲要
本书分为三部分:
在 第一部分 中,我们会讨论设计数据密集型应用所赖的基本思想。我们从 第一章 开始,讨论我们实际要达到的目标:可靠性、可伸缩性和可维护性;我们该如何思考这些概念;以及如何实现它们。在 第二章 中,我们比较了几种不同的数据模型和查询语言,看看它们如何适用于不同的场景。在 第三章 中将讨论存储引擎:数据库如何在磁盘上摆放数据,以便能高效地再次找到它。第四章 转向数据编码(序列化),以及随时间演化的模式。
在 第二部分 中,我们从讨论存储在一台机器上的数据转向讨论分布在多台机器上的数据。这对于可伸缩性通常是必需的,但带来了各种独特的挑战。我们首先讨论复制(第五章)、分区 / 分片(第六章)和事务(第七章)。然后我们将探索关于分布式系统问题的更多细节(第八章),以及在分布式系统中实现一致性与共识意味着什么(第九章)。
在 第三部分 中,我们讨论那些从其他数据集派生出一些数据集的系统。派生数据经常出现在异构系统中:当没有单个数据库可以把所有事情都做的很好时,应用需要集成几种不同的数据库、缓存、索引等。在 第十章 中我们将从一种派生数据的批处理方法开始,然后在此基础上建立在 第十一章 中讨论的流处理。最后,在 第十二章 中,我们将所有内容汇总,讨论在将来构建可靠、可伸缩和可维护的应用程序的方法。
参考文献与延伸阅读
本书中讨论的大部分内容已经在其它地方以某种形式出现过了 —— 会议演示文稿、研究论文、博客文章、代码、BUG 跟踪器、邮件列表以及工程习惯中。本书总结了不同来源资料中最重要的想法,并在文本中包含了指向原始文献的链接。如果你想更深入地探索一个领域,那么每章末尾的参考文献都是很好的资源,其中大部分可以免费在线获取。
O‘Reilly Safari
Safari (formerly Safari Books Online) is a membership-based training and reference platform for enterprise, government, educators, and individuals.
Members have access to thousands of books, training videos, Learning Paths, interac‐ tive tutorials, and curated playlists from over 250 publishers, including O’Reilly Media, Harvard Business Review, Prentice Hall Professional, Addison-Wesley Pro‐ fessional, Microsoft Press, Sams, Que, Peachpit Press, Adobe, Focal Press, Cisco Press, John Wiley & Sons, Syngress, Morgan Kaufmann, IBM Redbooks, Packt, Adobe Press, FT Press, Apress, Manning, New Riders, McGraw-Hill, Jones & Bartlett, and Course Technology, among others.
For more information, please visit http://oreilly.com/safari.
联系我们
有关本书的评论和问题,请联系出版社:
O’Reilly Media, Inc.
1005 Gravenstein Highway North
Sebastopol, CA 95472
800-998-9938(美国或加拿大)
707-829-0515(国际或本地)
707-829-0104(传真)
我们为本书提供了网页,会在上面列出勘误、示例以及任何补充信息。你可以访问:http://bit.ly/designing-data-intensive-apps。
如需发表评论或提出技术问题,请发送邮件至:bookquestions@oreilly.com。
有关 O’Reilly 图书、课程、会议和新闻的更多信息,请访问:http://www.oreilly.com。
- Facebook: http://facebook.com/oreilly
- Twitter: http://twitter.com/oreillymedia
- YouTube: http://www.youtube.com/oreillymedia
致谢
本书融合了学术研究和工业实践的经验,融合并系统化了大量其他人的想法与知识。在计算领域,我们往往会被各种新鲜花样所吸引,但我认为前人完成的工作中,有太多值得我们学习的地方了。本书有 800 多处引用:文章、博客、讲座、文档等,对我来说这些都是宝贵的学习资源。我非常感谢这些材料的作者分享他们的知识。
我也从与人交流中学到了很多东西,很多人花费了宝贵的时间与我讨论想法并耐心解释。特别感谢 Joe Adler, Ross Anderson, Peter Bailis, Márton Balassi, Alastair Beresford, Mark Callaghan, Mat Clayton, Patrick Collison, Sean Cribbs, Shirshanka Das, Niklas Ekström, Stephan Ewen, Alan Fekete, Gyula Fóra, Camille Fournier, Andres Freund, John Garbutt, Seth Gilbert, Tom Haggett, Pat Hel‐ land, Joe Hellerstein, Jakob Homan, Heidi Howard, John Hugg, Julian Hyde, Conrad Irwin, Evan Jones, Flavio Junqueira, Jessica Kerr, Kyle Kingsbury, Jay Kreps, Carl Lerche, Nicolas Liochon, Steve Loughran, Lee Mallabone, Nathan Marz, Caitie McCaffrey, Josie McLellan, Christopher Meiklejohn, Ian Meyers, Neha Narkhede, Neha Narula, Cathy O’Neil, Onora O’Neill, Ludovic Orban, Zoran Perkov, Julia Powles, Chris Riccomini, Henry Robinson, David Rosenthal, Jennifer Rullmann, Matthew Sackman, Martin Scholl, Amit Sela, Gwen Shapira, Greg Spurrier, Sam Stokes, Ben Stopford, Tom Stuart, Diana Vasile, Rahul Vohra, Pete Warden, 以及 Brett Wooldridge.
更多人通过审阅草稿并提供反馈意见在本书的创作过程中做出了无价的贡献。我要特别感谢 Raul Agepati, Tyler Akidau, Mattias Andersson, Sasha Baranov, Veena Basavaraj, David Beyer, Jim Brikman, Paul Carey, Raul Castro Fernandez, Joseph Chow, Derek Elkins, Sam Elliott, Alexander Gallego, Mark Grover, Stu Halloway, Heidi Howard, Nicola Kleppmann, Stefan Kruppa, Bjorn Madsen, Sander Mak, Stefan Podkowinski, Phil Potter, Hamid Ramazani, Sam Stokes, 以及 Ben Summers。当然对于本书中的任何遗留错误或难以接受的见解,我都承担全部责任。
为了帮助这本书落地,并且耐心地处理我缓慢的写作和不寻常的要求,我要对编辑 Marie Beaugureau,Mike Loukides,Ann Spencer 和 O’Reilly 的所有团队表示感谢。我要感谢 Rachel Head 帮我找到了合适的术语。我要感谢 Alastair Beresford,Susan Goodhue,Neha Narkhede 和 Kevin Scott,在其他工作事务之外给了我充分地创作时间和自由。
特别感谢 Shabbir Diwan 和 Edie Freedman,他们非常用心地为各章配了地图。他们提出了不落俗套的灵感,创作了这些地图,美丽而引人入胜,真是太棒了。
最后我要表达对家人和朋友们的爱,没有他们,我将无法走完这个将近四年的写作历程。你们是最棒的。
I 数据系统基础
本书前五章介绍了数据系统底层的基础概念,无论是在单台机器上运行的单点数据系统,还是分布在多台机器上的分布式数据系统都适用。
- 第一章 将介绍 数据系统架构中的利弊权衡。我们将讨论不同类型的数据系统(例如,分析型与事务型),以及它们在云环境中的运行方式。
- 第二章 将介绍非功能性需求的定义。可靠性,可伸缩性和可维护性,这些词汇到底意味着什么?如何实现这些目标?
- 第三章 将对几种不同的 数据模型和查询语言 进行比较。从程序员的角度看,这是数据库之间最明显的区别。不同的数据模型适用于不同的应用场景。
- 第四章 将深入 存储引擎 内部,研究数据库如何在磁盘上摆放数据。不同的存储引擎针对不同的负载进行优化,选择合适的存储引擎对系统性能有巨大影响。
- 第五章 将对几种不同的 数据编码 进行比较。特别研究了这些格式在应用需求经常变化、模式需要随时间演变的环境中表现如何。
第二部分 将专门讨论在 分布式数据系统 中特有的问题。
1. 数据系统架构中的权衡
2. 定义非功能性需求
3. 数据模型与查询语言
4. 存储与检索
5. 编码与演化
1 数据系统架构中的权衡
没有解决方案,只有权衡取舍。[…] 你只能尽力做出最佳权衡,也只能期望如此。
Thomas Sowell,与 Fred Barnes 的访谈(2005 年)
如今,数据是许多应用开发的核心。随着 Web 应用、移动应用、软件即服务(SaaS)和云服务的普及,在共享的服务器端数据基础设施中存储众多用户的数据,已经司空见惯。用户活动、业务交易、设备和传感器产生的数据都需要保存下来,以供分析。用户与应用交互时,既会读取已存储的数据,也会产生更多数据。
少量数据可以在单台机器上存储和处理,通常比较容易应付。然而,随着数据量或查询速率增长,数据就需要分布到多台机器上,由此带来许多挑战。应用需求变得更加复杂之后,把所有数据放在一个系统里也不再够用,往往需要组合多个能力各异的存储或处理系统。
如果数据管理是开发应用时面临的主要挑战之一,我们就称这种应用为 数据密集型(data-intensive)应用 1。计算密集型(compute-intensive)系统的难点在于如何将某项极其庞大的计算并行化;而对数据密集型应用来说,我们通常更关心如何存储和处理海量数据、如何管理数据变更、如何在故障和并发面前保证一致性,以及如何维持服务的高可用性。
这类应用通常由一些标准构件搭建而成,它们提供各种常用功能。例如,许多应用都需要:
- 存储数据,以便自己或其他应用日后能够再次找到(数据库,database)
- 记住开销昂贵的操作结果,加快读取速度(缓存,cache)
- 允许用户按关键字搜索数据,或以各种方式过滤数据(搜索索引,search index)
- 在事件和数据变更发生后立即处理(流处理,stream processing)
- 定期处理累积的大批量数据(批处理,batch processing)
构建应用时,我们通常会选用几个软件系统或服务(例如数据库和 API),再用应用代码把它们拼接起来。如果你的用途恰好是这些数据系统原本就为之设计的,整个过程可能相当容易。
但是,随着应用要实现的目标越来越高,挑战也随之而来。数据库系统种类繁多,特性各异,适用目的也各不相同——该选择哪一种?缓存有不同的做法,搜索索引也有多种构建方式,诸如此类——该如何权衡?你必须判断哪些工具和方法最适合手头的任务;而当一项工作无法由单个工具独立完成时,把多个工具组合起来也可能很困难。
本书将帮助你决定采用哪些技术,以及如何组合这些技术。正如你将看到的,并不存在一种从根本上优于其他方案的做法;每种方案都有利有弊。本书会教你提出恰当的问题来评估和比较数据系统,从而找出最能满足特定应用需求的方案。
我们的旅程从当今组织使用数据的一些典型方式开始。这里的许多思想源自 企业软件(enterprise software),也就是大型组织(例如大公司和政府机构)的软件需求与工程实践。因为在过去,只有大型组织才拥有如此庞大的数据量,需要复杂的技术方案;只要数据量足够小,用电子表格保存就行了!不过近年来,小公司和初创企业管理海量数据、构建数据密集型系统,也已变得十分普遍。
数据系统的一项关键挑战是:不同的人需要用数据做截然不同的事情。在一家公司里,你和你的团队有自己的一套优先事项;另一个团队即使在处理同一份数据,也可能有完全不同的目标。而且,这些目标未必得到明确表达,因而很容易造成误解,并引发对正确方案的争论。
为了帮助你了解有哪些选择,本章将比较几组相对的概念,并探讨它们之间的权衡:
- 事务型系统与分析型系统有何区别(“分析型与事务型系统”);
- 云服务与自托管系统各有哪些利弊(“云服务与自托管”);
- 何时应当从单节点系统转向分布式系统(“分布式与单节点系统”);以及
- 如何在业务需求与用户权利之间取得平衡(“数据系统、法律与社会”)。
此外,本章还会提供阅读本书其余部分所需的术语。
本书讨论的许多内容都与 后端开发(backend development)有关。以 Web 应用为例,运行在浏览器中的客户端代码称为 前端(frontend),处理用户请求的服务器端代码则称为 后端(backend)。移动应用与前端相似:它们负责提供用户界面,并且常常经由互联网与服务器端后端通信。前端有时也会在用户设备上管理本地数据 2,但数据基础设施面临的最大挑战往往在后端:前端只需处理一个用户的数据,而后端要代表 所有 用户管理数据。
后端服务通常可以通过 HTTP(有时是 WebSocket)访问。它一般由一些应用代码组成:这些代码在一个或多个数据库中读写数据,有时也与缓存、消息队列等其他数据系统交互;这些系统可以统称为 数据基础设施(data infrastructure)。应用代码通常是 无状态(stateless)的,也就是说,处理完一个 HTTP 请求后,它就会忘掉有关该请求的一切。任何需要在请求之间持久保存的信息,都必须存放在客户端或服务器端的数据基础设施中。
分析型与事务型系统
如果你在企业中从事数据系统工作,很可能会遇到几类与数据打交道的人。第一类是 后端工程师(backend engineer),负责构建处理数据读取和更新请求的服务。这些服务通常直接面向外部用户,或通过其他服务间接为外部用户提供功能(参见“微服务与无服务器”);有时也只供组织内其他部门使用。
除了管理后端服务的团队,通常还有两类人需要访问组织的数据:业务分析师(business analyst)根据组织的活动生成报表,帮助管理层做出更好的决策,这就是 商业智能(BI);数据科学家(data scientist)则从数据中寻找新的洞见,或者利用数据分析和机器学习/AI 构建面向用户的产品功能,例如电商网站上“购买了 X 的人也购买了 Y”的推荐、风险评分或垃圾邮件过滤等预测分析,以及搜索结果排名。
业务分析师和数据科学家使用的工具不同,工作方式也不同,但仍有一些共同之处:两者都要进行 分析(analytics),也就是查看用户和后端服务产生的数据,但通常不会修改这些数据(纠正错误或许除外)。他们可能会创建衍生数据集,以某种方式处理原始数据。由此形成了两类相互分离的系统——本书将始终沿用这种区分:
- 事务型系统(operational system)由创建数据的后端服务和数据基础设施组成,例如直接为外部用户提供服务。应用代码根据用户执行的操作,读取和修改数据库中的数据。
- 分析型系统(analytical system)服务于业务分析师和数据科学家。它们保存事务型系统数据的只读副本,并针对分析所需的数据处理方式进行优化。
正如下一节将要说明的,事务型系统与分析型系统往往有充分的理由彼此分离。随着这两类系统日趋成熟,又出现了两个专业角色:数据工程师(data engineer)与 分析工程师(analytics engineer)。数据工程师懂得如何集成事务型系统和分析型系统,并对组织的数据基础设施承担更广泛的责任 3。分析工程师则对数据进行建模和转换,使其更便于组织内的业务分析师和数据科学家使用 4。
许多工程师专攻事务型或分析型系统中的一类。不过,本书会同时涵盖两者,因为它们都在组织的数据生命周期中扮演重要角色。我们将深入探讨为内部和外部用户提供服务所需的数据基础设施,帮助你更好地与分界线另一侧的同事合作。
事务处理与分析的特征
在商业数据处理的早期,每次写入数据库通常都对应一笔 商业交易:完成一笔销售、向供应商下订单、发放员工工资,等等。后来,数据库的应用扩展到不涉及金钱往来的领域,事务(transaction)这个名称却沿用下来,用来指构成一个逻辑单元的一组读写操作。
第 8 章会详细探讨“事务”的含义。本章则宽泛地用这个词指代低延迟的读写操作。
尽管数据库开始处理形形色色的数据——社交媒体帖子、游戏中的操作、地址簿联系人,等等——基本访问模式仍与处理商业交易相似。事务型系统通常按某个键查找少量记录(称为 点查询,point query),再根据用户输入插入、更新或删除记录。由于这些应用具有交互性,这种访问模式称为 联机事务处理(OLTP)。
与此同时,数据库也越来越多地用于分析,而分析的访问模式与 OLTP 大相径庭。分析查询通常会扫描海量记录,计算计数、总和或平均值等聚合统计量,而不是把一条条记录返回给用户。例如,连锁超市的业务分析师可能想回答下面的问题:
- 我们每家商店在一月份的总收入是多少?
- 在我们最近的促销期间,我们比平时多卖出了多少香蕉?
- 哪个品牌的婴儿食品最常与 X 品牌尿布一起购买?
这类查询产生的报表是商业智能的重要依据,可以帮助管理层决定下一步行动。为了把这种数据库使用模式与事务处理区分开来,人们称之为 联机分析处理(OLAP)5。OLTP 与分析之间的界线并不总是泾渭分明,但表 1-1列出了二者的一些典型特征。
| 属性 | 事务型系统(OLTP) | 分析型系统(OLAP) |
|---|---|---|
| 主要读取模式 | 点查询(按键读取单条记录) | 聚合大量记录 |
| 主要写入模式 | 创建、更新和删除单条记录 | 批量导入(ETL)或事件流 |
| 人类用户示例 | Web 或移动应用的最终用户 | 为决策提供支持的内部分析师 |
| 机器用途示例 | 检查某项操作是否获得授权 | 检测欺诈或滥用模式 |
| 查询类型 | 由应用预先定义的一组固定查询 | 分析师可以任意查询 |
| 数据表示的内容 | 数据的最新状态(当前时点) | 一段时间内发生的事件历史 |
| 数据集规模 | GB 至 TB | TB 至 PB |
OLAP 中的 联机(online)含义并不明确;它大概是指查询并非只用于预定义报表,分析师还会以交互方式使用 OLAP 系统进行探索性查询。
事务型系统一般不允许用户自行编写 SQL 查询并提交给数据库执行,否则用户可能读取或修改自己无权访问的数据。用户也可能写出执行开销很高的查询,影响其他用户使用数据库。因此,OLTP 系统主要执行写在应用代码中的一组固定查询,只在维护或排查故障时偶尔运行一次性自定义查询。分析数据库则不同:它通常允许用户自由手写任意 SQL 查询,也可以通过 Tableau、Looker 或 Microsoft Power BI 等数据可视化或仪表盘工具自动生成查询。
还有一类系统专为分析型负载(即聚合大量记录的查询)而设计,却嵌入在面向用户的产品中。这类用途称为 产品分析(product analytics)或 实时分析(real-time analytics),为此设计的系统包括 Pinot、Druid 和 ClickHouse 6。
数据仓库
起初,同一套数据库既用于事务处理,也用于分析查询。事实证明,SQL 在这方面非常灵活,两类查询都能胜任。不过到了 20 世纪 80 年代末和 90 年代初,企业开始不再使用 OLTP 系统进行分析,转而在一个独立的数据库系统上运行分析查询。这个独立的数据库称为 数据仓库(data warehouse)。
一家大型企业可能拥有几十乃至上百个联机事务处理系统:支撑面向客户的网站,控制实体店的销售终端(收银系统),跟踪仓库库存,规划车辆路线,管理供应商和员工,以及执行许多其他任务。每个系统都很复杂,都需要专门的团队维护,因此最终大多彼此独立运行。
通常不宜让业务分析师和数据科学家直接查询这些 OLTP 系统,原因有以下几点:
- 所需数据可能散落在多个事务型系统中,很难通过一条查询组合这些数据集;这个问题称为 数据孤岛(data silo)。
- 适合 OLTP 的模式和数据布局不太适合分析(参见“星型与雪花型:分析模式”)。
- 分析查询的开销可能很高;在 OLTP 数据库上运行它们,会影响其他用户的性能。
- 出于安全或合规方面的考虑,OLTP 系统可能位于一个不允许用户直接访问的独立网络中。
相比之下,数据仓库 是一个独立的数据库,分析师可以尽情查询,而不会影响 OLTP 系统的运行 7。正如第 4 章将要介绍的,数据仓库的存储方式往往与 OLTP 数据库截然不同,以便针对分析中常见的查询类型进行优化。
数据仓库保存着企业各个 OLTP 系统中数据的只读副本。数据先从 OLTP 数据库中抽取出来(通过定期转储或连续的更新流),再转换成便于分析的模式并加以清理,最后载入数据仓库。把数据送入数据仓库的这一过程称为 提取—转换—加载(ETL),如图 1-1所示。有时也会对调 转换 与 加载 两步的顺序,即先加载数据,再在数据仓库内转换;这便成了 ELT。
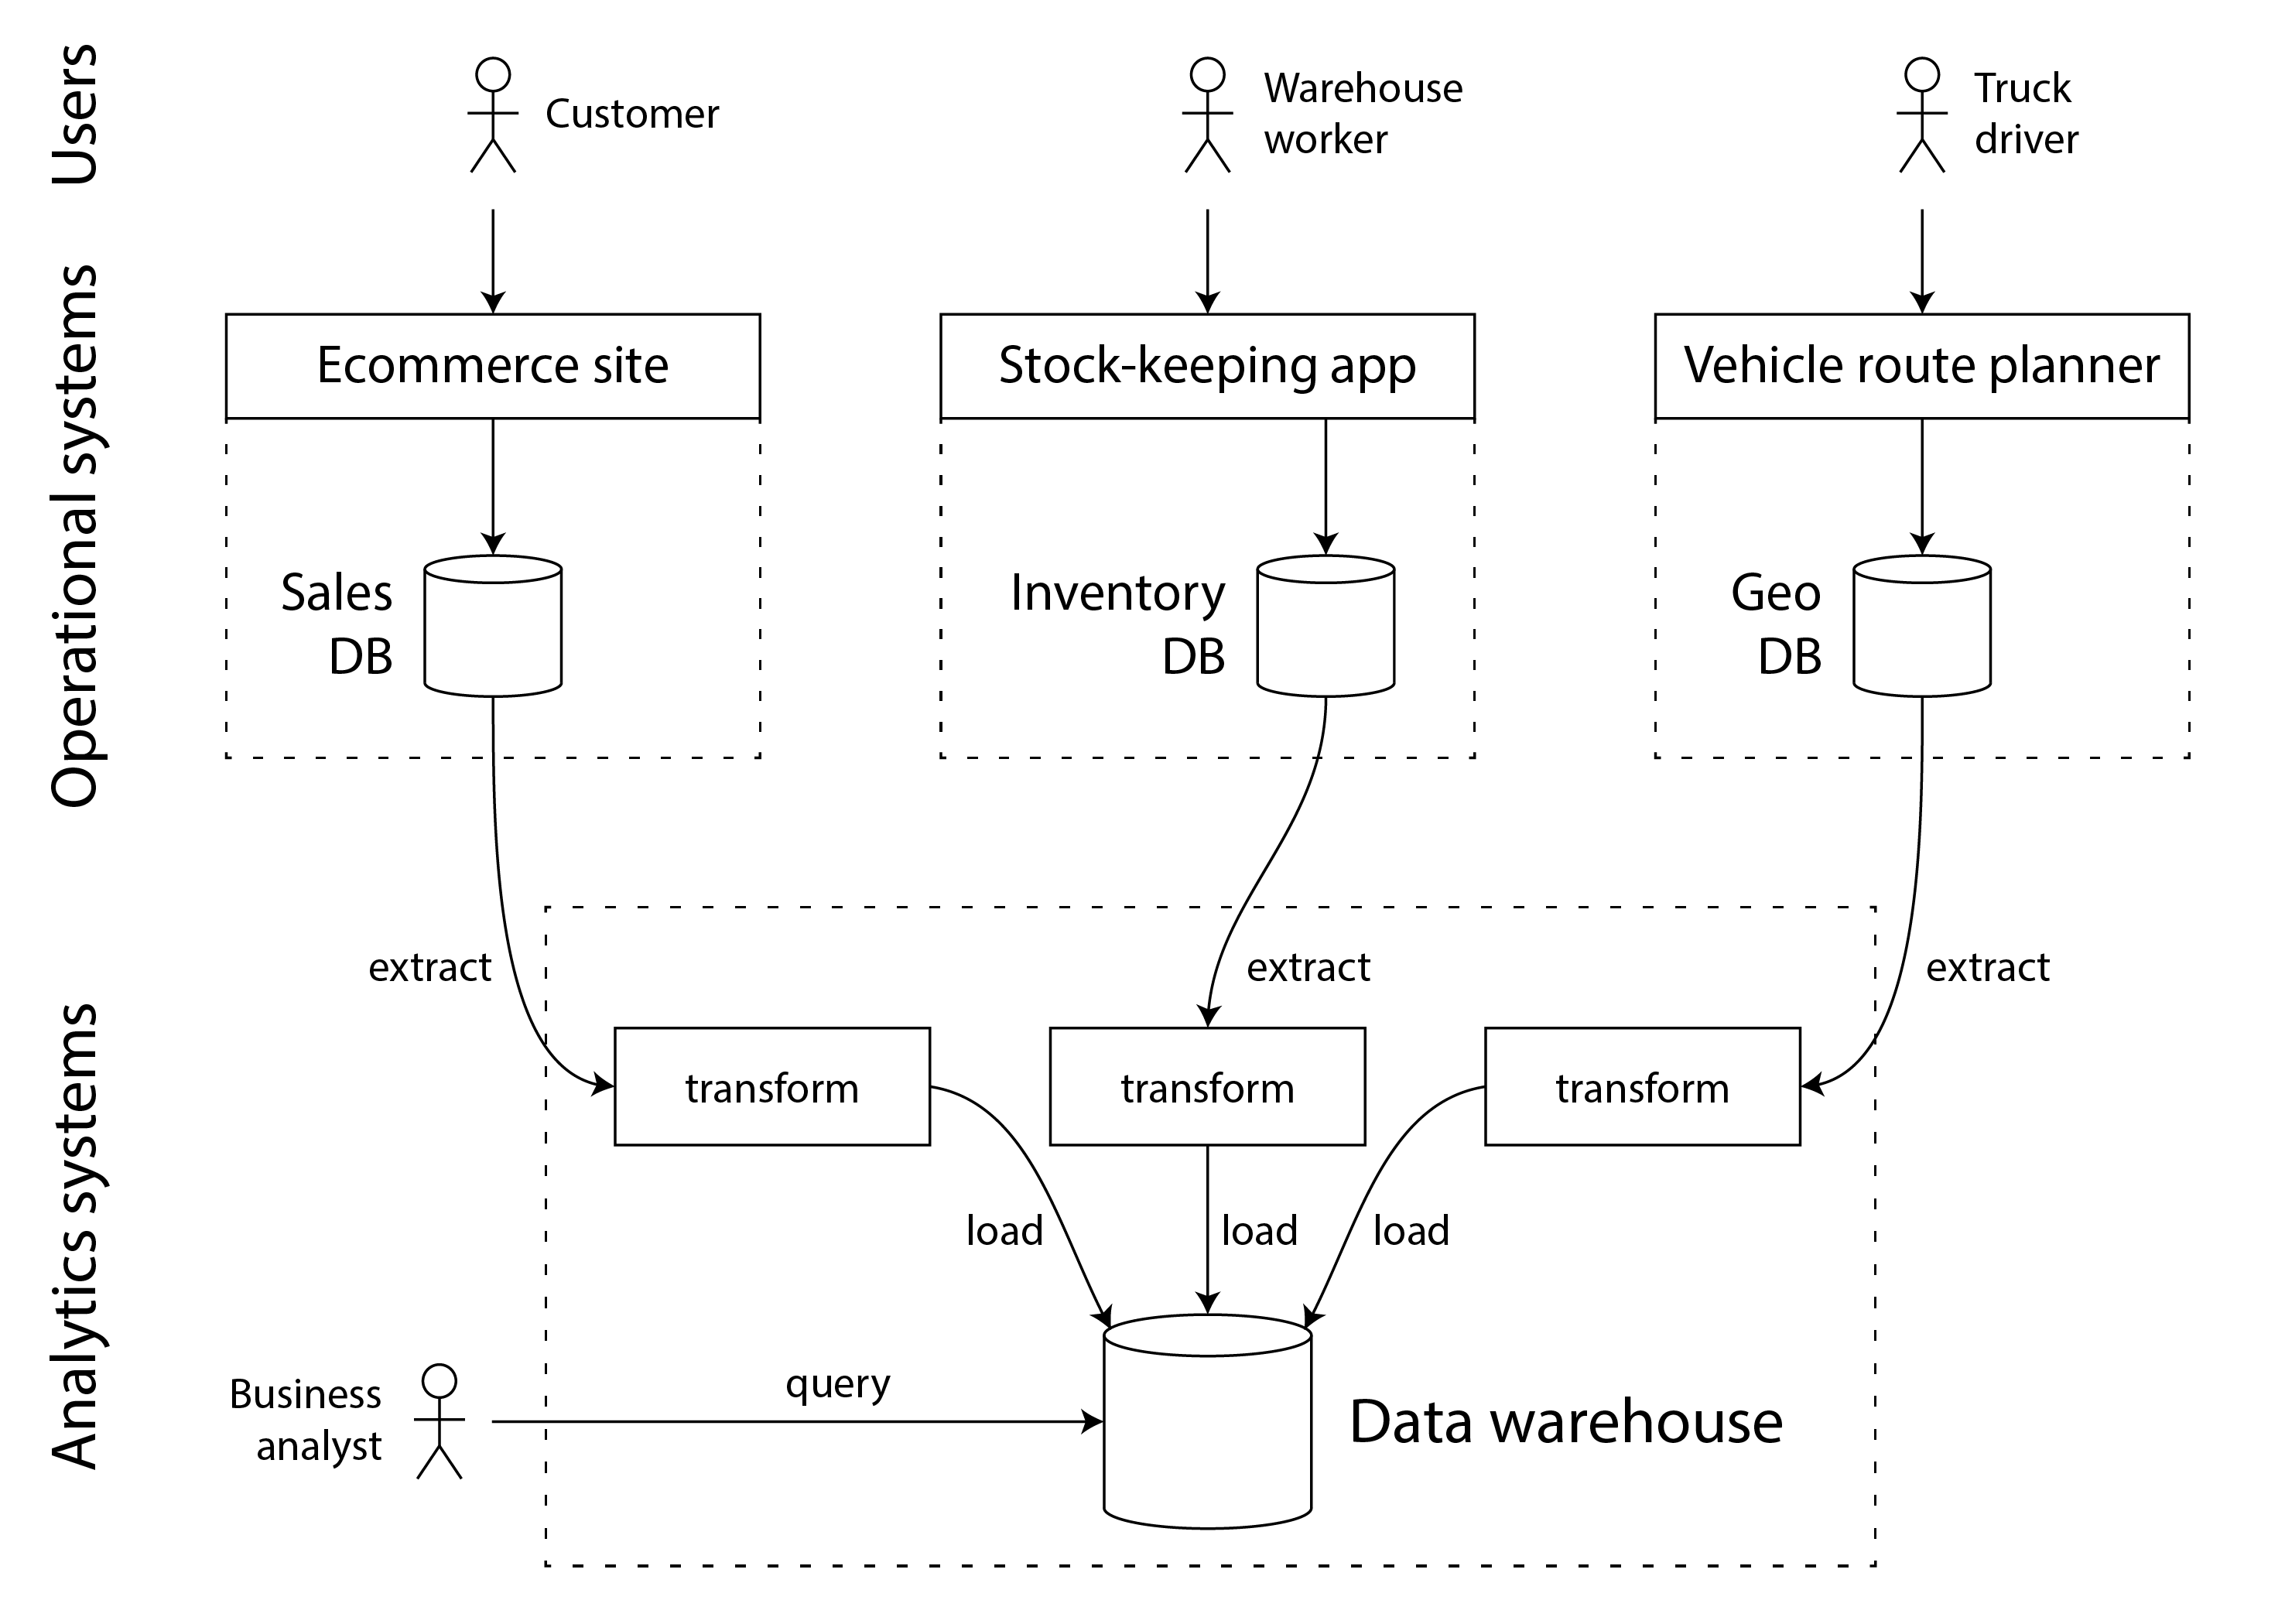
有时,ETL 流程的数据源是外部 SaaS 产品,例如客户关系管理(CRM)、电子邮件营销或信用卡处理系统。此时,你无法直接访问原始数据库,只能通过软件供应商的 API 获取数据。把这些外部系统的数据导入自己的数据仓库,就能进行 SaaS API 本身无法支持的分析。针对 SaaS API 的 ETL,通常由 Fivetran、Singer 或 AirByte 等专业数据连接器服务实现。
有些数据库系统提供 混合事务/分析处理(HTAP),目标是在单个系统中同时支持 OLTP 和分析,无需通过 ETL 把数据从一个系统送入另一个系统 8 9。然而,许多 HTAP 系统内部仍由一个 OLTP 系统和一个独立的分析系统耦合而成,只是共同隐藏在统一接口之后。因此,要理解这类系统的工作原理,二者的区别依然重要。
此外,即使已有 HTAP,由于事务型系统和分析型系统的目标与需求不同,把它们分开依然很常见。特别是,每个事务型系统各自拥有数据库通常被视为良好实践(参见“微服务与无服务器”),这样可能产生数百个独立的事务型数据库;而企业通常只设一个数据仓库,以便业务分析师在一条查询中组合多个事务型系统的数据。
因此,HTAP 并不能取代数据仓库。它适合的是另一类场景:同一个应用既要运行扫描大量数据行的分析查询,又要低延迟地读取和更新单条记录。例如,欺诈检测就可能具有这样的工作负载 10。
事务型系统与分析型系统的分离,体现了一种更广泛的趋势:随着工作负载要求越来越高,系统也日益专门化,针对特定负载进行优化。通用系统应付少量数据绰绰有余;但规模越大,系统往往越专门化 11。
从数据仓库到数据湖
数据仓库通常采用 关系 数据模型,并通过 SQL 查询(参见第 3 章),有时还会配合专门的商业智能软件。这种模型很适合业务分析师所需的查询,却不太适合数据科学家的需求;他们可能需要完成下面的工作:
- 把数据转换成适合训练机器学习模型的形式。这通常要把数据库表中的行列转换为数值向量或矩阵,其中的数值称为 特征(feature)。以尽可能提高训练后模型性能的方式完成这种转换,称为 特征工程(feature engineering);它通常需要编写难以用 SQL 表达的定制代码。
- 对文本数据(例如商品评论)应用自然语言处理技术,尝试从中提取结构化信息(例如作者表达的情绪,或提到了哪些主题)。同样,他们也可能要用计算机视觉技术从照片中提取结构化信息。
尽管人们一直尝试为 SQL 数据模型加入机器学习算子 12,也在关系模型的基础上构建高效的机器学习系统 13,许多数据科学家仍不愿在数据仓库这样的关系数据库中工作。他们往往更喜欢 pandas、scikit-learn 等 Python 数据分析库,R 等统计分析语言,以及 Spark 等分布式分析框架 14。我们将在“数据框、矩阵与数组”中进一步讨论这些工具。
因此,组织需要以适合数据科学家使用的形式提供数据。解决方案是 数据湖(data lake):一个集中的数据存储库,保存一切可能对分析有用的数据副本,这些数据通过 ETL 流程从事务型系统取得。数据湖与数据仓库的区别在于,它只保存文件,并不强制规定文件格式或数据模型。数据湖中的文件可以是一批数据库记录,以 Avro 或 Parquet 等文件格式编码(参见第 5 章);也完全可以是文本、图像、视频、传感器读数、稀疏矩阵、特征向量、基因组序列,或任何其他类型的数据 15。数据湖不仅更加灵活,而且往往比关系数据存储更便宜,因为它可以使用对象存储等廉价通用的文件存储(参见“云原生系统架构”)。
ETL 流程已经泛化为 数据管道(data pipeline);在某些情况下,数据湖成为事务型系统通往数据仓库途中的一站。数据湖以事务型系统产生的“原始”形态保存数据,不把它们转换成关系数据仓库的模式。这种做法的好处是,每个数据消费者都可以把原始数据转换成最适合自己需求的形式。它有一个诙谐的名字——寿司原则(sushi principle):“原始数据更好”16。
除了把数据从数据湖载入独立的数据仓库,也可以直接针对数据湖中的文件运行典型的数据仓库工作负载(SQL 查询和业务分析),并与数据科学和机器学习工作负载并存。这种架构称为 数据湖仓(data lakehouse);它需要在数据湖的文件存储之上增加查询执行引擎和元数据层(例如模式管理)17。
Apache Hive、Spark SQL、Presto 和 Trino 都采用了这种方法。
超越数据湖
随着分析实践日益成熟,组织也越来越重视分析系统与数据管道的管理和运维,例如 DataOps 宣言就体现了这种趋势 18。其中包括治理、隐私,以及遵守 GDPR、CCPA 等法规的问题;我们将在“数据系统、法律与社会”和“立法与自律”中讨论这些问题。
此外,分析数据的提供形式越来越多,不仅包括文件和关系表,还包括事件流(参见第 12 章)。采用基于文件的分析时,可以定期(例如每天)重新运行分析,以响应数据的变化;流处理则能让分析系统快得多,通常在几秒内便对事件作出响应。具体是否值得采用流处理,要看应用对时效性的要求。例如,它可以用来识别并阻止潜在的欺诈或滥用活动。
有时,分析系统的输出还会提供给事务型系统,这个过程有时称为 反向 ETL(reverse ETL)19。例如,在分析系统中训练好的机器学习模型可以部署到生产环境,向最终用户生成“购买了 X 的人也购买了 Y”之类的推荐。分析系统中这类投入实际应用的输出也称为 数据产品(data product)20。机器学习模型可以借助 TFX、Kubeflow 或 MLflow 等专用工具部署到事务型系统。
权威记录系统与衍生数据
除了区分事务型系统与分析型系统,本书还区分 权威记录系统(system of record)与 衍生数据系统(derived data system)。这组术语很有用,可以帮助你理清数据在系统中的流向:
- 权威记录系统
- 权威记录系统也称 权威数据源(source of truth),保存某类数据的权威或 规范(canonical)版本。新数据到来时,例如用户输入,首先写入这里。每项事实只表示一次,通常采用 规范化(normalized)表示(参见“规范化、反规范化与连接”)。如果其他系统与权威记录系统的数据不一致,那么按照定义,应以权威记录系统中的值为准。
- 衍生数据系统
- 衍生系统中的数据,是以另一个系统中的现有数据为基础,经过某种转换或处理而得到的结果。衍生数据即使丢失,也可以从原始数据源重新创建。缓存就是一个典型例子:若数据在缓存中,便可直接返回;若缓存中没有所需数据,则可以退回底层数据库读取。反规范化值、索引、物化视图、转换后的数据表示,以及在数据集上训练的模型,也都属于这一类。
从技术上讲,衍生数据是 冗余(redundant)的,因为它复制了现有信息。但是,要让读查询获得良好性能,这种冗余往往不可或缺。你可以从同一个数据源衍生出多个不同的数据集,从不同“视角”观察数据。
分析型系统通常属于衍生数据系统,因为它们消费的是在别处创建的数据。事务型服务则可能同时包含权威记录系统和衍生数据系统:权威记录系统是数据首先写入的主数据库,衍生数据系统则是加快常见读取操作的索引和缓存,尤其适用于权威记录系统无法高效回答的查询。
大多数数据库、存储引擎和查询语言,本身并不天然是权威记录系统或衍生系统。数据库只是工具,如何使用由你决定。一个系统究竟属于哪一类,取决于它在应用中的用法,而不是采用了什么工具。明确哪些数据衍生自哪些其他数据,可以让原本令人困惑的系统架构变得清晰。
如果一个系统的数据衍生自另一个系统,那么每当权威记录系统中的原始数据发生变化,就需要有相应流程更新衍生数据。遗憾的是,许多数据库在设计时都假定应用只会使用这一个数据库,因而很难集成多个系统并传播这类更新。我们将在“数据集成”中讨论 数据集成(data integration)的各种方法;借助这些方法,可以组合多个数据系统,完成单个系统无法独力完成的任务。
至此,我们对分析与事务处理的比较告一段落。下一节要讨论的另一项权衡,你可能已经见过许多人反复争论。
云服务与自托管
无论组织要做什么,最先遇到的问题之一总是:应当由内部完成,还是外包出去?应当自建,还是购买?
归根结底,这取决于业务的优先事项。管理学中通常认为,属于组织核心能力或竞争优势的事情应当在内部完成;非核心、例行或司空见惯的事情则应交给供应商 21。举一个极端的例子:大多数公司都不会自行发电(能源公司除外,这里也不考虑应急备用电源),因为从电网购电更加便宜。
对软件来说,有两个重要决定:由谁来构建,又由谁来部署。两项工作都可以按不同程度外包,从而形成图 1-2所示的一条连续谱。一个极端是完全定制的软件,由你自行编写并在内部运行;另一个极端是广泛使用的云服务或软件即服务(SaaS)产品,由外部供应商开发和运维,你只能通过 Web 界面或 API 使用。
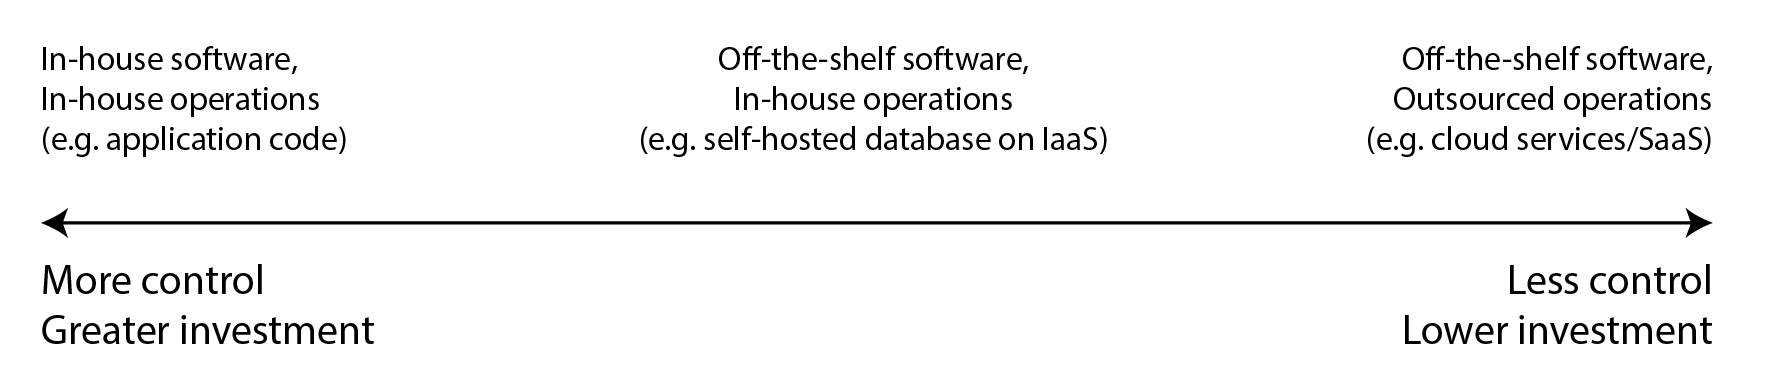
这条连续谱的中间,是由你 自托管(self-hosted)的现成软件(可以是开源软件,也可以是商业软件),也就是由你亲自部署。例如,下载 MySQL 并安装到一台由你掌控的服务器上。这台服务器可以是你自己的硬件——通常称为 本地部署(on-premises),即使它实际位于租用的数据中心机架里,并不真的在你的自有场所——也可以是云中的虚拟机,即 基础设施即服务(IaaS)。这条连续谱上还有更多中间位置,例如采用开源软件,但运行自己修改过的版本。
与这条连续谱相互独立的另一个问题是:无论在云端还是本地,究竟要 如何 部署服务,例如是否采用 Kubernetes 之类的编排框架。不过,部署工具的选择不在本书讨论范围内,因为还有其他因素对数据系统架构的影响更大。
云服务的利弊
使用云服务而不是自行运行同类软件,本质上就是把软件的运维外包给云服务商。采用云服务既有充分的支持理由,也有充分的反对理由。云服务商声称,与自建基础设施相比,使用它们的服务能够节省时间和金钱,还能让你行动得更快。
云服务究竟是否比自托管更便宜、更省事,很大程度上取决于你掌握的技能和系统承受的工作负载。如果你已经熟悉所需系统的部署和运维,而且负载相当容易预测(也就是所需机器数量不会剧烈波动),那么购买自己的机器并自行运行软件,往往更加便宜 22 23。
反过来,如果你需要一个自己还不会部署和运维的系统,那么采用云服务,通常比从头学习如何自行管理更加容易、快捷。如果还必须专门招聘和培训人员来维护、运维这个系统,成本可能会非常高。使用云服务时仍然需要运维团队(参见“云时代的运维”),但把基础系统管理外包出去,可以让团队专注于更高层次的问题。
把系统运维外包给专门经营这项服务的公司,也可能得到更好的服务,因为供应商在服务众多客户的过程中积累了丰富的运维经验。另一方面,如果由你自行运维,就能针对自己的特定工作负载配置和调优服务;云服务商不太可能愿意为你进行这样的定制。
如果系统负载随时间大幅波动,云服务尤其有价值。假如机器按峰值负载配置,但计算资源在大多数时候都处于闲置状态,系统的成本效益就会很差。在这种情况下,云服务的优势在于,可以更加容易地随着需求变化增加或减少计算资源。
例如,分析型系统的负载通常变化极大:要快速执行一项大型分析查询,需要同时动用大量计算资源;但查询完成后,这些资源就会闲置,直到用户发出下一项查询。预定义查询(例如日报)可以排队并调度执行,从而平滑负载;但对交互式查询而言,越是希望迅速得到结果,工作负载的波动就越大。如果数据集庞大到必须投入大量计算资源才能快速查询,使用云服务可以节省成本,因为闲置资源可以归还服务商,而不必任其空置。数据集较小时,这种差别就没那么显著。
云服务最大的缺点是你无法掌控它:
- 如果服务缺少你需要的功能,你只能客气地询问供应商是否愿意添加;通常无法自己动手实现。
- 如果服务宕机,你只能等它恢复。
- 如果你的某种使用方式触发了缺陷或性能问题,诊断起来会非常困难。对于自行运行的软件,你可以从操作系统获取性能指标和调试信息,从而了解它的行为,还可以查看服务器日志;但服务由供应商托管时,你通常无法接触这些内部信息。
- 如果服务停止运营、价格高到无法接受,或供应商以你不喜欢的方式改动产品,你也只能任其摆布——继续运行旧版本通常不可行,因此只能被迫迁移到其他服务 24。如果存在提供兼容 API 的替代服务,这种风险会小一些;但是许多云服务并没有标准 API,切换成本很高,因而产生了供应商锁定问题。
- 你必须相信云服务商能够保护数据安全,这会增加遵守隐私和安全法规的难度。
尽管存在这些风险,组织在云服务之上构建新应用,或者采用只在系统某些部分使用云服务的混合方案,还是越来越普遍。不过,云服务不会取代所有内部数据系统:许多老系统诞生在云计算之前;只要某项服务有现有云服务无法满足的特殊需求,内部系统仍然不可或缺。例如,高频交易等对延迟极其敏感的应用,就需要完全掌控硬件。
云原生系统架构
云计算不仅采用了不同的经济模式——订阅服务,而不是购买硬件和软件许可证,再自行运行软件——它的兴起也从技术层面深刻影响了数据系统的实现方式。云原生(cloud-native)一词用来描述专为利用云服务优势而设计的架构。
原则上,几乎任何可以自托管的软件都能以云服务的形式提供;事实上,许多流行的数据系统如今都有相应的托管服务。然而,从一开始就按云原生思路设计的系统已经展现出若干优势:在相同硬件上性能更好,故障恢复更快,能够迅速调整计算资源以匹配负载,并且可以支持更大的数据集 25 26 27。表 1-2列出了两类系统的一些例子。
云服务的分层
许多自托管数据系统对运行环境的要求非常简单:在 Linux 或 Windows 等常规操作系统上运行,把数据存成文件系统中的文件,并通过 TCP/IP 等标准网络协议通信。少数系统依赖 GPU(用于机器学习)或 RDMA 网卡等特殊硬件,但总体而言,自托管软件使用的都是十分通用的计算资源:CPU、内存、文件系统和 IP 网络。
在云中,这类软件可以运行在基础设施即服务(IaaS)环境里,使用一台或多台虚拟机(也称为 实例,instance),每台实例分配一定数量的 CPU、内存、磁盘和网络带宽。与物理机器相比,云实例的开通速度更快,可选规格也更多;但除此之外,它们与传统计算机相似:你可以随意运行任何软件,也要自行负责管理。
与之相对,云原生服务的关键思想是:不仅使用操作系统管理的计算资源,还要在低层云服务的基础上构建更高层的服务。例如:
- Amazon S3、Azure Blob Storage 和 Cloudflare R2 等 对象存储(object storage)服务用于保存大型文件。它们的 API 比普通文件系统更受限,只提供基本的文件读写;但好处是隐藏了底层物理机器。服务会自动把数据分布到许多机器上,你不必担心其中某台机器的磁盘空间耗尽。即使某些机器或其磁盘彻底损坏,数据也不会丢失。
- 许多其他服务又建立在对象存储和其他云服务之上。例如,Snowflake 是一种云端分析数据库(数据仓库),依靠 S3 存储数据 27;还有一些服务进一步构建在 Snowflake 之上。
计算机领域的抽象一向如此:该选择哪一层,并没有唯一正确的答案。一般来说,层次越高的抽象,往往越面向特定用例。如果你的需求恰好符合某个高层系统的设计场景,那么直接使用现成系统,通常比自己用低层系统搭建省心得多,也足以满足需要。反过来,如果没有任何高层系统符合需求,那就只能用低层组件自行构建。
存储与计算的分离
在传统计算中,磁盘存储被视为持久存储:我们假定数据一旦写入磁盘,就不会丢失。为了容忍单块硬盘故障,人们通常使用 RAID(独立磁盘冗余阵列),在连接到同一台机器的多块磁盘上保存数据副本。RAID 既可以由硬件实现,也可以由操作系统通过软件实现;对于访问文件系统的应用来说,这一切都是透明的。
云中的计算实例(虚拟机)也可以连接本地磁盘,但云原生系统通常更愿意把它们当作临时缓存,而不是长期存储。原因在于:一旦相应实例发生故障,本地磁盘就无法访问;为了适应负载变化而把实例换成另一台物理机上的更大或更小规格时,本地磁盘同样无法访问。
作为本地磁盘的替代方案,云服务还提供虚拟磁盘存储,可以从一个实例卸载,再挂载到另一个实例上,例如 Amazon EBS、Azure 托管磁盘和 Google Cloud 持久磁盘。这种虚拟磁盘并不是真正的物理磁盘,而是由另一组机器提供的云服务,用来模拟磁盘的行为——也就是 块设备(block device),其中每个块通常为 4 KiB。这项技术让传统的磁盘软件可以在云中运行,但块设备模拟会引入额外开销;如果系统从一开始便针对云设计,这些开销本来可以避免 25。它还使应用对网络异常极为敏感,因为虚拟块设备上的每次 I/O 实际上都是一次网络调用 28。
为了解决这个问题,云原生服务通常避开虚拟磁盘,转而建立在针对特定工作负载优化的专用存储服务之上。S3 等对象存储服务适合长期保存较大的文件,大小从数百 KB 到数 GB 不等。数据库中的单行或单个值通常远小于这个范围;因此,云数据库通常在一个独立服务中管理较小的值,并把包含许多个值的较大数据块存入对象存储 26 29。我们将在第 4 章介绍相应的实现方法。
在传统系统架构中,同一台计算机同时负责存储(磁盘)和计算(CPU 与内存);而在云原生系统中,这两项职责在一定程度上相互分离,或者说被 解耦(decoupled)了 9 27 30 31。例如,S3 只负责保存文件;如果要分析其中的数据,就必须在 S3 之外运行分析代码。这也意味着数据需要通过网络传输,我们将在“分布式与单节点系统”中进一步讨论。
此外,云原生系统往往采用 多租户(multitenant)模式:它并不为每个客户单独分配一台机器,而是由同一项服务在共享硬件上处理多个客户的数据和计算 32。
多租户可以提高硬件利用率,更容易实现可伸缩性,也便于云服务商管理;但要保证一个客户的活动不影响其他客户的性能或安全,就必须经过周密的工程设计 33。
云时代的运维
传统上,管理组织服务器端数据基础设施的人员称为 数据库管理员(DBA)或 系统管理员(sysadmin)。近年来,许多组织尝试把软件开发与运维角色融入同一个团队,让团队共同负责后端服务和数据基础设施;DevOps 理念推动了这一趋势。站点可靠性工程师(SRE)则是 Google 对这一理念的实践 34。
运维的职责是确保服务可靠地交付给用户,包括配置基础设施和部署应用;同时保障生产环境稳定,包括监控和诊断任何可能影响可靠性的问题。对自托管系统来说,传统运维有大量工作落在单台机器上,例如容量规划(监控可用磁盘空间,并在耗尽前增加磁盘)、开通新机器、在机器之间迁移服务,以及安装操作系统补丁。
许多云服务通过 API 隐藏了实际承载服务的一台台机器。例如,云存储不再提供固定容量的磁盘,而是采用 按量计费(metered billing):你无需提前规划容量,就可以存储数据,然后按实际占用的空间付费。此外,即使个别机器发生故障,许多云服务仍然保持高可用性(参见“可靠性与容错”)。
关注点从单台机器转向服务,也伴随着运维角色的变化。可靠地提供服务这一高层目标没有改变,但流程和工具已经演变。DevOps/SRE 理念更强调:
- 自动化——采用可重复的流程,而不是手工执行一次性任务;
- 采用临时性的虚拟机和服务,而不是长时间运行的服务器;
- 支持频繁更新应用;
- 从事故中吸取教训;以及
- 即使人员来去更替,也要保留组织对系统的知识 35。
随着云服务兴起,运维角色也发生了分化:基础设施公司的运维团队专攻如何面向大量客户提供可靠服务;云服务客户则力求把投入基础设施的时间和精力降到最低 36。
云服务的客户仍然需要运维,只是关注的方面有所不同,例如为一项任务选择最合适的服务、集成不同服务,以及从一项服务迁移到另一项服务。尽管按量计费消除了传统意义上的容量规划,你依然必须清楚哪些资源被用在什么地方,免得为并不需要的云资源白白花钱:容量规划变成了财务规划,性能优化变成了成本优化 37。
而且,云服务仍有资源上限或 配额(quota),例如并发运行的进程数上限。你必须提前了解并做好规划,不能等到撞上限额才处理 38。
采用云服务或许比自行运行基础设施更加容易、快捷,但学习如何使用仍有成本,有时还得设法绕过它的限制。随着供应商越来越多,面向各种用例的云服务层出不穷,如何集成不同服务成了一项格外棘手的挑战 39 40。
ETL(参见“数据仓库”)只是其中一部分,事务型云服务同样需要彼此集成。目前还缺少简化这类集成的标准,因此往往要投入大量手工工作。
还有一些运维工作无法完全外包给云服务,例如维护应用及其依赖库的安全,管理自有服务之间的交互,监控服务负载,以及追查性能下降或服务中断等问题的根源。云计算固然正在改变运维的角色,但运维仍与以往任何时候一样重要。
分布式与单节点系统
由多台机器通过网络通信而构成的系统,称为 分布式系统(distributed system)。参与分布式系统的每个进程称为一个 节点(node)。采用分布式系统可能出于以下各种原因:
- 固有的分布式系统
- 如果一项应用涉及两个或更多相互交互的用户,而每个用户都使用自己的设备,那么这个系统不可避免地是分布式的:设备之间只能通过网络通信。
- 云服务之间的请求
- 如果数据存储在一个服务中,却要由另一个服务处理,就必须通过网络把数据从一个服务传到另一个服务。
- 容错/高可用性
- 如果应用需要在一台机器(乃至多台机器、网络或整个数据中心)发生故障时继续运行,可以用多台机器提供冗余:一台发生故障后,由另一台接管。参见“可靠性与容错”以及第 6 章关于复制的讨论。
- 可伸缩性
- 如果数据量或计算需求增长到单台机器无力承担,或许可以把负载分散到多台机器上。参见“可伸缩性”。
- 延迟
- 如果用户遍布世界各地,你可能希望在全球多个区域部署服务器,让每个用户都由地理位置较近的服务器提供服务。这样一来,用户就不必等待网络数据包绕过半个地球才得到响应。参见“描述性能”。
- 弹性
- 如果应用有时繁忙、有时空闲,云端部署可以随着需求扩大或缩小,让你只为正在使用的资源付费。这在单台机器上很难做到:即使大部分时间几乎没有负载,仍要按最大负载预先配置机器。
- 使用专用硬件
- 系统的各个部分可以采用与各自工作负载相匹配的硬件。例如,对象存储可以使用磁盘很多、CPU 很少的机器;数据分析系统可以使用 CPU 和内存很多、却没有磁盘的机器;机器学习系统则可以使用配备 GPU 的机器——训练深度神经网络及执行其他机器学习任务时,GPU 的效率远高于 CPU。
- 法律合规
- 一些国家制定了数据驻留法律,要求有关本国管辖范围内人员的数据,必须在该国境内存储和处理 41。这类规定的适用范围不尽相同:有些只针对医疗或金融数据,有些则更加宽泛。因此,如果一项服务的用户分布在多个这样的司法管辖区,就不得不把用户数据分散到多个地点的服务器上。
- 可持续性
- 如果作业在何时、何地运行具有一定灵活性,就可以选择可再生电力充足的时间和地点,并避开电网负荷紧张的时候。这样既能减少碳排放,也能利用价格低廉的电力 42 43。
这些理由既适用于自行编写的服务(应用代码),也适用于由数据库等现成软件组成的服务。
分布式系统的问题
分布式系统也有缺点。每一个经过网络的请求和 API 调用,都必须面对失败的可能:网络可能中断,服务可能过载或崩溃,任何请求都有可能超时而收不到响应。此时,我们不知道服务究竟有没有收到请求,贸然重试未必安全。我们将在第 9 章详细讨论这些问题。
尽管数据中心网络很快,调用另一个服务仍然远远慢于在同一进程中调用函数 44。
处理海量数据时,与其把数据从存储位置传到另一台机器上处理,往往不如把计算带到已经保存数据的机器上来得快 45。
节点更多也不一定更快:有些情况下,一台计算机上简单的单线程程序,性能可以显著胜过拥有 100 多个 CPU 核心的集群 46。
分布式系统往往很难排查故障:如果系统响应缓慢,怎样才能找出问题在哪里?用于诊断分布式系统问题的技术统称为 可观测性(observability)47 48。它收集系统的执行数据,并允许人们查询这些数据,从而既能分析高层指标,也能追查单个事件。OpenTelemetry、Zipkin 和 Jaeger 等 追踪(tracing)工具可以记录哪个客户端为了什么操作调用了哪个服务器,以及每次调用花了多长时间 49。
数据库提供了多种保证数据一致性的机制,我们将在第 6 章和第 8 章中看到。但是,当每个服务都有自己的数据库时,如何保持不同服务之间的数据一致,就成了应用自身的问题。分布式事务(参见第 8 章)是一种可能的手段,但很少用于微服务,因为它与服务彼此独立的目标背道而驰,而且许多数据库根本不支持分布式事务 50。
出于以上种种原因,只要一项工作能在单台机器上完成,通常就比搭建分布式系统简单得多,也便宜得多 23 46 51。CPU 越来越快,内存和磁盘的容量越来越大,硬件也越来越可靠。再加上 DuckDB、SQLite 和 KùzuDB 等单节点数据库,如今许多工作负载都可以在单个节点上运行。我们将在第 4 章进一步探讨这个话题。
微服务与无服务器
把系统分布到多台机器上,最常见的做法是将它划分为客户端和服务器,由客户端向服务器发送请求。这种通信最常使用 HTTP,我们将在“流经服务的数据流:REST 与 RPC”中进一步讨论。同一个进程既可以是服务器(处理传入的请求),也可以是客户端(向其他服务发出请求)。
这种构建应用的方式传统上称为 面向服务架构(SOA);近年来,这一思想又进一步演化为 微服务(microservices)架构 52 53。在这种架构中,每项服务都有明确的用途(例如 S3 的用途就是文件存储);服务通过 API 向客户端开放能力,由客户端经网络调用;每项服务还由一个团队负责维护。这样一来,复杂应用就可以拆分成多项相互交互的服务,分别由不同团队管理。
把复杂软件拆成多项服务有几个优点:各项服务可以独立更新,减少团队之间的协调;每项服务可以获得符合自身需要的硬件资源;实现细节隐藏在 API 后面,服务负责人可以自由改变实现,而不影响客户端。在数据存储方面,通常每项服务都有自己的数据库,服务之间不共享数据库。否则,整个数据库结构实际上都会成为服务 API 的一部分,很难再行修改;而且,一项服务发出的查询也可能拖累其他服务的性能。
另一方面,服务多了本身也会滋生复杂度:每项服务都需要相应基础设施,用来部署新版本、根据负载调整硬件资源、收集日志、监控服务健康状况,并在出现问题时向值班工程师告警。Kubernetes 等 编排(orchestration)框架为这类基础设施提供了基础能力,因此成了部署服务的常用方式。在开发过程中测试一项服务也可能很麻烦,因为它所依赖的其他服务必须一并运行。
微服务 API 也很难演化。调用 API 的客户端会期待其中存在某些字段;随着业务需求改变,开发者或许想要增删 API 字段,但这可能导致客户端出错。更糟的是,这类问题往往要到开发周期后期,更新后的服务 API 部署到预发布或生产环境时才被发现。OpenAPI 和 gRPC 等 API 描述标准有助于管理客户端 API 与服务器 API 之间的关系,我们将在第 5 章中进一步讨论。
微服务主要是用技术手段解决人员问题:让不同团队无需彼此协调,也能独立推进工作。这对大公司很有价值;但在团队不多的小公司里,微服务很可能只是没有必要的额外开销,此时最好采用最简单的方式实现应用 52。
无服务器(serverless),又称 函数即服务(FaaS),是另一种服务部署方式:它把基础设施管理进一步外包给云服务商 33。使用虚拟机时,你必须明确决定何时启动或关闭实例;无服务器模型则由云服务商根据发往服务的请求,自动分配和释放硬件资源 54。这种部署方式把更多运维负担转移给云服务商,并允许按使用量灵活计费,不再按机器实例收费。为了提供这些好处,许多无服务器基础设施会限制函数执行时长和运行时环境,而且函数第一次调用时可能启动缓慢。“无服务器”这个名称也容易误导:每次执行无服务器函数仍然要用到一台服务器,只是下一次执行可能换到另一台。此外,BigQuery 和各种 Kafka 产品也采用了“无服务器”这个说法,用来表示服务能够自动伸缩,并按使用量而不是机器实例收费。
正如云存储用按量计费取代了容量规划(提前决定购买多少磁盘),无服务器模式也把按量计费带到了代码执行:你只需为应用代码实际运行的时间付费,不必提前配置资源。
云计算与超级计算
云计算并非构建大规模计算系统的唯一方式,另一条路线是 高性能计算(HPC),也称为 超级计算(supercomputing)。尽管二者有所重叠,但与云计算和企业数据中心系统相比,HPC 的侧重点通常不同,采用的技术也不一样。差异包括:
- 超级计算机通常用于计算密集型的科学计算任务,例如天气预报、气候建模、分子动力学(模拟原子和分子的运动)、复杂优化问题,以及求解偏微分方程。云计算则更常用于在线服务、业务数据系统,以及其他需要以高可用性响应用户请求的系统。
- 超级计算机通常运行大型批处理作业,并不时把计算状态作为检查点写入磁盘。如果某个节点发生故障,一种常见做法是直接停止整个集群的工作负载,修复故障节点,再从最近的检查点重新开始计算 55 56。云服务通常不能这样停掉整个集群,因为服务必须持续响应用户,尽量减少中断。
- 超级计算机的节点通常通过共享内存和远程直接内存访问(RDMA)通信,既有高带宽,又有低延迟,但前提是系统用户彼此高度信任 57。在云计算中,网络和机器常由互不信任的组织共享,因此需要更强的安全机制,例如资源隔离(使用虚拟机等)、加密和认证。
- 云数据中心网络通常以 IP 和以太网为基础,采用 Clos 拓扑来提供较高的对分带宽——这是衡量网络整体性能的常用指标 55 58。超级计算机则常采用专门的网络拓扑,例如多维网格和环面 59;对于通信模式已知的 HPC 工作负载,这类拓扑可以提供更好的性能。
- 云计算允许节点分布在多个地理区域;超级计算机通常假定所有节点都彼此邻近。
大规模分析系统有时也具备超级计算的一些特征;如果你在这个领域工作,了解这些技术会很有价值。不过,本书主要关注必须持续可用的服务,正如“可靠性与容错”所讨论的那样。
数据系统、法律与社会
本章到目前为止已经说明,数据系统架构不仅受技术目标和要求影响,也受其所服务组织中人类需求的影响。越来越多的数据系统工程师开始认识到,只满足自己所在企业的需求还不够:我们也对整个社会负有责任。
其中一个特别值得关注的问题,是存储个人及其行为数据的系统。自 2018 年起,《通用数据保护条例》(GDPR)赋予许多欧洲国家的居民更大的个人数据控制权和更多法律权利;世界各地的不少国家和地区也采用了类似的隐私法规,例如《加州消费者隐私法案》(CCPA)。《欧盟人工智能法案》 等针对 AI 的法规,又进一步限制了个人数据的使用方式。
即使在没有直接受到监管的领域,人们也越来越清楚地认识到计算机系统对个人和社会的影响。社交媒体改变了人们获取新闻的方式,进而影响政治观点,甚至可能左右选举结果。自动化系统也越来越多地作出对个人影响深远的决定,例如谁能获得贷款或保险,谁能得到工作面试的机会,以及谁会成为犯罪嫌疑人 60。
每一个参与这类系统的人,都有责任考虑它们的伦理影响,并确保系统遵守相关法律。并非人人都要成为法律和伦理专家,但具备基本的法律与伦理常识,与掌握分布式系统的基础知识同样重要。
法律因素正在影响数据系统设计最根本的部分 61。例如,GDPR 赋予个人要求删除其数据的权利,有时称为 被遗忘权(right to be forgotten)。然而,正如本书将要介绍的,许多数据系统的设计依赖仅追加日志等不可变结构;一个本应不可变的文件,要怎样从中间删除某些数据?如果数据已经纳入衍生数据集(参见“权威记录系统与衍生数据”),例如成为机器学习模型的训练数据,又该如何删除?回答这些问题带来了新的工程挑战。
目前,还没有明确指南说明哪些具体技术或系统架构算是“符合 GDPR”。法规有意不规定特定技术,因为技术进步可能很快就会使这些规定过时。法律文本给出的只是有待解释的高层原则。因此,如何遵守隐私法规并没有简单答案;不过,在讨论本书的一些技术时,我们会从这个角度加以审视。
一般来说,我们之所以存储数据,是因为相信它的价值高于存储成本。但不要忘记,存储成本不只是付给 Amazon S3 或其他服务的账单。成本效益分析还应计入这些风险:数据一旦泄露,或遭到攻击者窃取、破坏,可能承担法律责任并蒙受声誉损失;如果数据的存储和处理不符合法律规定,还可能产生诉讼费用和罚款 51。
政府或警方也可能强迫企业交出数据。如果数据可能暴露某些在当地被法律定为犯罪的行为——例如,在一些中东和非洲国家,同性恋会受到刑事处罚;在美国一些州,寻求堕胎也可能受到刑事追究——那么存储这些数据会给用户带来切实的安全风险。例如,位置数据很容易暴露一个人曾前往堕胎诊所;哪怕只是一段用户 IP 地址的历史日志,也可能泄露其大致位置。
把所有风险都考虑在内之后,合理的结论可能是:某些数据根本不值得存储,因此应当删除。数据最小化(data minimization)原则(有时也用德语 Datensparsamkeit 表示)与“大数据”理念背道而驰;后者倾向于先存下大量数据,指望它们将来也许会派上用场 62。不过,数据最小化符合 GDPR:个人数据只能为具体、明确的目的而收集,日后不得用于其他目的,也不得在超出原定目的所需期限后继续保留 63。
企业同样开始重视隐私和安全问题。信用卡公司要求支付处理企业遵守严格的支付卡行业(PCI)标准;支付处理商要频繁接受独立审计机构的评估,验证是否持续合规。软件供应商面临的审查也日趋严格,许多采购方如今要求供应商符合服务组织控制(SOC)第 2 类标准。与 PCI 合规一样,供应商要通过第三方审计来验证是否符合要求。
总而言之,必须在业务需求与数据被收集、处理的人们的需求之间取得平衡。这个话题远不止于此;第 14 章将深入讨论伦理与法律合规问题,包括偏见和歧视。
总结
本章的主题是理解权衡:许多问题并没有唯一正确的答案,而是有几种不同的做法,各有利弊。我们探讨了影响数据系统架构的一些最重要的选择,也介绍了阅读本书其余部分所需的术语。
首先,我们区分了事务型系统(事务处理,即 OLTP)与分析型系统(OLAP),看到两者不仅管理着访问模式不同的各类数据,服务的群体也不相同。我们还认识了数据仓库与数据湖,它们通过 ETL 接收事务型系统送来的数据。第 4 章将会说明,由于要服务的查询类型不同,事务型系统与分析型系统的内部数据布局往往大相径庭。
接着,我们把出现时间较晚的云服务,与此前长期主导数据系统架构的自托管软件范式作了比较。哪种方式成本效益更高,很大程度上取决于具体情况;但不可否认的是,云原生方法正在深刻改变数据系统的架构,例如将存储与计算分离。
云系统天然就是分布式系统,我们也简要考察了分布式系统与单机方案之间的一些权衡。有些场景无法避免分布式;但只要系统还能保留在一台机器上,就不宜急着将其分布式化。第 9 章将更详细地讨论分布式系统带来的挑战。
最后,我们看到,数据系统架构不仅由部署系统的企业需求决定,也受隐私法规影响;这些法规保护着数据处理所涉及人员的权利,而许多工程师很容易忽视这一点。如何把法律要求转化为技术实现,目前还没有得到充分理解;但在阅读本书后续内容时,务必始终把这个问题放在心上。
参考文献
Richard T. Kouzes, Gordon A. Anderson, Stephen T. Elbert, Ian Gorton, and Deborah K. Gracio. The Changing Paradigm of Data-Intensive Computing. IEEE Computer, volume 42, issue 1, January 2009. doi:10.1109/MC.2009.26 ↩︎
Martin Kleppmann, Adam Wiggins, Peter van Hardenberg, and Mark McGranaghan. Local-first software: you own your data, in spite of the cloud. At 2019 ACM SIGPLAN International Symposium on New Ideas, New Paradigms, and Reflections on Programming and Software (Onward!), October 2019. doi:10.1145/3359591.3359737 ↩︎
Joe Reis and Matt Housley. Fundamentals of Data Engineering. O’Reilly Media, 2022. ISBN: 9781098108304 ↩︎
Rui Pedro Machado and Helder Russa. Analytics Engineering with SQL and dbt. O’Reilly Media, 2023. ISBN: 9781098142384 ↩︎
Edgar F. Codd, S. B. Codd, and C. T. Salley. Providing OLAP to User-Analysts: An IT Mandate. E. F. Codd Associates, 1993. Archived at perma.cc/RKX8-2GEE ↩︎
Chinmay Soman and Neha Pawar. Comparing Three Real-Time OLAP Databases: Apache Pinot, Apache Druid, and ClickHouse. startree.ai, April 2023. Archived at perma.cc/8BZP-VWPA ↩︎
Surajit Chaudhuri and Umeshwar Dayal. An Overview of Data Warehousing and OLAP Technology. ACM SIGMOD Record, volume 26, issue 1, pages 65–74, March 1997. doi:10.1145/248603.248616 ↩︎
Fatma Özcan, Yuanyuan Tian, and Pinar Tözün. Hybrid Transactional/Analytical Processing: A Survey. At ACM International Conference on Management of Data (SIGMOD), May 2017. doi:10.1145/3035918.3054784 ↩︎
Adam Prout, Szu-Po Wang, Joseph Victor, Zhou Sun, Yongzhu Li, Jack Chen, Evan Bergeron, Eric Hanson, Robert Walzer, Rodrigo Gomes, and Nikita Shamgunov. Cloud-Native Transactions and Analytics in SingleStore. At International Conference on Management of Data (SIGMOD), June 2022. doi:10.1145/3514221.3526055 ↩︎ ↩︎
Chao Zhang, Guoliang Li, Jintao Zhang, Xinning Zhang, and Jianhua Feng. HTAP Databases: A Survey. IEEE Transactions on Knowledge and Data Engineering, April 2024. doi:10.1109/TKDE.2024.3389693 ↩︎
Michael Stonebraker and Uğur Çetintemel. ‘One Size Fits All’: An Idea Whose Time Has Come and Gone. At 21st International Conference on Data Engineering (ICDE), April 2005. doi:10.1109/ICDE.2005.1 ↩︎
Jeffrey Cohen, Brian Dolan, Mark Dunlap, Joseph M. Hellerstein, and Caleb Welton. MAD Skills: New Analysis Practices for Big Data. Proceedings of the VLDB Endowment, volume 2, issue 2, pages 1481–1492, August 2009. doi:10.14778/1687553.1687576 ↩︎
Dan Olteanu. The Relational Data Borg is Learning. Proceedings of the VLDB Endowment, volume 13, issue 12, August 2020. doi:10.14778/3415478.3415572 ↩︎
Matt Bornstein, Martin Casado, and Jennifer Li. Emerging Architectures for Modern Data Infrastructure: 2020. future.a16z.com, October 2020. Archived at perma.cc/LF8W-KDCC ↩︎
Martin Fowler. DataLake. martinfowler.com, February 2015. Archived at perma.cc/4WKN-CZUK ↩︎
Bobby Johnson and Joseph Adler. The Sushi Principle: Raw Data Is Better. At Strata+Hadoop World, February 2015. ↩︎
Michael Armbrust, Ali Ghodsi, Reynold Xin, and Matei Zaharia. Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics. At 11th Annual Conference on Innovative Data Systems Research (CIDR), January 2021. ↩︎
DataKitchen, Inc. The DataOps Manifesto. dataopsmanifesto.org, 2017. Archived at perma.cc/3F5N-FUQ4 ↩︎
Tejas Manohar. What is Reverse ETL: A Definition & Why It’s Taking Off. hightouch.io, November 2021. Archived at perma.cc/A7TN-GLYJ ↩︎
Simon O’Regan. Designing Data Products. towardsdatascience.com, August 2018. Archived at perma.cc/HU67-3RV8 ↩︎
Camille Fournier. Why is it so hard to decide to buy? skamille.medium.com, July 2021. Archived at perma.cc/6VSG-HQ5X ↩︎
David Heinemeier Hansson. Why we’re leaving the cloud. world.hey.com, October 2022. Archived at perma.cc/82E6-UJ65 ↩︎
Nima Badizadegan. Use One Big Server. specbranch.com, August 2022. Archived at perma.cc/M8NB-95UK ↩︎ ↩︎
Steve Yegge. Dear Google Cloud: Your Deprecation Policy is Killing You. steve-yegge.medium.com, August 2020. Archived at perma.cc/KQP9-SPGU ↩︎
Alexandre Verbitski, Anurag Gupta, Debanjan Saha, Murali Brahmadesam, Kamal Gupta, Raman Mittal, Sailesh Krishnamurthy, Sandor Maurice, Tengiz Kharatishvili, and Xiaofeng Bao. Amazon Aurora: Design Considerations for High Throughput Cloud-Native Relational Databases. At ACM International Conference on Management of Data (SIGMOD), pages 1041–1052, May 2017. doi:10.1145/3035918.3056101 ↩︎ ↩︎ ↩︎
Panagiotis Antonopoulos, Alex Budovski, Cristian Diaconu, Alejandro Hernandez Saenz, Jack Hu, Hanuma Kodavalla, Donald Kossmann, Sandeep Lingam, Umar Farooq Minhas, Naveen Prakash, Vijendra Purohit, Hugh Qu, Chaitanya Sreenivas Ravella, Krystyna Reisteter, Sheetal Shrotri, Dixin Tang, and Vikram Wakade. Socrates: The New SQL Server in the Cloud. At ACM International Conference on Management of Data (SIGMOD), pages 1743–1756, June 2019. doi:10.1145/3299869.3314047 ↩︎ ↩︎ ↩︎
Midhul Vuppalapati, Justin Miron, Rachit Agarwal, Dan Truong, Ashish Motivala, and Thierry Cruanes. Building An Elastic Query Engine on Disaggregated Storage. At 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI), February 2020. ↩︎ ↩︎ ↩︎ ↩︎
Nick Van Wiggeren. The Real Failure Rate of EBS. planetscale.com, March 2025. Archived at perma.cc/43CR-SAH5 ↩︎
Colin Breck. Predicting the Future of Distributed Systems. blog.colinbreck.com, August 2024. Archived at perma.cc/K5FC-4XX2 ↩︎
Gwen Shapira. Compute-Storage Separation Explained. thenile.dev, January 2023. Archived at perma.cc/QCV3-XJNZ ↩︎
Ravi Murthy and Gurmeet Goindi. AlloyDB for PostgreSQL under the hood: Intelligent, database-aware storage. cloud.google.com, May 2022. Archived at archive.org ↩︎
Jack Vanlightly. The Architecture of Serverless Data Systems. jack-vanlightly.com, November 2023. Archived at perma.cc/UDV4-TNJ5 ↩︎
Eric Jonas, Johann Schleier-Smith, Vikram Sreekanti, Chia-Che Tsai, Anurag Khandelwal, Qifan Pu, Vaishaal Shankar, Joao Carreira, Karl Krauth, Neeraja Yadwadkar, Joseph E. Gonzalez, Raluca Ada Popa, Ion Stoica, David A. Patterson. Cloud Programming Simplified: A Berkeley View on Serverless Computing. arxiv.org, February 2019. ↩︎ ↩︎
Betsy Beyer, Jennifer Petoff, Chris Jones, and Niall Richard Murphy. Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media, 2016. ISBN: 9781491929124 ↩︎
Thomas Limoncelli. The Time I Stole $10,000 from Bell Labs. ACM Queue, volume 18, issue 5, November 2020. doi:10.1145/3434571.3434773 ↩︎
Charity Majors. The Future of Ops Jobs. acloudguru.com, August 2020. Archived at perma.cc/GRU2-CZG3 ↩︎
Boris Cherkasky. (Over)Pay As You Go for Your Datastore. medium.com, September 2021. Archived at perma.cc/Q8TV-2AM2 ↩︎
Shlomi Kushchi. Serverless Doesn’t Mean DevOpsLess or NoOps. thenewstack.io, February 2023. Archived at perma.cc/3NJR-AYYU ↩︎
Erik Bernhardsson. Storm in the stratosphere: how the cloud will be reshuffled. erikbern.com, November 2021. Archived at perma.cc/SYB2-99P3 ↩︎
Benn Stancil. The data OS. benn.substack.com, September 2021. Archived at perma.cc/WQ43-FHS6 ↩︎
Maria Korolov. Data residency laws pushing companies toward residency as a service. csoonline.com, January 2022. Archived at perma.cc/CHE4-XZZ2 ↩︎
Severin Borenstein. Can Data Centers Flex Their Power Demand? energyathaas.wordpress.com, April 2025. Archived at https://perma.cc/MUD3-A6FF ↩︎
Bilge Acun, Benjamin Lee, Fiodar Kazhamiaka, Aditya Sundarrajan, Kiwan Maeng, Manoj Chakkaravarthy, David Brooks, and Carole-Jean Wu. Carbon Dependencies in Datacenter Design and Management. ACM SIGENERGY Energy Informatics Review, volume 3, issue 3, pages 21–26. doi:10.1145/3630614.3630619 ↩︎
Kousik Nath. These are the numbers every computer engineer should know. freecodecamp.org, September 2019. Archived at perma.cc/RW73-36RL ↩︎
Joseph M. Hellerstein, Jose Faleiro, Joseph E. Gonzalez, Johann Schleier-Smith, Vikram Sreekanti, Alexey Tumanov, and Chenggang Wu. Serverless Computing: One Step Forward, Two Steps Back. At Conference on Innovative Data Systems Research (CIDR), January 2019. ↩︎
Frank McSherry, Michael Isard, and Derek G. Murray. Scalability! But at What COST? At 15th USENIX Workshop on Hot Topics in Operating Systems (HotOS), May 2015. ↩︎ ↩︎
Cindy Sridharan. Distributed Systems Observability: A Guide to Building Robust Systems. Report, O’Reilly Media, May 2018. Archived at perma.cc/M6JL-XKCM ↩︎
Charity Majors. Observability — A 3-Year Retrospective. thenewstack.io, August 2019. Archived at perma.cc/CG62-TJWL ↩︎
Benjamin H. Sigelman, Luiz André Barroso, Mike Burrows, Pat Stephenson, Manoj Plakal, Donald Beaver, Saul Jaspan, and Chandan Shanbhag. Dapper, a Large-Scale Distributed Systems Tracing Infrastructure. Google Technical Report dapper-2010-1, April 2010. Archived at perma.cc/K7KU-2TMH ↩︎
Rodrigo Laigner, Yongluan Zhou, Marcos Antonio Vaz Salles, Yijian Liu, and Marcos Kalinowski. Data management in microservices: State of the practice, challenges, and research directions. Proceedings of the VLDB Endowment, volume 14, issue 13, pages 3348–3361, September 2021. doi:10.14778/3484224.3484232 ↩︎
Jordan Tigani. Big Data is Dead. motherduck.com, February 2023. Archived at perma.cc/HT4Q-K77U ↩︎ ↩︎
Sam Newman. Building Microservices, second edition. O’Reilly Media, 2021. ISBN: 9781492034025 ↩︎ ↩︎
Chris Richardson. Microservices: Decomposing Applications for Deployability and Scalability. infoq.com, May 2014. Archived at perma.cc/CKN4-YEQ2 ↩︎
Mohammad Shahrad, Rodrigo Fonseca, Íñigo Goiri, Gohar Chaudhry, Paul Batum, Jason Cooke, Eduardo Laureano, Colby Tresness, Mark Russinovich, Ricardo Bianchini. Serverless in the Wild: Characterizing and Optimizing the Serverless Workload at a Large Cloud Provider. At USENIX Annual Technical Conference (ATC), July 2020. ↩︎
Luiz André Barroso, Urs Hölzle, and Parthasarathy Ranganathan. The Datacenter as a Computer: Designing Warehouse-Scale Machines, third edition. Morgan & Claypool Synthesis Lectures on Computer Architecture, October 2018. doi:10.2200/S00874ED3V01Y201809CAC046 ↩︎ ↩︎
David Fiala, Frank Mueller, Christian Engelmann, Rolf Riesen, Kurt Ferreira, and Ron Brightwell. Detection and Correction of Silent Data Corruption for Large-Scale High-Performance Computing,” at International Conference for High Performance Computing, Networking, Storage and Analysis (SC), November 2012. doi:10.1109/SC.2012.49 ↩︎
Anna Kornfeld Simpson, Adriana Szekeres, Jacob Nelson, and Irene Zhang. Securing RDMA for High-Performance Datacenter Storage Systems. At 12th USENIX Workshop on Hot Topics in Cloud Computing (HotCloud), July 2020. ↩︎
Arjun Singh, Joon Ong, Amit Agarwal, Glen Anderson, Ashby Armistead, Roy Bannon, Seb Boving, Gaurav Desai, Bob Felderman, Paulie Germano, Anand Kanagala, Jeff Provost, Jason Simmons, Eiichi Tanda, Jim Wanderer, Urs Hölzle, Stephen Stuart, and Amin Vahdat. Jupiter Rising: A Decade of Clos Topologies and Centralized Control in Google’s Datacenter Network. At Annual Conference of the ACM Special Interest Group on Data Communication (SIGCOMM), August 2015. doi:10.1145/2785956.2787508 ↩︎
Glenn K. Lockwood. Hadoop’s Uncomfortable Fit in HPC. glennklockwood.blogspot.co.uk, May 2014. Archived at perma.cc/S8XX-Y67B ↩︎
Cathy O’Neil: Weapons of Math Destruction: How Big Data Increases Inequality and Threatens Democracy. Crown Publishing, 2016. ISBN: 9780553418811 ↩︎
Supreeth Shastri, Vinay Banakar, Melissa Wasserman, Arun Kumar, and Vijay Chidambaram. Understanding and Benchmarking the Impact of GDPR on Database Systems. Proceedings of the VLDB Endowment, volume 13, issue 7, pages 1064–1077, March 2020. doi:10.14778/3384345.3384354 ↩︎
Martin Fowler. Datensparsamkeit. martinfowler.com, December 2013. Archived at perma.cc/R9QX-CME6 ↩︎
Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016 (General Data Protection Regulation). Official Journal of the European Union L 119/1, May 2016. ↩︎
2 定义非功能性需求

互联网做得太好了,以至于大多数人将它看作像太平洋这样的自然资源,而不是什么人工产物。上一次出现这种规模且几乎不出错的技术,是什么时候?
艾伦・凯, 接受 Dr Dobb’s Journal 采访(2012 年)
构建应用程序时,你会面对一张需求清单。其中排在最前面的,很可能是应用必须提供的功能:需要哪些页面和按钮,每项操作要完成什么,才能实现软件的目的。这些就是 功能需求(functional requirements)。
此外,你可能还有一些 非功能性需求(nonfunctional requirements):例如,应用应当快速、可靠、安全、符合法律规定,而且易于维护。这些要求未必会明确写下来,因为它们看似理所当然,但其重要性丝毫不亚于应用的功能:一个慢得让人无法忍受,或是很不可靠的应用,几乎等于不存在。
安全性等许多非功能性需求超出了本书的范围。不过,本章会讨论其中几项,并帮助你准确表述自己的系统需要达到什么要求:
- 如何定义和衡量系统的 性能(performance;参见“描述性能”);
- 服务 可靠(reliable)意味着什么——也就是即使出了问题,仍能继续正确工作(参见“可靠性与容错”);
- 随着系统负载增长,能否高效增加计算能力,使系统具备 可伸缩性(scalability;参见“可伸缩性”);以及
- 如何让系统在长期使用中更易维护(参见“可维护性”)。
后续章节深入讨论数据密集型系统的实现细节时,还会用到本章引入的术语。不过,抽象定义读起来难免枯燥。为了让这些概念更加具体,我们先从一个社交网络服务的实现案例讲起,以此说明性能与可伸缩性在实践中意味着什么。
案例研究:社交网络首页时间线
假设你的任务是实现一个类似 X(原 Twitter)的社交网络,用户可以发帖,也可以关注其他用户。这里的实现会比真实服务简单得多 1 2 3,但足以说明大规模系统会遇到的一些问题。
假设用户每天发布 5 亿条帖子,平均每秒 5,700 条;偶尔,发帖速率会飙升至每秒 150,000 条 4。再假设每位用户平均关注 200 人,也有 200 名关注者(实际分布范围非常广:大多数人只有寥寥几名关注者,而巴拉克・奥巴马等少数名人则有超过一亿名关注者)。
表示用户、帖子与关注关系
假设我们把所有数据都保存在关系数据库中,如图 2-1所示:一张表存储用户,一张表存储帖子,还有一张表存储关注关系。

假设这个社交网络需要支持的主要读操作是 首页时间线(home timeline),用来展示你所关注的人最近发布的帖子(为简单起见,我们忽略广告、来自未关注用户的推荐帖,以及其他扩展功能)。可以用下面这条 SQL 查询来获取某位用户的首页时间线:
执行这条查询时,数据库先用 follows 表找出 current_user 关注的所有人,再查找这些用户最近发布的帖子,并按时间戳排序,取出其中最新的 1,000 条。
帖子讲究时效,因此假设某人发帖之后,我们希望其关注者能在 5 秒内看到。一个办法是,只要用户在线,客户端就每隔 5 秒重复执行一次上述查询(这称为 轮询(polling))。如果同时在线且已登录的用户有 1,000 万,就意味着每秒要执行 200 万次查询。即使延长轮询间隔,这个数字仍然很大。
而且,这条查询本身开销不小:如果你关注了 200 人,数据库就要分别取出这 200 人最近发布的帖子,再把这些列表合并起来。每秒 200 万次时间线查询,意味着数据库每秒要查询某个发帖者的近期帖子 4 亿次——这是个惊人的数字,而且还只是平均情况。有些用户关注了数万个账户,为他们执行这条查询的代价极高,也很难保证速度。
时间线的物化与更新
怎样才能做得更好?首先,与其让客户端轮询,不如由服务器把新帖子主动推送给当前在线的关注者。其次,可以预先计算上述查询的结果,使首页时间线请求直接由缓存提供。
设想我们为每位用户保存一个数据结构,其中装着他们的首页时间线,也就是他们所关注的人最近发布的帖子。每当有人发帖,我们就找出他的所有关注者,把这条帖子插入每位关注者的首页时间线,就像把信投进一个个邮箱。这样,用户登录时只需把预先计算好的时间线交给他们即可。若要接收时间线上的新帖通知,客户端只需订阅不断加入其首页时间线的帖子流。
这种方法的缺点是,每次发帖都要完成更多工作,因为首页时间线是需要随之更新的 衍生数据(derived data)。整个过程如图 2-2所示。当一个初始请求引发多个下游请求时,我们用 扇出(fan-out) 来表示请求数量被放大的倍数。

以每秒 5,700 条帖子的速率计算,如果每条帖子平均要送达 200 名关注者(也就是扇出系数为 200),每秒就要完成略多于 100 万次首页时间线写入。这个数字依然很大,但与另一种方案每秒 4 亿次按发帖者查询近期帖子的操作相比,已经节省了很多工作。
如果某个特殊事件使发帖速率骤增,我们无须立刻完成所有时间线投递;可以先把投递任务放入队列,并接受帖子暂时要过一会儿才会出现在关注者的时间线上。即使出现这种负载高峰,时间线仍然可以快速加载,因为读取只需访问缓存。
这种预先计算并不断更新查询结果的过程称为 物化(materialization),时间线缓存就是一个 物化视图(materialized view) 的例子(我们会在“维护物化视图”中进一步讨论这个概念)。物化视图加快了读取,代价则是写入时要做更多工作。对大多数用户而言,写入成本并不高,但社交网络还必须考虑一些极端情况:
- 如果一位用户关注了非常多的账户,而且这些账户发帖频繁,那么写入其物化时间线的速率会很高。不过,这位用户多半也不会读完时间线中的所有帖子,因此可以丢弃其中一部分时间线写入,只向用户展示所关注账户发布帖子的一个样本 5。
- 如果一位拥有海量关注者的名人发帖,我们就要完成大量工作,把这条帖子插入数百万人的首页时间线。在这种情况下,丢弃部分写入是不可接受的。一种解决办法是把名人帖子与其他人的帖子分开处理:不必费力把名人帖子加入数百万条时间线,而是将其单独存储,等读取时再与物化时间线合并。即使采用这类优化,社交网络要承载名人账户仍可能需要大量基础设施 6。
描述性能
讨论软件性能时,通常会考虑两类主要指标:
- 响应时间(response time)
- 从用户发出请求到收到所需响应所经过的时间。计量单位是秒(或毫秒、微秒)。
- 吞吐量(throughput)
- 系统每秒处理的请求数或数据量。对于给定的硬件资源,系统能处理的吞吐量存在上限,也就是 最大吞吐量(maximum throughput)。计量单位通常写成“每秒多少个……”。
在社交网络案例中,“每秒帖子数”和“每秒时间线写入数”是吞吐量指标;“加载首页时间线所需的时间”和“帖子送达关注者所需的时间”则是响应时间指标。
吞吐量和响应时间之间往往存在联系,图 2-3勾勒了在线服务中二者的一种典型关系。请求吞吐量较低时,服务的响应时间也很短;随着负载增大,响应时间随之上升。这是 排队(queueing)造成的:当请求到达负载很高的系统时,CPU 很可能正在处理先前的请求,新来的请求只好等到前一个处理完毕。当吞吐量逐渐逼近硬件的处理极限时,排队延迟会急剧增加。

当系统濒临过载、吞吐量已被推到极限附近时,有时会陷入恶性循环:系统效率越来越低,因而变得更加过载。例如,等待处理的请求排起长队,响应时间可能因此增长到客户端超时并重发请求。请求速率随之进一步上升,让问题愈演愈烈——这就是 重试风暴(retry storm)。即使负载随后下降,系统也可能一直停留在过载状态,直到重启或以其他方式重置。这种现象称为 亚稳态故障(metastable failure),它可能导致生产系统严重中断 7 8。
为了避免重试压垮服务,可以在客户端逐渐延长并随机扰动连续重试之间的等待时间(指数退避,exponential backoff 9 10)。还可以采用 熔断器(circuit breaker)11 12 或 令牌桶(token bucket)算法 13,暂时停止向最近曾返回错误或发生超时的服务发送请求。服务器也可以在察觉自己接近过载时主动拒绝请求(负载卸除,load shedding 14),并在响应中要求客户端降低发送速率(背压,backpressure 1 15)。排队算法和负载均衡算法的选择同样会产生影响 16。
在各项性能指标中,用户通常最关心响应时间;吞吐量则决定了所需的计算资源(例如服务器数量),从而决定处理特定工作负载的成本。如果吞吐量可能增长到超出当前硬件的处理能力,就需要扩充容量。如果增加计算资源能够显著提高系统的最大吞吐量,我们就称这个系统具有 可伸缩性(scalability)。
本节主要关注响应时间;我们会在“可伸缩性”一节回头讨论吞吐量与可伸缩性。
延迟与响应时间
“延迟”和“响应时间”有时会被混为一谈,但本书将按下面的特定含义使用这几个术语(如图 2-4所示):
- 响应时间(response time)是客户端看到的时间,其中包括系统各处产生的全部延误。
- 服务时间(service time)是服务真正用于处理用户请求的时间。
- 排队延迟(queueing delay)可能发生在流程中的多个位置。例如,请求到达后,也许必须等到 CPU 空闲才能开始处理;如果同一台机器上的其他任务正在通过出站网络接口发送大量数据,响应数据包也可能先在缓冲区中等待。
- 延迟(latency)泛指请求没有得到实际处理的时间,也就是请求处于 潜伏(latent) 状态的时间。具体来说,网络延迟(network latency)或 网络时延(network delay)是请求和响应在网络中传输所花的时间。

在图 2-4中,时间从左向右流逝;参与通信的每个节点用一条水平线表示,请求或响应消息则画成从一个节点指向另一个节点的粗斜箭头。本书后面还会经常遇到这种图示方式。
即使反复发送同一个请求,每次的响应时间也可能相差很大。许多因素都会带来随机的额外延迟,例如:上下文切换到后台进程、网络丢包和 TCP 重传、垃圾回收暂停、缺页迫使系统从磁盘读取数据、服务器机架的机械振动 17,等等。我们会在“超时和无界延迟”中进一步讨论这个问题。
响应时间的波动很大一部分往往来自排队延迟。服务器同时能处理的任务数量有限(例如受 CPU 核数限制),因此只需少数几个慢请求,就足以阻碍后续请求,这种现象称为 队头阻塞(head-of-line blocking)。即使后续请求本身的服务时间很短,客户端看到的总体响应时间仍会很长,因为它们要等待先前的请求完成。排队延迟不属于服务时间,所以在客户端测量响应时间十分重要。
平均值、中位数与分位数
由于每次请求的响应时间都不一样,我们不能只把它看成一个数字,而应将其视为一组可测量数值的 分布(distribution)。在图 2-5中,每根灰色柱条代表一次服务请求,柱条的高度表示这次请求所花的时间。大多数请求都相当快,但偶尔会出现耗时长得多的 异常值(outlier)。网络延迟的变化也称为 抖动(jitter)。

服务通常会报告 平均(mean)响应时间,也就是 算术平均值(arithmetic mean):把所有响应时间相加,再除以请求数。平均响应时间有助于估算吞吐量的上限 18。不过,如果你想知道“典型”的响应时间,平均值就不是很好的指标,因为它没有告诉你究竟有多少用户实际经历了这样的等待。
通常,采用 分位数(percentile) 更合适。将响应时间从快到慢排列,中位数(median)就是位于正中间的值。例如,如果响应时间的中位数是 200 毫秒,就意味着一半请求用时不到 200 毫秒,另一半则需要更长时间。因此,如果想知道用户通常要等多久,中位数是个很好的指标。中位数也称为 第 50 分位数,有时缩写为 p50。
为了弄清异常值究竟有多糟,可以观察更高的分位数。常用的有第 95、99 和 99.9 分位数,分别缩写为 p95、p99 和 p999。它们对应这样一个响应时间阈值:分别有 95%、99% 或 99.9% 的请求快于这个阈值。例如,如果第 95 分位数的响应时间是 1.5 秒,就意味着每 100 个请求中,有 95 个用时不到 1.5 秒,另外 5 个则需要 1.5 秒或更久。图 2-5对此作了说明。
响应时间的高分位数也称为 尾延迟(tail latencies),它们十分重要,因为会直接影响用户对服务的体验。例如,亚马逊用第 99.9 分位数来描述内部服务的响应时间要求,尽管它只影响每 1,000 个请求中的一个。这是因为,响应最慢的客户往往是在账户中积累了最多数据的人——他们购买过很多商品,也就是最有价值的客户 19。确保网站对这些客户同样快速,是维持其满意度的重要手段。
另一方面,亚马逊认为,针对第 99.99 分位数(每 10,000 个请求中最慢的一个)进行优化,成本过高,收益又不足。降低极高分位数处的响应时间非常困难,因为它很容易受到不可控随机事件的影响,而且越往后收益越小。
从直觉上说,速度快的服务当然比慢的服务更受用户欢迎 20。然而,要获得可靠数据,量化延迟对用户行为的影响,却出人意料地困难。
一些经常被引用的数据并不可靠。2006 年,Google 报告称,搜索结果的响应时间从 400 毫秒增加到 900 毫秒,与流量和收入下降 20% 存在相关性 21。然而,Google 在 2009 年的另一项研究中又报告说,延迟增加 400 毫秒,只使每天的搜索次数减少了 0.6% 22;同年,Bing 发现加载时间增加 2 秒会使广告收入减少 4.3% 23。这些公司似乎没有公开过更新的数据。
Akamai 一项较新的研究 24 声称,响应时间增加 100 毫秒,会使电子商务网站的转化率最多下降 7%。然而仔细查看就会发现,同一项研究还显示,加载速度 非常快 的页面也与较低的转化率相关!这个看似矛盾的结果可以这样解释:加载最快的往往是没有有用内容的页面,例如 404 错误页面。该研究没有尝试把页面内容的影响与加载时间的影响区分开来,因此其结果恐怕没有什么意义。
Yahoo 的一项研究 25 在控制搜索结果质量的前提下,比较了加载较快和较慢的搜索结果的点击率。研究发现,当快、慢响应相差 1.25 秒或更久时,快速搜索获得的点击量会多出 20%~30%。
响应时间指标的应用
如果后端服务要为一次最终用户请求执行多次调用,那么高分位数尤其重要。即使这些调用并行发出,最终用户请求仍要等待其中最慢的一次完成。正如图 2-6所示,只需一个慢调用,就足以拖慢整个最终用户请求。即使后端调用中只有很小一部分速度较慢,一次最终用户请求所需的后端调用越多,其中出现慢调用的概率也就越大,最终会有更高比例的用户请求变慢。这种效应称为 尾部延迟放大(tail latency amplification) 26。

分位数经常出现在 服务级别目标(SLO) 和 服务级别协议(SLA) 中,用来规定服务应达到的性能和可用性 27。例如,一项 SLO 可能要求服务的中位响应时间低于 200 毫秒、第 99 分位数的响应时间低于 1 秒,并要求至少 99.9% 的有效请求得到非错误响应。SLA 则是一份合同,规定未达到 SLO 时会怎样处理(例如,客户可能有权获得退款)。这至少是其基本思路;在实践中,要为 SLO 和 SLA 定义良好的可用性指标并不简单 28 29。
如果想在服务的监控仪表板上加入响应时间分位数,就需要持续、高效地计算这些指标。例如,可以维护一个滚动窗口,记录最近 10 分钟内所有请求的响应时间;每隔一分钟,计算窗口中各个数值的中位数和其他分位数,并把这些指标绘制在图表上。
最简单的实现是保存时间窗口内所有请求的响应时间列表,并每分钟对它排序一次。如果这样做效率太低,也有一些算法能够以极低的 CPU 和内存开销,算出相当准确的分位数近似值。用于估算分位数的开源库包括 HdrHistogram、t-digest 30 31、OpenHistogram 32 和 DDSketch 33。
注意,对分位数取平均值——例如为了降低时间分辨率,或合并多台机器的数据——在数学上没有意义。聚合响应时间数据的正确方法是把直方图相加 34。
可靠性与容错
每个人对于一个东西是否可靠,都有直观的判断。人们对可靠软件的典型期望包括:
- 应用程序表现出用户所期望的功能。
- 允许用户犯错,或以出乎意料的方式使用软件。
- 在预期的负载和数据量下,性能足以满足所需的使用场景。
- 系统能防止未经授权的访问和滥用。
如果把这些合在一起称为“正确工作”,那么 可靠性(reliability) 可以粗略理解为“即使出了问题,也能继续正确工作”。为了更准确地描述所谓“出了问题”,我们要区分 故障(fault) 和 失效(failure) 35 36 37:
- 故障
- 系统的某个 部分 停止正常工作。例如,单块硬盘发生故障、单台机器崩溃,或者系统所依赖的外部服务中断。
- 失效
- 整个系统 停止向用户提供所需的服务;换言之,系统没有达到服务级别目标(SLO)。
故障与失效之所以容易混淆,是因为二者其实是同一件事,只是观察的层次不同。例如,如果一块硬盘停止工作,我们会说这块硬盘失效了:若整个系统只有这一块硬盘,系统也就停止了提供所需服务。然而,如果我们谈论的是一个包含许多硬盘的系统,那么单块硬盘失效从整个系统的角度看只是一项故障;只要数据在另一块硬盘上还有副本,整个系统就可能容忍这项故障。
容错
如果某些故障发生时,系统仍能继续向用户提供所需服务,我们就称它是 容错的(fault-tolerant)。如果系统无法容忍某个部分出现故障,这个部分就称为 单点故障(SPOF),因为它一旦发生故障,就会升级为整个系统的失效。
以社交网络案例为例,扇出过程中可能发生这样一种故障:负责更新物化时间线的某台机器崩溃或变得不可用。要让这个过程具备容错能力,就必须确保另一台机器能接手这项任务,既不漏掉任何本应投递的帖子,也不会重复投递。(这个思想称为 恰好一次语义(exactly-once semantics),我们会在“数据库的端到端原则”中详细讨论。)
容错能力总是针对特定类型、特定数量的故障而言。例如,一个系统也许最多能容忍两块硬盘同时失效,或三个节点中有一个崩溃。要求系统容忍任意数量的故障没有意义:如果所有节点都崩溃了,任何办法都无济于事。如果整个地球(以及上面的所有服务器)都被黑洞吞噬,要容忍这项故障就得把网站托管到太空中——祝你好运,看看这笔预算能不能获批。
反直觉的是,在这类容错系统中,通过故意触发故障来 提高 故障率有时反而是合理的,例如毫无预警地随机杀死某个进程。这称为 故障注入(fault injection)。许多严重缺陷其实源于糟糕的错误处理 38;故意制造故障,可以让容错机制不断得到演练和检验,从而增强我们的信心:当故障自然发生时,系统确实能够正确处理。混沌工程(chaos engineering) 就是一门通过故障注入等实验来增强人们对容错机制信心的学科 39。
虽然比起预防故障,我们通常更倾向于容忍故障,但有时预防确实胜于治疗(例如根本无药可救时)。安全问题就是如此:如果攻击者已经攻破系统并获得敏感数据,这件事无法撤销。不过,本书主要讨论的是能够补救的故障类型,下面几节会作进一步说明。
硬件与软件故障
说到系统失效的原因,人们很容易首先想到硬件故障:
- 每年大约有 2%~5% 的机械硬盘发生故障 40 41;因此,在拥有 10,000 块硬盘的存储集群中,平均每天应该会有一块硬盘失效。近期数据表明硬盘越来越可靠,但故障率仍不容忽视 42。
- 每年大约有 0.5%~1% 的固态硬盘(SSD)发生故障 43。少量比特错误会自动得到纠正 44,但每块硬盘大约每年仍会发生一次无法纠正的错误,即使硬盘相当新(也就是磨损很少)也不例外;这个错误率高于机械硬盘 45 46。
- 电源、RAID 控制器和内存模块等其他硬件组件也会发生故障,只是没有硬盘那么频繁 47 48。
- 大约每 1,000 台机器中,就有一台的某个 CPU 核心偶尔会算出错误结果,原因很可能是制造缺陷 49 50 51。错误计算有时会导致崩溃,有时却只是让程序返回错误的结果。
- RAM 中的数据也可能损坏,原因既可能是宇宙射线等随机事件,也可能是永久性的物理缺陷。即使采用纠错码(ECC)内存,一年内仍会有超过 1% 的机器遇到无法纠正的错误,通常会导致机器崩溃,并且需要更换受影响的内存模块 52。此外,某些病态的内存访问模式很可能导致比特翻转 53。
- 整个数据中心可能变得不可用(例如停电或网络配置错误),甚至遭到永久摧毁(例如火灾、洪水或地震 54)。太阳喷发大量带电粒子所形成的太阳风暴,会在长距离导线中感应出很强的电流,可能破坏电网和海底网络电缆 55。这类大规模失效虽然少见,但如果服务不能容忍整个数据中心的丢失,后果可能是灾难性的 56。
这些事件相当少见,因此在小型系统中,只要故障硬件很容易更换,通常不必为之过分担心。然而,在大规模系统里,硬件故障发生得足够频繁,已经成了系统正常运行的一部分。
通过冗余容忍硬件故障
面对不可靠的硬件,我们通常首先想到为各个硬件组件增加冗余,以降低整个系统的失效率。磁盘可以组成 RAID(把数据分散到同一台机器的多块磁盘上,使单块磁盘失效不至于造成数据丢失);服务器可以配备双路电源和可热插拔的 CPU;数据中心可以用电池和柴油发电机提供备用电源。这些冗余措施往往能让一台机器连续运行多年而不中断。
当各个组件的故障彼此独立时,冗余最有效;所谓独立,就是一项故障的发生不会改变另一项故障发生的概率。然而,实践表明,组件失效之间往往存在显著的相关性 41 57 58;整个服务器机架乃至整个数据中心不可用的情况,仍然比我们希望的更加常见。
硬件冗余可以提高单台机器的正常运行时间。不过,正如“分布式与单节点系统”中所述,采用分布式系统还有其他好处,例如能够容忍整个数据中心中断。因此,云系统往往不那么强调单台机器的可靠性,而是力求在软件层面容忍节点故障,让服务实现高可用。云提供商用 可用区(availability zone) 来标明哪些资源在物理上位于同一处;与地理位置分散的资源相比,同一地点的资源更可能同时失效。
本书讨论的容错技术,旨在容忍整台机器、整个机架或整个可用区的丢失。它们通常允许一个数据中心内的机器,在另一个数据中心内的机器发生故障或变得不可达时接替其工作。我们会在第 6 章、第 10 章以及本书其他多处讨论这类容错技术。
能够容忍整台机器丢失的系统,在运维上也有优势。如果需要重启机器(例如安装操作系统安全补丁),单服务器系统必须安排停机;而多节点容错系统可以逐个重启节点来安装补丁,不影响向用户提供服务。这称为 滚动升级(rolling upgrade),我们会在第 5 章进一步讨论。
软件故障
尽管硬件失效之间可能存在较弱的相关性,但大体上仍然相互独立。例如,一块硬盘失效以后,同一台机器上的其他硬盘很可能还能继续正常工作一段时间。相比之下,软件故障往往高度相关,因为许多节点通常运行同一套软件,也就带有同样的缺陷 59 60。这类故障更难预见,而且比互不相关的硬件故障更容易造成系统失效 47。例如:
- 一个软件缺陷在特定情况下导致所有节点同时失效。例如,2012 年 6 月 30 日的一次闰秒触发了 Linux 内核中的缺陷,使许多 Java 应用程序同时挂起,大量互联网服务随之中断 61。另一个例子是,由于固件缺陷,某些型号的 SSD 会在恰好运行 32,768 小时(不到 4 年)后突然全部失效,盘上的数据再也无法恢复 62。
- 某个失控进程耗尽 CPU 时间、内存、磁盘空间、网络带宽或线程等共享而有限的资源 63。例如,进程在处理大型请求时消耗了过多内存,可能被操作系统杀死;客户端库中的缺陷也可能产生远高于预期的请求量 64。
- 系统所依赖的某项服务变慢、失去响应,或开始返回内容损坏的响应。
- 不同系统之间的交互产生涌现行为,而每个系统单独测试时都不会出现这种行为 65。
- 发生级联失效:一个组件的问题导致另一个组件过载并变慢,后者继而又拖垮下一个组件 66 67。
引发这类软件故障的缺陷往往会潜伏很久,直到一组不同寻常的条件将其触发。这时人们才发现,软件原来对运行环境作出了某种假设;这个假设通常都成立,却最终会出于某种原因不再成立 68 69。
软件中的系统性故障没有速效药,但许多小措施都能有所帮助:认真思考系统中的假设和交互,开展彻底的测试,隔离进程,允许进程崩溃并重启,避免重试风暴之类的反馈环路(参见“当过载系统无法恢复时”),并在生产环境中度量、监控和分析系统行为。
人类与可靠性
软件系统由人设计和构建,维持系统运行的运维人员同样也是人。与机器不同,人类不只是照章行事;他们的长处正是能够发挥创造力、随机应变,把工作完成。不过,这一特点也会带来不可预测性:即使出发点再好,人也会犯错,有时还会导致系统失效。例如,一项针对大型互联网服务的研究发现,运维人员修改配置是服务中断的首要原因,而硬件故障(服务器或网络)只在 10%~25% 的中断中起了作用 70。
人们很容易把这类问题归结为“人为错误”,并幻想通过更严格的流程和更严密的规则来约束人的行为,从而解决问题。然而,把错误归咎于个人往往适得其反。所谓“人为错误”其实并不是事故的根本原因,而是人与技术共同构成的 社会技术系统(sociotechnical system)出了问题的一种症状;身处其中的人只是在竭尽所能地完成工作 71。复杂系统也常常表现出涌现行为,组件之间出人意料的交互同样可能导致失效 72。
多种技术手段都能减小人为失误的影响,包括:彻底测试(既包括手写测试,也包括用大量随机输入进行的 属性测试,property-based testing)38;提供回滚机制,以便迅速撤销配置变更;逐步发布新代码;提供详细而清晰的监控,以及用于诊断生产问题的可观测性工具(参见“分布式系统的问题”);精心设计界面,使“做正确的事”更加容易,“做错误的事”更加困难。
不过,这些措施都要投入时间和金钱。在日常经营的现实压力下,组织往往优先考虑能够创造收入的工作,而不是提高自身抵御失误能力的措施。如果必须在开发更多功能和开展更多测试之间选择,许多组织选择功能也不难理解。既然作出了这样的选择,当本可避免的错误不可避免地发生时,再去责怪犯错的人便毫无道理——真正的问题在于组织如何设定优先级。
越来越多的组织开始形成 无责复盘(blameless postmortem) 的文化:事故发生后,鼓励所有参与者毫无保留地讲清事情经过,不必担心受到惩罚;这样,组织中的其他人才能从中学习,避免今后再发生类似问题 73。复盘过程也许会发现,业务优先级需要调整,长期遭到忽视的领域需要投入,相关人员的激励机制需要改变,或者还有其他系统性问题需要提请管理层关注。
一般而言,调查事故时应当警惕过分简单的答案。“鲍勃部署这项变更时应该更加小心”无助于解决问题,“我们必须用 Haskell 重写后端”同样如此。管理层应当抓住机会,从每天使用这个社会技术系统的一线人员那里了解它究竟如何运作,再根据这些反馈采取措施加以改进 71。
可靠性并不只对核电站和空中交通管制系统重要;人们同样期望更平常的应用能够可靠工作。商务应用程序中的缺陷会降低生产率(如果报告的数字有误,还会带来法律风险),电子商务网站中断则可能造成巨额收入损失,并损害企业声誉。
对许多应用来说,暂时中断几分钟乃至几小时尚可容忍 74,但永久丢失或损坏数据却会是一场灾难。设想一位家长把孩子所有的照片和视频都保存在你的照片应用中 75。如果数据库突然损坏,他们会有什么感受?他们知道怎样从备份恢复吗?
英国邮局的 Horizon 丑闻,是不可靠的软件伤害人的另一个例子。1999 至 2019 年间,数百名经营英国邮局网点的人被判盗窃或欺诈罪,只因会计软件显示他们的账目存在短缺。最终人们发现,其中许多短缺其实源于软件缺陷,此后已有许多判决被撤销 76。这场或许是英国历史上最大的司法不公之所以发生,是因为英格兰法律假定计算机能够正确运行,因此也假定计算机产生的证据可靠,除非有人能提出反证 77。软件工程师也许会觉得“软件没有任何缺陷”的想法十分可笑,但那些因为不可靠的计算机系统而被错误定罪、遭到监禁、宣告破产,甚至自杀的人,却无法从中得到丝毫安慰。
在有些情况下,我们可能会为了降低开发成本而牺牲可靠性(例如为尚未验证的市场开发产品原型)。但我们必须清楚地意识到自己何时正在走捷径,并始终牢记可能造成的后果。
可伸缩性
系统今天能可靠运行,并不意味着将来也一定能够可靠运行。系统退化的一个常见原因是负载增加:也许并发用户从 10,000 人增长到了 100,000 人,或者从 100 万人增长到了 1,000 万人;也许系统现在处理的数据量比过去大得多。
可伸缩性(scalability) 是描述系统应对负载增长能力的术语。讨论可伸缩性时,人们有时会说:“你又不是 Google 或 Amazon。别再担心规模问题了,用关系数据库就好。”这句话是否适用于你,要看你构建的究竟是哪一类应用。
如果你正在构建一个目前用户不多的新产品,例如初创公司的新业务,压倒一切的工程目标通常是让系统尽可能简单、灵活;这样,随着你逐渐了解客户的需求,就能轻松修改和调整产品功能 78。在这种环境中,为将来或许才需要的假想规模忧心忡忡,只会适得其反:往好里说,对可伸缩性的投入是白费力气和过早优化;往坏里说,它会把你困在一个不灵活的设计中,让应用更难演化。
这是因为,可伸缩性并不是一个一维的标签。简单地说“X 是可伸缩的”或“Y 无法伸缩”毫无意义。讨论可伸缩性,真正要考虑的是下面这些问题:
*“如果系统按某种方式增长,我们有哪些应对选项?” *“我们如何增加计算资源来承载额外负载?” *“按当前的增长预期,什么时候会达到现有架构的极限?”
如果应用大受欢迎,因而需要处理不断增长的负载,你会逐渐知道性能瓶颈在哪里,也就清楚系统需要沿着哪些维度扩展。到那时,再开始认真考虑可伸缩性技术也不迟。
描述负载
首先,我们需要简明地描述系统当前的负载;只有这样,才能继续讨论增长问题(例如负载翻倍会发生什么)。这种描述通常是某项吞吐量指标,例如服务每秒收到的请求数、每天新增多少 GB 数据,或每小时完成的购物车结账次数。有时,我们关心的是某个变量的峰值,例如“案例研究:社交网络首页时间线”中的同时在线用户数。
负载往往还有其他统计特征,它们同样会影响访问模式,进而影响系统对可伸缩性的要求。例如,你可能需要知道数据库的读写比例、缓存命中率,或每位用户拥有的数据项数量(例如社交网络案例中的关注者人数)。有时平均情况最重要,有时瓶颈却由少数极端情况主导。一切都取决于具体应用的细节。
描述好系统负载以后,就可以研究负载增加时会发生什么。我们可以从两个角度来看:
- 以某种方式增加负载,而系统资源(CPU、内存、网络带宽等)保持不变,系统性能会受到什么影响?
- 以某种方式增加负载,而你希望性能保持不变,需要增加多少资源?
通常,我们的目标是在满足 SLA 性能要求(参见“响应时间指标的应用”)的同时,尽可能降低系统的运行成本。所需的计算资源越多,成本就越高。某些硬件也许比另一些更具性价比,而随着新型硬件出现,这些因素也会随时间变化。
如果资源增加一倍,就能在性能不变的情况下处理两倍负载,我们称系统具备 线性可伸缩性(linear scalability),这通常是一件好事。偶尔,由于规模经济或峰值负载分布得更加均匀,不到两倍的资源也能处理两倍的负载 79 80。更常见的情况是,成本增长得比线性更快,造成这种低效的原因可能有很多。例如,系统拥有大量数据时,即使写入请求本身大小相同,处理一次写入所需的工作也可能多于数据量较小时。
共享内存、共享磁盘与无共享架构
增加服务硬件资源最简单的办法,就是把服务迁移到更强大的机器上。单个 CPU 核心的速度已经不再显著提高,但你仍可以买到(或在云上租用)配有更多 CPU 核心、更大 RAM 和更多磁盘空间的机器。这种方法称为 纵向扩展(vertical scaling),也叫 向上扩展(scaling up)。
在单台机器上运行多个进程或线程,可以获得并行处理能力。同一进程中的所有线程都能访问同一块 RAM,因此这种方法也称为 共享内存架构(shared-memory architecture)。共享内存方案的问题在于,成本增长得比线性更快:硬件资源多一倍的高端机器,价格通常远远不止两倍;受各种瓶颈限制,一台规模翻倍的机器又往往处理不了两倍的负载。
另一种方案是 共享磁盘架构(shared-disk architecture):多台机器分别拥有独立的 CPU 和 RAM,却把数据存储在共同访问的一组磁盘阵列中,机器与磁盘通过高速网络连接,例如 网络附加存储(NAS) 或 存储区域网络(SAN)。这种架构过去常用于本地部署的数据仓库工作负载,但资源争用和加锁开销限制了共享磁盘方案的可伸缩性 81。
相比之下,无共享架构(shared-nothing architecture) 82(也称为 水平扩展(horizontal scaling) 或 向外扩展(scaling out))已经广受欢迎。这种方案采用包含多个节点的分布式系统,每个节点都拥有自己的 CPU、RAM 和磁盘;节点之间的一切协调,都通过普通网络在软件层完成。
无共享架构的优势是:它有望实现线性伸缩;可以使用任何性价比最好的硬件,在云端尤其如此;负载增减时更容易调整硬件资源;还可以把系统分布到多个数据中心和地域,以获得更强的容错能力。缺点则是必须显式进行分片(参见第 7 章),并且要面对分布式系统的全部复杂性(参见第 9 章)。
一些云原生数据库系统把存储和事务执行拆分成不同的服务(参见“存储与计算的分离”),让多个计算节点共享同一项存储服务。这个模型与共享磁盘架构有几分相似,但避开了老式系统的可伸缩性问题:存储服务提供的不是文件系统(NAS)或块设备(SAN)抽象,而是一套针对数据库具体需求设计的专用 API 83。
可伸缩性原则
大规模系统的架构通常高度依赖具体应用,不存在一套通用、放之四海而皆准的可伸缩架构(俗称 万金油(magic scaling sauce))。例如,处理每秒 100,000 个请求、每个请求 1 kB 的系统,与每分钟只处理 3 个请求、每个请求却有 2 GB 的系统,看起来会截然不同——尽管二者的数据吞吐量同为 100 MB/s。
而且,适合某个负载水平的架构,多半应付不了十倍于此的负载。如果你正在开发一个快速增长的服务,很可能每当负载增加一个数量级,就需要重新考虑架构。应用需求本身也很可能不断变化,因此提前为超过一个数量级之后的伸缩需求作规划,通常并不值得。
可伸缩性有一项很好的通用原则:把系统拆分成较小的组件,使它们大体上能够彼此独立地运行。这是微服务(参见“微服务与无服务器”)、分片(第 7 章)、流处理(第 12 章)和无共享架构背后的共同原则。不过,真正的挑战在于判断哪些东西应该放在一起,哪些东西应该拆开。其他书籍介绍了微服务的设计准则 84;本书则会在第 7 章讨论无共享系统中的分片。
另一项好原则是,不要让系统变得比必要的更加复杂。如果单机数据库足以完成任务,它很可能比复杂的分布式配置更可取。自动伸缩系统会根据需求自动增加或移除资源,的确很酷;但如果负载相当可预测,手动伸缩的系统在运维中也许更少出现意外(参见“运维:自动/手动再平衡”)。由 5 个服务组成的系统比由 50 个服务组成的系统更简单。优秀的架构通常务实地混合了多种方案。
可维护性
软件不会磨损,也不会像机械装置那样发生材料疲劳,因此它不会以同样的方式损坏。不过,应用程序的需求经常变化,软件运行的环境也会变化(例如依赖项和底层平台),而且软件中总有缺陷需要修复。
众所周知,软件的大部分成本不在最初的开发阶段,而在持续的维护阶段,包括修复缺陷、保持系统正常运行、调查失效、适配新的平台、为新的使用场景进行修改、偿还技术债和添加新功能 85 86。
然而,维护工作本身也很困难。一个成功运行多年的系统,很可能仍在使用如今已经没有多少工程师了解的过时技术,例如大型机和 COBOL 代码;随着人员离开组织,关于系统为何如此设计、怎样设计的组织知识可能已经丢失;维护者也许不得不修正前人留下的错误。而且,计算机系统往往与它所支撑的组织紧密交织在一起,这意味着维护这样的 遗留(legacy) 系统既是人的问题,也是技术问题 87。
我们今天构建的每个系统,只要足够有价值、能够长期存续,终有一天都会成为遗留系统。为了尽量减轻以后维护软件的人所承受的痛苦,我们设计软件时就应该考虑维护问题。虽然无法事先断定哪些决定会在未来制造维护难题,但本书会特别关注几项具有广泛适用性的原则:
- 可运维性(operability)
- 便于组织保持系统平稳运行。
- 简单性(simplicity)
- 采用人们熟知且前后一致的模式和结构,避免不必要的复杂度,使新工程师也能轻松理解系统。
- 可演化性(evolvability)
- 便于工程师将来修改系统,在需求变化时调整和扩展系统,以适应事先没有预料到的使用场景。
可运维性:让运维更轻松
我们已经在“云时代的运维”中讨论过运维的作用,并且看到,要实现可靠运维,人的流程至少与软件工具同等重要。事实上,有人认为:“良好的运维往往能绕开糟糕(或不完整)软件的局限,但即使软件很好,糟糕的运维也无法让它可靠运行” 60。
大规模系统由成千上万台机器组成,纯靠人工维护,成本高得难以承受,因此自动化必不可少。然而,自动化是一把双刃剑:总会有一些边缘情况(例如罕见的故障场景)需要运维团队人工干预。自动化无法处理的恰恰是最复杂的问题,所以自动化程度越高,反而越需要一支技能 更强 的运维团队来解决这些问题 88。
而且,自动化系统一旦出错,往往比依靠运维人员手工完成某些操作的系统更难排查。因此,对可运维性而言,自动化并非总是越多越好。一定程度的自动化依然很重要,最佳平衡点则取决于具体应用和组织的情况。
良好的可运维性意味着让日常工作更加轻松,使运维团队能把精力集中在高价值的任务上。数据系统可以通过多种方式简化日常工作 89:
- 允许监控工具检查系统的关键指标,并支持可观测性工具(参见“分布式系统的问题”),以便深入了解系统运行时的行为。许多商业工具和开源工具都能在这方面提供帮助 90。
- 避免依赖任何一台机器,使机器可以下线维护,而整个系统仍能不间断地运行。
- 提供良好的文档和易于理解的操作模型(“如果我做 X,就会发生 Y”)。
- 提供良好的默认行为,同时允许管理员在必要时覆盖默认设置。
- 在适当的时候自动修复,同时也允许管理员在必要时手动控制系统状态。
- 表现出可预测的行为,尽量避免出人意料。
简单性:管理复杂度
小型软件项目可以拥有简单讨喜、富有表现力的代码;但随着项目不断扩大,代码往往变得非常复杂,难以理解。这种复杂度拖慢了每一个需要在系统上工作的人,进一步增加了维护成本。一个陷入复杂泥潭的软件项目有时被称为 大泥球(big ball of mud) 91。
当复杂度使维护变得困难时,预算和进度安排往往都会超支。修改复杂软件也更容易引入缺陷:系统越难理解和推理,开发人员就越容易忽略隐藏的假设、无意的后果和意外的交互 69。反过来,降低复杂度可以极大提高软件的可维护性,因此简单性应该成为我们构建系统时的一项关键目标。
简单的系统更容易理解,因此我们应该尽可能用最简单的办法解决给定的问题。可惜,说起来容易,做起来却很难。事物是否简单往往取决于主观品味,并不存在衡量简单性的客观标准 92。例如,一个系统可能把复杂实现隐藏在简单接口背后,另一个系统的实现本身很简单,却向用户暴露了更多内部细节——究竟哪一个更简单?
人们曾尝试把复杂度分成 本质复杂度(essential complexity) 和 偶然复杂度(accidental complexity) 两类,以此对复杂度进行推理 93。按照这种思路,本质复杂度是应用程序问题领域所固有的,而偶然复杂度只因工具的局限而产生。不幸的是,这种区分也有缺陷,因为随着工具不断演进,本质复杂度与偶然复杂度之间的界限也会发生变化 94。
管理复杂度最好的工具之一是 抽象(abstraction)。一个好的抽象可以把大量实现细节隐藏在干净、简单易懂的外观之下,也可以广泛用于各种不同的应用。复用抽象不仅比一遍遍重新实现类似功能更加高效,也能带来更高质量的软件,因为抽象组件的质量得到改进,所有使用它的应用都会从中受益。
例如,高级编程语言是一种抽象,隐藏了机器码、CPU 寄存器和系统调用。SQL 也是一种抽象,隐藏了复杂的磁盘和内存数据结构、其他客户端发出的并发请求,以及崩溃后产生的不一致。当然,使用高级语言编程时,我们仍然用到了机器码;只不过没有 直接 使用它,因为编程语言的抽象让我们不必考虑这些细节。
为了降低应用程序代码的复杂度,可以借助 设计模式(design pattern)95 和 领域驱动设计(DDD) 96 等方法来构建抽象。本书讨论的不是这类应用专用的抽象,而是数据库事务、索引和事件日志等通用抽象;你可以在它们之上构建应用。如果你想采用 DDD 等方法,也可以把它们实现于本书所述的基础之上。
可演化性:让变化更容易
系统的需求永远不变,基本是不可能的。更可能的情况是,需求总在变化:你了解了新的事实,出现了事先未曾预料的使用场景,业务优先级发生变化,用户要求新功能,新平台取代旧平台,法律或监管要求改变,系统增长迫使架构发生变化,等等。
在组织流程方面,敏捷(Agile) 工作模式为适应变化提供了框架。敏捷社区还发展出了适合在频繁变化的环境中开发软件的技术工具和流程,例如测试驱动开发(TDD)和重构。本书则会寻找一些办法,在由多个特性各异的应用程序或服务组成的系统层面上提高敏捷性。
修改数据系统、使其适应不断变化的需求有多容易,与系统的简单性和抽象密切相关:松耦合、简单的系统通常比紧耦合、复杂的系统更容易修改。这个概念如此重要,因此我们用一个不同的词来指代数据系统层面的敏捷性:可演化性(evolvability) 97。
大型系统中的某些操作不可逆,因此必须极为谨慎地执行;这是让变更变得困难的一个主要因素 98。例如,假设你要从一个数据库迁移到另一个数据库:如果新系统出了问题却无法切回旧系统,风险就远高于能够轻松回退的情况。尽量减少不可逆性,可以提高系统的灵活性。
总结
本章考察了几种非功能性需求:性能、可靠性、可伸缩性和可维护性。在讨论这些主题的过程中,我们还遇到了贯穿全书都要用到的一些原则和术语。本章从社交网络首页时间线的实现案例入手,说明了系统规模增大时会出现的部分挑战。
我们讨论了如何衡量性能(例如采用响应时间分位数)、如何衡量系统负载(例如采用吞吐量指标),以及怎样在 SLA 中使用这些指标。可伸缩性与此密切相关:负载增加时,怎样确保性能保持不变。我们看到了一些关于可伸缩性的通用原则,例如把一项任务拆分成彼此可以独立运行的较小部分;后续章节还会深入探讨实现可伸缩性的技术细节。
为了实现可靠性,可以采用容错技术,使系统即使有某个组件(例如硬盘、机器或另一项服务)发生故障,仍能继续提供服务。我们考察了可能发生的各种硬件故障,并把它们与软件故障区分开来;软件故障往往高度相关,因此更难处理。提高可靠性的另一方面,是增强系统抵御人为失误的能力;我们还看到,无责复盘可以帮助组织从事故中学习。
最后,我们讨论了可维护性的几个方面,包括为运维团队的工作提供支持、管理复杂度,以及让应用程序的功能更容易随时间演化。实现这些目标没有简单的答案,但采用人们熟知、能够提供实用抽象的构件来搭建应用程序,确实会有所帮助。本书余下部分将介绍一系列已经在实践中证明颇有价值的构件。
参考文献
Mike Cvet. How We Learned to Stop Worrying and Love Fan-In at Twitter. At QCon San Francisco, December 2016. ↩︎ ↩︎
Raffi Krikorian. Timelines at Scale. At QCon San Francisco, November 2012. Archived at perma.cc/V9G5-KLYK ↩︎
Twitter. Twitter’s Recommendation Algorithm. blog.twitter.com, March 2023. Archived at perma.cc/L5GT-229T ↩︎
Raffi Krikorian. New Tweets per second record, and how! blog.twitter.com, August 2013. Archived at perma.cc/6JZN-XJYN ↩︎
Jaz Volpert. When Imperfect Systems are Good, Actually: Bluesky’s Lossy Timelines. jazco.dev, February 2025. Archived at perma.cc/2PVE-L2MX ↩︎
Samuel Axon. 3% of Twitter’s Servers Dedicated to Justin Bieber. mashable.com, September 2010. Archived at perma.cc/F35N-CGVX ↩︎
Nathan Bronson, Abutalib Aghayev, Aleksey Charapko, and Timothy Zhu. Metastable Failures in Distributed Systems. At Workshop on Hot Topics in Operating Systems (HotOS), May 2021. doi:10.1145/3458336.3465286 ↩︎
Marc Brooker. Metastability and Distributed Systems. brooker.co.za, May 2021. Archived at perma.cc/7FGJ-7XRK ↩︎
Marc Brooker. Exponential Backoff And Jitter. aws.amazon.com, March 2015. Archived at perma.cc/R6MS-AZKH ↩︎
Marc Brooker. What is Backoff For? brooker.co.za, August 2022. Archived at perma.cc/PW9N-55Q5 ↩︎
Michael T. Nygard. Release It!, 2nd Edition. Pragmatic Bookshelf, January 2018. ISBN: 9781680502398 ↩︎
Frank Chen. Slowing Down to Speed Up – Circuit Breakers for Slack’s CI/CD. slack.engineering, August 2022. Archived at perma.cc/5FGS-ZPH3 ↩︎
Marc Brooker. Fixing retries with token buckets and circuit breakers. brooker.co.za, February 2022. Archived at perma.cc/MD6N-GW26 ↩︎
David Yanacek. Using load shedding to avoid overload. Amazon Builders’ Library, aws.amazon.com. Archived at perma.cc/9SAW-68MP ↩︎
Matthew Sackman. Pushing Back. wellquite.org, May 2016. Archived at perma.cc/3KCZ-RUFY ↩︎
Dmitry Kopytkov and Patrick Lee. Meet Bandaid, the Dropbox service proxy. dropbox.tech, March 2018. Archived at perma.cc/KUU6-YG4S ↩︎
Haryadi S. Gunawi, Riza O. Suminto, Russell Sears, Casey Golliher, Swaminathan Sundararaman, Xing Lin, Tim Emami, Weiguang Sheng, Nematollah Bidokhti, Caitie McCaffrey, Gary Grider, Parks M. Fields, Kevin Harms, Robert B. Ross, Andree Jacobson, Robert Ricci, Kirk Webb, Peter Alvaro, H. Birali Runesha, Mingzhe Hao, and Huaicheng Li. Fail-Slow at Scale: Evidence of Hardware Performance Faults in Large Production Systems. At 16th USENIX Conference on File and Storage Technologies, February 2018. ↩︎
Marc Brooker. Is the Mean Really Useless? brooker.co.za, December 2017. Archived at perma.cc/U5AE-CVEM ↩︎
Giuseppe DeCandia, Deniz Hastorun, Madan Jampani, Gunavardhan Kakulapati, Avinash Lakshman, Alex Pilchin, Swaminathan Sivasubramanian, Peter Vosshall, and Werner Vogels. Dynamo: Amazon’s Highly Available Key-Value Store. At 21st ACM Symposium on Operating Systems Principles (SOSP), October 2007. doi:10.1145/1294261.1294281 ↩︎
Kathryn Whitenton. The Need for Speed, 23 Years Later. nngroup.com, May 2020. Archived at perma.cc/C4ER-LZYA ↩︎
Greg Linden. Marissa Mayer at Web 2.0. glinden.blogspot.com, November 2005. Archived at perma.cc/V7EA-3VXB ↩︎
Jake Brutlag. Speed Matters for Google Web Search. services.google.com, June 2009. Archived at perma.cc/BK7R-X7M2 ↩︎
Eric Schurman and Jake Brutlag. Performance Related Changes and their User Impact. Talk at Velocity 2009. ↩︎
Akamai Technologies, Inc. The State of Online Retail Performance. akamai.com, April 2017. Archived at perma.cc/UEK2-HYCS ↩︎
Xiao Bai, Ioannis Arapakis, B. Barla Cambazoglu, and Ana Freire. Understanding and Leveraging the Impact of Response Latency on User Behaviour in Web Search. ACM Transactions on Information Systems, volume 36, issue 2, article 21, April 2018. doi:10.1145/3106372 ↩︎
Jeffrey Dean and Luiz André Barroso. The Tail at Scale. Communications of the ACM, volume 56, issue 2, pages 74–80, February 2013. doi:10.1145/2408776.2408794 ↩︎
Alex Hidalgo. Implementing Service Level Objectives: A Practical Guide to SLIs, SLOs, and Error Budgets. O’Reilly Media, September 2020. ISBN: 1492076813 ↩︎
Jeffrey C. Mogul and John Wilkes. Nines are Not Enough: Meaningful Metrics for Clouds. At 17th Workshop on Hot Topics in Operating Systems (HotOS), May 2019. doi:10.1145/3317550.3321432 ↩︎
Tamás Hauer, Philipp Hoffmann, John Lunney, Dan Ardelean, and Amer Diwan. Meaningful Availability. At 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI), February 2020. ↩︎
Ted Dunning. The t-digest: Efficient estimates of distributions. Software Impacts, volume 7, article 100049, February 2021. doi:10.1016/j.simpa.2020.100049 ↩︎
David Kohn. How percentile approximation works (and why it’s more useful than averages). timescale.com, September 2021. Archived at perma.cc/3PDP-NR8B ↩︎
Heinrich Hartmann and Theo Schlossnagle. Circllhist — A Log-Linear Histogram Data Structure for IT Infrastructure Monitoring. arxiv.org, January 2020. ↩︎
Charles Masson, Jee E. Rim, and Homin K. Lee. DDSketch: A Fast and Fully-Mergeable Quantile Sketch with Relative-Error Guarantees. Proceedings of the VLDB Endowment, volume 12, issue 12, pages 2195–2205, August 2019. doi:10.14778/3352063.3352135 ↩︎
Baron Schwartz. Why Percentiles Don’t Work the Way You Think. solarwinds.com, November 2016. Archived at perma.cc/469T-6UGB ↩︎
Walter L. Heimerdinger and Charles B. Weinstock. A Conceptual Framework for System Fault Tolerance. Technical Report CMU/SEI-92-TR-033, Software Engineering Institute, Carnegie Mellon University, October 1992. Archived at perma.cc/GD2V-DMJW ↩︎
Felix C. Gärtner. Fundamentals of fault-tolerant distributed computing in asynchronous environments. ACM Computing Surveys, volume 31, issue 1, pages 1–26, March 1999. doi:10.1145/311531.311532 ↩︎
Algirdas Avižienis, Jean-Claude Laprie, Brian Randell, and Carl Landwehr. Basic Concepts and Taxonomy of Dependable and Secure Computing. IEEE Transactions on Dependable and Secure Computing, volume 1, issue 1, January 2004. doi:10.1109/TDSC.2004.2 ↩︎
Ding Yuan, Yu Luo, Xin Zhuang, Guilherme Renna Rodrigues, Xu Zhao, Yongle Zhang, Pranay U. Jain, and Michael Stumm. Simple Testing Can Prevent Most Critical Failures: An Analysis of Production Failures in Distributed Data-Intensive Systems. At 11th USENIX Symposium on Operating Systems Design and Implementation (OSDI), October 2014. ↩︎ ↩︎
Casey Rosenthal and Nora Jones. Chaos Engineering. O’Reilly Media, April 2020. ISBN: 9781492043867 ↩︎
Eduardo Pinheiro, Wolf-Dietrich Weber, and Luiz Andre Barroso. Failure Trends in a Large Disk Drive Population. At 5th USENIX Conference on File and Storage Technologies (FAST), February 2007. ↩︎
Bianca Schroeder and Garth A. Gibson. Disk failures in the real world: What does an MTTF of 1,000,000 hours mean to you? At 5th USENIX Conference on File and Storage Technologies (FAST), February 2007. ↩︎ ↩︎
Andy Klein. Backblaze Drive Stats for Q2 2021. backblaze.com, August 2021. Archived at perma.cc/2943-UD5E ↩︎
Iyswarya Narayanan, Di Wang, Myeongjae Jeon, Bikash Sharma, Laura Caulfield, Anand Sivasubramaniam, Ben Cutler, Jie Liu, Badriddine Khessib, and Kushagra Vaid. SSD Failures in Datacenters: What? When? and Why? At 9th ACM International on Systems and Storage Conference (SYSTOR), June 2016. doi:10.1145/2928275.2928278 ↩︎
Alibaba Cloud Storage Team. Storage System Design Analysis: Factors Affecting NVMe SSD Performance (1). alibabacloud.com, January 2019. Archived at archive.org ↩︎
Bianca Schroeder, Raghav Lagisetty, and Arif Merchant. Flash Reliability in Production: The Expected and the Unexpected. At 14th USENIX Conference on File and Storage Technologies (FAST), February 2016. ↩︎
Jacob Alter, Ji Xue, Alma Dimnaku, and Evgenia Smirni. SSD failures in the field: symptoms, causes, and prediction models. At International Conference for High Performance Computing, Networking, Storage and Analysis (SC), November 2019. doi:10.1145/3295500.3356172 ↩︎
Daniel Ford, François Labelle, Florentina I. Popovici, Murray Stokely, Van-Anh Truong, Luiz Barroso, Carrie Grimes, and Sean Quinlan. Availability in Globally Distributed Storage Systems. At 9th USENIX Symposium on Operating Systems Design and Implementation (OSDI), October 2010. ↩︎ ↩︎
Kashi Venkatesh Vishwanath and Nachiappan Nagappan. Characterizing Cloud Computing Hardware Reliability. At 1st ACM Symposium on Cloud Computing (SoCC), June 2010. doi:10.1145/1807128.1807161 ↩︎
Peter H. Hochschild, Paul Turner, Jeffrey C. Mogul, Rama Govindaraju, Parthasarathy Ranganathan, David E. Culler, and Amin Vahdat. Cores that don’t count. At Workshop on Hot Topics in Operating Systems (HotOS), June 2021. doi:10.1145/3458336.3465297 ↩︎
Harish Dattatraya Dixit, Sneha Pendharkar, Matt Beadon, Chris Mason, Tejasvi Chakravarthy, Bharath Muthiah, and Sriram Sankar. Silent Data Corruptions at Scale. arXiv:2102.11245, February 2021. ↩︎
Diogo Behrens, Marco Serafini, Sergei Arnautov, Flavio P. Junqueira, and Christof Fetzer. Scalable Error Isolation for Distributed Systems. At 12th USENIX Symposium on Networked Systems Design and Implementation (NSDI), May 2015. ↩︎
Bianca Schroeder, Eduardo Pinheiro, and Wolf-Dietrich Weber. DRAM Errors in the Wild: A Large-Scale Field Study. At 11th International Joint Conference on Measurement and Modeling of Computer Systems (SIGMETRICS), June 2009. doi:10.1145/1555349.1555372 ↩︎
Yoongu Kim, Ross Daly, Jeremie Kim, Chris Fallin, Ji Hye Lee, Donghyuk Lee, Chris Wilkerson, Konrad Lai, and Onur Mutlu. Flipping Bits in Memory Without Accessing Them: An Experimental Study of DRAM Disturbance Errors. At 41st Annual International Symposium on Computer Architecture (ISCA), June 2014. doi:10.1145/2678373.2665726 ↩︎
Tim Bray. Worst Case. tbray.org, October 2021. Archived at perma.cc/4QQM-RTHN ↩︎
Sangeetha Abdu Jyothi. Solar Superstorms: Planning for an Internet Apocalypse. At ACM SIGCOMM Conferene, August 2021. doi:10.1145/3452296.3472916 ↩︎
Adrian Cockcroft. Failure Modes and Continuous Resilience. adrianco.medium.com, November 2019. Archived at perma.cc/7SYS-BVJP ↩︎
Shujie Han, Patrick P. C. Lee, Fan Xu, Yi Liu, Cheng He, and Jiongzhou Liu. An In-Depth Study of Correlated Failures in Production SSD-Based Data Centers. At 19th USENIX Conference on File and Storage Technologies (FAST), February 2021. ↩︎
Edmund B. Nightingale, John R. Douceur, and Vince Orgovan. Cycles, Cells and Platters: An Empirical Analysis of Hardware Failures on a Million Consumer PCs. At 6th European Conference on Computer Systems (EuroSys), April 2011. doi:10.1145/1966445.1966477 ↩︎
Haryadi S. Gunawi, Mingzhe Hao, Tanakorn Leesatapornwongsa, Tiratat Patana-anake, Thanh Do, Jeffry Adityatama, Kurnia J. Eliazar, Agung Laksono, Jeffrey F. Lukman, Vincentius Martin, and Anang D. Satria. What Bugs Live in the Cloud? At 5th ACM Symposium on Cloud Computing (SoCC), November 2014. doi:10.1145/2670979.2670986 ↩︎
Jay Kreps. Getting Real About Distributed System Reliability. blog.empathybox.com, March 2012. Archived at perma.cc/9B5Q-AEBW ↩︎ ↩︎
Nelson Minar. Leap Second Crashes Half the Internet. somebits.com, July 2012. Archived at perma.cc/2WB8-D6EU ↩︎
Hewlett Packard Enterprise. Support Alerts – Customer Bulletin a00092491en_us. support.hpe.com, November 2019. Archived at perma.cc/S5F6-7ZAC ↩︎
Lorin Hochstein. awesome limits. github.com, November 2020. Archived at perma.cc/3R5M-E5Q4 ↩︎
Caitie McCaffrey. Clients Are Jerks: AKA How Halo 4 DoSed the Services at Launch & How We Survived. caitiem.com, June 2015. Archived at perma.cc/MXX4-W373 ↩︎
Lilia Tang, Chaitanya Bhandari, Yongle Zhang, Anna Karanika, Shuyang Ji, Indranil Gupta, and Tianyin Xu. Fail through the Cracks: Cross-System Interaction Failures in Modern Cloud Systems. At 18th European Conference on Computer Systems (EuroSys), May 2023. doi:10.1145/3552326.3587448 ↩︎
Mike Ulrich. Addressing Cascading Failures. In Betsy Beyer, Jennifer Petoff, Chris Jones, and Niall Richard Murphy (ed). Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media, 2016. ISBN: 9781491929124 ↩︎
Harri Faßbender. Cascading failures in large-scale distributed systems. blog.mi.hdm-stuttgart.de, March 2022. Archived at perma.cc/K7VY-YJRX ↩︎
Richard I. Cook. How Complex Systems Fail. Cognitive Technologies Laboratory, April 2000. Archived at perma.cc/RDS6-2YVA ↩︎
David D. Woods. STELLA: Report from the SNAFUcatchers Workshop on Coping With Complexity. snafucatchers.github.io, March 2017. Archived at archive.org ↩︎ ↩︎
David Oppenheimer, Archana Ganapathi, and David A. Patterson. Why Do Internet Services Fail, and What Can Be Done About It? At 4th USENIX Symposium on Internet Technologies and Systems (USITS), March 2003. ↩︎
Sidney Dekker. The Field Guide to Understanding ‘Human Error’, 3rd Edition. CRC Press, November 2017. ISBN: 9781472439055 ↩︎ ↩︎
Sidney Dekker. Drift into Failure: From Hunting Broken Components to Understanding Complex Systems. CRC Press, 2011. ISBN: 9781315257396 ↩︎
John Allspaw. Blameless PostMortems and a Just Culture. etsy.com, May 2012. Archived at perma.cc/YMJ7-NTAP ↩︎
Itzy Sabo. Uptime Guarantees — A Pragmatic Perspective. world.hey.com, March 2023. Archived at perma.cc/F7TU-78JB ↩︎
Michael Jurewitz. The Human Impact of Bugs. jury.me, March 2013. Archived at perma.cc/5KQ4-VDYL ↩︎
Mark Halper. How Software Bugs led to ‘One of the Greatest Miscarriages of Justice’ in British History. Communications of the ACM, January 2025. doi:10.1145/3703779 ↩︎
Nicholas Bohm, James Christie, Peter Bernard Ladkin, Bev Littlewood, Paul Marshall, Stephen Mason, Martin Newby, Steven J. Murdoch, Harold Thimbleby, and Martyn Thomas. The legal rule that computers are presumed to be operating correctly – unforeseen and unjust consequences. Briefing note, benthamsgaze.org, June 2022. Archived at perma.cc/WQ6X-TMW4 ↩︎
Dan McKinley. Choose Boring Technology. mcfunley.com, March 2015. Archived at perma.cc/7QW7-J4YP ↩︎
Andy Warfield. Building and operating a pretty big storage system called S3. allthingsdistributed.com, July 2023. Archived at perma.cc/7LPK-TP7V ↩︎
Marc Brooker. Surprising Scalability of Multitenancy. brooker.co.za, March 2023. Archived at perma.cc/ZZD9-VV8T ↩︎
Ben Stopford. Shared Nothing vs. Shared Disk Architectures: An Independent View. benstopford.com, November 2009. Archived at perma.cc/7BXH-EDUR ↩︎
Michael Stonebraker. The Case for Shared Nothing. IEEE Database Engineering Bulletin, volume 9, issue 1, pages 4–9, March 1986. ↩︎
Panagiotis Antonopoulos, Alex Budovski, Cristian Diaconu, Alejandro Hernandez Saenz, Jack Hu, Hanuma Kodavalla, Donald Kossmann, Sandeep Lingam, Umar Farooq Minhas, Naveen Prakash, Vijendra Purohit, Hugh Qu, Chaitanya Sreenivas Ravella, Krystyna Reisteter, Sheetal Shrotri, Dixin Tang, and Vikram Wakade. Socrates: The New SQL Server in the Cloud. At ACM International Conference on Management of Data (SIGMOD), pages 1743–1756, June 2019. doi:10.1145/3299869.3314047 ↩︎
Sam Newman. Building Microservices, second edition. O’Reilly Media, 2021. ISBN: 9781492034025 ↩︎
Nathan Ensmenger. When Good Software Goes Bad: The Surprising Durability of an Ephemeral Technology. At The Maintainers Conference, April 2016. Archived at perma.cc/ZXT4-HGZB ↩︎
Robert L. Glass. Facts and Fallacies of Software Engineering. Addison-Wesley Professional, October 2002. ISBN: 9780321117427 ↩︎
Marianne Bellotti. Kill It with Fire. No Starch Press, April 2021. ISBN: 9781718501188 ↩︎
Lisanne Bainbridge. Ironies of automation. Automatica, volume 19, issue 6, pages 775–779, November 1983. doi:10.1016/0005-1098(83)90046-8 ↩︎
James Hamilton. On Designing and Deploying Internet-Scale Services. At 21st Large Installation System Administration Conference (LISA), November 2007. ↩︎
Dotan Horovits. Open Source for Better Observability. horovits.medium.com, October 2021. Archived at perma.cc/R2HD-U2ZT ↩︎
Brian Foote and Joseph Yoder. Big Ball of Mud. At 4th Conference on Pattern Languages of Programs (PLoP), September 1997. Archived at perma.cc/4GUP-2PBV ↩︎
Marc Brooker. What is a simple system? brooker.co.za, May 2022. Archived at perma.cc/U72T-BFVE ↩︎
Frederick P. Brooks. No Silver Bullet – Essence and Accident in Software Engineering. In The Mythical Man-Month, Anniversary edition, Addison-Wesley, 1995. ISBN: 9780201835953 ↩︎
Dan Luu. Against essential and accidental complexity. danluu.com, December 2020. Archived at perma.cc/H5ES-69KC ↩︎
Erich Gamma, Richard Helm, Ralph Johnson, and John Vlissides. Design Patterns: Elements of Reusable Object-Oriented Software. Addison-Wesley Professional, October 1994. ISBN: 9780201633610 ↩︎
Eric Evans. Domain-Driven Design: Tackling Complexity in the Heart of Software. Addison-Wesley Professional, August 2003. ISBN: 9780321125217 ↩︎
Hongyu Pei Breivold, Ivica Crnkovic, and Peter J. Eriksson. Analyzing Software Evolvability. at 32nd Annual IEEE International Computer Software and Applications Conference (COMPSAC), July 2008. doi:10.1109/COMPSAC.2008.50 ↩︎
Enrico Zaninotto. From X programming to the X organisation. At XP Conference, May 2002. Archived at perma.cc/R9AR-QCKZ ↩︎
3 数据模型与查询语言

我的语言的边界,意味着我的世界的边界。
路德维希・维特根斯坦,《逻辑哲学论》(1922)
数据模型可能是软件开发中最重要的部分了,因为它们的影响如此深远:不仅仅影响着软件的编写方式,而且影响着我们的 解题思路。
多数应用使用层层叠加的数据模型构建。对于每层数据模型的关键问题是:它是如何用低一层数据模型来 表示 的?例如:
- 作为一名应用开发人员,你观察现实世界(里面有人员、组织、货物、行为、资金流向、传感器等),并采用对象或数据结构,以及操控那些数据结构的 API 来进行建模。那些结构通常是特定于应用程序的。
- 当要存储那些数据结构时,你可以利用通用数据模型来表示它们,如 JSON 或 XML 文档、关系数据库中的表,或者图中的顶点和边。这些数据模型正是本章的主题。
- 构建数据库软件的工程师决定如何以内存、磁盘或网络上的字节来表示文档、关系或图数据。这类表示形式使数据有可能以各种方式来查询、搜索、操纵和处理。我们将在 第 4 章 讨论这些存储引擎的设计。
- 在更低的层次上,硬件工程师已经想出了使用电流、光脉冲、磁场或者其他东西来表示字节的方法。
一个复杂的应用程序可能会有更多的中间层次,比如基于 API 的 API,不过基本思想仍然是一样的:每个层都通过提供一个明确的数据模型来隐藏更低层次中的复杂性。这些抽象允许不同的人群有效地协作,例如数据库厂商的工程师和使用数据库的应用程序开发人员。
实践中广泛使用着几种不同的数据模型,通常各有用途。某些类型的数据和查询在一种模型中很容易表达,在另一种模型中却很别扭。本章将比较 关系模型(relational model)、文档模型(document model)、图数据模型(graph data model)、事件溯源(event sourcing)和 数据框(dataframe),探讨其中的权衡。我们还将简要介绍操作这些模型的查询语言,帮助你判断何时应该使用哪种模型。
本章中的许多查询语言(如 SQL、Cypher、SPARQL 或 Datalog)都是 声明式(declarative)的。在声明式查询语言中,你只需指定所需数据的模式——结果必须符合哪些条件,以及数据应如何转换(例如排序、分组和聚合)——而不必说明 如何 实现这一目标。数据库系统的查询优化器决定使用哪些索引和连接算法,以及以何种顺序执行查询的各个部分。
相比之下,使用大多数编程语言时,你必须写出一套 算法(algorithm),告诉计算机以特定顺序执行哪些操作。声明式查询语言通常比显式算法更加简洁,也更容易编写;但更重要的是,它隐藏了查询引擎的实现细节,使数据库系统可以在无须对查询做任何修改的情况下提升性能 1。
例如,数据库或许能跨多个 CPU 核心和多台机器并行执行一条声明式查询,而你无须操心如何实现这种并行 2。若是手写算法,自行实现这种并行执行将费不少功夫。
关系模型与文档模型
如今最广为人知的数据模型或许是 SQL 所采用的关系模型,它由 Edgar Codd 于 1970 年提出 3:数据被组织成 关系(relation,SQL 称之为 表,table),每个关系都是由 元组(tuple,SQL 称之为 行,row)构成的无序集合。
关系模型最初只是一项理论提议,当时许多人怀疑它能否得到高效实现。然而到了 20 世纪 80 年代中期,对于大多数需要存储和查询具有某种规则结构的数据的人来说,关系数据库管理系统(RDBMS)和 SQL 已成为首选工具。几十年过去,关系数据仍主导着许多数据管理场景,例如商业分析(参见 “星型与雪花型:分析模式”)。
多年来,数据存储和查询领域涌现过许多彼此竞争的方法。20 世纪 70 年代至 80 年代初,网状模型(network model)和 层次模型(hierarchical model)是关系模型的主要对手,但最终都败下阵来。对象数据库在 20 世纪 80 年代末至 90 年代初兴起后又销声匿迹;XML 数据库于 21 世纪初出现,却始终只在少数场景中得到采用。关系模型的每个竞争者都曾盛极一时,但无一长久 4。反倒是 SQL 在关系模型这个核心之上不断吸收其他数据类型,例如增加了对 XML、JSON 和图数据的支持 5。
到了 2010 年代,NoSQL 成了试图撼动关系数据库统治地位的最新流行语。NoSQL 并非某项特定技术,而是围绕新数据模型、模式灵活性、可伸缩性和开源许可模式形成的一组宽泛理念。另一些数据库则以 NewSQL 自居,力图在保留传统关系数据库的数据模型和事务保证的同时,提供 NoSQL 系统的可伸缩性。NoSQL 和 NewSQL 的理念深刻影响了数据系统的设计;不过,随着这些原则被广泛吸收,两个术语本身已渐渐淡出。
NoSQL 运动留下的一项持久影响,是通常以 JSON 表示数据的 文档模型(document model)广受欢迎。这个模型最初由 MongoDB、Couchbase 等专用文档数据库推广,如今大多数关系数据库也已加入 JSON 支持。关系表的模式常被视为严格而僵化,相比之下,JSON 文档被认为更加灵活。
文档数据与关系数据孰优孰劣,已经引发过大量争论。下面来看看其中几个关键问题。
对象关系不匹配
如今,大量应用开发使用面向对象的编程语言,这也引出了针对 SQL 数据模型的一项常见批评:数据若存储在关系表中,就需要一个笨拙的转换层,在应用代码中的对象与数据库的表、行、列模型之间来回转换。两种模型之间的这种脱节,有时称为 阻抗不匹配(impedance mismatch)。
阻抗不匹配 一词借自电子学。每个电路的输入和输出都有一定的阻抗(对交流电的阻力)。把一个电路的输出接到另一个电路的输入时,若两边阻抗匹配,连接处的功率传输就能达到最大;阻抗不匹配则可能造成信号反射等问题。
对象关系映射(ORM)
ActiveRecord、Hibernate 等对象关系映射(ORM)框架减少了转换层所需的样板代码,但也时常遭到批评 6。常见问题包括:
- ORM 本身很复杂,也无法彻底掩盖两种模型的差异,开发者最终仍得同时考虑数据的关系表示和对象表示。
- ORM 一般只用于开发 OLTP 应用(参见 “事务处理与分析的特征”)。为了让数据可供分析,数据工程师仍须面对底层的关系表示,因此采用 ORM 并不意味着关系模式的设计不再重要。
- 许多 ORM 只面向关系型 OLTP 数据库。若组织还使用搜索引擎、图数据库、NoSQL 系统等多种数据系统,ORM 提供的支持可能远远不够。
- 有些 ORM 会自动生成关系模式,但生成的模式对直接访问关系数据的用户未必友好,在底层数据库上也可能效率不佳。要定制 ORM 生成模式与查询的方式,往往相当复杂,甚至会抵消采用 ORM 原本想获得的好处。
- 使用 ORM 很容易在无意中写出低效查询,例如触发 N+1 查询问题(N+1 query problem)7。假设你要在页面上显示用户评论列表:先用一条查询取回 N 条评论,每条都含有作者 ID;为了显示作者姓名,还要用这个 ID 查询用户表。手写 SQL 时,你大概会直接在查询中连接用户表,让每条评论连同作者姓名一起返回;使用 ORM 时,却可能对 N 条评论逐条查询用户表,最终一共执行 N+1 条数据库查询。这比在数据库内完成连接要慢得多。为避免这个问题,你可能必须明确要求 ORM 在获取评论的同时一并取回作者信息。
不过,ORM 也自有其优势:
- 对适合关系模型的数据来说,持久化的关系表示与内存中的对象表示之间总要进行某种转换,ORM 可以减少这类转换所需的样板代码。复杂查询或许仍须绕开 ORM 处理,但简单、重复的场景正适合交给它。
- 有些 ORM 可以缓存数据库查询结果,从而减轻数据库负载。
- ORM 还可以协助管理模式迁移和其他数据库管理工作。
用于一对多关系的文档数据模型
并非所有数据都适合用关系形式表示。下面用一个例子看看关系模型的局限。图 3-1 展示了如何用关系模式表示一份简历(LinkedIn 个人资料)。整份资料由唯一标识符 user_id 标识;first_name 和 last_name 等字段对每位用户只出现一次,因此可以建模为 users 表中的列。
大多数人的职业生涯中都不止有一份工作(即多个职位),每个人的教育经历数量也不相同,联系方式更可能有任意多项。这些 一对多关系(one-to-many relationship)可以这样表示:把职位、教育经历和联系信息分别放在单独的表中,再通过外键引用 users 表,如 图 3-1 所示。

同一份信息还可以表示为 JSON 文档,如 示例 3-1 所示。这种形式可能更为自然,也更贴近应用代码中的对象结构。
一些开发者认为,JSON 模型减轻了应用代码与存储层之间的阻抗不匹配。不过,正如我们将在 第 5 章 看到的,JSON 用作数据编码格式时也有不少问题。没有模式常被视为它的一项优势,我们将在 “文档模型中的模式灵活性” 进一步讨论。
与 图 3-1 的多表模式相比,JSON 表示具有更好的 局部性(参见 “读写的数据局部性”)。在关系模型的例子中,要取回一份个人资料,要么执行多次查询(按 user_id 分别查询每张表),要么在 users 表及其下属表之间进行繁琐的多路连接 8。而在 JSON 表示中,所有相关信息都集中在一处,查询既简单又快捷。
个人资料与职位、教育经历、联系信息之间的一对多关系,在数据中形成了一棵树;JSON 表示则明确呈现了这种树状结构(见 图 3-2)。

规范化、反规范化与连接
前一节的 示例 3-1 用 ID 表示 region_id,而没有直接写成纯文本字符串 "Washington, DC, United States"。为什么要这样做?
如果用户界面提供自由文本框让用户填写地区,那么把输入直接存成文本字符串很合理。不过,预先提供标准化的地理区域列表,让用户通过下拉列表或自动补全来选择,也有不少好处:
- 所有个人资料中的格式和拼写保持一致
- 避免同名地点造成歧义(若字符串只有 “Washington”,究竟是指华盛顿特区,还是华盛顿州?)
- 便于更新——名称只存储在一处,将来如有变动(例如因政治事件而更改城市名称),只改一处便能全局生效
- 支持本地化——网站翻译成其他语言时,可以本地化这份标准列表,让地区名称以浏览者使用的语言显示
- 改善搜索——例如,地区列表可以记录华盛顿位于美国东海岸这一事实(单看
"Washington, DC"字符串无法得知),于是搜索美国东海岸的人时也能匹配这份资料
选择存储 ID 还是文本字符串,实质上是在决定是否 规范化(normalization)。使用 ID 时,数据更加规范化:对人有意义的信息(如 Washington, DC 这段文字)只存储一份,其他地方都用仅在数据库内有意义的 ID 来引用它。若直接存储文本,这段有意义的信息就会复制到每条使用它的记录中;这样的表示便是 反规范化(denormalized)的。
ID 的好处在于,它本身对人没有意义,因而永远不必改变:即使 ID 所标识的信息发生了变化,ID 仍可保持不变。凡是对人有意义的信息,将来都有可能需要修改;一旦这类信息被复制,所有冗余副本就都得随之更新。这不仅需要更多代码、写入操作和磁盘空间,还会带来不一致的风险——有些副本已经更新,另一些却没有。
规范化表示也有代价:每次显示含有 ID 的记录时,都要多做一次查找,把 ID 解析成人能读懂的信息。在关系数据模型中,这项工作通过 连接(join)完成,例如:
文档数据库既能存储规范化数据,也能存储反规范化数据,但人们往往把它与反规范化联系在一起。一方面,JSON 数据模型很容易加入额外的反规范化字段;另一方面,许多文档数据库对连接支持较弱,采用规范化表示很不方便。有些文档数据库完全不支持连接,只能在应用代码中自行完成:先取回含有 ID 的文档,再发起第二次查询,用 ID 找到另一个文档。MongoDB 也可以通过聚合管道中的 $lookup 算子执行连接:
规范化的权衡
在简历示例中,region_id 字段引用了标准化的地区集合,organization(任职的公司或政府机构)和 school_name(就读的学校)却只是字符串。这是一种反规范化表示:许多人或许曾在同一家公司工作,但这些记录并没有通过 ID 关联起来。
那么,是否应该把组织和学校也建模为实体,让个人资料引用其 ID,而不是直接写下名称?主张用 ID 引用地区的理由在这里同样成立。比如,假设除了名称之外,我们还想显示学校或公司的徽标:
- 采用反规范化表示时,每个人的个人资料都要包含徽标图片的 URL。这样固然让 JSON 文档自给自足,但徽标一旦更换,就必须找出旧 URL 出现的每个地方并逐一更新,十分麻烦 9。
- 采用规范化表示时,可以建立一个代表组织或学校的实体,只在其中存储一次名称、徽标 URL,也许再加上简介、动态消息等属性。所有提及该组织的简历只引用其 ID,更新徽标便易如反掌。
一般来说,规范化数据写入较快(因为只有一个副本),查询却较慢(因为需要连接);反规范化数据通常读取较快(连接更少),写入代价却更高(要更新更多副本,也占用更多磁盘空间)。把反规范化看作一种衍生数据或许很有帮助(参见 “权威记录系统与衍生数据”),因为你必须建立相应流程来更新那些冗余的数据副本。
除了更新本身的成本,还要考虑进程在更新中途崩溃时,数据库能否保持一致。支持原子事务的数据库(参见 “原子性”)更容易维护一致性,但并非所有数据库都能为跨多个文档的操作提供原子性。也可以利用流处理来保证一致性,我们将在 “保持系统同步” 讨论这种方法。
规范化往往更适合读写都要迅速完成的 OLTP 系统;分析系统通常更适合反规范化数据,因为它们会批量更新,首要关心的是只读查询的性能。此外,中小规模系统通常也更适合规范化数据模型:既不必费心维持多个副本的一致,执行连接的成本也还可以接受。不过到了超大规模,连接的代价就可能成为问题。
社交网络案例研究中的反规范化
在 “案例研究:社交网络首页时间线” 中,我们比较了规范化表示(图 2-1)和反规范化表示(预计算并物化的时间线)。在那个例子里,连接 posts 与 follows 的成本太高,于是物化时间线充当了连接结果的缓存;把新帖子扇出到关注者的时间线,正是维持这种反规范化表示一致的手段。
不过,X(原 Twitter)的物化时间线实际上并不保存每条帖子的正文。每个条目只存储帖子 ID、发帖用户的 ID,以及少量用于识别转帖和回复的附加信息 11。换句话说,它大致相当于预先算好了下面这条查询的结果:
因此,每次读取时间线时,服务仍要做两次连接:按帖子 ID 取回正文,以及点赞数、回复数等统计信息;再按发帖用户 ID 取回其用户名、头像和其他资料。这个把 ID 补全为人类可读信息的过程称为 补全 ID(hydrating IDs),本质上就是在应用代码中完成连接 11。
预计算时间线之所以只存 ID,是因为 ID 所指向的数据变化很快:热门帖子的点赞数和回复数每秒都可能变化多次,有些用户也会经常更换用户名或头像。时间线在展示时应呈现最新的点赞数和头像,所以把这些信息反规范化到物化时间线中并不合理,而且还会大幅增加存储成本。
这个例子说明,读取数据时需要执行连接,并不像有些说法所称的那样,会妨碍我们构建高性能、可伸缩的服务。补全帖子 ID 和用户 ID 其实相当容易伸缩:这项工作很适合并行执行,而且成本既不取决于你关注了多少账户,也不取决于有多少人关注你。
如果要判断应用中的某项数据是否应该反规范化,社交网络案例表明答案并不显而易见:可伸缩性最好的方案,可能是把一部分数据反规范化,同时让另一部分保持规范化。你必须仔细权衡信息的变化频率与读写成本;而成本又可能由极端情况主导,例如社交网络中关注或被关注人数异常多的用户。规范化与反规范化本身无所谓好坏,不过是在读写性能和实现成本之间作取舍。
多对一与多对多关系
图 3-1 中的 positions 和 education 是一对多(或一对少)关系:一份简历有多个职位,但每个职位只属于一份简历。相比之下,region_id 字段表示 多对一(many-to-one)关系:许多人住在同一个地区,而我们假设任一时刻每个人只住在一个地区。
如果进一步把组织和学校建模为实体,让简历通过 ID 引用它们,就会出现 多对多(many-to-many)关系:一个人曾在多个组织任职,一个组织也有多名现任或前任员工。在关系模型中,这类关系通常用 关联表(associative table,也称 连接表,join table)表示,如 图 3-3 所示:每个职位把一个用户 ID 与一个组织 ID 关联起来。

多对一和多对多关系很难塞进一个自包含的 JSON 文档,它们更适合规范化表示。示例 3-2 给出了文档模型中的一种方案,图 3-4 则以图示说明:每个虚线框内的数据可以组成一份文档,但指向组织和学校的链接最好表示为对其他文档的引用。

多对多关系通常需要从“两个方向”查询:既要找出某人任职过的所有组织,也要找出曾在某组织任职的所有人。一种做法是在关系两端都保存 ID 引用:简历列出此人任职过的各个组织 ID,组织文档也列出提及该组织的简历 ID。由于同一关系存储了两份,这是一种反规范化表示,两边可能彼此不一致。
规范化表示只在一处存储关系,再依靠 二级索引(secondary index;将在 第 4 章 讨论)从两个方向高效查询。图 3-3 的关系模式中,可以让数据库分别为 positions 表的 user_id 列和 org_id 列建立索引。
在 示例 3-2 的文档模型中,数据库则需要索引 positions 数组内各对象的 org_id 字段。许多文档数据库以及支持 JSON 的关系数据库,都能为文档内部的值建立这种索引。
星型与雪花型:分析模式
数据仓库(参见 “数据仓库”)通常采用关系模型,其表结构有几种广泛使用的惯例:星型模式(star schema)、雪花模式(snowflake schema)、维度建模(dimensional modeling)12,以及 一张大表(OBT)。这些结构针对业务分析师的需求进行了优化,ETL 过程则负责把事务型系统中的数据转换成这种模式。
图 3-5 中的示例模式,可能出现在一家食品零售商的数据仓库中。模式的中心是所谓的 事实表(fact table;本例中名为 fact_sales)。事实表的每一行代表在特定时间发生的事件;在这里,每行代表客户购买了一件产品。如果分析的是网站流量而不是零售量,那么每行可能代表一次页面浏览或一次用户点击。

通常会把每项事实记录为独立事件,因为这样能为日后的分析保留最大的灵活性。不过,这也意味着事实表可能变得极其庞大。大型企业的数据仓库可能保存着许多 PB 的交易历史,其中大部分都以事实表表示。
事实表中的一些列是属性,例如产品的售价和从供应商处购入的成本(据此可以计算利润率)。另一些列是指向其他表的外键引用,这些表称为 维度表(dimension table)。由于事实表的每一行表示一个事件,各个维度便代表事件发生的对象、内容、地点、时间、方式和原因。
例如,图 3-5 中的一个维度是售出的产品。dim_product 表中的每一行代表一种待售产品,包括库存单位(SKU)、产品描述、品牌名称、类别、脂肪含量、包装尺寸等。fact_sales 表的每一行都用外键表明该笔交易售出了哪种产品。查询往往要连接多个维度表。
甚至日期和时间也常用维度表表示,以便编码公共假期等额外信息,让查询可以区分节假日与平日的销售情况。
图 3-5 展示的便是星型模式。这个名称源自表关系的可视化形状:事实表位于中央,周围环绕着维度表;连接这些表的线条就像星星的光芒。
这个模板的变体称为 雪花模式,其中的维度会进一步分解成子维度。例如,可以为品牌和产品类别分别建表,让 dim_product 的每一行以外键引用品牌与类别,而不再把它们作为字符串直接存入 dim_product 表。雪花模式比星型模式更规范化,但星型模式通常更受青睐,因为分析师使用起来更简单 12。
典型数据仓库中的表通常非常宽:事实表往往超过 100 列,有时甚至有数百列。维度表也可能很宽,因为它们会收录所有可能与分析相关的元数据。例如,dim_store 表可能记录每家商店提供哪些服务、是否设有店内面包房、店面面积、首次开业日期、最近一次改造时间,以及离最近的高速公路有多远,等等。
星型模式和雪花模式主要由多对一关系构成,例如许多笔销售对应同一种产品、同一家商店。这些关系表现为事实表指向维度表的外键,或维度表指向子维度表的外键。原则上也可以存在其他类型的关系,但为了简化查询,通常会把它们反规范化。例如,顾客一次买了几种不同产品时,这笔多商品交易不会得到显式表示;事实表只是为每件商品各存一行,而这些事实恰好具有相同的顾客 ID、商店 ID 和时间戳。
有些数据仓库模式更进一步,完全省去维度表,把维度信息放进事实表的反规范化列中——实质上就是预先计算事实表与维度表的连接。这种方法称为 一张大表(OBT);它虽然占用更多存储空间,有时却能让查询更快 13。
在分析场景中,这样反规范化通常不成问题,因为数据往往是一份不会再改变的历史记录(偶尔纠正错误除外)。反规范化在 OLTP 系统中带来的数据一致性问题和写入开销,在分析系统里没有那么紧迫。
何时使用哪种模型
支持文档数据模型的主要论据是模式灵活性、因局部性而拥有更好的性能,以及对于某些应用程序而言,它更接近应用程序使用的对象模型。关系模型则以更好地支持连接、多对一和多对多关系作为回应。下面逐一详细考察这些论点。
如果应用程序中的数据具有类似文档的结构(即一对多关系树,通常一次性加载整棵树),那么使用文档模型可能是个好主意。把类似文档的结构 拆散 到多个表中(如 图 3-1 中的 positions、education 和 contact_info),可能导致繁琐的模式和不必要的复杂应用程序代码。
文档模型有一定的局限性:例如,不能直接引用文档中的嵌套项目,而是需要说“用户 251 的职位列表中的第二项”。如果确实需要引用嵌套项目,关系模型更合适,因为任何项目都能通过自身 ID 被直接引用。
有些应用允许用户自行安排项目顺序。例如,在待办事项清单或问题跟踪器中,用户可以拖放任务来重新排序。文档模型很适合这类应用,只需把项目(或项目 ID)按顺序存入 JSON 数组即可。关系数据库没有表示这种可重新排序列表的标准方式,只能借助各种技巧:按整数列排序(在中间插入时需要重新编号)、用 ID 构成链表,或者使用分数索引 14 15 16。
文档模型中的模式灵活性
大多数文档数据库以及关系数据库中的 JSON 支持,都不会强制文档中的数据采用何种模式。关系数据库的 XML 支持通常带有可选的模式验证。没有模式意味着可以向文档中添加任意键和值;读取时,客户端也无法确定文档究竟会包含哪些字段。
文档数据库有时称为 无模式(schemaless),但这具有误导性,因为读取数据的代码通常假定某种结构——即存在隐式模式,只是不由数据库强制执行 17。一个更准确的术语是 读时模式(schema-on-read,数据结构是隐含的,只有读取时才会解释),与之相对的是 写时模式(schema-on-write,关系数据库的传统做法:模式是明确的,数据库确保写入的所有数据都符合模式)18。
读时模式类似于编程语言中的动态(运行时)类型检查,而写时模式类似于静态(编译时)类型检查。就像静态与动态类型检查孰优孰劣一直争议不断 19,数据库是否应该强制执行模式也是个见仁见智的问题,通常并没有绝对的对错。
当应用程序想要改变数据格式时,两种方法的区别尤其明显。例如,假设原先把每位用户的全名存储在一个字段中,现在想把名和姓分开存储 20。在文档数据库中,只需开始写入带有新字段的文档,并在应用程序中加入代码来处理旧文档即可。例如:
这种方法的缺点是,应用中每个读取数据库的部分,从此都必须处理可能在很久以前写入的旧格式文档。另一方面,在写时模式数据库中,通常会执行下面这样的 迁移:
在大多数关系数据库中,即使面对大表,添加带默认值的列也又快又稳妥。不过,在大表上执行 UPDATE 可能很慢,因为每一行都必须重写;其他模式操作(例如修改某列的数据类型)通常也需要复制整张表。
有多种工具可以在后台完成这类模式变更而无须停机 21 22 23 24,但在大型数据库上进行这种迁移,运维起来依然颇具挑战。要避开复杂迁移,可以只快速添加一个默认值为 NULL 的 first_name 列,然后在读取时填充它,就像使用文档数据库那样。
如果集合中的项目因为某种原因并不都具有相同结构(即数据是异构的),读时模式更具优势。例如:
- 存在许多不同类型的对象,将每种对象分别放进一张表并不现实。
- 数据结构由你无法控制、且随时可能改变的外部系统决定。
在上述情况下,模式可能弊大于利,无模式文档反而是更自然的数据模型。但是,如果所有记录都应具有相同结构,那么模式就是记录并强制这种结构的有效机制。我们将在 第 5 章 更详细地讨论模式和模式演化。
读写的数据局部性
文档通常以单个连续字符串的形式存储,编码为 JSON、XML 或其二进制变体(如 MongoDB 的 BSON)。如果应用程序经常需要访问整个文档(例如把它渲染到网页上),这种 存储局部性 会带来性能优势。如果数据像 图 3-1 那样分散在多张表中,就需要多次查找索引才能检索完整,可能产生更多磁盘寻道并花费更长时间。
局部性优势只适用于同时需要文档绝大部分内容的情况。即使只访问大型文档的一小部分,数据库通常也要加载整个文档,这会造成浪费;更新时一般还要重写整个文档。因此,通常建议让文档保持较小,并避免频繁地对文档做小幅更新。
不过,为了局部性而把相关数据存储在一起,并非文档模型的专利。例如,Google 的 Spanner 数据库在关系模型中也提供同样的局部性属性,允许模式声明某张表的行应交错(嵌套)在父表之中 25。Oracle 也用名为 多表索引集群表(multi-table index cluster table)的功能提供类似能力 26。由 Google Bigtable 推广、并被 HBase 和 Accumulo 等系统采用的 宽列(wide-column)数据模型,则以 列族(column family)概念达到相似的局部性管理目的 27。
文档的查询语言
关系数据库和文档数据库的另一个区别,在于查询所用的语言或 API。大多数关系数据库使用 SQL,文档数据库则五花八门:有些只允许按主键进行键值访问,有些还提供二级索引来查询文档内部的值,还有些配有功能丰富的查询语言。
XML 数据库通常使用 XQuery 和 XPath;它们支持包括跨文档连接在内的复杂查询,还能把结果格式化为 XML 28。JSON Pointer 29 和 JSONPath 30 则为 JSON 提供了与 XPath 相当的功能。
MongoDB 的聚合管道就是一种面向 JSON 文档集合的查询语言;我们在 “规范化、反规范化与连接” 中已经见过它用于连接的 $lookup 算子。
再看一个例子来体会这种语言,这次考察分析中尤为常见的聚合。假设你是一名海洋生物学家,每当在海中看到动物,就向数据库添加一条观察记录。现在你想生成一份报告,说明每个月观察到多少条鲨鱼。在 PostgreSQL 中,可以像这样表述查询:
❶:date_trunc('month', timestamp) 函数确定 timestamp 所在的日历月份,并返回代表该月起点的另一个时间戳。换句话说,它把时间戳向下舍入到最近的月份。
这个查询首先过滤观察记录,只保留鲨鱼科的物种;然后按观察发生的日历月份分组;最后,把该月所有观察记录中的动物数量相加。同一个查询可以用 MongoDB 的聚合管道表示如下:
聚合管道语言的表达能力与 SQL 的一个子集相当,不过它采用基于 JSON 的语法,而不是 SQL 那种接近英语句式的语法;这种差异或许只是口味问题。
文档和关系数据库的融合
文档数据库和关系数据库最初采用截然不同的数据管理方法,但随着时间推移,两者变得越来越相似 31。关系数据库增加了对 JSON 类型和查询算子的支持,也能够为文档内部的属性建立索引;MongoDB、Couchbase、RethinkDB 等文档数据库,则增加了连接、二级索引和声明式查询语言。
这种融合对应用程序开发人员来说是件好事,因为关系模型和文档模型能够在同一个数据库中结合使用时,最能发挥各自所长。许多文档数据库需要以关系模型的方式引用其他文档,许多关系数据库也有些部分会受益于模式灵活性。关系模型与文档模型的混合是一种强大的组合。
Codd 对关系模型的原始描述 3 实际上允许关系模式中出现类似 JSON 的结构,他称之为 非简单域(nonsimple domain)。其思想是,一行中的值不一定只是数字或字符串之类的原始数据类型,也可以是嵌套的关系(表),因此可以把任意嵌套的树结构作为一个值。这与三十多年后加入 SQL 的 JSON 或 XML 支持非常相似。
图数据模型
如我们之前所见,关系的类型是区分不同数据模型的一项重要特征。如果应用程序中的关系大多是一对多关系(树状结构数据),而记录之间很少存在其他关系,那么文档模型是合适的。
但是,如果多对多关系在数据中十分常见呢?关系模型可以处理简单的多对多关系,但随着数据之间的连接变得越来越复杂,将数据建模为图就显得更加自然。
一个图由两种对象组成:顶点(vertices,也称为 节点,即 nodes,或 实体,即 entities)和 边(edges,也称为 关系,即 relationships,或 弧,即 arcs)。多种数据都可以建模为图,典型的例子包括:
- 社交图
- 顶点是人,边表示哪些人相互认识。
- 网页图
- 顶点是网页,边表示指向其他页面的 HTML 链接。
- 道路或铁路网络
- 顶点是交叉点,边表示它们之间的道路或铁路线。
可以把许多众所周知的算法运用到这些图上。例如,地图导航应用会搜索道路网络中两点之间的最短路径;PageRank 可以用在网页图上,判断网页的流行程度,进而决定它在搜索结果中的排名 32。
图可以用几种不同的方式表示。在 邻接表(adjacency list)模型中,每个顶点都保存与它相隔一条边的相邻顶点 ID。另一种方式是 邻接矩阵(adjacency matrix):这是一个二维数组,每行、每列各对应一个顶点;行顶点与列顶点之间没有边时,值为 0,有边时则为 1。邻接表适合图遍历,邻接矩阵则适合机器学习(参见 “数据框、矩阵与数组”)。
在刚才给出的例子中,图里的所有顶点都表示同一种事物,分别是人、网页或道路交叉口。不过,图并不局限于这种 同质(homogeneous)数据:图还有一项同样强大的用途,就是以一致的方式在单个数据库中存储截然不同的对象。例如:
- Facebook 维护着一个包含许多不同类型顶点和边的图:顶点表示人、地点、事件、签到和用户评论;边表示哪些人是朋友、某次签到发生在哪里、谁评论了哪篇帖子、谁参加了哪场活动,等等 33。
- 搜索引擎用知识图谱来记录查询中经常出现的组织、人物、地点等实体的事实 34。这些信息来自对网站的抓取与文本分析;Wikidata 等网站也会以结构化形式发布图数据。
有几种不同但彼此相关的方式,可以用来组织和查询图中的数据。本节将讨论 属性图(property graph)模型(由 Neo4j、Memgraph、KùzuDB 35 等系统实现 36)和 三元组存储(triple store)模型(由 Datomic、AllegroGraph、Blazegraph 等系统实现)。两种模型的表达能力相当接近,Amazon Neptune 等图数据库还同时支持二者。
我们还将介绍四种图查询语言(Cypher、SPARQL、Datalog 和 GraphQL),以及 SQL 对图查询的支持。其他图查询语言还有 Gremlin 等 37,不过这里选取的几种已足以给出一幅有代表性的全景。
为了说明这些语言和模型,本节将以 图 3-6 为贯穿全节的例子。它可以取自社交网络或家谱数据库:图中有两个人,来自爱达荷州的 Lucy 和来自法国圣洛的 Alain。他们已经结婚,现居伦敦。每个人和每个地点都表示为顶点,彼此之间的关系则表示为边。这个例子将展示一些在图数据库中很容易、在其他模型中却很难表达的查询。

属性图
在 属性图(也称 带标签属性图,labeled property graph)模型中,每个顶点包括:
- 唯一标识符
- 一个标签(字符串),描述该顶点所表示的对象类型
- 一组出边
- 一组入边
- 一组属性(键值对)
每条边包括:
- 唯一标识符
- 边的起点(尾部顶点,即 tail vertex)
- 边的终点(头部顶点,即 head vertex)
- 一个标签,描述两个顶点之间的关系类型
- 一组属性(键值对)
可以把图存储看成两个关系表:一张存储顶点,另一张存储边,如 示例 3-3 所示(该模式使用 PostgreSQL 的 jsonb 数据类型存储每个顶点或每条边的属性)。每条边都保存头部顶点和尾部顶点;如果想找出某个顶点的所有入边或出边,可以分别按 head_vertex 或 tail_vertex 查询 edges 表。
这个模型有几个重要特点:
- 任何顶点都可以通过边连接到任何其他顶点。没有模式限制哪些事物可以关联,哪些不可以。
- 给定任意顶点,都能高效地找到它的入边和出边,从而双向 遍历 图——即沿着一系列顶点构成的路径前后移动。(这正是 示例 3-3 同时为
tail_vertex和head_vertex列建立索引的原因。) - 为不同类型的顶点和关系使用不同的标签,就可以在一个图中存储多种不同的信息,同时仍保持清晰的数据模型。
边表就像我们在 “多对一与多对多关系” 看到的多对多关联表(连接表),只不过经过了泛化,可以在同一张表中存储许多不同类型的关系。标签和属性也可以建立索引,以便高效查找具有某种属性的顶点或边。
图模型有一项局限:一条边只能关联两个顶点,而关系模型中的连接表可以在一行中保存多个外键引用,从而表示三元甚至更高元的关系。在图中,可以为连接表的每一行另建一个顶点,再用边把它与其他顶点相连;也可以使用 超图 来表示这类关系。
这些特性为数据建模提供了很大的灵活性,如 图 3-6 所示。图中有一些传统关系模式难以表达的事物,例如不同国家采用不同的行政区划结构(法国有 省 和 大区,美国有 县 和 州)、国中之国这样的历史怪事(暂且忽略主权国家与民族错综复杂的关系),以及粒度不一的数据(Lucy 现在的住所具体到城市,而出生地只记录到州)。
可以想象,这个图还能够扩展出关于 Lucy、Alain 或其他人的许多事实。例如,可以用它表示食物过敏:为每种过敏原增加一个顶点,用人与过敏原之间的边表示过敏,再把过敏原连接到一组说明哪些食物含有哪些物质的顶点。这样就能写一条查询,找出每个人可以安全食用的东西。图在可演化性方面很有优势:随着应用程序不断增加功能,可以轻松扩展图来适应数据结构的变化。
Cypher 查询语言
Cypher 是属性图的查询语言,最初为 Neo4j 图数据库而创,后来以 openCypher 之名发展为开放标准 38。除了 Neo4j,Memgraph、KùzuDB 35、Amazon Neptune、Apache AGE(数据存储在 PostgreSQL 中)等系统也支持 Cypher。它以电影《黑客帝国》中的角色命名,与密码学中的密码并无关系 39。
示例 3-4 展示了把 图 3-6 左侧部分插入图数据库的 Cypher 查询,图的其余部分也可以用同样方式加入。每个顶点都有一个 usa 或 idaho 之类的符号名称。该名称不会存入数据库,只在查询内部用来创建顶点之间的边。箭头记法 (idaho) -[:WITHIN]-> (usa) 会创建一条标签为 WITHIN 的边,以 idaho 为尾节点、usa 为头节点。
把 图 3-6 的所有顶点和边加入数据库后,就可以提出一些有趣的问题。例如:找出所有从美国移居欧洲的人的姓名。更确切地说,我们要找出同时具有一条指向美国境内某地的 BORN_IN 边,以及一条指向欧洲境内某地的 LIVES_IN 边的顶点,并返回这些顶点的 name 属性。
示例 3-5 展示了如何用 Cypher 表述这个查询。MATCH 子句使用同样的箭头记法在图中寻找模式:(person) -[:BORN_IN]-> () 匹配由一条 BORN_IN 边相连的任意两个顶点;这条边的尾部顶点绑定到变量 person,头部顶点则不命名。
这条查询可以这样解读:
找出满足以下 两个 条件的所有顶点(称为
person):
person顶点有一条指向某个顶点的BORN_IN出边。从那里沿着一系列WITHIN出边前进,最终能到达一个类型为Location、name属性为"United States"的顶点。- 同一个
person顶点还有一条LIVES_IN出边。沿着该边,再沿一系列WITHIN出边前进,最终能到达一个类型为Location、name属性为"Europe"的顶点。对每个这样的
person顶点,返回其name属性。
执行这条查询有几种可行的方式。上面的描述暗示,可以先扫描数据库中的所有人,逐一检查出生地和居住地,只返回符合条件的人。
等价地,也可以从两个 Location 顶点开始反向查找。如果 name 属性建有索引,就能高效找到代表美国和欧洲的两个顶点。然后沿着所有 WITHIN 入边,分别找出美国和欧洲境内的所有地点(州、地区、城市等)。最后,再沿这些地点顶点的 BORN_IN 或 LIVES_IN 入边找到相应的人。
SQL 中的图查询
示例 3-3 表明,可以在关系数据库中表示图数据。但是,如果图数据采用关系结构存储,还能使用 SQL 查询它吗?
答案是肯定的,但有些困难。图查询每遍历一条边,实际上都相当于与 edges 表连接一次。在关系数据库中,通常事先就知道查询需要哪些连接;而在图查询中,找到目标顶点之前可能要遍历数量不定的边,也就是说,连接次数无法预先确定。
在我们的例子中,Cypher 查询里的 () -[:WITHIN*0..]-> () 模式便是如此。一个人的 LIVES_IN 边可能指向任何层级的地点:街道、城市、区、地区、州,等等。城市可能 WITHIN 某个地区,地区又 WITHIN 某个州,州再 WITHIN 某个国家。LIVES_IN 边可能直接指向待查地点,也可能还隔着好几层地点层次。
Cypher 用 :WITHIN*0.. 非常简洁地表达了这一点:“沿着 WITHIN 边走零次或多次”。它类似于正则表达式中的 * 运算符。
从 SQL:1999 开始,可以用所谓的 递归公用表表达式(recursive common table expression,WITH RECURSIVE 语法)在查询中表示长度可变的遍历路径。示例 3-6 用这种技术在 SQL 中写出了同一个查询——查找从美国移居欧洲者的姓名。只不过,与 Cypher 相比,它的语法十分笨拙。
❶:首先找到 name 属性为 "United States" 的顶点,把它作为 in_usa 顶点集的第一个元素。
❷:从 in_usa 集合中的顶点出发,沿所有 within 入边反向前进,把到达的顶点加入同一集合,直到所有 within 入边都被访问。
❸:从 name 属性为 "Europe" 的顶点出发,执行同样的操作,建立 in_europe 顶点集。
❹:对 in_usa 集合中的每个顶点,沿 born_in 入边找到出生在美国境内某地的人。
❺:同理,对 in_europe 集合中的每个顶点,沿 lives_in 入边找到居住在欧洲的人。
❻:最后,通过连接让“出生在美国的人”与“居住在欧洲的人”两个集合取交集。
同一个查询用 Cypher 只需 4 行,用 SQL 却要写 31 行,这恰恰说明选对数据模型和查询语言会带来多大差别。而这还只是开始;还有更多细节需要考虑,例如如何处理环,以及选择广度优先还是深度优先遍历 40。
Oracle 为递归查询提供了另一套 SQL 扩展,称为 层次查询(hierarchical query)41。
不过,情况可能正在改善:在本书写作时,已有计划把一种名为 GQL 的图查询语言加入 SQL 标准 42 43,其语法借鉴了 Cypher、GSQL 44 和 PGQL 45。
三元组存储与 SPARQL
三元组存储模型大体上与属性图模型相同,只是用不同的词汇描述同样的思想。不过它仍然值得单独讨论,因为三元组存储有许多现成的工具和语言,可以成为构建应用程序时的宝贵补充。
在三元组存储中,所有信息都以非常简单的三部分陈述来存储:(主语、谓语、宾语)。例如,在三元组(Jim、喜欢、香蕉)中,Jim 是主语,喜欢 是谓语(动词),香蕉 是宾语。
三元组的主语相当于图中的一个顶点,宾语则是以下两者之一:
- 字符串、数字等原始数据类型的值。这时,三元组的谓语和宾语相当于主语顶点上某项属性的键和值。例如,沿用 图 3-6 的例子,三元组(lucy、birthYear、1989)相当于顶点
lucy拥有属性{"birthYear": 1989}。 - 图中的另一个顶点。这时,谓语相当于图中的边,主语是尾部顶点,宾语是头部顶点。例如,在(lucy、marriedTo、alain)中,lucy 和 alain 都是顶点,谓语 marriedTo 则是连接二者的边标签。
示例 3-7 把 示例 3-4 中的同一份数据写成了三元组,使用的格式称为 Turtle,它是 Notation3(N3)的一个子集 48。
在这个例子中,图的顶点写成 _:someName。名称在当前文件之外没有任何意义;之所以需要它,只是为了分辨哪些三元组引用了同一个顶点。当谓语表示边时,宾语是另一个顶点,如 _:idaho :within _:usa;当谓语表示属性时,宾语则是字符串字面量,如 _:usa :name "United States"。
一遍遍重复同一个主语显得相当啰嗦,好在可以用分号连续陈述关于同一主语的多件事。这使 Turtle 格式颇为清晰易读,如 示例 3-8 所示。
三元组存储的一部分研究与开发,源于 语义网 的推动。这项始于 21 世纪初的尝试,希望数据不仅以供人阅读的网页发布,也以标准化、机器可读的格式发布,从而促进整个互联网范围内的数据交换。最初设想的语义网并未成功 49 50,但这个项目仍留下了若干具体技术:JSON-LD 等 链接数据 标准 51、生物医学中使用的 本体 52、Facebook 的 Open Graph 协议 53(用于展开链接预览 54)、Wikidata 等知识图谱,以及由 schema.org 维护的结构化数据标准词汇表。
三元组存储也是一项走出语义网原始场景、在别处找到用武之地的技术:即使你对语义网毫无兴趣,三元组仍可以成为很好的应用内部数据模型。
RDF 数据模型
示例 3-8 使用的 Turtle 语言,实际上是对 资源描述框架(RDF,Resource Description Framework)数据进行编码的一种方式 55;RDF 是专为 语义网(Semantic Web)设计的数据模型。RDF 数据也可以采用其他编码,例如用更为冗长的 XML 表示,如 示例 3-9 所示。Apache Jena 等工具可以在不同 RDF 编码之间自动转换。
RDF 有一些奇特之处,因为它是为互联网范围的数据交换而设计的。三元组的主语、谓语和宾语通常都是 URI。例如,谓语可能写成 <http://my-company.com/namespace#within> 或 <http://my-company.com/namespace#lives_in>,而不只是 WITHIN 或 LIVES_IN。这样设计是为了让不同来源的数据可以合并:即使别人赋予 within 或 lives_in 不同含义,也不会发生冲突,因为对方的谓语实际是 <http://other.org/foo#within> 和 <http://other.org/foo#lives_in>。
从 RDF 的角度看,URL <http://my-company.com/namespace> 不一定真能解析出什么内容,它不过是个命名空间。为避免与 http:// URL 混淆,本节示例使用 urn:example:within 之类不可解析的 URI。好在只须在文件开头声明一次前缀,后面便不必再操心。
SPARQL 查询语言
SPARQL 是一种面向 RDF 数据模型的三元组存储查询语言 56。(它是 SPARQL Protocol and RDF Query Language 的缩写,读作 “sparkle”。)SPARQL 早于 Cypher;Cypher 的模式匹配借鉴了 SPARQL,因此两者看起来十分相似。
之前那条查找从美国移居欧洲者的查询,用 SPARQL 表示时和用 Cypher 一样简洁(见 示例 3-10)。
二者结构十分相似。下面两个表达式是等价的(SPARQL 中的变量以问号开头):
因为 RDF 不区分属性与边,而是把二者都当作谓语,所以匹配属性也可以使用同一种语法。在下面的表达式中,变量 usa 会绑定到任意 name 属性为字符串 "United States" 的顶点:
Amazon Neptune、AllegroGraph、Blazegraph、OpenLink Virtuoso、Apache Jena 以及其他多种三元组存储都支持 SPARQL 36。
Datalog:递归关系查询
Datalog 是比 SPARQL 和 Cypher 更古老的语言,源自 20 世纪 80 年代的学术研究 57 58 59。它在软件工程师中不太知名,主流数据库也很少支持;但它表达能力很强,尤其擅长复杂查询,理应得到更多关注。Datomic、LogicBlox、CozoDB 以及 LinkedIn 的 LIquid 60 等几种小众数据库,都使用 Datalog 作为查询语言。
Datalog 实际上基于关系数据模型,而不是图模型;之所以把它放在图数据库一节,是因为 Datalog 尤其擅长对图进行递归查询。
Datalog 数据库由 事实 组成,每项事实对应关系表中的一行。假设有一张存储地点的 location 表,包含 ID、name 和 type 三列;“美国是一个国家”这项事实就可以写成 location(2, "United States", "country"),其中 2 是美国的 ID。一般来说,table(val1, val2, …) 表示 table 中有这样一行:第一列为 val1,第二列为 val2,依此类推。
示例 3-11 展示了如何用 Datalog 写出 图 3-6 左侧的数据。图中的边(within、born_in 和 lives_in)表示为两列的连接表。例如,Lucy 的 ID 是 100,爱达荷州的 ID 是 3,因此“Lucy 出生在爱达荷州”这项关系表示为 born_in(100, 3)。
定义好数据之后,就可以写出与之前相同的查询,如 示例 3-12 所示。它看起来与 Cypher 或 SPARQL 中的等价查询颇为不同,但不必因此望而却步。Datalog 是 Prolog 的一个子集;如果学过计算机科学,你或许见过这种编程语言。
Cypher 和 SPARQL 一上来便使用 SELECT,Datalog 却每次只向前迈一小步。我们通过定义 规则,从底层事实派生出新的虚拟表。这些派生表类似于(虚拟的)SQL 视图:它们并不存储在数据库中,却可以像保存事实的表一样接受查询。
示例 3-12 定义了三个派生表:within_recursive、migrated 和 us_to_europe。每条规则中 :- 符号之前的部分,定义了虚拟表的名称与各列。例如,migrated(PName, BornIn, LivingIn) 是一张三列表,分别包含姓名、出生地名称和居住地名称。
虚拟表的内容由规则中 :- 符号之后的部分定义,它会尝试在各表中找出匹配特定模式的行。例如,person(PersonID, PName) 可以匹配 person(100, "Lucy") 这一行,此时变量 PersonID 绑定为 100,PName 绑定为 "Lucy"。只要系统能为 :- 右侧的 所有 模式找到匹配,规则便可以应用。应用规则的效果,就好像把 :- 左侧的内容加入数据库,并将其中的变量替换为各自匹配的值。
因此,可以按下面的方式应用规则(如 图 3-7 所示):
- 数据库中存在
location(1, "North America", "continent"),所以规则 1 可以应用,生成within_recursive(1, "North America")。 - 数据库中存在
within(2, 1),上一步又生成了within_recursive(1, "North America"),所以规则 2 可以应用,生成within_recursive(2, "North America")。 - 数据库中存在
within(3, 2),上一步又生成了within_recursive(2, "North America"),所以再次应用规则 2,生成within_recursive(3, "North America")。
反复应用规则 1 和规则 2,within_recursive 虚拟表就能告诉我们,数据库中的哪些地点位于北美(或任何其他地点)之内。

图 3-7. 使用 示例 3-12 中的 Datalog 规则确定爱达荷州在北美。
接下来,规则 3 可以找出出生在 BornIn、现居 LivingIn 的人。规则 4 以 BornIn = 'United States' 和 LivingIn = 'Europe' 调用规则 3,只返回符合条件者的姓名。最后查询虚拟表 us_to_europe,Datalog 系统便会给出与先前 Cypher 和 SPARQL 查询相同的答案。
Datalog 需要一种不同于本章其他查询语言的思维方式。它允许逐条规则地搭建复杂查询,让一条规则引用其他规则,就像把代码拆成彼此调用的函数。函数可以递归,Datalog 规则也同样可以调用自身;示例 3-12 的规则 2 正是如此,由此实现了 Datalog 查询中的图遍历。
GraphQL
GraphQL 也是一种查询语言,但它在设计上比本章介绍的其他语言限制更多。GraphQL 的用途,是让运行在用户设备上的客户端软件(例如移动应用或 JavaScript Web 应用的前端)请求一份特定结构的 JSON 文档,其中恰好包含渲染用户界面所需的字段。借助 GraphQL 接口,开发者可以迅速修改客户端代码中的查询,而无须改动服务端 API。
GraphQL 的灵活性并非没有代价。采用 GraphQL 的组织通常需要一套工具,把 GraphQL 查询转换成对内部服务的请求,而这些内部服务往往使用 REST 或 gRPC(参见 第 5 章)。此外还要应对授权、限流和性能等问题 61。GraphQL 查询来自不受信任的来源,因此查询语言本身也受到严格限制:它不允许任何执行成本可能很高的操作,否则用户就能大量提交昂贵查询,对服务器发动拒绝服务攻击。具体来说,GraphQL 不允许递归查询(Cypher、SPARQL、SQL 和 Datalog 都允许),也不能随意给出“查找出生在美国、现居欧洲的人”这样的搜索条件,除非服务所有者特意提供了相应搜索功能。
尽管如此,GraphQL 仍然很有用。示例 3-13 展示了如何用它实现 Discord 或 Slack 这类群聊应用。查询请求用户有权访问的所有频道,并取回每个频道的名称和最近 50 条消息。对每条消息,它请求时间戳、正文,以及发送者姓名和头像 URL。若某条消息是对另一条消息的回复,查询还会请求原消息的正文与发送者姓名;界面可以用较小字号把这些内容显示在回复上方,作为上下文。
示例 3-14 给出了 示例 3-13 中查询的一种可能响应。响应是一份与查询结构相呼应的 JSON 文档:请求了哪些属性,它就不多不少地返回哪些属性。这样一来,服务器无须预先知道客户端渲染界面需要什么;客户端直接提出所需内容即可。例如,这条查询没有请求 replyTo 消息发送者的头像 URL。若界面后来要显示该头像,客户端只需在查询中加入 imageUrl 属性,无须修改服务器。
示例 3-14 把消息发送者的姓名和头像 URL 直接嵌入消息对象。同一个用户若发送多条消息,这些信息会在每条消息中重复。原则上当然可以减少这种重复,但 GraphQL 选择接受更大的响应,以换取根据数据渲染界面时更加简单。
replyTo 字段也是如此:示例 3-14 中的第二条消息回复了第一条,因此第一条消息的内容(“Hey!…”)和发送者 Aaliyah 又在 replyTo 下重复了一遍。也可以只返回被回复消息的 ID,但如果该 ID 不在这次返回的最近 50 条消息之中,客户端就得向服务器再发一次请求。直接复制内容,处理起来简单得多。
服务器端数据库可以用更加规范化的形式存储数据,并在处理查询时执行必要的连接。例如,服务器可以把消息正文与发送者的用户 ID、被回复消息的 ID 存在一起;收到上述查询时,再解析这些 ID,找出它们引用的记录。不过,客户端只能要求服务器执行 GraphQL 模式中明确开放的连接。
尽管 GraphQL 的响应看起来很像文档数据库返回的结果,而且名称中还带有 “graph”,它其实可以构建在任何数据库之上,无论是关系数据库、文档数据库还是图数据库。
事件溯源与 CQRS
在我们迄今讨论过的所有数据模型中,数据都以写入时的形式接受查询——无论它是 JSON 文档、表中的行,还是图中的顶点和边。然而在复杂应用中,有时很难找到一种数据表示,能够满足所有查询和展现数据的需求。在这种情况下,可以用一种形式写入数据,再从中派生出多种针对不同读取方式优化的表示。
我们在 “权威记录系统与衍生数据” 中已经见过这种思路,ETL(参见 “数据仓库”)就是一种派生过程。现在让我们再往前走一步。既然无论如何都要由一种数据表示派生出另一种,那就可以分别选用针对写入和读取优化的表示。如果只需优化数据写入,丝毫不必考虑查询效率,你会如何对数据建模?
也许,写入数据最简单、最快且表意最清楚的方式,就是写入 事件日志(event log):每次写入数据时,都将它编码成一个自包含的字符串(也许是 JSON),其中带有时间戳,再追加到事件序列中。日志中的事件是 不可变的(immutable):你永远不会修改或删除它们,只会向日志追加更多事件(后来的事件可以取代早先事件的效力)。事件可以包含任意属性。
图 3-8 给出了一个可能来自会议管理系统的例子。会议管理是一个复杂的业务领域:不仅个人参会者可以报名并用信用卡付款,企业也可以批量预订座位,以发票结算,再把座位分配给个人。演讲者、赞助商和志愿者等人可能要占用一些预留座位。预订还可能取消;与此同时,会议组织者又可能因为更换场地,而改变活动的容量。这些事情叠加在一起,哪怕只是计算还有多少空余座位,也会变成一项颇具挑战的查询。

在 图 3-8 中,会议状态的每次变化(例如组织者开放报名,或参会者报名和取消报名),首先都会被存储为事件。每当日志追加一个事件,几个 物化视图(materialized view,也称为 投影,projection,或 读模型,read model)也会随之更新,以反映该事件带来的影响。在这个会议示例中,可以有一个物化视图汇总每笔预订状态的所有相关信息,另一个计算会议组织者仪表盘所需的图表,第三个则为制作参会者胸牌的打印机生成文件。
以事件作为权威数据源,并把每次状态变化都表达为事件,这种思路称为 事件溯源(event sourcing)62 63。维护独立的读取优化表示,并从写入优化的表示中派生它们,这种原则称为 命令查询责任分离(Command Query Responsibility Segregation,CQRS)64。这些术语源自领域驱动设计(DDD)社区,不过类似的思路由来已久,例如 状态机复制(state machine replication;参见 “使用共享日志”)。
当来自用户的请求刚到达时,它还是一个 命令(command),首先需要验证。只有在命令已经执行且确认有效之后(例如,请求的预订有足够的空余座位),它才会成为事实,相应的事件也才会追加到日志中。因此,事件日志中应当只有有效事件;消费事件日志来构建物化视图的组件,不允许拒绝事件。
以事件溯源的方式对数据建模时,建议用过去时来命名事件(例如“座位已预订”),因为事件记录的是已经发生的事实。即使用户后来更改或取消预订,他们曾经预订过的事实依然成立;更改或取消是之后另行追加的事件。
事件溯源与星型模式的事实表(参见 “星型与雪花型:分析模式”)有一个相似之处:它们都是过去所发生事件的集合。不过,事实表中每一行的列都相同,事件溯源中则可以有许多类型不同、属性各异的事件。此外,事实表是无序集合,而事件溯源中事件的先后顺序很重要:如果一笔预订先成立、后取消,颠倒顺序处理这两个事件就毫无意义。
事件溯源和 CQRS 有几个优点:
- 对系统开发者来说,事件能更清楚地表达某件事 为什么 发生。例如,理解“预订已取消”这个事件,要比理解“
bookings表第 4001 行的active列已设为false,seat_assignments表中与该预订相关的三行已被删除,payments表中又插入了一行表示退款”容易得多。物化视图处理取消事件时,依然可能会对这些行执行修改;但由事件驱动这些更新,其原因就清楚得多。 - 事件溯源的一项关键原则,是物化视图应以可重现的方式从事件日志中派生:你应当随时能够删除物化视图,然后用同一套代码,按同样的顺序处理同样的事件,从而重新计算出视图。如果视图维护代码存在错误,只需删除视图,再用修正后的代码重算。错误也更容易查找,因为你可以反复重新运行视图维护代码,并检查它的行为。
- 你可以维护多个物化视图,分别针对应用所需的特定查询进行优化。它们可以与事件保存在同一个数据库中,也可以根据需要存入不同的数据库。这些视图可以使用任何数据模型,也可以通过反规范化来加快读取。只要服务重启时可以从事件日志重算视图,甚至可以只把它保留在内存中,根本不做持久化。
- 如果决定以新方式展现现有信息,可以很容易地根据现有事件日志构建新的物化视图。添加新的事件类型,或给现有事件类型添加新属性(旧事件保持不变),就能让系统演化并支持新功能。还可以在现有事件后触发新的行为,例如参会者取消预订后,将座位提供给等候名单中的下一个人。
- 如果误写了某个事件,可以把它删除,再重建不包含该事件的视图。相比之下,在直接更新和删除数据的数据库中,已经提交的事务往往很难撤销。因此,事件溯源可以减少系统中不可逆操作的数量,让变更更容易(参见 “可演化性:让变化更容易”)。
- 事件日志还可以作为审计日志,记录系统中发生的一切。在必须提供审计能力的受监管行业中,这一点很有价值。
然而,事件溯源和 CQRS 也有缺点:
- 涉及外部信息时必须小心。例如,假设事件中有一个以某种货币计价的价格,而某个视图需要把它兑换成另一种货币。由于汇率会波动,处理事件时再从外部数据源获取汇率就有问题:换一天重新计算物化视图,得到的结果就可能不同。为了让事件处理逻辑具有确定性,要么把汇率写入事件本身,要么提供一种方法,能查询事件时间戳所对应的历史汇率,并确保同一时间戳始终返回同一结果。
- 事件不可变这一要求,在事件包含用户个人数据时会带来问题,因为用户可能行使自己的权利(例如 GDPR 规定的权利),要求删除个人数据。如果每个用户各有一份事件日志,只需删除该用户的整份日志;但如果日志中的事件关系到多个用户,这种做法就行不通。可以尝试把个人数据存在事件之外,或者用一把密钥加密,以便日后删除密钥;但这也会让按需重算派生状态变得更困难。
- 如果处理事件会带来外部可见的副作用,那么重新处理事件时必须小心。例如,你大概不会希望每次重建物化视图时,都再发一遍确认邮件。
事件溯源可以构建在任何数据库之上,不过也有一些系统是专为这种模式设计的,例如 EventStoreDB、MartenDB(基于 PostgreSQL)和 Axon Framework。也可以使用 Apache Kafka 之类的消息代理来存储事件日志,并通过流处理器使物化视图保持最新;我们将在 “变更数据捕获与事件溯源” 中再次讨论这些主题。
唯一一项重要要求是:事件存储系统必须保证,所有物化视图都以事件在日志中出现的顺序处理它们。正如我们将在 第 10 章 中看到的,这在分布式系统中并不总是一件容易的事。
数据框、矩阵与数组
本章迄今介绍的数据模型,通常既用于事务处理,也用于分析(参见 “分析型与事务型系统”)。还有一些数据模型常见于分析或科学场景,却很少出现在 OLTP 系统中:数据框(dataframe),以及矩阵等多维数值数组。
R 语言、Python 的 pandas 库、Apache Spark、ArcticDB 和 Dask 等系统,都支持数据框这种数据模型。数据科学家经常用它为训练机器学习模型准备数据;它也广泛用于数据探索、统计分析和数据可视化等场景。
乍看之下,数据框很像关系数据库中的表,也像电子表格。它支持一系列类似关系运算符的批量操作:例如,对所有行应用某个函数,按条件筛选行,按某些列分组并聚合其他列,以及按某个键连接两个数据框中的行(关系数据库中的 连接,在数据框中通常称为 合并,merge)。
数据框通常不是通过 SQL 之类的声明式查询来操作,而是通过一系列命令逐步修改其结构和内容。这恰好符合数据科学家的典型工作流程:一点点地“整理”数据,直至它变成一种适合回答当前问题的形式。这些操作通常在数据科学家私有的数据集副本上进行,而且往往就在本机上;不过最终结果也可能会分享给其他用户。
数据框 API 提供的许多操作远远超出关系数据库的能力,其使用方式也往往与典型的关系数据建模大不相同 65。例如,数据框的一种常见用途,是把数据从类似关系模型的表示转换为矩阵或多维数组,而许多机器学习算法期望的输入正是这种形式。
图 3-9 展示了一个简单的转换示例。左侧是一张关系表,记录不同用户给各种电影打出的分数(1 到 5 分);右侧则把这些数据转换成了矩阵,每一列代表一部电影,每一行代表一位用户(类似电子表格中的 数据透视表,pivot table)。这个矩阵是 稀疏(sparse)的,也就是说,很多用户与电影的组合都没有数据,但这并不碍事。矩阵可能有成千上万列,不太适合放在关系数据库中;数据框以及 Python 的 NumPy 等支持稀疏数组的库,却能轻松处理这类数据。

矩阵只能包含数字,因此需要用各种技术把非数值数据转换为矩阵中的数字。例如:
- 日期(图 3-9 的示例矩阵中省略了日期)可以按比例缩放为某个合适范围内的浮点数。
- 对于只能从一小组固定值中取值的列(例如电影数据库中的电影类型),通常采用 独热编码(one-hot encoding):为每个可能的值建立一列(“喜剧”一列、“剧情”一列、“恐怖”一列,依此类推);对于代表某部电影的每一行,在对应其类型的列中填 1,其余列填 0。这种表示也很容易推广到同时属于多种类型的电影。
数据一旦变成数值矩阵,就适合进行线性代数运算,而线性代数正是许多机器学习算法的基础。例如,图 3-9 中的数据可以用在向用户推荐其可能喜欢的电影的系统中。数据框十分灵活,可以让数据从关系形式逐步演变为矩阵表示,同时让数据科学家自行掌控哪种表示最适合达成数据分析或模型训练的目标。
还有一些数据库专门存储大型多维数值数组,例如 TileDB 66。这类系统称为 数组数据库(array database),最常用于科学数据集,例如地理空间测量数据(规则间隔网格上的栅格数据)、医学影像或天文望远镜的观测结果 67。金融行业也用数据框表示 时间序列数据(time-series data),例如资产价格以及按时间记录的交易 68。
总结
数据模型是一个巨大的课题,本章只是快速浏览了各种不同的模型。我们没有足够的篇幅详述每个模型,但希望这份概览足以引起你的兴趣,促使你进一步了解最适合应用需求的模型。
关系模型 尽管已有半个多世纪的历史,但对许多应用来说仍然是一种重要的数据模型——尤其是在数据仓库和商业分析领域,关系型星型或雪花型模式与 SQL 查询无处不在。不过,关系数据的几种替代方案也在其他领域流行起来:
- 文档模型 主要关注自包含的 JSON 数据文档,而且文档之间的关系非常稀少。
- 图数据模型 用于相反的场景:任意事物都可能与其他一切事物相关,查询可能需要跨越多跳才能找到感兴趣的数据(这类查询可以用 Cypher、SPARQL 或 Datalog 中的递归查询来表达)。
- 数据框 把关系数据推广到拥有大量列的情形,在数据库与多维数组之间架起了桥梁;而多维数组正是许多机器学习、统计分析和科学计算的基础。
一个模型可以用另一个模型来模拟——例如,图数据可以在关系数据库中表示——但结果往往很别扭,正如 SQL 对递归查询的支持所表明的那样。
因此,人们为每种数据模型开发了各式各样的专用数据库,提供针对该模型优化的查询语言和存储引擎。另一方面,数据库也在不断加入对其他数据模型的支持,向相邻领域扩展:例如,关系数据库通过 JSON 列支持文档数据,文档数据库加入类似关系模型的连接,而 SQL 对图数据的支持也在逐步改善。
我们还讨论了 事件溯源:它把数据表示为不可变事件的仅追加日志,这种形式可能很适合为复杂业务领域中的活动建模。仅追加日志有利于数据写入(正如我们将在 第 4 章 中看到的);为了支持高效查询,CQRS 会把事件日志转换为针对读取优化的物化视图。
非关系数据模型的一个共同点是,它们通常不会将存储的数据强制约束为特定模式,这可以使应用更容易适应不断变化的需求。但是应用很可能仍会假定数据具有一定的结构;区别仅在于模式是 明确的(写入时强制)还是 隐含的(读取时假定)。
虽然我们已经覆盖了很多层面,但仍有一些数据模型没有提到。举几个简单的例子:
- 研究基因组数据的研究人员通常需要执行 序列相似性搜索,这意味着取一个很长的字符串(代表一个 DNA 分子),在一个包含大量相似但不完全相同的字符串的数据库中寻找匹配。这里描述的数据库都不能处理这种用法,这就是研究人员编写了 GenBank 69 等专用基因组数据库软件的原因。
- 许多金融系统以采用复式记账法的 账本 作为数据模型。这类数据可以用关系数据库表示,但也有 TigerBeetle 这样专攻此类数据模型的数据库。加密货币和区块链通常基于分布式账本,并把价值转移也内置在数据模型之中。
- 全文检索 可以说是一种经常与数据库配合使用的数据模型。信息检索是一个很大的专业课题,本书不会深入介绍,但我们将在 “全文检索” 中谈到搜索索引与向量搜索。
我们暂且说到这里。在下一章中,我们将讨论在 实现 本章描述的数据模型时会遇到的一些权衡。
参考文献
Jamie Brandon. Unexplanations: query optimization works because sql is declarative. scattered-thoughts.net, February 2024. Archived at perma.cc/P6W2-WMFZ ↩︎
Joseph M. Hellerstein. The Declarative Imperative: Experiences and Conjectures in Distributed Logic. Tech report UCB/EECS-2010-90, Electrical Engineering and Computer Sciences, University of California at Berkeley, June 2010. Archived at perma.cc/K56R-VVQM ↩︎
Edgar F. Codd. A Relational Model of Data for Large Shared Data Banks. Communications of the ACM, volume 13, issue 6, pages 377–387, June 1970. doi:10.1145/362384.362685 ↩︎ ↩︎
Michael Stonebraker and Joseph M. Hellerstein. What Goes Around Comes Around. In Readings in Database Systems, 4th edition, MIT Press, pages 2–41, 2005. ISBN: 9780262693141 ↩︎
Markus Winand. Modern SQL: Beyond Relational. modern-sql.com, 2015. Archived at perma.cc/D63V-WAPN ↩︎
Martin Fowler. OrmHate. martinfowler.com, May 2012. Archived at perma.cc/VCM8-PKNG ↩︎
Vlad Mihalcea. N+1 query problem with JPA and Hibernate. vladmihalcea.com, January 2023. Archived at perma.cc/79EV-TZKB ↩︎
Jens Schauder. This is the Beginning of the End of the N+1 Problem: Introducing Single Query Loading. spring.io, August 2023. Archived at perma.cc/6V96-R333 ↩︎
William Zola. 6 Rules of Thumb for MongoDB Schema Design. mongodb.com, June 2014. Archived at perma.cc/T2BZ-PPJB ↩︎ ↩︎
Sidney Andrews and Christopher McClister. Data modeling in Azure Cosmos DB. learn.microsoft.com, February 2023. Archived at archive.org ↩︎
Raffi Krikorian. Timelines at Scale. At QCon San Francisco, November 2012. Archived at perma.cc/V9G5-KLYK ↩︎ ↩︎
Ralph Kimball and Margy Ross. The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling, 3rd edition. John Wiley & Sons, July 2013. ISBN: 9781118530801 ↩︎ ↩︎
Michael Kaminsky. Data warehouse modeling: Star schema vs. OBT. fivetran.com, August 2022. Archived at perma.cc/2PZK-BFFP ↩︎
Joe Nelson. User-defined Order in SQL. begriffs.com, March 2018. Archived at perma.cc/GS3W-F7AD ↩︎
Evan Wallace. Realtime Editing of Ordered Sequences. figma.com, March 2017. Archived at perma.cc/K6ER-CQZW ↩︎
David Greenspan. Implementing Fractional Indexing. observablehq.com, October 2020. Archived at perma.cc/5N4R-MREN ↩︎
Martin Fowler. Schemaless Data Structures. martinfowler.com, January 2013. ↩︎
Amr Awadallah. Schema-on-Read vs. Schema-on-Write. At Berkeley EECS RAD Lab Retreat, Santa Cruz, CA, May 2009. Archived at perma.cc/DTB2-JCFR ↩︎
Martin Odersky. The Trouble with Types. At Strange Loop, September 2013. Archived at perma.cc/85QE-PVEP ↩︎
Conrad Irwin. MongoDB—Confessions of a PostgreSQL Lover. At HTML5DevConf, October 2013. Archived at perma.cc/C2J6-3AL5 ↩︎
Percona Toolkit Documentation: pt-online-schema-change. docs.percona.com, 2023. Archived at perma.cc/9K8R-E5UH ↩︎
Shlomi Noach. gh-ost: GitHub’s Online Schema Migration Tool for MySQL. github.blog, August 2016. Archived at perma.cc/7XAG-XB72 ↩︎
Shayon Mukherjee. pg-osc: Zero downtime schema changes in PostgreSQL. shayon.dev, February 2022. Archived at perma.cc/35WN-7WMY ↩︎
Carlos Pérez-Aradros Herce. Introducing pgroll: zero-downtime, reversible, schema migrations for Postgres. xata.io, October 2023. Archived at archive.org ↩︎
James C. Corbett, Jeffrey Dean, Michael Epstein, Andrew Fikes, Christopher Frost, JJ Furman, Sanjay Ghemawat, Andrey Gubarev, Christopher Heiser, Peter Hochschild, Wilson Hsieh, Sebastian Kanthak, Eugene Kogan, Hongyi Li, Alexander Lloyd, Sergey Melnik, David Mwaura, David Nagle, Sean Quinlan, Rajesh Rao, Lindsay Rolig, Dale Woodford, Yasushi Saito, Christopher Taylor, Michal Szymaniak, and Ruth Wang. Spanner: Google’s Globally-Distributed Database. At 10th USENIX Symposium on Operating System Design and Implementation (OSDI), October 2012. ↩︎
Donald K. Burleson. Reduce I/O with Oracle Cluster Tables. dba-oracle.com. Archived at perma.cc/7LBJ-9X2C ↩︎
Fay Chang, Jeffrey Dean, Sanjay Ghemawat, Wilson C. Hsieh, Deborah A. Wallach, Mike Burrows, Tushar Chandra, Andrew Fikes, and Robert E. Gruber. Bigtable: A Distributed Storage System for Structured Data. At 7th USENIX Symposium on Operating System Design and Implementation (OSDI), November 2006. ↩︎
Priscilla Walmsley. XQuery, 2nd Edition. O’Reilly Media, December 2015. ISBN: 9781491915080 ↩︎
Paul C. Bryan, Kris Zyp, and Mark Nottingham. JavaScript Object Notation (JSON) Pointer. RFC 6901, IETF, April 2013. ↩︎
Stefan Gössner, Glyn Normington, and Carsten Bormann. JSONPath: Query Expressions for JSON. RFC 9535, IETF, February 2024. ↩︎
Michael Stonebraker and Andrew Pavlo. What Goes Around Comes Around… And Around…. ACM SIGMOD Record, volume 53, issue 2, pages 21–37. doi:10.1145/3685980.3685984 ↩︎
Lawrence Page, Sergey Brin, Rajeev Motwani, and Terry Winograd. The PageRank Citation Ranking: Bringing Order to the Web. Technical Report 1999-66, Stanford University InfoLab, November 1999. Archived at perma.cc/UML9-UZHW ↩︎
Nathan Bronson, Zach Amsden, George Cabrera, Prasad Chakka, Peter Dimov, Hui Ding, Jack Ferris, Anthony Giardullo, Sachin Kulkarni, Harry Li, Mark Marchukov, Dmitri Petrov, Lovro Puzar, Yee Jiun Song, and Venkat Venkataramani. TAO: Facebook’s Distributed Data Store for the Social Graph. At USENIX Annual Technical Conference (ATC), June 2013. ↩︎
Natasha Noy, Yuqing Gao, Anshu Jain, Anant Narayanan, Alan Patterson, and Jamie Taylor. Industry-Scale Knowledge Graphs: Lessons and Challenges. Communications of the ACM, volume 62, issue 8, pages 36–43, August 2019. doi:10.1145/3331166 ↩︎
Xiyang Feng, Guodong Jin, Ziyi Chen, Chang Liu, and Semih Salihoğlu. KÙZU Graph Database Management System. At 3th Annual Conference on Innovative Data Systems Research (CIDR 2023), January 2023. ↩︎ ↩︎
Maciej Besta, Emanuel Peter, Robert Gerstenberger, Marc Fischer, Michał Podstawski, Claude Barthels, Gustavo Alonso, Torsten Hoefler. Demystifying Graph Databases: Analysis and Taxonomy of Data Organization, System Designs, and Graph Queries. arxiv.org, October 2019. ↩︎ ↩︎
Apache TinkerPop 3.6.3 Documentation. tinkerpop.apache.org, May 2023. Archived at perma.cc/KM7W-7PAT ↩︎
Nadime Francis, Alastair Green, Paolo Guagliardo, Leonid Libkin, Tobias Lindaaker, Victor Marsault, Stefan Plantikow, Mats Rydberg, Petra Selmer, and Andrés Taylor. Cypher: An Evolving Query Language for Property Graphs. At International Conference on Management of Data (SIGMOD), pages 1433–1445, May 2018. doi:10.1145/3183713.3190657 ↩︎
Emil Eifrem. Twitter correspondence, January 2014. Archived at perma.cc/WM4S-BW64 ↩︎
Francesco Tisiot. Explore the new SEARCH and CYCLE features in PostgreSQL® 14. aiven.io, December 2021. Archived at perma.cc/J6BT-83UZ ↩︎
Gaurav Goel. Understanding Hierarchies in Oracle. towardsdatascience.com, May 2020. Archived at perma.cc/5ZLR-Q7EW ↩︎
Alin Deutsch, Nadime Francis, Alastair Green, Keith Hare, Bei Li, Leonid Libkin, Tobias Lindaaker, Victor Marsault, Wim Martens, Jan Michels, Filip Murlak, Stefan Plantikow, Petra Selmer, Oskar van Rest, Hannes Voigt, Domagoj Vrgoč, Mingxi Wu, and Fred Zemke. Graph Pattern Matching in GQL and SQL/PGQ. At International Conference on Management of Data (SIGMOD), pages 2246–2258, June 2022. doi:10.1145/3514221.3526057 ↩︎
Alastair Green. SQL… and now GQL. opencypher.org, September 2019. Archived at perma.cc/AFB2-3SY7 ↩︎
Alin Deutsch, Yu Xu, and Mingxi Wu. Seamless Syntactic and Semantic Integration of Query Primitives over Relational and Graph Data in GSQL. tigergraph.com, November 2018. Archived at perma.cc/JG7J-Y35X ↩︎
Oskar van Rest, Sungpack Hong, Jinha Kim, Xuming Meng, and Hassan Chafi. PGQL: a property graph query language. At 4th International Workshop on Graph Data Management Experiences and Systems (GRADES), June 2016. doi:10.1145/2960414.2960421 ↩︎
Amazon Web Services. Neptune Graph Data Model. Amazon Neptune User Guide, docs.aws.amazon.com. Archived at perma.cc/CX3T-EZU9 ↩︎
Cognitect. Datomic Data Model. Datomic Cloud Documentation, docs.datomic.com. Archived at perma.cc/LGM9-LEUT ↩︎
David Beckett and Tim Berners-Lee. Turtle – Terse RDF Triple Language. W3C Team Submission, March 2011. ↩︎
Sinclair Target. Whatever Happened to the Semantic Web? twobithistory.org, May 2018. Archived at perma.cc/M8GL-9KHS ↩︎
Gavin Mendel-Gleason. The Semantic Web is Dead – Long Live the Semantic Web! terminusdb.com, August 2022. Archived at perma.cc/G2MZ-DSS3 ↩︎
Manu Sporny. JSON-LD and Why I Hate the Semantic Web. manu.sporny.org, January 2014. Archived at perma.cc/7PT4-PJKF ↩︎
University of Michigan Library. Biomedical Ontologies and Controlled Vocabularies, guides.lib.umich.edu/ontology. Archived at perma.cc/Q5GA-F2N8 ↩︎
Facebook. The Open Graph protocol, ogp.me. Archived at perma.cc/C49A-GUSY ↩︎
Matt Haughey. Everything you ever wanted to know about unfurling but were afraid to ask /or/ How to make your site previews look amazing in Slack. medium.com, November 2015. Archived at perma.cc/C7S8-4PZN ↩︎
W3C RDF Working Group. Resource Description Framework (RDF). w3.org, February 2004. ↩︎
Steve Harris, Andy Seaborne, and Eric Prud’hommeaux. SPARQL 1.1 Query Language. W3C Recommendation, March 2013. ↩︎
Todd J. Green, Shan Shan Huang, Boon Thau Loo, and Wenchao Zhou. Datalog and Recursive Query Processing. Foundations and Trends in Databases, volume 5, issue 2, pages 105–195, November 2013. doi:10.1561/1900000017 ↩︎
Stefano Ceri, Georg Gottlob, and Letizia Tanca. What You Always Wanted to Know About Datalog (And Never Dared to Ask). IEEE Transactions on Knowledge and Data Engineering, volume 1, issue 1, pages 146–166, March 1989. doi:10.1109/69.43410 ↩︎
Serge Abiteboul, Richard Hull, and Victor Vianu. Foundations of Databases. Addison-Wesley, 1995. ISBN: 9780201537710, available online at webdam.inria.fr/Alice ↩︎
Scott Meyer, Andrew Carter, and Andrew Rodriguez. LIquid: The soul of a new graph database, Part 2. engineering.linkedin.com, September 2020. Archived at perma.cc/K9M4-PD6Q ↩︎
Matt Bessey. Why, after 6 years, I’m over GraphQL. bessey.dev, May 2024. Archived at perma.cc/2PAU-JYRA ↩︎
Dominic Betts, Julián Domínguez, Grigori Melnik, Fernando Simonazzi, and Mani Subramanian. Exploring CQRS and Event Sourcing. Microsoft Patterns & Practices, July 2012. ISBN: 1621140164, archived at perma.cc/7A39-3NM8 ↩︎
Greg Young. CQRS and Event Sourcing. At Code on the Beach, August 2014. ↩︎
Greg Young. CQRS Documents. cqrs.wordpress.com, November 2010. Archived at perma.cc/X5R6-R47F ↩︎
Devin Petersohn, Stephen Macke, Doris Xin, William Ma, Doris Lee, Xiangxi Mo, Joseph E. Gonzalez, Joseph M. Hellerstein, Anthony D. Joseph, and Aditya Parameswaran. Towards Scalable Dataframe Systems. Proceedings of the VLDB Endowment, volume 13, issue 11, pages 2033–2046. doi:10.14778/3407790.3407807 ↩︎
Stavros Papadopoulos, Kushal Datta, Samuel Madden, and Timothy Mattson. The TileDB Array Data Storage Manager. Proceedings of the VLDB Endowment, volume 10, issue 4, pages 349–360, November 2016. doi:10.14778/3025111.3025117 ↩︎
Florin Rusu. Multidimensional Array Data Management. Foundations and Trends in Databases, volume 12, numbers 2–3, pages 69–220, February 2023. doi:10.1561/1900000069 ↩︎
Ed Targett. Bloomberg, Man Group team up to develop open source “ArcticDB” database. thestack.technology, March 2023. Archived at perma.cc/M5YD-QQYV ↩︎
Dennis A. Benson, Ilene Karsch-Mizrachi, David J. Lipman, James Ostell, and David L. Wheeler. GenBank. Nucleic Acids Research, volume 36, database issue, pages D25–D30, December 2007. doi:10.1093/nar/gkm929 ↩︎
4 存储与检索

人生的苦恼之一,就是每个人给事物起的名字总有那么一点不对。于是,世上的一切都变得比换个名字时更难理解。计算机最主要的用途,并不是通常所谓做算术的“计算”。[……] 它们主要是档案系统。
理查德・费曼, 特立独行的思考 研讨会(1985 年)
一个数据库在最基础的层次上需要完成两件事情:当你把数据交给数据库时,它应当把数据存储起来;而后当你向数据库要数据时,它应当把数据返回给你。
在 第 3 章 中,我们讨论了数据模型和查询语言,即你将数据交给数据库时采用的格式,以及日后向数据库取回数据时使用的接口。在本章中,我们会从数据库的视角来讨论同样的问题:数据库如何存储我们提供的数据,以及如何在我们需要时重新找到数据。
作为应用开发者,为什么要关心数据库内部存储与检索的机理?你可能不会从头开始实现自己的 存储引擎(storage engine),但是你 确实 需要从许多可用的存储引擎中选择一个适合应用的。为了让存储引擎能在你的工作负载上运行良好,你也需要大致了解它在底层究竟做了什么。
尤其需要注意,针对事务型工作负载(OLTP)优化的存储引擎,与针对分析型工作负载优化的存储引擎之间存在巨大差异(这种区别已在 “分析型与事务型系统” 中介绍)。本章首先考察 OLTP 存储引擎的两大类:写出不可变数据文件的 日志结构(log-structured)存储引擎,以及像 B 树 这样就地更新数据的存储引擎。键值存储(key-value store)和 二级索引(secondary index)都可以采用这两类结构。
稍后在 “分析型数据存储” 中,我们会讨论一类针对分析优化的存储引擎;在 “多维索引与全文索引” 中,还会简要介绍用于文本检索等复杂查询的索引。
OLTP 系统的存储与索引
世界上最简单的数据库可以用两个 Bash 函数实现:
这两个函数实现了键值存储。调用 db_set key value,会将 key 和 value 存入数据库。键和值(几乎)可以是任意内容,例如值可以是一个 JSON 文档。随后调用 db_get key,就会查找与这个键关联的最新值并将其返回。
麻雀虽小,五脏俱全:
底层存储格式非常简单:一个文本文件,每行包含一条以逗号分隔的键值对(忽略转义问题的话,大致与 CSV 文件类似)。每次调用 db_set 都会向文件末尾追加记录。多次更新一个键时,旧版本的值不会被覆盖——因而要找到最新值,就必须查看这个键在文件中最后一次出现的位置(所以 db_get 中使用了 tail -n 1):
db_set 函数对于如此简单的实现其实有着相当不错的性能,因为在文件末尾追加写入通常非常高效。与 db_set 所做的事情类似,许多数据库在内部使用 日志(log),也就是仅追加的数据文件。真正的数据库还要处理更多问题(例如并发写入、回收磁盘空间以免日志无限增长,以及崩溃恢复时处理只写了一部分的记录),但基本原理是一样的。日志极其有用,我们还会在本书中多次遇到它。
日志 这个词通常指应用日志,即应用程序输出的、描述正在发生之事的文本。本书在更普遍的意义上使用 日志 一词:磁盘上仅追加的记录序列。它不一定供人阅读,也可能采用二进制格式,只供数据库系统内部使用。
另一方面,如果数据库中有大量记录,db_get 函数的性能就会非常糟糕。每次查找一个键,db_get 都必须从头到尾扫描整个数据库文件,寻找这个键。用算法的语言来说,查找开销是 O(n):如果数据库中的记录数 n 翻了一倍,查找时间也要翻一倍。这就不好了。
为了高效查找数据库中特定键的值,我们需要一种数据结构:索引(index)。本章将介绍一系列索引结构,并比较它们之间的差异。索引背后的大致思想,是以某种特定方式组织数据(例如按某个键排序),从而更快地定位想要的数据。如果想以几种不同的方式搜索同一份数据,那么也许需要在数据的不同部分建立多个索引。
索引是从主数据衍生出的 额外 结构。许多数据库允许添加和删除索引,这不会影响数据库的内容,只会影响查询性能。维护额外结构会产生开销,特别是在写入时。写入性能很难超过简单地向文件末尾追加,因为追加是最简单的写入操作。任何类型的索引通常都会拖慢写入速度,因为每次写入数据时还必须更新索引。
这是存储系统中一项重要的权衡:精心选择的索引能加快读查询,但每个索引都会占用额外的磁盘空间,并拖慢写入速度,有时影响还相当显著 1。因此,数据库通常不会默认索引所有内容,而是要求编写应用程序或管理数据库的人,根据自己对典型查询模式的了解手动选择索引。这样便可以选出给应用带来最大收益的索引,同时避免不必要的写入开销。
日志结构存储
首先假设你仍想把数据保存在 db_set 写入的仅追加文件中,只是希望加快读取速度。最简单的索引策略是保留一个内存中的哈希映射,其中每个键都映射到数据文件里的一个字节偏移量,指明该键最新的值位于何处,如 图 4-1 所示。

每当向文件追加新的键值对时,还要更新哈希映射,使它指向刚刚写入的数据。查找一个值时,先用哈希映射找到日志文件中的偏移量,再寻道至该位置读取即可。如果数据文件的这一部分已经在文件系统缓存中,读取甚至完全不需要磁盘 I/O。
这种方法快得多,但仍有几个问题:
- 被新值覆盖的旧日志条目仍占着磁盘空间,始终得不到释放;只要继续写入数据库,磁盘空间迟早会耗尽。
- 哈希映射没有持久化,数据库重启时必须重建。例如,可以扫描整个日志文件,找出每个键最新的字节偏移量。如果数据量很大,重启就会十分缓慢。
- 哈希表必须能放进内存。原则上可以在磁盘上维护哈希表,可惜磁盘哈希表很难有良好的性能:它需要大量随机访问 I/O,装满后的扩容代价很高,而且解决哈希冲突需要烦琐的逻辑 2。
- 范围查询效率不高。例如,无法轻松扫描
10000到19999之间的所有键,只能在哈希映射中逐个查找。
SSTable 文件格式
实践中,数据库索引很少采用哈希表,更常见的做法是把数据保存在 按键排序 的结构中 3。排序字符串表(Sorted String Table,简称 SSTable)便是一例,如 图 4-2 所示。这种文件格式同样存储键值对,但保证键值对按键排序,而且每个键在文件中只出现一次。

这样便不必在内存中保留所有键。可以把 SSTable 中的键值对分成若干个几千字节大小的 块(block),索引只存储每个块的第一个键。这种只收录部分键的索引称为 稀疏索引(sparse index)。索引保存在 SSTable 的一个独立区域中,可以采用不可变 B 树、字典树或其他能快速查找特定键的数据结构 4。
以 图 4-2 为例,一个块的第一个键是 handbag,下一个块的第一个键是 handsome。假设要查找没有出现在稀疏索引中的 handiwork。根据排序关系可知,handiwork 必定在 handbag 与 handsome 之间。因此,可以寻道至 handbag 的偏移量,再从那里开始扫描文件,直到找到 handiwork;如果一直扫到下一个块仍未找到,就说明文件中没有这个键。几千字节的数据块很快就能扫描完。
此外,每个记录块都可以压缩(图 4-2 中的阴影区域)。除了节省磁盘空间,压缩还能减少 I/O 带宽的使用,代价只是多耗费一点 CPU 时间。
构建和合并 SSTable
SSTable 文件格式比仅追加日志更利于读取,却让写入变得困难。不能直接向文件末尾追加,否则文件就不再有序(除非键碰巧按升序写入)。如果每次在文件中间插入一个键都要重写整个 SSTable,写入成本又会高得无法接受。
解决办法是采用 日志结构 方法,将仅追加日志与排序文件结合起来:
- 收到写入时,将其加入内存中的有序映射数据结构,例如红黑树、跳表 5 或字典树 6。这类数据结构可以按任意顺序插入键、高效查找键,并按排序顺序读出键。这个内存数据结构称为 内存表(memtable)。
- 当内存表超过某个阈值(通常为几兆字节)时,按排序顺序将它写成磁盘上的 SSTable 文件。这个新的 SSTable 文件称为数据库最新的 段(segment),它与较旧的段分别存放在独立文件中,每个段都有自己的索引。向磁盘写出新段期间,数据库可以继续向新的内存表实例写入;SSTable 写完后,旧内存表占用的内存即可释放。
- 读取某个键的值时,先在内存表和磁盘上最新的段中查找。如果没有找到,就依次查看更旧的段,直到找到这个键或查完最旧的段。如果任何段中都没有这个键,它就不存在于数据库中。
- 后台不时运行合并与压实过程,将段文件合并起来,并丢弃已经覆盖或删除的值。
段的合并类似于 归并排序 算法 5,如 图 4-3 所示。并行读取各个输入文件,比较每个文件当前的第一个键,把排序最靠前的键复制到输出文件,然后不断重复。如果同一个键出现在多个输入文件中,只保留较新的值。这样生成的新段仍按键排序,每个键只保留一个值;由于可以逐键遍历 SSTable,整个过程只需要很少的内存。

为了避免数据库崩溃时丢失内存表中的数据,存储引擎还会在磁盘上保存一个单独的日志,每次写入都会立即追加到这个日志。日志不按键排序,但这并不重要,因为它的唯一用途是在崩溃后恢复内存表。每当内存表写成 SSTable 后,日志中相应的部分便可丢弃。
如果要删除一个键及其关联的值,必须向数据文件追加一种称为 墓碑(tombstone)的特殊删除记录。日志段合并时,墓碑会指示合并过程丢弃这个键此前的所有值。墓碑一旦合并进最旧的段,自身也就可以删除。
这里描述的算法,本质上就是 RocksDB 7、Cassandra、ScyllaDB 和 HBase 8 所采用的算法。这些系统都受 Google Bigtable 论文 9 的启发;SSTable 和 memtable 两个术语正是由该论文提出的。
这一算法最初发表于 1996 年,名为 日志结构合并树(Log-Structured Merge-Tree,简称 LSM 树)10,它建立在更早的日志结构文件系统研究之上 11。因此,凡是以合并、压实有序文件为基本原理的存储引擎,通常都称为 LSM 存储引擎。
在 LSM 存储引擎中,段文件会一次写完(或者由内存表写出,或者由若干现有段合并而成),此后便不可变。段的合并与压实可以由后台线程完成;在此期间,旧段文件仍可继续处理读取请求。合并完成后,读取请求切换到新的合并段,旧段文件即可删除。
段文件不一定要保存在本地磁盘上;它们也非常适合写入对象存储。例如,SlateDB 和 Delta Lake 就采用这种方法 12。
段文件不可变,也让崩溃恢复变得更简单:如果写出内存表或合并段时发生崩溃,数据库只需删除未完成的 SSTable,再重新开始即可。用于持久化内存表写入的日志,可能因写到一半时崩溃或磁盘已满而留下不完整记录;通常可以借助日志中的校验和检测这些记录,并丢弃损坏或不完整的条目。我们将在 第 8 章 进一步讨论持久性与崩溃恢复。
布隆过滤器
在 LSM 存储中,读取很久以前才更新过的键,或读取根本不存在的键,可能十分缓慢,因为存储引擎必须检查多个段文件。为了加快这类读取,LSM 存储引擎通常会为每个段配备一个 布隆过滤器(Bloom filter)13,用来快速、近似地判断某个键是否出现在某个 SSTable 中。
图 4-4 展示了一个包含两个键、长度为 16 位的布隆过滤器(实际的键和位都会多得多)。对 SSTable 中的每个键计算哈希函数,会得到一组数字,再将这些数字解释为位数组中的下标 14。把这些位置上的位设为 1,其余位保持为 0。例如,键 handbag 的哈希结果是 (2, 9, 4),于是将第 2、9、4 位设为 1。得到的位图会与稀疏键索引一起存入 SSTable。它会占用一点额外空间,不过布隆过滤器通常远小于 SSTable 的其余部分。

要判断某个键是否出现在 SSTable 中,只需对它计算同样的哈希,再检查对应下标处的位。例如,图 4-4 查询的是键 handheld,其哈希结果为 (6, 11, 2)。其中第 2 位为 1,另外两位为 0。所有 CPU 都支持的位运算可以极快地完成这些检查。
只要其中至少一位为 0,就能确定 SSTable 中绝对没有这个键。如果查询对应的位全为 1,这个键很可能在 SSTable 中,但也可能只是其他键碰巧把这些位全都设成了 1。这种看似存在、实际却不存在的情况称为 假阳性(false positive)。
假阳性的概率取决于键的数量、每个键设置多少位,以及布隆过滤器的总位数。可以借助在线计算器为应用选择合适的参数 15。粗略地说,SSTable 中每个键分配 10 位布隆过滤器空间,假阳性概率约为 1%;此后每个键再多分配 5 位,概率就会降低一个数量级。
对 LSM 存储引擎来说,假阳性不会造成正确性问题:
- 如果布隆过滤器判断键 不存在,就可以放心跳过这个 SSTable,因为其中一定没有该键。
- 如果布隆过滤器判断键 存在,还要查询稀疏索引、解码键值对块,确认键是否真的在其中。如果遇到假阳性,不过是多做了一点无用功,并无其他危害;继续搜索下一个更旧的段即可。
压实策略
LSM 存储的一项重要设计细节,是何时执行压实,以及每次压实应包含哪些 SSTable。许多基于 LSM 的存储系统都允许配置压实策略,常见选择包括 16 17:
- 按大小分层压实(size-tiered compaction)
- 将较新、较小的 SSTable 逐步合并到较旧、较大的 SSTable 中。保存旧数据的 SSTable 可能变得非常大,合并时需要大量临时磁盘空间。这种策略的优点是能应对很高的写入吞吐量。
- 分级压实(leveled compaction)
- 将键范围拆分到较小的 SSTable 中,并把较旧的数据移入不同的“层级”。这样可以更增量地进行压实,所需磁盘空间也少于按大小分层策略。分级压实的读取效率更高,因为存储引擎只需检查较少的 SSTable,就能判断其中是否含有所需的键。
根据经验,如果工作负载以写入为主、读取很少,按大小分层压实通常表现更好;如果读取占主导,分级压实通常更好。若少量键经常写入,而大量键很少写入,分级压实也可能更有优势 18。
尽管其中有许多微妙之处,LSM 树的基本思想——保存一系列在后台合并的 SSTable——简单而有效。我们将在 “比较 B 树与 LSM 树” 中更详细地讨论其性能特征。
许多数据库以服务形式运行,通过网络接收查询;但也有一些 嵌入式(embedded)数据库并不提供网络 API。它们是与应用代码运行在同一进程中的库,通常读写本地磁盘上的文件,应用则通过普通函数调用与之交互。RocksDB、SQLite、LMDB、DuckDB 和 KùzuDB 都是嵌入式存储引擎 19。
嵌入式数据库在移动应用中十分常见,可用于保存本地用户的数据。在后端,如果数据小到单机足以容纳,并发事务又不多,嵌入式数据库也可能是合适的选择。例如在多租户系统中,如果每个租户的数据量都很小,且彼此完全隔离(即不需要查询多个租户的合并数据),就可以考虑为每个租户分别运行一个嵌入式数据库实例 20。
本章讨论的存储与检索方法,既适用于嵌入式数据库,也适用于客户端—服务器数据库。在 第 6 章 和 第 7 章 中,我们将讨论如何把数据库扩展到多台机器。
B 树
日志结构方法很流行,但它不是键值存储的唯一形式。按键读写数据库记录时,使用最广泛的结构是 B 树。
B 树自 1970 年问世 21,不到 10 年就被称为“无处不在”22,很好地经受住了时间的考验。时至今日,它仍然是几乎所有关系数据库中的标准索引实现,许多非关系数据库也使用 B 树。
与 SSTable 一样,B 树按键保存有序的键值对,因而能够高效地查找键值和执行范围查询。但相似之处也到此为止:B 树有着截然不同的设计理念。
前面看到的日志结构索引把数据库分成大小可变的 段(segment),通常每段为几兆字节或更大;段只写入一次,此后便不可变。相比之下,B 树把数据库分成大小固定的 块 或 页,并允许就地覆盖页。传统的页大小是 4 KiB,不过 PostgreSQL 目前默认使用 8 KiB,MySQL 默认使用 16 KiB。
每一页都有页号作为标识,因此一页可以引用另一页——类似于指针,只不过位于磁盘而非内存。如果所有页都保存在同一个文件中,页号乘以页大小,就是该页在文件中的字节偏移量。利用这些页引用可以构造一棵页组成的树,如 图 4-5 所示。

其中一页被指定为 B 树的 根(root);在索引中查找键时,总是从这里开始。根页包含若干个键和对子页的引用。每个子页负责一段连续的键范围,引用之间的键标示出相邻范围的边界。(这种结构有时称为 B+ 树,不过这里不必把它与其他 B 树变体区分开来。)
在 图 4-5 的例子中,我们要寻找键 251,因此沿着边界 200 与 300 之间的页引用向下走。接下来的一页结构相似,只是把 200–300 进一步划分成更小的子范围。最终会到达包含各个键的 叶页(leaf page);叶页或者直接保存每个键的值,或者保存指向值所在页的引用。
B 树一页中对子页的引用数称为 分支因子(branching factor)。例如,图 4-5 中的分支因子为 6。实践中的分支因子取决于页引用和范围边界所需的空间,不过通常可达几百。
如果要更新 B 树中已有键的值,就先找到包含该键的叶页,再用含有新值的版本覆盖磁盘上的这一页。如果要添加新键,则找到范围涵盖该键的页,并把键加入其中。如果页内没有足够的空闲空间容纳新键,就把它拆成两个半满的页,并更新父页,以反映键范围的新划分。

在 图 4-6 中,我们想插入键 334,但负责 333–345 范围的页已经装满。于是把它拆成两页:一页负责 333–337(并包含新键),另一页负责 337–344。父页也必须更新,增加对两个子页的引用,并以 337 作为二者的边界。如果父页容不下新的引用,它也要拆分;这种拆分可能一路向上传播到树根。根页拆分时,则在其上方创建一个新根。删除键还可能需要合并节点,处理起来更加复杂 5。
这个算法可以确保树始终 平衡(balanced):包含 n 个键的 B 树深度总是 O(log n)。大多数数据库只需要三四层深的 B 树,因此不必沿着很多页引用就能找到目标页。(一棵四层深、页大小为 4 KiB、分支因子为 500 的树,最多可以存储 250 TB 数据。)
使 B 树可靠
B 树最基本的底层写操作,是用新数据覆写磁盘上的页,并假定覆写不会改变页的位置:也就是说,页被覆写后,所有指向它的引用仍然有效。这与 LSM 树一类日志结构索引形成鲜明对比;后者只向文件追加写入(并最终删除过时文件),从不就地修改文件。
一次覆写多个页——例如拆分页时——是很危险的操作。如果数据库只写完其中一部分就崩溃,最终会留下损坏的树(例如出现不属于任何父页的 孤儿页,orphan page)。如果硬件不能原子地写入整页,还可能留下只写了一部分的页,这称为 页撕裂(torn page)23。
为了让数据库能够从崩溃中恢复,B 树实现通常会在磁盘上维护一个额外的数据结构:预写日志(write-ahead log,WAL)。这是一个仅追加文件;对 B 树的每项修改,都必须先写入 WAL,才能应用到树本身的页上。数据库在崩溃后重新启动时,会用这个日志把 B 树恢复到一致状态 2 24。文件系统中的对应机制称为 日志机制(journaling)。
为了提高性能,B 树实现通常不会立刻把每个修改过的页写入磁盘,而是先把 B 树页在内存中缓冲一段时间。此时,预写日志还负责确保崩溃时不丢数据:只要数据已写入 WAL,并通过 fsync() 系统调用刷到磁盘,它就是持久的,因为数据库能够在崩溃后将它恢复出来 25。
B 树变体
由于 B 树已经存在很久,多年来发展出了许多变体。这里只举几例:
- 一些数据库(如 LMDB)不覆写页,也不靠 WAL 进行崩溃恢复,而是采用写时复制方案 26。修改过的页写入新的位置,并为树中的父页创建新版本,使其指向新位置。这种方法对并发控制也很有用,我们将在 “快照隔离与可重复读” 中看到。
- 可以不存储完整的键,而只存储其缩写,以节省页内空间。尤其在树的内部页中,键只需包含足够的信息,能够充当键范围之间的边界即可。一页容纳的键越多,树的分支因子就越大,层数也越少。
- 为了加快按排序顺序扫描键范围,有些 B 树实现会尽量安排树的布局,使叶页在磁盘上也按顺序出现,从而减少磁盘寻道。不过随着树不断增长,这种顺序很难维持。
- 还可以向树中加入额外的指针。例如,让每个叶页引用左右相邻的兄弟页,便能按顺序扫描键,而不必反复跳回父页。
比较 B 树与 LSM 树
根据经验,LSM 树更适合写入密集型应用,而 B 树的读取通常更快 27 28。不过,基准测试结果往往对工作负载的细节非常敏感。只有使用自己的实际工作负载测试系统,比较才有意义。此外,LSM 树与 B 树并非严格的二选一:存储引擎有时会融合两种方法的特点,例如维护多棵 B 树,再用 LSM 风格将它们合并。本节将简要讨论衡量存储引擎性能时值得考虑的几个方面。
读取性能
在 B 树中查找键,需要在树的每一层读取一页。由于层数通常很少,B 树读取一般很快,性能也比较容易预测。LSM 存储引擎往往需要检查处于不同压实阶段的多个 SSTable,不过布隆过滤器能减少实际需要执行的磁盘 I/O 次数。两种方法都可能有良好表现;究竟哪种更快,取决于存储引擎的具体实现和工作负载。
B 树本身有序,因此范围查询简单而快速。LSM 存储也能利用 SSTable 的排序,但必须并行扫描所有段,再把结果合并起来。布隆过滤器对范围查询无能为力,因为不可能计算范围内每个潜在键的哈希;所以在 LSM 存储中,范围查询的成本高于点查询 29。
在日志结构存储引擎中,高写入吞吐量可能在内存表填满时引发延迟尖峰。如果数据来不及写入磁盘——或许因为压实速度赶不上新增写入——就会出现这种情况。包括 RocksDB 在内的许多存储引擎会在此时施加 背压(backpressure):暂停所有读写,直到内存表写入磁盘 30 31。
至于读取吞吐量,现代 SSD(尤其是 NVMe)可以并行处理许多相互独立的读取请求。LSM 树和 B 树都能提供很高的读取吞吐量,但存储引擎必须经过精心设计,才能利用这种并行能力 32。
顺序与随机写入
使用 B 树时,如果应用写入的键散布在整个键空间,产生的磁盘操作也会四处分散,因为存储引擎要覆写的页可能位于磁盘任何位置。日志结构存储引擎则一次写出整个段文件——无论是把内存表写出,还是压实现有段——其大小远远超过 B 树中的一页。
这种数量多、规模小而位置分散的写入模式(如 B 树)称为 随机写入(random write);数量少、规模较大的写入模式(如 LSM 树)则称为 顺序写入(sequential write)。磁盘的顺序写入吞吐量通常高于随机写入,因此在相同硬件上,日志结构存储引擎一般能承受比 B 树更高的写入吞吐量。这种差异在机械硬盘(HDD)上尤其显著;如今多数数据库使用固态硬盘(SSD),差距有所缩小,但依然不可忽略(参见 “SSD 上的顺序与随机写入”)。
在机械硬盘(HDD)上,顺序写入远快于随机写入:随机写入必须把磁头机械地移到新位置,还要等待盘片上的目标区域转到磁头下方,耗时可达数毫秒——以计算机的时间尺度看,简直是一生。如今,SSD(固态硬盘)已经在许多场景中取代 HDD,其中也包括 NVMe(Non-Volatile Memory Express,即通过 PCI Express 总线连接的闪存);它们没有这种机械限制。
尽管如此,SSD 的顺序写入吞吐量仍然高于随机写入。闪存每次可以读写一页(通常为 4 KiB),却只能按块擦除(通常为 512 KiB)。同一个块中,有些页可能仍保存有效数据,另一些页中的数据则已经无用。擦除整个块之前,控制器必须先把含有有效数据的页搬到其他块;这个过程称为 垃圾回收(GC)33。
顺序写入每次写入更大块的数据,所以一个完整的 512 KiB 块很可能都属于同一个文件;日后删除这个文件时,可以直接擦除整个块,不必执行 GC。随机写入则更容易让一个块混杂有效页和无效页,因此在擦除块之前,GC 必须完成更多搬运工作 34 35 36。
GC 占用的写入带宽无法再供应用使用;而且 GC 带来的额外写入会加剧闪存磨损。因此,随机写入比顺序写入更快地损耗 SSD。
写放大
无论采用哪种存储引擎,应用发出的一次写请求都会转化为底层磁盘上的多次 I/O。对 LSM 树而言,一个值首先写入日志以确保持久性;内存表写入磁盘时又写一次;此后每次所在的键值对参与压实,还要再次写入。(如果值远大于键,可以把键和值分开存放,只压实包含键和值引用的 SSTable,以降低这项开销 37。)
B 树索引也必须把每份数据至少写两次:一次写入预写日志,一次写入树页本身。为了确保 B 树能在崩溃或断电后正确恢复,有时即使页内只有几个字节发生变化,也必须写出整页 38 39。
把某个工作负载实际写入磁盘的总字节数,除以不带索引、只写仅追加日志时所需的字节数,得到的比值就是 写放大(write amplification)。(写放大有时也按 I/O 操作次数而非字节数定义。)在写入密集型应用中,瓶颈可能是数据库向磁盘写入的速度。此时写放大越高,在有限磁盘带宽内每秒能处理的写入就越少。
LSM 树和 B 树都有写放大问题。孰优孰劣取决于许多因素,例如键和值的长度,以及覆盖现有键与插入新键各有多频繁。对典型工作负载而言,LSM 树往往具有更低的写放大,因为它不必写出整页,还可以压缩 SSTable 中的数据块 40。这也是 LSM 存储引擎适合写入密集型工作负载的原因之一。
写放大除了影响吞吐量,也关系到 SSD 的磨损:存储引擎的写放大越低,SSD 损耗得就越慢。
测量存储引擎的写入吞吐量时,实验必须运行足够长的时间,才能显现写放大的影响。刚开始向空 LSM 树写入时,压实尚未发生,全部磁盘带宽都可供新写入使用。随着数据库增长,新写入便不得不与压实共享磁盘带宽。
磁盘空间使用
B 树可能随着时间推移逐渐 碎片化。例如,删除大量键之后,数据库文件里可能留下许多 B 树不再使用的页。以后向 B 树添加数据时可以复用这些空闲页,但它们位于文件中间,很难归还给操作系统,所以仍会占用文件系统空间。因此,数据库需要后台进程搬移并重新整理这些页,例如 PostgreSQL 的清理(vacuum)进程 25。
碎片化对 LSM 树来说问题较小,因为压实过程本来就会定期重写数据文件,而且 SSTable 中不存在留有空闲空间的页。此外,SSTable 中的键值对块更便于压缩,所以生成的磁盘文件通常小于 B 树。已经覆盖的键和值会继续占用空间,直到在压实中移除;不过采用分级压实时,这项开销相当低 40 41。按大小分层压实(参见 “压实策略”)会占用更多磁盘空间,尤其是在压实过程中临时占用的空间。
如果需要删除某些数据并确信它们确实已经消失——例如为了遵守数据保护法规——磁盘上并存的多份副本也会带来麻烦。在大多数 LSM 存储引擎中,已删除的记录仍可能留在较高层级,直到代表删除操作的墓碑传遍所有压实层级;这一过程可能持续很久。有些专门的存储引擎设计可以更快地传播删除操作 42。
另一方面,SSTable 段文件的不可变性很适合为数据库创建时间点快照(例如用于备份,或复制一份数据库进行测试):只需写出内存表,再记下当时存在哪些段文件。只要不删除属于快照的文件,就完全不必实际复制它们。B 树会覆写页,因此很难如此高效地创建快照。
多列索引与二级索引
到目前为止,我们只讨论了键值索引,它们类似于关系模型中的 主键 索引。主键唯一标识关系表中的一行、文档数据库中的一个文档,或图数据库中的一个顶点。数据库里的其他记录可以通过主键(或 ID)引用这一行、文档或顶点,而索引负责解析这种引用。
二级索引 也很常见。在关系数据库中,可以用 CREATE INDEX 命令在同一张表上创建多个二级索引,从而按主键以外的列进行搜索。例如,图 3-1(见 第 3 章)中的各张表很可能都要在 user_id 列上建立二级索引,以便找出属于同一用户的所有行。
二级索引很容易用键值索引构建。主要区别在于,二级索引中的被索引值不一定唯一,也就是说,同一个索引条目下可能对应许多行(或文档、顶点)。有两种解决办法:把索引中的值做成匹配行标识符的列表(类似全文索引的倒排列表);或者在每个索引项后附加行标识符,使它成为唯一项。B 树一类就地更新的存储引擎和日志结构存储都可以实现二级索引。
在索引中存储值
索引中的键是查询要搜索的内容,而值可以采用以下几种形式:
- 如果实际数据(行、文档或顶点)直接存储在索引结构中,这就是 聚簇索引。例如,MySQL 的 InnoDB 存储引擎总是把表的主键作为聚簇索引;SQL Server 则允许每张表指定一个聚簇索引 43。
- 另一种选择是让值引用实际数据:它可以是相应行的主键(InnoDB 的二级索引便是如此),也可以直接引用磁盘上的位置。后一种情况下,存放行的地方称为 堆文件(heap file);堆文件中的数据没有特定顺序,可以是仅追加的,也可以记录已删除的行,以便日后用新数据覆写。例如,Postgres 就使用堆文件 44。
- 两者之间的折中称为 覆盖索引(covering index)或 包含列的索引(index with included columns):完整的行仍保存在堆文件或主键聚簇索引中,但索引也会保存表的 部分 列 45。这样,一些查询只用索引就能得到答案,不必再解析主键或访问堆文件;此时称该索引 覆盖 了查询。覆盖索引可以加快某些查询,但重复数据会占用更多磁盘空间,也会拖慢写入。
到目前为止讨论的索引,都只是把单个键映射到值。如果需要同时查询表中的多个列(或文档中的多个字段),请参见 “多维索引与全文索引”。
更新值但不改变键时,只要新值不大于旧值,堆文件就能就地覆写记录。如果新值更大,情况会复杂一些:记录可能必须移到堆内空间足够的新位置。此时,要么更新所有索引,使其指向记录在堆中的新位置;要么在旧位置留下一个转发指针 2。
全内存存储
本章到目前为止讨论的数据结构,都是对磁盘局限的应对。与主内存相比,磁盘处理起来很麻烦。无论是磁性硬盘还是 SSD,要想获得良好的读写性能,都必须仔细安排数据在磁盘上的布局。不过我们能容忍这种麻烦,是因为磁盘有两项显著优势:它是持久的(断电后内容不会丢失),而且每 GB 的成本低于 RAM。
随着 RAM 越来越便宜,磁盘的每 GB 成本优势正在减弱。许多数据集本来就没有那么大,因此完全可以把它们全部放进内存,必要时还可以分布到多台机器上。于是,内存数据库 发展了起来。
有些内存键值存储(如 Memcached)仅用于缓存,机器重启时丢失数据也无妨。但另一些内存数据库以持久性为目标,可以借助特殊硬件(如电池供电的 RAM)、把变更日志写入磁盘、定期把快照写入磁盘,或把内存状态复制到其他机器来实现。
内存数据库重启时,需要从磁盘或通过网络从副本重新加载状态(使用特殊硬件时除外)。它虽然写磁盘,却仍然属于内存数据库,因为磁盘只是用作确保持久性的仅追加日志,所有读取都由内存处理。写入磁盘还有运维上的好处:外部工具可以轻松备份、检查和分析磁盘上的文件。
VoltDB、SingleStore 和 Oracle TimesTen 等产品是采用关系模型的内存数据库。供应商宣称,省去管理磁盘数据结构的全部开销后,它们可以大幅提高性能 46 47。RAMCloud 则是一个具备持久性的开源内存键值存储,对内存和磁盘中的数据都采用日志结构方法 48。
Redis 和 Couchbase 通过异步写入磁盘提供弱持久性。
反直觉的是,内存数据库的性能优势并不来自省去了磁盘读取。如果内存足够,即便基于磁盘的存储引擎也可能从不真正读取磁盘,因为操作系统本来就会把最近使用的磁盘块缓存在内存中。内存数据库之所以更快,是因为它省去了把内存数据结构编码成可写入磁盘的形式这一开销 49。
除了性能之外,内存数据库还有一个有趣之处:它可以提供很难用磁盘索引实现的数据模型。例如,Redis 为优先队列、集合等各种数据结构提供了类似数据库的接口。由于所有数据都放在内存中,实现起来相对简单。
分析型数据存储
数据仓库最常采用关系数据模型,因为 SQL 通常很适合分析查询。许多图形化数据分析工具可以生成 SQL 查询、可视化查询结果,并让分析师通过 下钻、切片与切块 等操作探索数据。
表面上,数据仓库与关系型 OLTP 数据库十分相似,因为二者都有 SQL 查询接口。然而,它们的内部实现可能大相径庭,因为两者针对的查询模式完全不同。如今,许多数据库供应商只专注于事务处理或分析工作负载中的一种,而非两者兼顾。
Microsoft SQL Server、SAP HANA 和 SingleStore 等数据库在同一产品中同时支持事务处理和数据仓库。不过,这些混合事务/分析处理(HTAP)数据库(已在 “数据仓库” 中介绍)正日益演变成两套彼此独立的存储与查询引擎,只是恰好通过同一个 SQL 接口访问 50 51 52 53。
云数据仓库
Teradata、Vertica 和 SAP HANA 等数据仓库供应商,既以商业许可证销售本地部署的数据仓库,也提供云端解决方案。随着越来越多的客户迁往云端,Google Cloud BigQuery、Amazon Redshift 和 Snowflake 等新一代云数据仓库也得到广泛采用。与传统数据仓库不同,云数据仓库会利用对象存储、无服务器计算平台等可伸缩的云基础设施。
云数据仓库通常能更好地集成其他云服务,也更具弹性。例如,许多云数据仓库支持自动摄取日志,并且可以轻松接入 Google Cloud Dataflow、Amazon Web Services Kinesis 等数据处理框架。它们把查询计算与存储层解耦,因此也更具弹性 54。数据持久保存在对象存储而非本地磁盘上,于是存储容量和查询计算资源可以分别调整,正如 “云原生系统架构” 所介绍的那样。
Apache Hive、Trino 和 Apache Spark 等开源数据仓库也随着云计算共同演进。分析数据存储迁入对象存储上的数据湖之后,开源数据仓库开始拆分、解耦 55。过去集成在 Apache Hive 这类单一系统中的功能,如今往往由以下独立组件实现:
- 查询引擎
- Trino、Apache DataFusion 和 Presto 等查询引擎负责解析 SQL 查询,将其优化成执行计划,再针对数据执行。查询通常需要由分布式任务并行处理。有些查询引擎内置了任务执行能力,另一些则借助 Apache Spark 或 Apache Flink 等第三方执行框架。
- 存储格式
- 存储格式规定如何把表中的行编码成文件里的字节;文件通常保存在对象存储或分布式文件系统中 12。查询引擎可以访问这些数据,使用同一数据湖的其他应用也可以。Parquet、ORC、Lance 和 Nimble 都属于这类格式,下一节还会进一步介绍。
- 表格式
- 以 Apache Parquet 等存储格式写出的文件通常不可变。为了支持插入和删除行,还要使用 Apache Iceberg 或 Databricks Delta 等表格式。表格式用一种文件格式来定义哪些文件构成一张表,以及这张表采用什么模式。它还可以提供时间旅行(查询表在过去某个时刻的状态)、垃圾回收乃至事务等高级功能。
- 数据目录
- 正如表格式定义哪些文件组成一张表,数据目录定义哪些表组成一个数据库。目录用于创建、重命名和删除表。与存储格式和表格式不同,Snowflake Polaris、Databricks Unity Catalog 等数据目录通常作为独立服务运行,并通过 REST 接口接受查询。Apache Iceberg 也提供目录,既可以嵌入客户端运行,也可以作为独立进程运行。查询引擎读写表时会使用目录信息。传统上,目录与查询引擎集成在一起;将二者解耦之后,数据发现和数据治理系统(见 “数据系统、法律与社会”)也可以访问目录中的元数据。
列式存储
正如 “星型与雪花型:分析模式” 所述,数据仓库通常采用关系模式:一张巨大的事实表通过外键引用各张维度表。如果事实表有数万亿行、数 PB 数据,如何高效存储和查询就成了严峻挑战。维度表通常小得多(只有数百万行),所以本节将重点讨论事实表的存储。
尽管事实表通常有 100 多列,但典型的数据仓库查询一次只访问其中 4、5 列(分析查询很少需要 "SELECT *")52。以 示例 4-1 为例:它会访问大量行(2024 年中每一笔水果或糖果销售记录),却只需要 fact_sales 表中的三列:date_key、product_sk 和 quantity。其他所有列都被查询忽略了。
怎样才能高效执行这个查询?
大多数 OLTP 数据库都以 面向行(row-oriented)的方式布置存储:表中同一行的所有值相邻存放。文档数据库也很相似,通常把整个文档存成一段连续的字节序列。图 4-1 的 CSV 示例就是如此。
为了处理 示例 4-1 这样的查询,可以在 fact_sales.date_key 和(或)fact_sales.product_sk 上建立索引,告诉存储引擎去哪里寻找某一天或某种产品的所有销售记录。但面向行的存储引擎仍要把这些完整的行(每行有 100 多个属性)从磁盘载入内存,逐一解析,再过滤掉不满足条件的行。这个过程可能十分耗时。
面向列(column-oriented,或 列式,columnar)存储背后的想法很简单:不要把同一行中的所有值放在一起,而要把同一 列 中的所有值放在一起 56。每列分别存储后,查询只需读取和解析自己用到的列,能省下大量工作。图 4-7 用 图 3-5 中事实表的扩展版本展示了这一原理。

面向列的存储布局要求每一列都按相同的行顺序保存数据。因此,要重新拼出完整的一行,可以分别取出每列中的第 23 项,把它们组合成表的第 23 行。
实际上,列式存储引擎并不会把完整的一列(可能有数万亿行)一次存放在一起。它会把表切成若干个包含数千乃至数百万行的数据块,再在每个块内分别保存各列的值 60。许多查询只关注特定日期范围,因此常让每个块包含某个时间戳范围内的行。查询只需在与目标日期范围重叠的块中,加载自己需要的列。
如今,几乎所有分析数据库都采用列式存储 60:从 Snowflake 61 这样的大型云数据仓库,到 DuckDB 62 这样的单节点嵌入式数据库,再到 Pinot 63、Druid 64 等产品分析系统。Parquet、ORC 65 66、Lance 67 和 Nimble 68 等存储格式,以及 Apache Arrow 65 69、pandas/NumPy 70 等内存分析格式,也都采用列式布局。InfluxDB IOx 71、TimescaleDB 72 等时间序列数据库同样以列式存储为基础。
列压缩
除了只从磁盘加载查询需要的列,还可以压缩数据,进一步降低对磁盘吞吐量和网络带宽的需求。幸运的是,列式存储通常很适合压缩。
看看 图 4-7 中各列的值序列:它们往往相当重复,这是很适合压缩的信号。根据列中数据的不同,可以选用不同的压缩技术。其中对数据仓库特别有效的一种是 位图编码,如 图 4-8 所示。

通常,一列中不同值的数量远小于总行数(例如,零售商可能有数十亿笔销售交易,却只有 100,000 种产品)。可以把一个具有 n 个不同值的列转换成 n 张独立位图:每个不同值对应一张位图,每一行对应其中一位。如果该行取这个值,对应位就是 1,否则为 0。
一种选择是按每行一位直接存储这些位图。不过,位图中通常有大量的 0,也就是十分 稀疏。这时还可以使用游程编码:统计连续出现的 0 或 1 的数量,并存下这个数字,如 图 4-8 底部所示。Roaring 位图会在两种位图表示之间切换,总是选用更紧凑的一种 73。这样可以极其高效地编码一整列。
像这样的位图索引非常适合数据仓库中常见的查询类型。例如:
WHERE product_sk IN (31, 68, 69):- 加载
product_sk = 31、product_sk = 68和product_sk = 69对应的三张位图,再计算三者的按位 或,这个操作可以非常高效地完成。 WHERE product_sk = 30 AND store_sk = 3:- 加载
product_sk = 30和store_sk = 3对应的位图,再计算按位 与。之所以可行,是因为各列中的行顺序相同:一列位图中的第 k 位,与另一列位图中的第 k 位对应同一行。
位图也可以回答图查询,例如找出社交网络中所有“被用户 X 关注、同时又关注用户 Y”的用户 74。列式数据库还有许多其他压缩方案,参见参考文献 75。
不要把列式数据库与 宽列(wide-column,又称 列族,column-family)数据模型混为一谈。宽列模型的一行可以有数千列,各行也不必拥有相同的列 9。尽管名字相似,宽列数据库其实是面向行的,因为它会把同一行的所有值存放在一起。Google Bigtable、Apache Accumulo 和 HBase 都属于宽列模型。
列存储中的排序顺序
在列式存储中,行的存储顺序并不一定重要。最简单的方式是按插入顺序存放,因为插入新行时只需向每一列追加数据。不过,也可以像此前处理 SSTable 那样,为数据指定某种顺序,并把这种顺序用作索引机制。
注意,分别对每一列独立排序毫无意义,因为那样就再也不知道不同列中的哪些项属于同一行。我们之所以能够重建一行,正是因为一列中的第 k 项与另一列中的第 k 项属于同一行。
因此,即使数据按列存储,排序也必须以整行为单位。数据库管理员可以根据自己对常见查询的了解,选择表按哪些列排序。例如,如果查询经常针对“上个月”这样的日期范围,就可以把 date_key 作为第一个排序键。这样查询只需扫描上个月的行,比扫描所有行快得多。
对于第一排序列中取值相同的行,可以用第二列进一步决定顺序。例如,如果 图 4-7 以 date_key 为第一排序键,那么把 product_sk 作为第二排序键或许很有用:同一天、同一种产品的所有销售记录就会在存储中相邻。这有利于在特定日期范围内按产品分组或筛选销售记录的查询。
排序的另一个好处是有助于列压缩。如果主排序列没有太多不同的值,排序后会形成很长的连续序列,同一个值反复出现。使用简单的游程编码——就像 图 4-8 中的位图一样——即可把这一列压缩到几千字节,即使表中有数十亿行也不例外。
这种压缩效果在第一排序键上最强。第二、第三排序键会更加杂乱,不会出现那么长的重复值序列。排序优先级更低的列基本呈随机顺序,压缩效果可能不佳。不过,只要前几列经过排序,整体上依然受益。
写入列式存储
我们在 “事务处理与分析的特征” 中看到,数据仓库的读取通常要聚合大量行;列式存储、压缩和排序都能加快这类读查询。数据仓库的写入则往往是批量导入数据,通常通过 ETL 流程完成。
对列式存储而言,在有序表的中间插入单独一行非常低效,因为从插入位置开始,所有压缩列都必须重写。但一次批量写入很多行,可以分摊重写这些列的成本,因而效率很高。
批量写入通常采用日志结构方法。所有写入先进入一个面向行、有序的内存存储。积累足够多的写入后,再与磁盘上的列编码文件合并,并成批写入新文件。旧文件保持不可变,新文件一次写成,所以对象存储很适合保存这些文件。
查询必须同时检查磁盘上的列数据和内存中的近期写入,再把两部分结果合并起来。查询执行引擎会向用户隐藏这项区别。在分析师看来,插入、更新或删除的数据会立刻反映在后续查询中。Snowflake、Vertica、Apache Pinot、Apache Druid 等许多系统都是这样做的 61 63 64 76。
查询执行:编译与向量化
复杂的分析型 SQL 查询会被分解成一个 查询计划(query plan),其中包含多个称为 算子(operator)的执行阶段;这些算子可能分布到多台机器上并行执行。查询规划器可以决定选用哪些算子、以什么顺序执行,以及每个算子在哪里运行,从而完成大量优化。
在每个算子内部,查询引擎都要对列中的值执行各种操作,例如找出值属于某个集合的所有行(或许是连接的一部分),或者判断值是否大于 15。查询引擎还要同时查看同一行的多个列,例如找出产品是香蕉、门店又恰好是目标门店的所有销售记录。
数据仓库查询需要扫描数百万行,因此不仅要关注从磁盘读取的数据量,还要关注执行复杂算子所需的 CPU 时间。最简单的算子就像编程语言解释器:遍历每一行时,查看表示查询的数据结构,弄清要对哪些列做什么比较或计算。遗憾的是,这种方式对许多分析场景来说太慢。实践中出现了两种高效执行查询的方法 77:
- 查询编译(query compilation)
- 查询引擎根据 SQL 查询生成执行代码。代码逐行迭代,读取相关列中的值,完成所需的比较或计算;如果条件满足,就把必要的值复制到输出缓冲区。随后,查询引擎把生成的代码编译成机器码(往往借助 LLVM 等现有编译器),再对已经载入内存的列编码数据运行。这种代码生成方式类似 Java 虚拟机(JVM)等运行时采用的即时(JIT)编译。
- 向量化处理(vectorized processing)
- 查询仍然采用解释执行,而非编译执行;但它不再逐行迭代,而是成批处理一列中的许多值,从而提高速度。数据库内置一组固定的预定义算子,向算子传入参数,就会得到一批结果 50 75。
例如,把 product_sk 列和“香蕉”的 ID 传给相等比较算子,会得到一张位图:输入列的每个值对应一位,是香蕉则为 1。再把 store_sk 列和目标门店的 ID 传给同一个算子,得到另一张位图。最后把两张位图传给“按位与”算子,如 图 4-9 所示。结果位图中,特定门店售出的每一笔香蕉都对应一个 1。

这两种方法的实现大不相同,但都已投入实际使用 77。它们都能利用现代 CPU 的特点,获得优异性能:
- 优先顺序访问内存而非随机访问,减少缓存未命中 78;
- 把大部分工作放在紧凑的内层循环中(指令少且没有函数调用),使 CPU 指令流水线保持忙碌,并避免分支预测错误;
- 利用多线程和单指令多数据(SIMD)指令等并行机制 79 80;
- 直接处理压缩数据,不先解码成另一种内存表示,从而省去内存分配和复制的成本。
物化视图与多维数据集
我们曾在 “时间线的物化与更新” 中遇到 物化视图(materialized view)。在关系数据模型中,它是一种类似表的对象,内容是某个查询的结果。物化视图是实际写入磁盘的查询结果副本,而虚拟视图只是编写查询的快捷方式。从虚拟视图读取时,SQL 引擎会即时把它展开成底层查询,再处理展开后的查询。
底层数据变化时,物化视图也必须随之更新。有些数据库可以自动完成这项工作,Materialize 等系统则专门负责维护物化视图 81。更新视图会增加写入工作量,但如果工作负载反复执行相同查询,物化视图可以改善读取性能。
物化聚合(materialized aggregate)是一类对数据仓库很有用的物化视图。如前所述,数据仓库查询经常使用 SQL 中的 COUNT、SUM、AVG、MIN 或 MAX 等聚合函数。如果许多查询都使用相同的聚合,每次重新处理原始数据就太浪费了,何不把最常用的计数或总和缓存起来?多维数据集(data cube,或 OLAP 多维数据集,OLAP cube)会创建一个按不同维度分组的聚合网格,正是为了实现这种缓存 82。图 4-10 展示了一个例子。

暂且假设每条事实记录只外键引用两张维度表——图 4-10 中是 date_key 和 product_sk。这样可以画出一张二维表,一条轴表示日期,另一条轴表示产品。每个单元格保存具有相应“日期—产品”组合的所有事实记录中,某项属性(如 net_price)的聚合值(如 SUM)。再沿每一行或每一列应用同样的聚合,就能得到减少一个维度的汇总结果:不考虑日期的产品销售额,或者不考虑产品的逐日销售额。
一般而言,事实往往不止两个维度。图 3-5 中就有日期、产品、门店、促销和客户五个维度。五维超立方体很难想象,但原理仍然一样:每个单元格保存特定“日期—产品—门店—促销—客户”组合的销售额,随后可以沿每个维度反复汇总这些值。
物化多维数据集的优点,是某些查询会变得非常快,因为结果实际上已经预先计算好了。例如,要知道昨天每家门店的总销售额,只需查看相应维度上的汇总值,不必扫描数百万行。
缺点是多维数据集不如直接查询原始数据灵活。例如,价格不是其中一个维度,就无法计算有多大比例的销售额来自售价超过 100 美元的商品。因此,大多数数据仓库会尽可能保留原始数据,只把多维数据集等聚合用作某些查询的性能优化手段。
多维索引与全文索引
本章前半部分介绍的 B 树和 LSM 树,可以对单个属性执行范围查询。例如,如果键是用户名,就能用它们建立索引,高效找出所有以 L 开头的名字。但有时,只按一个属性搜索并不够用。
最常见的多列索引称为 联合索引(concatenated index)。它把一列接在另一列之后,将多个字段组合成一个键;字段的连接顺序由索引定义指定。这就像老式纸质电话簿提供的索引:从(姓、名)映射到电话号码。由于索引按这个顺序排列,可以找出某个姓氏对应的所有人,也可以找出特定 姓—名 组合对应的所有人。但如果只想查找某个名字对应的所有人,这个索引就毫无用处。
多维索引(multidimensional index)则允许同时查询多个列,这对地理空间数据尤其重要。例如,餐厅搜索网站的数据库可能保存了每家餐厅的经纬度。用户查看地图时,网站需要找出当前矩形地图区域内的所有餐厅。这就需要下面这样的二维范围查询:
在纬度和经度列上建立联合索引,无法高效回答这个查询:它只能返回某一纬度范围内的所有餐厅(经度任意),或者某一经度范围内的所有餐厅(纬度可以是南北两极之间的任意位置),却无法同时约束两者。
一种办法是使用空间填充曲线把二维位置转换成单个数字,再建立普通的 B 树索引 83。更常见的做法是使用 R 树、Bkd 树 84 等专门的空间索引;它们对空间进行划分,让邻近的数据点尽量落在同一棵子树中。例如,PostGIS 使用 PostgreSQL 的通用搜索树索引设施,以 R 树实现地理空间索引 85。另一种选择是使用规则排布的三角形、正方形或六边形网格 86。
多维索引并不只用于地理位置。例如,电子商务网站可以在(红、绿、蓝)三个维度上建立索引,以搜索特定颜色范围内的产品;天气观测数据库也可以在(日期、温度)上建立二维索引,高效找出 2013 年中温度介于 25~30℃ 的所有观测记录。使用一维索引,要么必须扫描 2013 年的所有记录(不考虑温度)再按温度筛选,要么反过来处理。二维索引则可以同时按时间戳和温度缩小结果范围 87。
全文检索
全文检索(full-text search)允许按关键词搜索一组文本文档(网页、产品描述等),关键词可以出现在文本中的任意位置 88。信息检索是一门庞大而专门的学科,往往还要针对具体语言进行处理。例如,一些亚洲语言书写时不会在词与词之间添加空格或标点,因此把文本切分成词需要借助模型,判断哪些字符序列构成一个词。全文检索还经常需要匹配相似但不完全相同的词(例如拼写错误或同一个词的不同语法形式),以及同义词。这些问题都超出了本书的范围。
不过从核心原理看,全文检索也可以视为一种多维查询:文本中可能出现的每个词(即一个 词项,term)都是一个维度。包含词项 x 的文档在维度 x 上取值为 1,不包含 x 则取值为 0。搜索提到“红苹果”的文档,就是同时寻找 红 维度和 苹果 维度都为 1 的文档。这样一来,维度数可能非常庞大。
许多搜索引擎使用 倒排索引(inverted index)回答这类查询。它是一种键值结构:键是词项,值是所有包含该词项的文档 ID 列表,即 倒排列表(postings list)。如果文档 ID 是连续数字,倒排列表也可以表示成 图 4-8 那样的稀疏位图:如果 ID 为 n 的文档包含词项 x,那么词项 x 的位图中第 n 位就是 1 89。
现在,查找同时包含词项 x 和 y 的所有文档,就类似于用向量化数据仓库查询寻找满足两个条件的行(图 4-9):载入 x 和 y 对应的两张位图,再计算按位与。即使位图经过游程编码,这个操作也可以高效完成。
Elasticsearch 和 Solr 使用的全文索引引擎 Lucene 就采用这种方法 90。它把从词项到倒排列表的映射保存在类似 SSTable 的有序文件中,再使用本章前面介绍的日志结构方法,在后台合并这些文件 91。PostgreSQL 的 GIN 索引也通过倒排列表支持全文检索,以及 JSON 文档内部的索引 92 93。
除了把文本切分成词,还可以找出所有长度为 n 的子串,称为 n-gram。例如,字符串 "hello" 的 3-gram(n = 3)是 "hel"、"ell" 和 "llo"。如果为所有 3-gram 建立倒排索引,就能搜索任意长度至少为三个字符的子串。这样的索引甚至支持在搜索查询中使用正则表达式,缺点是体积相当大 94。
为了应对文档或查询中的拼写错误,Lucene 可以搜索与目标词相差一定编辑距离的词(编辑距离为 1,表示增加、删除或替换了一个字母)95。它把词项集合存储成一个以键中字符为边的有限状态自动机,结构类似 字典树(trie)96;再将其转换成 莱文斯坦自动机(Levenshtein automaton),从而高效搜索给定编辑距离以内的词 97。
向量嵌入
语义搜索不只处理同义词和拼写错误,还试图理解文档表达的概念和用户的意图。例如,帮助中心有一页标题是“取消订阅”,那么用户搜索“如何关闭账户”或“终止合同”时也应当找到它:这些说法用词完全不同,意思却十分接近。
为了理解文档的语义,也就是它表达的含义,语义搜索索引会使用嵌入模型,把文档转换成由浮点数组成的向量,称为 向量嵌入(vector embedding)。这个向量表示多维空间中的一个点,每个浮点数表示文档在某一维坐标轴上的位置。如果输入文档的语义相似,嵌入模型就会生成在多维空间中彼此接近的向量。
我们在 “查询执行:编译与向量化” 中见过 向量化处理 一词。语义搜索中的“向量”含义不同:向量化处理所说的向量,是一批可以用专门优化的代码处理的比特;嵌入模型所说的向量,则是一列浮点数,用来表示多维空间中的位置。
例如,一篇介绍农业的维基百科页面,其三维向量嵌入可能是 [0.1, 0.22, 0.11]。介绍蔬菜的页面应该离它很近,向量或许是 [0.13, 0.19, 0.24]。介绍星型模式的页面则可能得到 [0.82, 0.39, -0.74],距离相对很远。只看数字也能发现,前两个向量比第三个更接近。
实际的嵌入模型使用大得多的向量,往往包含 1,000 多个数字,但原理相同。我们不会试图理解每个数字各自代表什么;它们只是嵌入模型用来指向抽象多维空间中某个位置的方式。搜索引擎通过余弦相似度、欧几里得距离等距离函数衡量向量间的距离。余弦相似度计算两个向量夹角的余弦,判断它们有多接近;欧几里得距离则计算空间中两点间的直线距离。
Word2Vec 98、BERT 99 和 GPT 100 等许多早期嵌入模型都处理文本数据,通常以神经网络实现。后来,研究者又为视频、音频和图像创建了嵌入模型。近来,模型架构进一步走向 多模态(multimodal):同一个模型可以为文本、图像等多种模态生成向量嵌入。
用户输入查询时,语义搜索引擎会把查询及其相关上下文(例如用户位置)交给嵌入模型,生成查询的向量嵌入。随后,搜索引擎还必须通过向量索引,找出向量嵌入与查询相似的文档。
向量索引保存一组文档的向量嵌入。查询时传入查询本身的向量嵌入,索引会返回向量最接近查询向量的文档。前面介绍的 R 树不适合维度很高的向量,因此需要专门的向量索引,例如:
- 平面索引(Flat indexes)
- 向量原样保存在索引中。查询必须读取每个向量,并测量它与查询向量的距离。平面索引结果精确,但逐一计算查询与每个向量的距离很慢。
- 倒排文件(IVF)索引
- 把向量空间聚类成若干向量分区,以减少必须比较的向量数;这些分区称为 质心(centroid)。IVF 索引比平面索引更快,却只能给出近似结果:查询向量和某个文档向量可能十分接近,却恰好落入不同分区。查询 IVF 索引时,首先要指定 探测数(probes),也就是需要检查多少个分区。探测数越大,查询越准确,但也越慢,因为必须比较更多向量。
- 分层可导航小世界(HNSW)
- HNSW 索引维护向量空间的多个层级,如 图 4-11 所示。每层都表示成一张图:节点代表向量,边表示向量彼此接近。查询先在节点很少的最顶层找到最近向量,再进入下一层的同一节点;下一层连接更密集,查询沿边寻找更接近查询向量的向量。这个过程不断重复,直至最底层。与 IVF 一样,HNSW 也是近似索引。

许多流行的向量数据库都实现了 IVF 和 HNSW 索引。Facebook 的 Faiss 库为两者提供了许多变体 101,PostgreSQL 的 pgvector 也同时支持这两种索引 102。IVF 和 HNSW 算法的完整细节超出了本书范围,不过介绍它们的论文是很好的参考资料 103 104。
总结
在本章中,我们试图深入了解数据库是如何处理存储与检索的。把数据存入数据库时会发生什么?日后再次查询这些数据时,数据库又会做什么?
“分析型与事务型系统” 介绍了事务处理(OLTP)与分析(OLAP)的区别。本章进一步看到,针对 OLTP 优化的存储引擎,与针对分析优化的存储引擎大不相同:
- OLTP 系统针对大量请求优化;每个请求只读写少量记录,并且需要迅速响应。记录通常通过主键或二级索引访问,这些索引一般是从键到记录的有序映射,也支持范围查询。
- 数据仓库等分析型系统,针对需要扫描大量记录的复杂读查询优化。它们通常采用经过压缩的列式存储布局,尽可能减少查询要从磁盘读取的数据量;并通过查询的即时编译或向量化,尽可能减少处理数据所耗费的 CPU 时间。
在 OLTP 方面,我们看到了两个主要思想流派的存储引擎:
- 日志结构学派只允许向文件追加数据和删除过时文件,从不更新已经写出的文件。SSTable、LSM 树、RocksDB、Cassandra、HBase、ScyllaDB、Lucene 等都属于这一类。一般而言,日志结构存储引擎能提供很高的写入吞吐量。
- 就地更新学派把磁盘视为一组大小固定、可以覆写的页。B 树是这种理念最典型的代表,所有主流关系型 OLTP 数据库和许多非关系数据库都使用它。根据经验,B 树通常更适合读取,其读取吞吐量高于日志结构存储,响应时间也更短。
随后,我们考察了能够同时搜索多个条件的索引:R 树等多维索引可以同时按经度和纬度搜索地图上的点;全文检索索引则可以搜索同一段文本中出现的多个关键词。最后,向量数据库用于对文本文档及其他媒体进行语义搜索;它把数据表示成高维向量,再通过比较向量相似度找出相似文档。
作为应用开发者,如果掌握了这些有关存储引擎内部机制的知识,就能更好地判断哪种工具最适合自己的应用。需要调整数据库的调优参数时,这种理解也让你能够设想参数调高或调低会产生怎样的影响。
尽管本章无法让你成为某一种存储引擎的调优专家,但希望它已经提供了足够的概念和词汇,让你能够读懂自己所选数据库的文档。
参考文献
Nikolay Samokhvalov. How partial, covering, and multicolumn indexes may slow down UPDATEs in PostgreSQL. postgres.ai, October 2021. Archived at perma.cc/PBK3-F4G9 ↩︎
Goetz Graefe. Modern B-Tree Techniques. Foundations and Trends in Databases, volume 3, issue 4, pages 203–402, August 2011. doi:10.1561/1900000028 ↩︎ ↩︎ ↩︎
Evan Jones. Why databases use ordered indexes but programming uses hash tables. evanjones.ca, December 2019. Archived at perma.cc/NJX8-3ZZD ↩︎
Branimir Lambov. CEP-25: Trie-indexed SSTable format. cwiki.apache.org, November 2022. Archived at perma.cc/HD7W-PW8U. Linked Google Doc archived at perma.cc/UL6C-AAAE ↩︎
Thomas H. Cormen, Charles E. Leiserson, Ronald L. Rivest, and Clifford Stein: Introduction to Algorithms, 3rd edition. MIT Press, 2009. ISBN: 978-0-262-53305-8 ↩︎ ↩︎ ↩︎
Branimir Lambov. Trie Memtables in Cassandra. Proceedings of the VLDB Endowment, volume 15, issue 12, pages 3359–3371, August 2022. doi:10.14778/3554821.3554828 ↩︎
Dhruba Borthakur. The History of RocksDB. rocksdb.blogspot.com, November 2013. Archived at perma.cc/Z7C5-JPSP ↩︎
Matteo Bertozzi. Apache HBase I/O – HFile. blog.cloudera.com, June 2012. Archived at perma.cc/U9XH-L2KL ↩︎
Fay Chang, Jeffrey Dean, Sanjay Ghemawat, Wilson C. Hsieh, Deborah A. Wallach, Mike Burrows, Tushar Chandra, Andrew Fikes, and Robert E. Gruber. Bigtable: A Distributed Storage System for Structured Data. At 7th USENIX Symposium on Operating System Design and Implementation (OSDI), November 2006. ↩︎ ↩︎
Patrick O’Neil, Edward Cheng, Dieter Gawlick, and Elizabeth O’Neil. The Log-Structured Merge-Tree (LSM-Tree). Acta Informatica, volume 33, issue 4, pages 351–385, June 1996. doi:10.1007/s002360050048 ↩︎
Mendel Rosenblum and John K. Ousterhout. The Design and Implementation of a Log-Structured File System. ACM Transactions on Computer Systems, volume 10, issue 1, pages 26–52, February 1992. doi:10.1145/146941.146943 ↩︎
Michael Armbrust, Tathagata Das, Liwen Sun, Burak Yavuz, Shixiong Zhu, Mukul Murthy, Joseph Torres, Herman van Hovell, Adrian Ionescu, Alicja Łuszczak, Michał Świtakowski, Michał Szafrański, Xiao Li, Takuya Ueshin, Mostafa Mokhtar, Peter Boncz, Ali Ghodsi, Sameer Paranjpye, Pieter Senster, Reynold Xin, and Matei Zaharia. Delta Lake: High-Performance ACID Table Storage over Cloud Object Stores. Proceedings of the VLDB Endowment, volume 13, issue 12, pages 3411–3424, August 2020. doi:10.14778/3415478.3415560 ↩︎ ↩︎
Burton H. Bloom. Space/Time Trade-offs in Hash Coding with Allowable Errors. Communications of the ACM, volume 13, issue 7, pages 422–426, July 1970. doi:10.1145/362686.362692 ↩︎
Adam Kirsch and Michael Mitzenmacher. Less Hashing, Same Performance: Building a Better Bloom Filter. Random Structures & Algorithms, volume 33, issue 2, pages 187–218, September 2008. doi:10.1002/rsa.20208 ↩︎
Thomas Hurst. Bloom Filter Calculator. hur.st, September 2023. Archived at perma.cc/L3AV-6VC2 ↩︎
Chen Luo and Michael J. Carey. LSM-based storage techniques: a survey. The VLDB Journal, volume 29, pages 393–418, July 2019. doi:10.1007/s00778-019-00555-y ↩︎
Subhadeep Sarkar and Manos Athanassoulis. Dissecting, Designing, and Optimizing LSM-based Data Stores. Tutorial at ACM International Conference on Management of Data (SIGMOD), June 2022. Slides archived at perma.cc/93B3-E827 ↩︎
Mark Callaghan. Name that compaction algorithm. smalldatum.blogspot.com, August 2018. Archived at perma.cc/CN4M-82DY ↩︎
Prashanth Rao. Embedded databases (1): The harmony of DuckDB, KùzuDB and LanceDB. thedataquarry.com, August 2023. Archived at perma.cc/PA28-2R35 ↩︎
Hacker News discussion. Bluesky migrates to single-tenant SQLite. news.ycombinator.com, October 2023. Archived at perma.cc/69LM-5P6X ↩︎
Rudolf Bayer and Edward M. McCreight. Organization and Maintenance of Large Ordered Indices. Boeing Scientific Research Laboratories, Mathematical and Information Sciences Laboratory, report no. 20, July 1970. doi:10.1145/1734663.1734671 ↩︎
Douglas Comer. The Ubiquitous B-Tree. ACM Computing Surveys, volume 11, issue 2, pages 121–137, June 1979. doi:10.1145/356770.356776 ↩︎
Alex Miller. Torn Write Detection and Protection. transactional.blog, April 2025. Archived at perma.cc/G7EB-33EW ↩︎
C. Mohan and Frank Levine. ARIES/IM: An Efficient and High Concurrency Index Management Method Using Write-Ahead Logging. At ACM International Conference on Management of Data (SIGMOD), June 1992. doi:10.1145/130283.130338 ↩︎
Hironobu Suzuki. The Internals of PostgreSQL. interdb.jp, 2017. ↩︎ ↩︎
Howard Chu. LDAP at Lightning Speed. At Build Stuff ’14, November 2014. Archived at perma.cc/GB6Z-P8YH ↩︎
Manos Athanassoulis, Michael S. Kester, Lukas M. Maas, Radu Stoica, Stratos Idreos, Anastasia Ailamaki, and Mark Callaghan. Designing Access Methods: The RUM Conjecture. At 19th International Conference on Extending Database Technology (EDBT), March 2016. doi:10.5441/002/edbt.2016.42 ↩︎
Ben Stopford. Log Structured Merge Trees. benstopford.com, February 2015. Archived at perma.cc/E5BV-KUJ6 ↩︎
Mark Callaghan. The Advantages of an LSM vs a B-Tree. smalldatum.blogspot.co.uk, January 2016. Archived at perma.cc/3TYZ-EFUD ↩︎
Oana Balmau, Florin Dinu, Willy Zwaenepoel, Karan Gupta, Ravishankar Chandhiramoorthi, and Diego Didona. SILK: Preventing Latency Spikes in Log-Structured Merge Key-Value Stores. At USENIX Annual Technical Conference, July 2019. ↩︎
Igor Canadi, Siying Dong, Mark Callaghan, et al. RocksDB Tuning Guide. github.com, 2023. Archived at perma.cc/UNY4-MK6C ↩︎
Gabriel Haas and Viktor Leis. What Modern NVMe Storage Can Do, and How to Exploit it: High-Performance I/O for High-Performance Storage Engines. Proceedings of the VLDB Endowment, volume 16, issue 9, pages 2090-2102. doi:10.14778/3598581.3598584 ↩︎
Emmanuel Goossaert. Coding for SSDs. codecapsule.com, February 2014. ↩︎
Jack Vanlightly. Is sequential IO dead in the era of the NVMe drive? jack-vanlightly.com, May 2023. Archived at perma.cc/7TMZ-TAPU ↩︎
Alibaba Cloud Storage Team. Storage System Design Analysis: Factors Affecting NVMe SSD Performance (2). alibabacloud.com, January 2019. Archived at archive.org ↩︎
Xiao-Yu Hu and Robert Haas. The Fundamental Limit of Flash Random Write Performance: Understanding, Analysis and Performance Modelling. dominoweb.draco.res.ibm.com, March 2010. Archived at perma.cc/8JUL-4ZDS ↩︎
Lanyue Lu, Thanumalayan Sankaranarayana Pillai, Andrea C. Arpaci-Dusseau, and Remzi H. Arpaci-Dusseau. WiscKey: Separating Keys from Values in SSD-conscious Storage. At 4th USENIX Conference on File and Storage Technologies (FAST), February 2016. ↩︎
Peter Zaitsev. Innodb Double Write. percona.com, August 2006. Archived at perma.cc/NT4S-DK7T ↩︎
Tomas Vondra. On the Impact of Full-Page Writes. 2ndquadrant.com, November 2016. Archived at perma.cc/7N6B-CVL3 ↩︎
Mark Callaghan. Read, write & space amplification - B-Tree vs LSM. smalldatum.blogspot.com, November 2015. Archived at perma.cc/S487-WK5P ↩︎ ↩︎
Mark Callaghan. Choosing Between Efficiency and Performance with RocksDB. At Code Mesh, November 2016. Video at youtube.com/watch?v=tgzkgZVXKB4 ↩︎
Subhadeep Sarkar, Tarikul Islam Papon, Dimitris Staratzis, Zichen Zhu, and Manos Athanassoulis. Enabling Timely and Persistent Deletion in LSM-Engines. ACM Transactions on Database Systems, volume 48, issue 3, article no. 8, August 2023. doi:10.1145/3599724 ↩︎
Lukas Fittl. Postgres vs. SQL Server: B-Tree Index Differences & the Benefit of Deduplication. pganalyze.com, April 2025. Archived at perma.cc/XY6T-LTPX ↩︎
Drew Silcock. How Postgres stores data on disk – this one’s a page turner. drew.silcock.dev, August 2024. Archived at perma.cc/8K7K-7VJ2 ↩︎
Joe Webb. Using Covering Indexes to Improve Query Performance. simple-talk.com, September 2008. Archived at perma.cc/6MEZ-R5VR ↩︎
Michael Stonebraker, Samuel Madden, Daniel J. Abadi, Stavros Harizopoulos, Nabil Hachem, and Pat Helland. The End of an Architectural Era (It’s Time for a Complete Rewrite). At 33rd International Conference on Very Large Data Bases (VLDB), September 2007. ↩︎
VoltDB Technical Overview White Paper. VoltDB, 2017. Archived at perma.cc/B9SF-SK5G ↩︎
Stephen M. Rumble, Ankita Kejriwal, and John K. Ousterhout. Log-Structured Memory for DRAM-Based Storage. At 12th USENIX Conference on File and Storage Technologies (FAST), February 2014. ↩︎
Stavros Harizopoulos, Daniel J. Abadi, Samuel Madden, and Michael Stonebraker. OLTP Through the Looking Glass, and What We Found There. At ACM International Conference on Management of Data (SIGMOD), June 2008. doi:10.1145/1376616.1376713 ↩︎
Per-Åke Larson, Cipri Clinciu, Campbell Fraser, Eric N. Hanson, Mostafa Mokhtar, Michal Nowakiewicz, Vassilis Papadimos, Susan L. Price, Srikumar Rangarajan, Remus Rusanu, and Mayukh Saubhasik. Enhancements to SQL Server Column Stores. At ACM International Conference on Management of Data (SIGMOD), June 2013. doi:10.1145/2463676.2463708 ↩︎ ↩︎
Franz Färber, Norman May, Wolfgang Lehner, Philipp Große, Ingo Müller, Hannes Rauhe, and Jonathan Dees. The SAP HANA Database – An Architecture Overview. IEEE Data Engineering Bulletin, volume 35, issue 1, pages 28–33, March 2012. ↩︎
Michael Stonebraker. The Traditional RDBMS Wisdom Is (Almost Certainly) All Wrong. Presentation at EPFL, May 2013. ↩︎ ↩︎
Adam Prout, Szu-Po Wang, Joseph Victor, Zhou Sun, Yongzhu Li, Jack Chen, Evan Bergeron, Eric Hanson, Robert Walzer, Rodrigo Gomes, and Nikita Shamgunov. Cloud-Native Transactions and Analytics in SingleStore. At ACM International Conference on Management of Data (SIGMOD), June 2022. doi:10.1145/3514221.3526055 ↩︎
Tino Tereshko and Jordan Tigani. BigQuery under the hood. cloud.google.com, January 2016. Archived at perma.cc/WP2Y-FUCF ↩︎
Wes McKinney. The Road to Composable Data Systems: Thoughts on the Last 15 Years and the Future. wesmckinney.com, September 2023. Archived at perma.cc/6L2M-GTJX ↩︎
Michael Stonebraker, Daniel J. Abadi, Adam Batkin, Xuedong Chen, Mitch Cherniack, Miguel Ferreira, Edmond Lau, Amerson Lin, Sam Madden, Elizabeth O’Neil, Pat O’Neil, Alex Rasin, Nga Tran, and Stan Zdonik. C-Store: A Column-oriented DBMS. At 31st International Conference on Very Large Data Bases (VLDB), pages 553–564, September 2005. ↩︎
Julien Le Dem. Dremel Made Simple with Parquet. blog.twitter.com, September 2013. ↩︎
Sergey Melnik, Andrey Gubarev, Jing Jing Long, Geoffrey Romer, Shiva Shivakumar, Matt Tolton, and Theo Vassilakis. Dremel: Interactive Analysis of Web-Scale Datasets. At 36th International Conference on Very Large Data Bases (VLDB), pages 330–339, September 2010. doi:10.14778/1920841.1920886 ↩︎
Joe Kearney. Understanding Record Shredding: storing nested data in columns. joekearney.co.uk, December 2016. Archived at perma.cc/ZD5N-AX5D ↩︎
Jamie Brandon. A shallow survey of OLAP and HTAP query engines. scattered-thoughts.net, September 2023. Archived at perma.cc/L3KH-J4JF ↩︎ ↩︎
Benoit Dageville, Thierry Cruanes, Marcin Zukowski, Vadim Antonov, Artin Avanes, Jon Bock, Jonathan Claybaugh, Daniel Engovatov, Martin Hentschel, Jiansheng Huang, Allison W. Lee, Ashish Motivala, Abdul Q. Munir, Steven Pelley, Peter Povinec, Greg Rahn, Spyridon Triantafyllis, and Philipp Unterbrunner. The Snowflake Elastic Data Warehouse. At ACM International Conference on Management of Data (SIGMOD), pages 215–226, June 2016. doi:10.1145/2882903.2903741 ↩︎ ↩︎
Mark Raasveldt and Hannes Mühleisen. Data Management for Data Science Towards Embedded Analytics. At 10th Conference on Innovative Data Systems Research (CIDR), January 2020. ↩︎
Jean-François Im, Kishore Gopalakrishna, Subbu Subramaniam, Mayank Shrivastava, Adwait Tumbde, Xiaotian Jiang, Jennifer Dai, Seunghyun Lee, Neha Pawar, Jialiang Li, and Ravi Aringunram. Pinot: Realtime OLAP for 530 Million Users. At ACM International Conference on Management of Data (SIGMOD), pages 583–594, May 2018. doi:10.1145/3183713.3190661 ↩︎ ↩︎
Fangjin Yang, Eric Tschetter, Xavier Léauté, Nelson Ray, Gian Merlino, and Deep Ganguli. Druid: A Real-time Analytical Data Store. At ACM International Conference on Management of Data (SIGMOD), June 2014. doi:10.1145/2588555.2595631 ↩︎ ↩︎
Chunwei Liu, Anna Pavlenko, Matteo Interlandi, and Brandon Haynes. Deep Dive into Common Open Formats for Analytical DBMSs. Proceedings of the VLDB Endowment, volume 16, issue 11, pages 3044–3056, July 2023. doi:10.14778/3611479.3611507 ↩︎ ↩︎
Xinyu Zeng, Yulong Hui, Jiahong Shen, Andrew Pavlo, Wes McKinney, and Huanchen Zhang. An Empirical Evaluation of Columnar Storage Formats. Proceedings of the VLDB Endowment, volume 17, issue 2, pages 148–161. doi:10.14778/3626292.3626298 ↩︎
Weston Pace. Lance v2: A columnar container format for modern data. blog.lancedb.com, April 2024. Archived at perma.cc/ZK3Q-S9VJ ↩︎
Yoav Helfman. Nimble, A New Columnar File Format. At VeloxCon, April 2024. ↩︎
Wes McKinney. Apache Arrow: High-Performance Columnar Data Framework. At CMU Database Group – Vaccination Database Tech Talks, December 2021. ↩︎
Wes McKinney. Python for Data Analysis, 3rd Edition. O’Reilly Media, August 2022. ISBN: 9781098104023 ↩︎
Paul Dix. The Design of InfluxDB IOx: An In-Memory Columnar Database Written in Rust with Apache Arrow. At CMU Database Group – Vaccination Database Tech Talks, May 2021. ↩︎
Carlota Soto and Mike Freedman. Building Columnar Compression for Large PostgreSQL Databases. timescale.com, March 2024. Archived at perma.cc/7KTF-V3EH ↩︎
Daniel Lemire, Gregory Ssi‐Yan‐Kai, and Owen Kaser. Consistently faster and smaller compressed bitmaps with Roaring. Software: Practice and Experience, volume 46, issue 11, pages 1547–1569, November 2016. doi:10.1002/spe.2402 ↩︎
Jaz Volpert. An entire Social Network in 1.6GB (GraphD Part 2). jazco.dev, April 2024. Archived at perma.cc/L27Z-QVMG ↩︎
Daniel J. Abadi, Peter Boncz, Stavros Harizopoulos, Stratos Idreos, and Samuel Madden. The Design and Implementation of Modern Column-Oriented Database Systems. Foundations and Trends in Databases, volume 5, issue 3, pages 197–280, December 2013. doi:10.1561/1900000024 ↩︎ ↩︎
Andrew Lamb, Matt Fuller, Ramakrishna Varadarajan, Nga Tran, Ben Vandiver, Lyric Doshi, and Chuck Bear. The Vertica Analytic Database: C-Store 7 Years Later. Proceedings of the VLDB Endowment, volume 5, issue 12, pages 1790–1801, August 2012. doi:10.14778/2367502.2367518 ↩︎
Timo Kersten, Viktor Leis, Alfons Kemper, Thomas Neumann, Andrew Pavlo, and Peter Boncz. Everything You Always Wanted to Know About Compiled and Vectorized Queries But Were Afraid to Ask. Proceedings of the VLDB Endowment, volume 11, issue 13, pages 2209–2222, September 2018. doi:10.14778/3275366.3284966 ↩︎ ↩︎
Forrest Smith. Memory Bandwidth Napkin Math. forrestthewoods.com, February 2020. Archived at perma.cc/Y8U4-PS7N ↩︎
Peter Boncz, Marcin Zukowski, and Niels Nes. MonetDB/X100: Hyper-Pipelining Query Execution. At 2nd Biennial Conference on Innovative Data Systems Research (CIDR), January 2005. ↩︎
Jingren Zhou and Kenneth A. Ross. Implementing Database Operations Using SIMD Instructions. At ACM International Conference on Management of Data (SIGMOD), pages 145–156, June 2002. doi:10.1145/564691.564709 ↩︎
Kevin Bartley. OLTP Queries: Transfer Expensive Workloads to Materialize. materialize.com, August 2024. Archived at perma.cc/4TYM-TYD8 ↩︎
Jim Gray, Surajit Chaudhuri, Adam Bosworth, Andrew Layman, Don Reichart, Murali Venkatrao, Frank Pellow, and Hamid Pirahesh. Data Cube: A Relational Aggregation Operator Generalizing Group-By, Cross-Tab, and Sub-Totals. Data Mining and Knowledge Discovery, volume 1, issue 1, pages 29–53, March 2007. doi:10.1023/A:1009726021843 ↩︎
Frank Ramsak, Volker Markl, Robert Fenk, Martin Zirkel, Klaus Elhardt, and Rudolf Bayer. Integrating the UB-Tree into a Database System Kernel. At 26th International Conference on Very Large Data Bases (VLDB), September 2000. ↩︎
Octavian Procopiuc, Pankaj K. Agarwal, Lars Arge, and Jeffrey Scott Vitter. Bkd-Tree: A Dynamic Scalable kd-Tree. At 8th International Symposium on Spatial and Temporal Databases (SSTD), pages 46–65, July 2003. doi:10.1007/978-3-540-45072-6_4 ↩︎
Joseph M. Hellerstein, Jeffrey F. Naughton, and Avi Pfeffer. Generalized Search Trees for Database Systems. At 21st International Conference on Very Large Data Bases (VLDB), September 1995. ↩︎
Isaac Brodsky. H3: Uber’s Hexagonal Hierarchical Spatial Index. eng.uber.com, June 2018. Archived at archive.org ↩︎
Robert Escriva, Bernard Wong, and Emin Gün Sirer. HyperDex: A Distributed, Searchable Key-Value Store. At ACM SIGCOMM Conference, August 2012. doi:10.1145/2377677.2377681 ↩︎
Christopher D. Manning, Prabhakar Raghavan, and Hinrich Schütze. Introduction to Information Retrieval. Cambridge University Press, 2008. ISBN: 978-0-521-86571-5, available online at nlp.stanford.edu/IR-book ↩︎
Jianguo Wang, Chunbin Lin, Yannis Papakonstantinou, and Steven Swanson. An Experimental Study of Bitmap Compression vs. Inverted List Compression. At ACM International Conference on Management of Data (SIGMOD), pages 993–1008, May 2017. doi:10.1145/3035918.3064007 ↩︎
Adrien Grand. What is in a Lucene Index? At Lucene/Solr Revolution, November 2013. Archived at perma.cc/Z7QN-GBYY ↩︎
Michael McCandless. Visualizing Lucene’s Segment Merges. blog.mikemccandless.com, February 2011. Archived at perma.cc/3ZV8-72W6 ↩︎
Lukas Fittl. Understanding Postgres GIN Indexes: The Good and the Bad. pganalyze.com, December 2021. Archived at perma.cc/V3MW-26H6 ↩︎
Jimmy Angelakos. The State of (Full) Text Search in PostgreSQL 12. At FOSDEM, February 2020. Archived at perma.cc/J6US-3WZS ↩︎
Alexander Korotkov. Index support for regular expression search. At PGConf.EU Prague, October 2012. Archived at perma.cc/5RFZ-ZKDQ ↩︎
Michael McCandless. Lucene’s FuzzyQuery Is 100 Times Faster in 4.0. blog.mikemccandless.com, March 2011. Archived at perma.cc/E2WC-GHTW ↩︎
Steffen Heinz, Justin Zobel, and Hugh E. Williams. Burst Tries: A Fast, Efficient Data Structure for String Keys. ACM Transactions on Information Systems, volume 20, issue 2, pages 192–223, April 2002. doi:10.1145/506309.506312 ↩︎
Klaus U. Schulz and Stoyan Mihov. Fast String Correction with Levenshtein Automata. International Journal on Document Analysis and Recognition, volume 5, issue 1, pages 67–85, November 2002. doi:10.1007/s10032-002-0082-8 ↩︎
Tomas Mikolov, Kai Chen, Greg Corrado, and Jeffrey Dean. Efficient Estimation of Word Representations in Vector Space. At International Conference on Learning Representations (ICLR), May 2013. doi:10.48550/arXiv.1301.3781 ↩︎
Jacob Devlin, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. At Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, volume 1, pages 4171–4186, June 2019. doi:10.18653/v1/N19-1423 ↩︎
Alec Radford, Karthik Narasimhan, Tim Salimans, and Ilya Sutskever. Improving Language Understanding by Generative Pre-Training. openai.com, June 2018. Archived at perma.cc/5N3C-DJ4C ↩︎
Matthijs Douze, Maria Lomeli, and Lucas Hosseini. Faiss indexes. github.com, August 2024. Archived at perma.cc/2EWG-FPBS ↩︎
Varik Matevosyan. Understanding pgvector’s HNSW Index Storage in Postgres. lantern.dev, August 2024. Archived at perma.cc/B2YB-JB59 ↩︎
Dmitry Baranchuk, Artem Babenko, and Yury Malkov. Revisiting the Inverted Indices for Billion-Scale Approximate Nearest Neighbors. At European Conference on Computer Vision (ECCV), pages 202–216, September 2018. doi:10.1007/978-3-030-01258-8_13 ↩︎
Yury A. Malkov and Dmitry A. Yashunin. Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs. IEEE Transactions on Pattern Analysis and Machine Intelligence, volume 42, issue 4, pages 824–836, April 2020. doi:10.1109/TPAMI.2018.2889473 ↩︎
5 编码与演化

唯变所适。
以弗所的赫拉克利特,引自柏拉图《克拉提鲁斯》(公元前 360 年)
应用程序不可避免地会随时间而变化。随着新产品推出、对用户需求的理解日益深入,或者商业环境发生变化,应用程序总要增添或修改功能。在 第 2 章 中,我们介绍了 可演化性(evolvability)的概念:应该尽力构建能够灵活适应变化的系统(参见“可演化性:让变化更容易”)。
在大多数情况下,修改应用程序的功能也意味着需要更改其存储的数据:可能需要记录新的字段或记录类型,也可能需要以新的方式呈现现有数据。
我们在 第 3 章 中讨论的数据模型,采用不同的方法来应对这种变化。关系数据库通常假定数据库中的所有数据都遵循同一个模式:尽管可以通过模式迁移(即 ALTER 语句)来更改模式,但任何时刻都只有一个模式有效。相比之下,读时模式(即“无模式”)数据库不会强制使用某个模式,因此数据库中可以混合存放在不同时间写入的新旧数据格式(参见“文档模型中的模式灵活性”)。
当数据格式或模式发生变化时,通常也需要相应地修改应用程序代码(例如,为记录添加新字段,然后让应用程序开始读写该字段)。但在大型应用程序中,代码变更往往无法瞬间完成:
- 对于服务端应用程序,可能需要执行 滚动升级(rolling upgrade,也称为 逐步发布,staged rollout):每次只把新版本部署到少数几个节点,确认运行正常后,再逐步部署到所有节点。这样无需中断服务即可上线新版本,有利于更频繁地发布,也让系统更容易演化。
- 对于客户端应用程序,是否升级只能任由用户决定,而用户可能很长时间都不安装更新。
这意味着,新旧版本的代码以及新旧数据格式,可能同时存在于系统中。系统要继续顺利运行,就需要保持双向兼容:
- 向后兼容(backward compatibility)
- 较新的代码可以读取由较旧代码写入的数据。
- 向前兼容(forward compatibility)
- 较旧的代码可以读取由较新代码写入的数据。
向后兼容通常不难实现:新代码的作者知道旧代码写入的数据格式,因此可以显式地处理它(必要时,只要保留读取旧数据的旧代码即可)。向前兼容则可能棘手得多,因为旧代码必须忽略新版本代码新增的部分。
向前兼容还有一个难点,如 图 5-1 所示。假设你在记录模式中添加了一个字段,新代码创建了一条包含这个字段的记录,并把它存入数据库。随后,尚不了解这个新字段的旧版代码读出记录,做了更新,又将其写回。在这种情况下,通常希望旧代码把新字段原样保留下来,即使它无法解释该字段。但如果记录被解码成一个不会显式保留未知字段的模型对象,数据就可能丢失,如 图 5-1 所示。

本章将介绍几种数据编码格式,包括 JSON、XML、Protocol Buffers 和 Avro。我们尤其关注这些格式如何应对模式变化,以及如何支持新旧数据与新旧代码共存。随后,我们会讨论这些格式如何用于存储和通信,包括数据库、Web 服务、REST API、远程过程调用(RPC)、工作流引擎,以及 actor 和消息队列等事件驱动系统。
编码数据的格式
程序通常(至少)使用两种形式的数据:
- 在内存中,数据保存在对象、结构体、列表、数组、哈希表、树等数据结构中。这些结构通常使用指针,针对 CPU 的高效访问与操作进行了优化。
- 如果要将数据写入文件或通过网络发送,就必须将其编码成某种自包含的字节序列(例如 JSON 文档)。由于指针对其他进程没有意义,这种字节序列表示通常与内存中的数据结构大不相同。
因此,需要在两种表示之间进行转换。从内存表示转换为字节序列,称为 编码(encoding,也称为 序列化,serialization,或 编组,marshalling);反过来则称为 解码(decoding,也称为 解析,parsing,反序列化,deserialization,或 解组,unmarshalling)。
遗憾的是,序列化 一词也用于事务的语境,而且含义完全不同(参见 第 8 章)。虽然“序列化”可能更常用,但为了避免一词多义,本书在这里始终使用 编码。
也有一些情况不需要编码和解码。例如,“查询执行:编译与向量化” 中介绍过,数据库可以直接操作从磁盘加载的压缩数据。还有一些 零拷贝(zero-copy)数据格式,例如 Cap’n Proto 和 FlatBuffers;它们既可用于运行时,也可直接用于磁盘或网络上的数据,无需显式的转换步骤。
不过,大多数系统仍需在内存对象与扁平的字节序列之间转换。这是个极其常见的问题,因而有数不清的库和编码格式可供选择。下面先来简要概览一下。
特定语言的格式
许多编程语言都内置了将内存对象编码成字节序列的功能。例如,Java 有 java.io.Serializable,Python 有 pickle,Ruby 有 Marshal,等等。此外还有许多第三方库,例如 Java 的 Kryo。
这些编码库非常方便,只需很少的额外代码就能保存和恢复内存对象。但是,它们也有一些深层次的问题:
- 这类编码通常与某种编程语言紧密绑定,其他语言很难读取。如果用这类编码存储或传输数据,就可能在很长一段时间内把自己锁定在当前语言上,也很难与其他组织的系统集成——它们使用的语言可能与你不同。
- 为了恢复出相同类型的对象,解码过程必须能够实例化任意类,这经常成为安全漏洞的来源 1。如果攻击者能让应用程序解码任意字节序列,就可能借此实例化任意类,进而实施远程执行任意代码之类的恶意操作 2 3。
- 这些库通常事后才考虑数据的版本管理。它们只求快速、方便地编码数据,往往忽略向前兼容和向后兼容这些棘手的问题 4。
- 效率——包括编码或解码所耗的 CPU 时间,以及编码结果的大小——往往也是事后才考虑的。例如,Java 的内置序列化就因性能糟糕、编码臃肿而臭名昭著 5。
因此,除非数据只作非常短暂的使用,否则采用语言内置的编码通常不是个好主意。
JSON、XML 及其二进制变体
说到可由多种编程语言读写的标准编码,JSON 和 XML 是最显眼的候选者。它们广为人知、广受支持,也几乎同样“广受憎恶”。XML 经常因为过于冗长和不必要的复杂而受到批评 6。JSON 的流行,主要得益于 Web 浏览器的内置支持,以及它相对于 XML 的简单性。CSV 是另一种流行的语言无关格式,但它只能表示不含嵌套的表格数据。
JSON、XML 和 CSV 都是文本格式,因而具有一定的人类可读性(尽管它们的语法一直是热门争议话题)。除了表面的语法问题,它们还有一些不易察觉的麻烦:
数字 的编码有很多模糊之处。在 XML 和 CSV 中,无法区分数值和碰巧只由数字组成的字符串,除非借助外部模式。JSON 虽然区分字符串和数值,却不区分整数与浮点数,也没有规定精度。
处理大数时,这会造成问题。例如,大于 2⁵³ 的整数无法用 IEEE 754 双精度浮点数精确表示;如果某种语言像 JavaScript 一样使用浮点数来解析数值,这些大整数就会失真 7。X(原 Twitter)使用 64 位数字标识每条帖子,便是一个实际例子。为了绕过 JavaScript 应用程序无法正确解析这类数字的问题,其 API 返回的 JSON 会把帖子 ID 包含两次:一次作为 JSON 数值,另一次作为十进制字符串 8。
JSON 和 XML 对 Unicode 字符串(即人类可读的文本)支持得很好,却不支持二进制字符串(即不带字符编码的字节序列)。二进制字符串非常有用,人们通常把二进制数据用 Base64 编码成文本来绕过这一限制,再由模式说明该值应按 Base64 解读。这个办法虽然管用,却有些取巧,而且会让数据体积增加 33%。
XML 模式和 JSON 模式功能强大,因而学习和实现起来都相当复杂。数字、二进制字符串等数据的正确解释依赖模式中的信息,所以不使用 XML/JSON 模式的应用程序可能不得不硬编码相应的编码与解码逻辑。
CSV 没有任何模式,每行每列的含义完全由应用程序自行定义。如果应用程序变更增加了一行或一列,就必须手工处理这种变化。CSV 本身也相当含糊:如果值中包含逗号或换行符,该怎么办?尽管转义规则已有正式规范 9,却不是所有解析器都正确实现了它。
尽管有这些缺陷,JSON、XML 和 CSV 对许多用途来说已经足够好。它们很可能会继续流行,尤其是作为数据交换格式——也就是把数据从一个组织发送给另一个组织。在这种情况下,只要大家能就格式达成一致,格式是否美观或高效往往并不重要。毕竟,让不同组织对 任何事情 达成一致,就已经压倒了大多数其他考量。
JSON 模式
当数据需要在系统间交换或写入存储时,JSON 模式已经成为广泛采用的数据建模方式。它出现在许多地方:作为 OpenAPI Web 服务规范的一部分用于 Web 服务(参见“Web 服务”);用于 Confluent Schema Registry、Red Hat Apicurio Registry 等模式注册表;也用于数据库,例如 PostgreSQL 的 pg_jsonschema 验证扩展,以及 MongoDB 的 $jsonSchema 验证语法。
JSON 模式规范提供了许多功能。它包含字符串、数值、整数、对象、数组、布尔值和空值等标准基本类型,还另有一套验证规范,开发者可以用它给字段附加约束。例如,可以规定 port 字段的最小值为 1、最大值为 65535。
JSON 模式可以采用开放或封闭的内容模型。开放内容模型允许出现模式未定义的任意字段,而且这些字段可以是任意数据类型;封闭内容模型则只允许出现显式定义的字段。在 JSON 模式中,把 additionalProperties 设为 true 就会启用开放内容模型,而这恰好是默认值。因此,JSON 模式通常是在定义 不允许什么(也就是已定义字段上的无效值),而不是穷举模式中 允许什么。
开放内容模型功能强大,但也可能相当复杂。假设你想定义一个从整数(例如 ID)到字符串的映射。JSON 没有映射或字典类型,只有“对象”类型;对象的键必须是字符串,值则可以是任意类型。此时可以借助 JSON 模式,用 patternProperties 和 additionalProperties 约束对象,规定键只能由数字组成、值只能是字符串,如 示例 5-1 所示。
除了开放和封闭内容模型以及验证器,JSON 模式还支持条件式 if/else 模式逻辑、命名类型、远程模式引用等诸多功能。这些能力造就了一门十分强大的模式语言,却也让模式定义变得庞杂难用。解析远程模式、推断条件规则,或者以向前或向后兼容的方式演化模式,都可能很有挑战 10。XML 模式也有类似的问题 11。
二进制编码
JSON 比 XML 简洁,但两者与二进制格式相比仍然很占空间。于是,人们开发出了大量 JSON 的二进制编码(例如 MessagePack、CBOR、BSON、BJSON、UBJSON、BISON、Hessian 和 Smile)以及 XML 的二进制编码(例如 WBXML 和 Fast Infoset)。这些格式更紧凑,有时解析也更快,因此在各自的细分领域得到应用;但没有一种像文本版 JSON 和 XML 那样普及 12。
其中一些格式扩展了数据类型集合,例如区分整数和浮点数,或者支持二进制字符串;除此之外,它们仍然沿用 JSON/XML 的数据模型。尤其是,它们没有规定模式,所以必须把所有对象字段名都写进编码后的数据。也就是说,对 示例 5-2 中的 JSON 文档进行二进制编码时,某处仍须包含 userName、favoriteNumber 和 interests 这些字符串。
下面来看 MessagePack,它是 JSON 的一种二进制编码。图 5-2 展示了用 MessagePack 编码 示例 5-2 中的 JSON 文档后得到的字节序列。开头几个字节的含义如下:
- 第一个字节
0x83表示接下来是一个对象(高四位 =0x80),其中有三个字段(低四位 =0x03)。(如果对象超过 15 个字段,字段数无法装进四位,就会改用另一种类型标识符,并用两个或四个字节编码字段数。) - 第二个字节
0xa8表示接下来是一个字符串(高四位 =0xa0),长度为八个字节(低四位 =0x08)。 - 接下来的八个字节,是以 ASCII 编码的字段名
userName。由于前面已经给出长度,不需要再用标记或转义来指示字符串在哪里结束。 - 再往后的七个字节,以前缀
0xa6加六个字母的方式编码字符串值Martin,后续内容依此类推。
二进制编码共 66 字节,只比去掉空白后的文本 JSON(81 字节)略小一点。各种 JSON 二进制编码在这方面都差不多。如此有限的空间节省(外加也许更快的解析速度),是否值得牺牲人类可读性,并不好说。
接下来我们会看到,同一条记录其实可以只用 32 字节编码,效果好得多。

Protocol Buffers
Protocol Buffers(protobuf)是 Google 开发的二进制编码库。它与最初由 Facebook 开发的 Apache Thrift 很相似 13;本节关于 Protocol Buffers 的大部分内容也适用于 Thrift。
Protocol Buffers 要求任何待编码的数据都有模式。要用 Protocol Buffers 编码 示例 5-2 中的数据,可以用 Protocol Buffers 的接口定义语言(IDL)这样描述模式:
Protocol Buffers 自带代码生成工具。它接收上述模式定义,生成用各种编程语言实现该模式的类,应用程序可以调用生成的代码来编码或解码符合模式的记录。与 JSON 模式相比,Protocol Buffers 的模式语言非常简单:它只定义记录的字段及其类型,不支持对字段取值施加其他约束。
使用 Protocol Buffers 编码器对 示例 5-2 进行编码,需要 33 字节,如 图 5-3 所示 14。

与 图 5-2 类似,每个字段都有类型注解,用来说明它是字符串、整数还是其他类型;必要时还会给出长度,例如字符串长度。数据中的字符串(“Martin”“daydreaming”“hacking”)也和之前一样编码为 ASCII——准确地说,是 UTF-8。
与 图 5-2 相比,最大的区别在于这里没有字段名(userName、favoriteNumber、interests)。编码数据包含的是数字形式的 字段标签(field tag)(1、2 和 3),也就是模式定义中的那些数字。字段标签好比字段的别名:无需写出字段名,就能以紧凑的方式指出所说的是哪个字段。
Protocol Buffers 把字段类型和标签号塞进同一个字节,进一步节省了空间。它还使用变长整数:数字 1337 编码成两个字节,每个字节的最高位表示后面是否还有更多字节。这样,-64 到 63 之间的数字用一个字节编码,-8192 到 8191 之间的数字用两个字节编码,依此类推;数字越大,占用的字节就越多。
Protocol Buffers 没有显式的列表或数组数据类型。interests 字段上的 repeated 修饰符表示该字段包含一组值,而不是单个值。在二进制编码中,列表元素只是同一字段标签在同一条记录中重复出现。
字段标签与模式演化
前面说过,模式不可避免地会随时间改变,这称为 模式演化(schema evolution)。Protocol Buffers 如何在保持向后和向前兼容的同时处理模式变更?
从示例可以看出,一条编码后的记录,就是各个已编码字段的拼接。每个字段由标签号(示例模式中的 1、2、3)标识,并带有数据类型注解(例如字符串或整数)。如果某个字段没有值,就直接从编码记录中省略。由此可见,字段标签对编码数据的含义至关重要。模式中的字段名可以修改,因为编码数据从不引用字段名;但字段标签不能修改,否则现有的所有编码数据都会失效。
可以向模式中添加新字段,只要给它分配一个新的标签号。旧代码并不知道新增的标签号;当它读取新代码写入的数据、遇到无法识别的新字段时,只需忽略该字段即可。借助数据类型注解,解析器能够判断要跳过多少字节;同时还应保留未知字段,以免出现 图 5-1 所示的问题。这样就保持了向前兼容:旧代码仍能读取新代码写入的记录。
向后兼容又如何呢?只要每个字段的标签号唯一,新代码就总能读取旧数据,因为标签号的含义没有改变。如果新模式增加了一个字段,而读取的旧数据尚不包含它,就会填入默认值:例如,字符串字段填入空字符串,数值字段填入零。
删除字段与添加字段类似,只是向后兼容和向前兼容的考量正好相反。已经用过的标签号绝不能再次使用,因为某处可能仍有带着旧标签号的数据,而新代码必须忽略这个字段。可以在模式定义中把用过的标签号标记为保留,确保以后不会忘记。
字段的数据类型能否改变?某些类型可以,详情需查阅文档,但值有可能被截断。例如,假设把一个 32 位整数改成 64 位整数。新代码可以轻松读取旧代码写入的数据,因为解析器能用零补齐缺少的位。但如果旧代码读取新代码写入的数据,它仍会用 32 位变量保存这个值;一旦解码后的 64 位值装不进 32 位,就会被截断。
Avro
Apache Avro 是另一种二进制编码格式,与 Protocol Buffers 有着颇为有趣的差异。它于 2009 年作为 Hadoop 的子项目启动,起因是 Protocol Buffers 不适合 Hadoop 的使用场景 15。
Avro 也使用模式来规定待编码数据的结构。它有两种模式语言:一种是供人编辑的 Avro IDL,另一种基于 JSON,更便于机器读取。与 Protocol Buffers 一样,Avro 的模式语言只规定字段及其类型,不支持 JSON 模式那样复杂的验证规则。
用 Avro IDL 编写的示例模式可能如下所示:
等价的 JSON 表示如下:
首先请注意,模式中没有标签号。如果用这个模式编码示例记录(示例 5-2),Avro 的二进制编码只有 32 字节,是目前所见编码中最紧凑的。图 5-4 展示了这个字节序列的组成。
仔细查看这个字节序列,会发现其中没有任何内容标识字段或数据类型;编码仅仅是各个值的拼接。字符串就是长度前缀加上 UTF-8 字节,但编码数据本身并不说明它是字符串——它同样可能是整数或其他任何东西。整数则使用变长编码。

要解析二进制数据,必须按照字段在模式中出现的顺序逐一读取,并由模式告知每个字段的数据类型。这意味着,读取数据的代码只有使用与写入代码 完全相同的模式,才能正确解码二进制数据。读写双方的模式只要有任何不一致,解码结果就会出错。
那么,Avro 如何支持模式演化?
写入者模式与读取者模式
当应用程序要编码数据——例如写入文件或数据库,或者通过网络发送——它会使用自己所知版本的模式;这个模式可能已经编译进应用程序。这称为 写入者模式(writer’s schema)。
当应用程序要解码数据——例如从文件或数据库读取,或者从网络接收——它会使用两个模式:一个是与编码时完全相同的写入者模式,另一个是可能有所不同的 读取者模式(reader’s schema),如 图 5-5 所示。读取者模式定义了应用程序代码期望每条记录包含哪些字段,以及这些字段的类型。

如果读写双方的模式相同,解码很简单。如果不同,Avro 会并排比较写入者模式与读取者模式,把数据从前者转换成后者,从而协调其中的差异。Avro 规范 16 17 精确定义了这一解析过程,图 5-6 给出了示意。
例如,写入者模式和读取者模式中的字段顺序不同并不成问题,因为模式解析会按字段名配对。读取代码如果遇到只存在于写入者模式、却不在读取者模式中的字段,就将其忽略;如果读取代码需要某个字段,而写入者模式中没有同名字段,就填入读取者模式声明的默认值。

模式演化规则
对 Avro 而言,向前兼容意味着可以用新版模式写入、用旧版模式读取;反过来,向后兼容意味着可以用旧版模式写入、用新版模式读取。
为了保持兼容,只能添加或删除带默认值的字段(示例 Avro 模式中的 favoriteNumber 字段,默认值就是 null)。例如,假设新增了一个带默认值的字段,于是该字段存在于新模式、却不存在于旧模式。当采用新模式的读取者读取旧模式写入的记录时,就会为缺少的字段填入默认值。
如果新增的字段没有默认值,新读取者就无法读取旧写入者产生的数据,因而破坏向后兼容。如果删除的字段没有默认值,旧读取者就无法读取新写入者产生的数据,因而破坏向前兼容。
在某些编程语言中,任何变量都可以默认取 null,Avro 却并非如此:如果希望字段允许为 null,就必须使用 联合类型(union type)。例如,union { null, long, string } field; 表示 field 可以是数字、字符串或 null。而且,只有当 null 是联合类型的第一个分支时,才能把它用作默认值。这种写法比默认所有内容都可为 null 略显冗长,却明确说明了什么可以、什么不可以为 null,从而有助于避免错误 18。
只要 Avro 能完成相应的类型转换,就可以更改字段的数据类型。字段名也能更改,不过稍微麻烦一些:读取者模式可以为字段名声明别名,从而让旧写入者模式中的字段名与别名匹配。因此,更改字段名向后兼容,却不向前兼容。同样,给联合类型增加一个分支向后兼容,却不向前兼容。
但什么是写入者模式?
到目前为止,我们一直略过一个重要问题:读取者如何知道某段数据是用哪个写入者模式编码的?不能把整个模式塞进每条记录,因为模式很可能比编码后的数据大得多,那样二进制编码省下的空间就全白费了。
答案取决于 Avro 的使用场景。举几个例子:
- 包含大量记录的大文件
- Avro 的一种常见用途,是存储包含数百万条记录的大文件,所有记录都使用同一个模式编码(我们会在 第 11 章 讨论这种情况)。此时,文件的写入者只需在文件开头写入一次写入者模式。Avro 为此规定了一种文件格式,称为对象容器文件。
- 逐条写入记录的数据库
- 在数据库中,不同记录可能在不同时间用不同的写入者模式写入,不能假定所有记录都采用同一个模式。最简单的解决方案,是在每条编码记录的开头放一个版本号,并在数据库中维护模式版本列表。读取者取出记录后先提取版本号,再从数据库取得该版本对应的写入者模式,用它解码记录的其余部分。
例如,Apache Kafka 的 Confluent Schema Registry 19 和 LinkedIn 的 Espresso 20 就采用这种做法。
- 通过网络连接发送记录
- 当两个进程通过双向网络连接通信时,可以在建立连接时协商模式版本,并在连接的整个生命周期中使用这个模式。Avro RPC 协议(参见“流经服务的数据流:REST 与 RPC”)就是这样工作的。
无论采用哪种方式,维护模式版本数据库都很有用:它既是文档,也让你有机会检查模式兼容性 21。版本号可以是简单递增的整数,也可以是模式的哈希值。
动态生成的模式
与 Protocol Buffers 相比,Avro 的一个优点是模式中没有任何标签号。但这为什么重要?在模式中维护几个数字,能有什么问题?
区别在于,Avro 对 动态生成 的模式更友好。假设你想把关系数据库的内容转储到文件,并希望使用二进制格式,避开前面提到的 JSON、CSV、XML 等文本格式的问题。使用 Avro 时,可以很容易地从关系模式生成 Avro 模式(采用前面展示过的 JSON 表示),再用它编码数据库内容,把所有数据转储到 Avro 对象容器文件中 22。可以为每张数据库表生成一个记录模式,让表中的每一列对应记录中的一个字段,数据库列名则映射为 Avro 字段名。
如果数据库模式发生变化,例如表中增加一列、删除一列,只要根据更新后的数据库模式生成新的 Avro 模式,再用新模式导出数据即可。数据导出过程无需关注具体发生了什么模式变更,每次运行时照常完成模式转换就行。读取新数据文件的人会看到记录字段发生了变化,但由于字段按名称标识,更新后的写入者模式仍能与旧读取者模式匹配。
相比之下,如果用 Protocol Buffers 完成这项工作,字段标签很可能必须手工分配:数据库模式每次变化,管理员都得手工更新数据库列名到字段标签的映射。(这也许能够自动化,但模式生成器必须格外谨慎,不能再次分配以前用过的标签号。)动态生成模式从来就不是 Protocol Buffers 的设计目标,却是 Avro 的设计目标之一。
模式的优点
正如我们所见,Protocol Buffers 和 Avro 都用模式描述二进制编码格式。它们的模式语言比 XML 模式或 JSON 模式简单得多;后两者支持更细致的验证规则,例如“这个字段的字符串值必须匹配某个正则表达式”,或者“这个字段的整数值必须介于 0 和 100 之间”。Protocol Buffers 和 Avro 实现起来更简单,使用起来也更简单,因此已经支持相当广泛的编程语言。
这些编码背后的思想绝不新鲜。例如,它们与 ASN.1 有许多共同之处。ASN.1 是一门模式定义语言,早在 1984 年便首次标准化 23 24;它曾用于定义各种网络协议,其二进制编码 DER 至今仍用于编码 SSL 证书(X.509)25。与 Protocol Buffers 类似,ASN.1 也用标签号支持模式演化 26。不过,ASN.1 非常复杂,文档也很糟糕,因此可能并不适合新的应用程序。
许多数据系统也为自身数据实现了某种专有二进制编码。例如,大多数关系数据库都有自己的网络协议,用于接收查询并返回响应。这些协议通常只适用于特定数据库,由数据库厂商提供驱动程序(例如采用 ODBC 或 JDBC API),把数据库网络协议中的响应解码成内存数据结构。
由此可见,尽管 JSON、XML 和 CSV 等文本格式非常普遍,基于模式的二进制编码同样是可行的选择,而且具备一些很好的性质:
- 它们可以比各种“二进制 JSON”变体紧凑得多,因为编码数据中不必包含字段名。
- 模式本身就是一种很有价值的文档。解码时必须使用模式,所以可以确信它与数据保持同步;而手工维护的文档很容易与实际情况脱节。
- 维护模式数据库,可以在部署任何变更之前检查它是否保持向前和向后兼容。
- 对于静态类型编程语言的用户,从模式生成代码很有用,因为这样可以在编译时进行类型检查。
总而言之,模式演化提供了与无模式/读时模式 JSON 数据库相同的灵活性(参见“文档模型中的模式灵活性”),同时还能为数据提供更强的保证和更好的工具。
数据流的模式
本章开头曾经说过,每当你想把数据发送给不共享内存的另一个进程——例如通过网络发送数据,或者将数据写入文件——都需要先把它编码成字节序列。随后,我们讨论了完成这项工作所用的各种编码。
我们还讨论了向前兼容与向后兼容。两者对可演化性都很重要:它们允许独立升级系统的不同部分,不必一次改动所有内容,从而让变更更容易。兼容性描述的是编码数据的进程与解码数据的进程之间的关系。
这个概念相当抽象,因为数据可以通过许多方式从一个进程流向另一个进程。究竟由谁编码,又由谁解码?本章余下部分将探讨几种最常见的进程间数据流:
- 通过数据库(参见“流经数据库的数据流”)
- 通过服务调用(参见“流经服务的数据流:REST 与 RPC”)
- 通过工作流引擎(参见“持久化执行与工作流”)
- 通过异步消息(参见“事件驱动的架构”)
流经数据库的数据流
在数据库中,写入数据库的进程负责编码数据,读取数据库的进程负责解码。也许始终只有一个进程访问数据库,此时读取者只不过是同一进程的后续版本——可以把向数据库存入数据看作 给未来的自己发送消息。
显然,这里必须保持向后兼容,否则未来的你就无法解码过去写下的数据。
一般来说,多个不同进程同时访问数据库很常见。这些进程可能属于不同的应用程序或服务,也可能只是同一服务的多个实例,为可伸缩性或容错而并行运行。无论哪种情况,只要应用程序还在变化,访问数据库的进程就很可能有些运行新版代码,有些仍在运行旧版代码。例如,滚动升级期间,一部分实例已经更新,其他实例还没有。
这意味着,数据库中的某个值可能由 较新 版本的代码写入,随后却被仍在运行的 较旧 版本读取。因此,数据库通常也需要向前兼容。
不同时间写入的不同值
数据库通常允许随时更新任何值。因此,同一个数据库里可能既有五毫秒前写入的值,也有五年前写入的值。
部署新版应用程序时——至少对服务端应用程序而言——可能只需几分钟就能用新版本完全替换旧版本。但数据库内容不是这样:除非显式重写,五年前的数据仍会以最初的编码留在那里。这种现象有时概括为:数据比代码更长寿。
当然,可以把数据重写(即 迁移)到新模式,但对大型数据集来说代价高昂,所以大多数数据库都会尽量避免。大多数关系数据库允许某些简单的模式变更,例如增加一个默认值为 null 的新列,而不必重写已有数据。读取旧行时,如果磁盘上的编码数据缺少某一列,数据库便为它填入 null。
因此,模式演化让整个数据库看上去仿佛都用同一个模式编码,尽管底层存储中可能混有按各个历史版本模式编码的记录。
更复杂的模式变更——例如把单值属性改成多值属性,或者把一部分数据移到另一张表中——仍然需要重写数据,而且通常要在应用程序层完成 27。如何在这类迁移中保持向前和向后兼容,至今仍是一个研究问题 28。
归档存储
也许你会不时为数据库制作快照,用于备份或者加载到数据仓库中(参见“数据仓库”)。这时,即使源数据库的原始编码混合了不同时期的多个模式版本,数据转储通常也会统一使用最新模式编码。反正数据总要复制一遍,不妨让副本采用一致的编码。
数据转储一次写成,此后不再修改,因此 Avro 对象容器文件之类的格式很适合。这里也是把数据编码成适合分析的列式格式(例如 Parquet)的好机会(参见“列压缩”)。
在 第 11 章 中,我们会进一步讨论归档存储中数据的用途。
流经服务的数据流:REST 与 RPC
当多个进程需要通过网络通信时,可以采用几种不同的组织方式。最常见的方式包含两个角色:客户端(client)和 服务器(server)。服务器通过网络公开 API,客户端连接服务器并向 API 发出请求。服务器公开的这个 API 称为 服务(service)。
Web 正是这样工作的:客户端(Web 浏览器)向 Web 服务器发出请求,用 GET 请求下载 HTML、CSS、JavaScript、图片等内容,用 POST 请求向服务器提交数据。这个 API 由一套标准化的协议和数据格式组成,包括 HTTP、URL、SSL/TLS、HTML 等。因为 Web 浏览器、Web 服务器和网站作者基本都遵循这些标准,所以理论上可以用任何 Web 浏览器访问任何网站。
Web 浏览器并不是唯一的客户端。例如,运行在移动设备或桌面计算机上的原生应用程序经常与服务器通信,浏览器中的客户端 JavaScript 应用程序也可以发出 HTTP 请求。这种情况下,服务器返回的通常不是供人阅读的 HTML,而是便于客户端代码进一步处理的编码数据,最常见的是 JSON。HTTP 虽然可以作为传输协议,但构建在它之上的 API 仍然由应用程序自行定义,客户端与服务器必须就 API 的细节达成一致。
在某些方面,服务很像数据库:它们通常允许客户端提交和查询数据。不过,数据库允许使用 第 3 章 讨论过的查询语言发起任意查询,服务公开的却是应用程序专用 API,只接受服务业务逻辑(应用程序代码)预先规定的输入,也只产生预先规定的输出 29。这种限制带来了一定程度的封装:服务可以细粒度地约束客户端能做什么、不能做什么。
面向服务架构或微服务架构的一项关键设计目标,是让服务可以独立部署和演化,从而使应用程序更容易修改和维护。一条常见原则是:每项服务由一个团队负责,这个团队应当能够频繁发布服务的新版本,而不必与其他团队协调。因此,服务器和客户端的新旧版本同时运行是意料之中的,双方使用的数据编码必须跨服务 API 版本保持兼容。
Web 服务
如果以 HTTP 作为与服务通信的底层协议,就称为 Web 服务(Web service)。Web 服务常用于构建面向服务或微服务架构(前文“微服务与无服务器”已经讨论过)。不过,“Web 服务”这个名字并不十分贴切,因为它不只用于 Web,还出现在其他几种场景中。例如:
- 运行在用户设备上的客户端应用程序(例如移动设备上的原生应用,或者浏览器中的 JavaScript Web 应用)通过 HTTP 请求服务。这些请求通常经由公共互联网传输。
- 作为面向服务或微服务架构的一部分,一项服务请求同一组织拥有的另一项服务;两者通常位于同一个数据中心。
- 一项服务请求另一组织拥有的服务,通常经由互联网完成。这种方式用于不同组织的后端系统交换数据,包括在线服务提供的公共 API,例如信用卡支付系统,以及用来共享访问用户数据的 OAuth。
最流行的服务设计理念是 REST,它建立在 HTTP 的原则之上 30 31。REST 强调简单的数据格式,以 URL 标识资源,并利用 HTTP 的功能进行缓存控制、身份认证和内容类型协商。遵循 REST 原则设计的 API 称为 RESTful API。
调用 Web 服务 API 的代码必须知道应该请求哪个 HTTP 端点、应发送什么格式的数据,以及预期得到什么响应。即使服务遵循 RESTful 设计原则,客户端也得通过某种途径获知这些细节。服务开发者通常使用接口定义语言(IDL)来定义并记录 API 端点和数据模型,随后再逐步演化它们。其他开发者可以根据服务定义判断如何发起请求。最流行的两种服务 IDL 是 OpenAPI(也称为 Swagger 32)和 gRPC。OpenAPI 用于收发 JSON 数据的 Web 服务,而 gRPC 服务收发 Protocol Buffers 数据。
开发者通常用 JSON 或 YAML 编写 OpenAPI 服务定义,参见 示例 5-3。服务定义可以描述端点、文档、版本、数据模型等许多内容。gRPC 的定义看起来与此相似,但采用 Protocol Buffers 的服务定义语法。
即使选定了设计理念和 IDL,开发者仍要编写代码来实现服务的 API 调用。通常可以采用服务框架来简化这项工作。Spring Boot、FastAPI 和 gRPC 等框架让开发者只需编写每个 API 端点的业务逻辑,由框架负责路由、指标、缓存、身份认证等事务。示例 5-4 给出了 示例 5-3 所定义服务的一种 Python 实现。
许多框架把服务定义与服务器代码结合在一起。以流行的 Python 框架 FastAPI 为例,开发者先用代码编写服务器,框架再自动生成 IDL;gRPC 等框架则反过来,先编写服务定义,再生成服务器代码的脚手架。两种方式都能根据服务定义生成多种语言的客户端库和 SDK。除了生成代码,Swagger 等 IDL 工具还可以生成文档、验证模式变更是否兼容,并提供图形界面,供开发者查询和测试服务。
远程过程调用(RPC)的问题
Web 服务只是通过网络发起 API 请求这一系列技术的最新化身。此前许多技术都曾被大肆炒作,却存在严重问题:Enterprise JavaBeans(EJB)和 Java 的远程方法调用(RMI)局限于 Java;分布式组件对象模型(DCOM)局限于 Microsoft 平台;公共对象请求代理架构(CORBA)过度复杂,又不支持向后或向前兼容 33。SOAP 和 WS-* Web 服务框架试图实现跨厂商互操作,却同样饱受复杂性和兼容性问题困扰 34 35 36。
所有这些技术都建立在 远程过程调用(remote procedure call,RPC)的思想之上,而 RPC 早在 20 世纪 70 年代便已出现 37。RPC 模型试图让远程网络服务请求,看起来就像在同一进程内调用编程语言中的函数或方法一样(这种抽象称为 位置透明性,location transparency)。RPC 乍看十分方便,这种思路却有根本性的缺陷 38 39。网络请求与本地函数调用大不相同:
- 本地函数调用是可预测的,成功还是失败只取决于你能控制的参数。网络请求却不可预测:请求或响应可能因网络问题而丢失,远端机器也可能很慢或不可用,这些情况都完全不受你控制。网络问题很常见,必须预先做好准备,例如重试失败的请求。
- 本地函数调用要么返回结果,要么抛出异常,要么永远不返回(因为陷入死循环或进程崩溃)。网络请求还有另一种结果:它可能因 超时(timeout)而返回,却没有结果。此时你根本不知道发生了什么;如果远程服务没有响应,就无法判断请求究竟有没有送达(第 9 章 会更详细地讨论这个问题)。
- 重试失败的网络请求时,原请求可能其实已经成功,只是响应丢失了。此时重试会让同一操作执行多次,除非协议内置了去重机制,也就是 幂等性(idempotence)40。本地函数调用没有这个问题(参见“幂等性”)。
- 本地函数每次调用通常耗时相近。网络请求不仅比函数调用慢得多,延迟还会剧烈波动:顺利时可能不到一毫秒就完成;网络拥塞或远程服务过载时,同一个操作却可能花上好几秒。
- 调用本地函数时,可以高效传递指向本地内存对象的引用(指针)。发起网络请求时,所有参数都必须编码成可以通过网络发送的字节序列。对于数字、短字符串等不可变基本值,这不成问题;但数据量一大,或者涉及可变对象,麻烦很快就会出现。
- 客户端和服务可能由不同的编程语言实现,因此 RPC 框架必须在语言之间转换数据类型。各语言的类型并不完全相同,转换结果可能十分难看——例如前面提到过,JavaScript 无法准确表示大于 2⁵³ 的整数(参见“JSON、XML 及其二进制变体”)。如果单个进程只使用一种语言,就没有这个问题。
这些差异表明,没必要强求远程服务看起来像编程语言中的本地对象,因为两者从根本上就是不同的东西。REST 的一部分吸引力,正是它把网络上的状态传输视为有别于函数调用的过程。
负载均衡器、服务发现和服务网格
所有服务都通过网络通信,因此客户端必须知道目标服务的地址,这个问题称为 服务发现(service discovery)。最简单的做法,是把运行服务的 IP 地址和端口配置到客户端中。这样确实能工作,但服务器一旦离线、迁移到另一台机器或负载过高,就必须手工重新配置客户端。
为了提高可用性和可伸缩性,一项服务通常会在不同机器上运行多个实例,任一实例都能处理传入的请求。把请求分摊到这些实例上的过程称为 负载均衡(load balancing)41。负载均衡和服务发现有许多实现方案:
硬件负载均衡器(hardware load balancer)是安装在数据中心的专用设备。客户端只连接一个主机和端口,设备再把传入连接路由到运行该服务的某台服务器。此类负载均衡器会在连接下游服务器时检测网络故障,并将流量转移到其他服务器。
软件负载均衡器(software load balancer)的行为与硬件负载均衡器大体相同,只是不需要专用设备。Nginx 和 HAProxy 等软件负载均衡器就是可以安装在普通机器上的应用程序。
域名系统(DNS) 用于在互联网上解析域名,例如打开网页时就会用到。它允许一个域名关联多个 IP 地址,从而实现负载均衡。客户端可以配置为按域名而非 IP 地址连接服务,再由客户端的网络层在建立连接时选择某个 IP 地址。这种方法的缺点是,DNS 原本就允许变更经过较长时间才完全传播,而且会缓存 DNS 条目。如果服务器频繁启动、停止或迁移,客户端可能拿到过期的 IP 地址,而该地址上已经没有服务器运行。
服务发现系统(service discovery system)不使用 DNS,而是通过集中式注册表跟踪哪些服务端点可用。新服务实例启动时,会向发现系统注册自己,声明正在监听的主机和端口,以及分片归属信息(参见 第 7 章)、数据中心位置等相关元数据。随后,服务定期向发现系统发送心跳,表示自己仍然可用。
客户端要连接服务时,先向发现系统查询可用端点列表,再直接连接某个端点。与 DNS 相比,服务发现更适合实例频繁变化的动态环境。发现系统还会向客户端提供更多服务元数据,使客户端能做出更明智的负载均衡决策。
服务网格(service mesh)是一种更复杂的负载均衡方案,把软件负载均衡器与服务发现结合起来。传统软件负载均衡器运行在独立机器上,服务网格的负载均衡器则通常部署为进程内客户端库,或者部署为伴随客户端和服务器的进程或“边车”容器。客户端应用程序连接本机的服务负载均衡器,后者再连接服务器一侧的负载均衡器,最终把连接路由到本机的服务器进程。
这种拓扑虽然复杂,却有不少优点。客户端和服务器应用程序都只需建立本地连接,因此连接加密可以完全由负载均衡器处理,让应用程序不必面对 SSL 证书和 TLS 的复杂性。服务网格还提供了强大的可观测性,能够实时跟踪服务间的调用关系、检测故障、监测流量负载等。
哪种方案合适,取决于组织自身的需求。在使用 Kubernetes 等编排器的高度动态环境中,组织往往会选择 Istio 或 Linkerd 等服务网格。数据库、消息传递系统等专用基础设施,可能需要量身定制的负载均衡器。对于更简单的部署,软件负载均衡器通常就足够了。
RPC 的数据编码与演化
为了实现可演化性,RPC 客户端与服务器必须能够独立修改和部署。与上一节讨论的数据库数据流相比,服务数据流可以作一个简化假设:先更新所有服务器,再更新所有客户端通常是合理的。因此,请求只需向后兼容,响应只需向前兼容。
RPC 方案的向后与向前兼容性质,取决于它所采用的编码:
- gRPC(Protocol Buffers)和 Avro RPC 可以按照各自编码格式的兼容规则演化。
- RESTful API 通常用 JSON 编码响应,请求参数则通常采用 JSON、URI 编码或表单编码。增加可选请求参数,或者给响应对象增加新字段,通常都被视为保持兼容的变更。
RPC 经常用于跨组织边界通信,这让服务兼容性变得更加困难:服务提供者通常无法控制客户端,也不能强迫它们升级。因此,兼容性必须维持很长时间,甚至可能永远维持下去。如果不得不作出破坏兼容性的变更,服务提供者往往只好同时维护多个版本的服务 API。
对于 API 应当如何版本化——也就是客户端如何表明自己想使用哪个 API 版本——业界并无共识 42。RESTful API 的常见做法,是在 URL 或 HTTP Accept 标头中加入版本号。如果服务用 API 密钥识别具体客户端,还可以在服务器端记录该客户端请求的 API 版本,并通过单独的管理界面更新版本选择 43。
持久化执行与工作流
按照定义,基于服务的架构由多项服务组成,每项服务负责应用程序的一部分。以支付处理应用为例,它要从信用卡扣款,再把资金存入银行账户。系统很可能分别用不同服务负责欺诈检测、信用卡集成、银行系统集成等工作。
在这个例子中,处理一笔付款需要多次服务调用。支付处理服务可能先调用欺诈检测服务检查风险,再调用信用卡服务扣款,最后调用银行服务把扣下的款项存入账户,如 图 5-7 所示。这一系列步骤称为 工作流(workflow),其中每一步称为 任务(task)。工作流通常定义成一张任务图,其定义可以使用通用编程语言、领域特定语言(DSL),也可以使用业务流程执行语言(BPEL)之类的标记语言 44。
不同的工作流引擎对任务有不同称呼。例如,Temporal 使用 活动(activity)一词,另一些引擎则称之为 持久函数(durable function)。名称虽异,概念相同。

工作流由 工作流引擎(workflow engine)运行或执行。引擎决定每项任务何时运行、在哪台机器上运行、任务失败时该怎么办(例如执行任务的机器崩溃),以及允许多少任务并行执行等。
工作流引擎通常由编排器和执行器组成:编排器负责调度,执行器负责真正运行任务。工作流被触发后,执行便开始。如果用户定义了按时间运行的计划,例如每小时执行一次,编排器可以自行触发工作流;Web 服务等外部来源,甚至人,也可以触发工作流。一旦触发,执行器就会受命运行任务。
工作流引擎种类繁多,面向的使用场景也各不相同。Airflow、Dagster 和 Prefect 等引擎与数据系统集成,用于编排 ETL 任务。Camunda 和 Orkes 等引擎提供图形化工作流表示,例如 图 5-7 中的 BPMN,让非工程师也能更方便地定义和执行工作流。Temporal 和 Restate 等引擎则提供 持久化执行(durable execution)。
持久化执行
对于需要事务语义的服务架构,持久化执行框架已经成为一种流行的构建方式。在支付示例中,我们希望每笔付款都恰好处理一次。但工作流执行期间一旦发生故障,就可能出现信用卡已经扣款,银行账户却没有收到相应款项的情况。在基于服务的架构中,无法简单地把这两项任务包进一个数据库事务;况且,系统可能还要与我们无法充分控制的第三方支付网关交互。
持久化执行框架可以为工作流提供 恰好一次语义(exactly-once semantics)。任务失败后,框架会重新执行它,但会跳过失败前已经成功完成的 RPC 调用或状态变更:框架表面上再次发起调用,实际上却直接返回上一次调用的结果。这之所以可行,是因为框架把所有 RPC 和状态变更都记录在预写日志(WAL)之类的持久存储中 45 46。示例 5-5 展示了用 Temporal 定义支持持久化执行的工作流。
Temporal 之类的框架并非没有难题。外部服务——例如示例中的第三方支付网关——仍然必须提供幂等 API,开发者也必须记得为调用使用唯一 ID,以防重复执行 47。此外,持久化执行框架会按顺序记录每次 RPC 调用,因此要求后续执行以同样的顺序发起同样的调用。这让代码变更十分脆弱:仅仅调整函数调用顺序,就可能引入未定义行为 48。与其修改现有工作流的代码,更安全的做法是单独部署一个新版本,让已有工作流的重执行继续使用旧版代码,只有新启动的工作流才使用新版 49。
同样,持久化执行框架要求以确定性的方式重放所有代码,也就是相同输入必须产生相同输出。因此,随机数生成器、系统时钟等非确定性代码会带来问题 48。框架通常会为这类库函数提供自己的确定性实现,但开发者必须记得使用。有些框架还提供静态分析工具,用于检查是否引入了非确定性行为,例如 Temporal 的 workflowcheck。
让代码具有确定性是个强大的思想,但要可靠地做到这一点并不容易。我们会在“确定性的力量”中再次讨论这个话题。
事件驱动的架构
最后,我们来简要介绍 事件驱动架构(event-driven architecture),这是编码数据在进程间流动的另一种方式。请求在这里称为 事件(event)或 消息(message);与 RPC 不同,发送者通常不会等待接收者处理事件。事件一般也不会通过直接网络连接发给接收者,而是先经过一个临时存储消息的中介,称为 消息代理(message broker),也叫 事件代理(event broker)、消息队列(message queue)或 面向消息的中间件(message-oriented middleware) 50。
与直接使用 RPC 相比,消息代理有几个优点:
- 接收者不可用或过载时,它可以充当缓冲区,从而提高系统可靠性。
- 它可以自动向崩溃后恢复的进程重新传递消息,避免消息丢失。
- 它不需要服务发现,因为发送者不必直接连接接收者的 IP 地址。
- 它可以把同一条消息发送给多个接收者。
- 它从逻辑上解耦发送者与接收者:发送者只管发布消息,不必关心谁来消费。
通过消息代理进行的通信是 异步的(asynchronous):发送者不等待消息送达,只管发出消息,然后就将其忘掉。不过,也可以让发送者在另一条通道上等待响应,从而实现类似同步 RPC 的模型。
消息代理
过去,消息代理领域主要由 TIBCO、IBM WebSphere 和 webMethods 等公司的商业企业软件占据;后来 RabbitMQ、ActiveMQ、HornetQ、NATS 和 Apache Kafka 等开源实现逐渐流行。近年来,Amazon Kinesis、Azure Service Bus 和 Google Cloud Pub/Sub 等云服务也得到广泛采用。我们会在“消息传递系统”中更详细地比较它们。
具体的传递语义因实现和配置而异,但最常见的是以下两种消息分发模式:
- 一个进程把消息加入某个命名 队列(queue),代理再把消息交给该队列的一个 消费者(consumer)。如果有多个消费者,其中只有一个会收到这条消息。
- 一个进程把消息发布到某个命名 主题(topic),代理再把消息交给该主题的所有 订阅者(subscriber)。如果有多个订阅者,每个都会收到这条消息。
消息代理通常不强制使用特定数据模型:消息只是附带少量元数据的字节序列,因此可以采用任何编码格式。常见做法是使用 Protocol Buffers、Avro 或 JSON,并在消息代理旁部署模式注册表,用来保存所有有效的模式版本并检查兼容性 19 21。也可以使用 AsyncAPI——面向消息传递、与 OpenAPI 对应的规范——来规定消息模式。
不同消息代理对消息持久性的保证各不相同。许多代理会把消息写入磁盘,以免代理崩溃或重启时丢失消息。不过,与数据库不同,许多消息代理会在消息被消费后自动删除它。也有些代理可以配置为无限期保存消息;要采用事件溯源,就必须这样做(参见“事件溯源与 CQRS”)。
如果消费者把消息重新发布到另一个主题,就要注意保留未知字段,以免出现前面讨论数据库时所说的问题(图 5-1)。
分布式 actor 框架
Actor 模型(actor model)是一种用于单进程并发的编程模型。它不直接处理线程以及随之而来的竞态条件、锁和死锁,而是把逻辑封装在 actor 中。每个 actor 通常代表一个客户端或实体,可以拥有不与其他 actor 共享的本地状态,并通过收发异步消息与其他 actor 通信。消息传递并无保证:在某些错误场景下,消息会丢失。由于每个 actor 一次只处理一条消息,所以无需操心线程问题,而框架可以独立调度每个 actor。
Akka、Orleans 51 和 Erlang/OTP 等 分布式 actor 框架(distributed actor framework),用这种编程模型把应用程序扩展到多个节点。无论发送者和接收者位于同一节点还是不同节点,都使用同一种消息传递机制。如果双方位于不同节点,消息会被透明地编码成字节序列,通过网络发送,再由另一端解码。
位置透明性在 actor 模型中比在 RPC 中效果更好,因为 actor 模型本来就假设消息可能丢失,即使消息只在单个进程内传递也一样。网络延迟固然可能高于进程内延迟,但在 actor 模型中,本地通信与远程通信之间的根本差异要小得多。
分布式 actor 框架本质上把消息代理与 actor 编程模型集成在同一个框架中。不过,要对基于 actor 的应用程序进行滚动升级,仍然必须考虑向前和向后兼容:消息可能从运行新版代码的节点发往运行旧版代码的节点,也可能反过来。采用本章讨论的某种编码,就能实现这种兼容性。
总结
本章介绍了几种把数据结构转换成网络字节流或磁盘字节流的方法。我们看到,编码细节影响的不只是效率,更重要的是,它还会影响应用程序的架构,以及未来如何演化。
许多服务尤其需要支持滚动升级:新版本逐步部署到少数节点,而不是一次覆盖所有节点。滚动升级让服务无需停机就能发布新版本,因而鼓励频繁发布小版本,而不是很久才发布一次大版本;它也能降低部署风险,使有问题的版本在影响大量用户之前就被发现并回滚。这些性质大大提升了 可演化性,也就是修改应用程序的容易程度。
在滚动升级期间,或者出于其他种种原因,必须假设不同节点会运行不同版本的应用程序代码。因此,系统中流动的所有数据都应采用能够保持向后兼容(新代码可以读取旧数据)和向前兼容(旧代码可以读取新数据)的编码。
我们讨论了几种数据编码格式及其兼容性质:
- 编程语言专用的编码只能用于单一语言,而且往往无法提供向前和向后兼容。
- JSON、XML 和 CSV 等文本格式非常普遍,其兼容性取决于具体用法。它们可以配合可选的模式语言;这些模式有时很有帮助,有时反而成为障碍。文本格式对数据类型的规定有些模糊,因此必须留意数值和二进制字符串等问题。
- Protocol Buffers 和 Avro 等由模式驱动的二进制格式,能够以明确定义的向前、向后兼容语义进行紧凑而高效的编码。模式既可充当文档,也可为静态类型语言生成代码。不过,这类格式也有缺点:数据必须先解码,才能供人阅读。
我们还讨论了几种数据流模式,借此说明数据编码在哪些场景中十分重要:
- 在数据库中,写入数据库的进程编码数据,读取数据库的进程解码数据。
- 在 RPC 和 REST API 中,客户端编码请求,服务器解码请求并编码响应,最后由客户端解码响应。
- 在使用消息代理或 actor 的事件驱动架构中,节点通过互发消息来通信;发送者编码消息,接收者解码消息。
由此可以得出结论:只要稍加留意,向后兼容、向前兼容和滚动升级都完全能够实现。愿你的应用程序演化迅速,部署频繁。
参考文献
CWE-502: Deserialization of Untrusted Data. Common Weakness Enumeration, cwe.mitre.org, July 2006. Archived at perma.cc/26EU-UK9Y ↩︎
Steve Breen. What Do WebLogic, WebSphere, JBoss, Jenkins, OpenNMS, and Your Application Have in Common? This Vulnerability. foxglovesecurity.com, November 2015. Archived at perma.cc/9U97-UVVD ↩︎
Patrick McKenzie. What the Rails Security Issue Means for Your Startup. kalzumeus.com, January 2013. Archived at perma.cc/2MBJ-7PZ6 ↩︎
Brian Goetz. Towards Better Serialization. openjdk.org, June 2019. Archived at perma.cc/UK6U-GQDE ↩︎
Eishay Smith. jvm-serializers wiki. github.com, October 2023. Archived at perma.cc/PJP7-WCNG ↩︎
XML Is a Poor Copy of S-Expressions. wiki.c2.com, May 2013. Archived at perma.cc/7FAN-YBKL ↩︎
Julia Evans. Examples of floating point problems. jvns.ca, January 2023. Archived at perma.cc/M57L-QKKW ↩︎
Matt Harris. Snowflake: An Update and Some Very Important Information. Email to Twitter Development Talk mailing list, October 2010. Archived at perma.cc/8UBV-MZ3D ↩︎
Yakov Shafranovich. RFC 4180: Common Format and MIME Type for Comma-Separated Values (CSV) Files. IETF, October 2005. ↩︎
Andy Coates. Evolving JSON Schemas - Part I and Part II. creekservice.org, January 2024. Archived at perma.cc/MZW3-UA54 and perma.cc/GT5H-WKZ5 ↩︎
Pierre Genevès, Nabil Layaïda, and Vincent Quint. Ensuring Query Compatibility with Evolving XML Schemas. INRIA Technical Report 6711, November 2008. ↩︎
Tim Bray. Bits On the Wire. tbray.org, November 2019. Archived at perma.cc/3BT3-BQU3 ↩︎
Mark Slee, Aditya Agarwal, and Marc Kwiatkowski. Thrift: Scalable Cross-Language Services Implementation. Facebook technical report, April 2007. Archived at perma.cc/22BS-TUFB ↩︎
Martin Kleppmann. Schema Evolution in Avro, Protocol Buffers and Thrift. martin.kleppmann.com, December 2012. Archived at perma.cc/E4R2-9RJT ↩︎
Doug Cutting, Chad Walters, Jim Kellerman, et al. [PROPOSAL] New Subproject: Avro. Email thread on hadoop-general mailing list, lists.apache.org, April 2009. Archived at perma.cc/4A79-BMEB ↩︎
Apache Software Foundation. Apache Avro 1.12.0 Specification. avro.apache.org, August 2024. Archived at perma.cc/C36P-5EBQ ↩︎
Apache Software Foundation. Avro schemas as LL(1) CFG definitions. avro.apache.org, August 2024. Archived at perma.cc/JB44-EM9Q ↩︎
Tony Hoare. Null References: The Billion Dollar Mistake. Talk at QCon London, March 2009. ↩︎
Confluent, Inc. Schema Registry Overview. docs.confluent.io, 2024. Archived at perma.cc/92C3-A9JA ↩︎ ↩︎
Aditya Auradkar and Tom Quiggle. Introducing Espresso—LinkedIn’s Hot New Distributed Document Store. engineering.linkedin.com, January 2015. Archived at perma.cc/FX4P-VW9T ↩︎
Jay Kreps. Putting Apache Kafka to Use: A Practical Guide to Building a Stream Data Platform (Part 2). confluent.io, February 2015. Archived at perma.cc/8UA4-ZS5S ↩︎ ↩︎
Gwen Shapira. The Problem of Managing Schemas. oreilly.com, November 2014. Archived at perma.cc/BY8Q-RYV3 ↩︎
John Larmouth. ASN.1 Complete. Morgan Kaufmann, 1999. ISBN: 978-0-122-33435-1. Archived at perma.cc/GB7Y-XSXQ ↩︎
Burton S. Kaliski Jr. A Layman’s Guide to a Subset of ASN.1, BER, and DER. Technical Note, RSA Data Security, Inc., November 1993. Archived at perma.cc/2LMN-W9U8 ↩︎
Jacob Hoffman-Andrews. A Warm Welcome to ASN.1 and DER. letsencrypt.org, April 2020. Archived at perma.cc/CYT2-GPQ8 ↩︎
Lev Walkin. Question: Extensibility and Dropping Fields. lionet.info, September 2010. Archived at perma.cc/VX8E-NLH3 ↩︎
Jacqueline Xu. Online migrations at scale. stripe.com, February 2017. Archived at perma.cc/X59W-DK7Y ↩︎
Geoffrey Litt, Peter van Hardenberg, and Orion Henry. Project Cambria: Translate your data with lenses. Technical Report, Ink & Switch, October 2020. Archived at perma.cc/WA4V-VKDB ↩︎
Pat Helland. Data on the Outside Versus Data on the Inside. At 2nd Biennial Conference on Innovative Data Systems Research (CIDR), January 2005. ↩︎
Roy Thomas Fielding. Architectural Styles and the Design of Network-Based Software Architectures. PhD Thesis, University of California, Irvine, 2000. Archived at perma.cc/LWY9-7BPE ↩︎
Roy Thomas Fielding. REST APIs must be hypertext-driven.” roy.gbiv.com, October 2008. Archived at perma.cc/M2ZW-8ATG ↩︎
OpenAPI Specification Version 3.1.0. swagger.io, February 2021. Archived at perma.cc/3S6S-K5M4 ↩︎
Michi Henning. The Rise and Fall of CORBA. Communications of the ACM, volume 51, issue 8, pages 52–57, August 2008. doi:10.1145/1378704.1378718 ↩︎
Pete Lacey. The S Stands for Simple. harmful.cat-v.org, November 2006. Archived at perma.cc/4PMK-Z9X7 ↩︎
Stefan Tilkov. Interview: Pete Lacey Criticizes Web Services. infoq.com, December 2006. Archived at perma.cc/JWF4-XY3P ↩︎
Tim Bray. The Loyal WS-Opposition. tbray.org, September 2004. Archived at perma.cc/J5Q8-69Q2 ↩︎
Andrew D. Birrell and Bruce Jay Nelson. Implementing Remote Procedure Calls. ACM Transactions on Computer Systems (TOCS), volume 2, issue 1, pages 39–59, February 1984. doi:10.1145/2080.357392 ↩︎
Jim Waldo, Geoff Wyant, Ann Wollrath, and Sam Kendall. A Note on Distributed Computing. Sun Microsystems Laboratories, Inc., Technical Report TR-94-29, November 1994. Archived at perma.cc/8LRZ-BSZR ↩︎
Steve Vinoski. Convenience over Correctness. IEEE Internet Computing, volume 12, issue 4, pages 89–92, July 2008. doi:10.1109/MIC.2008.75 ↩︎
Brandur Leach. Designing robust and predictable APIs with idempotency. stripe.com, February 2017. Archived at perma.cc/JD22-XZQT ↩︎
Sam Rose. Load Balancing. samwho.dev, April 2023. Archived at perma.cc/Q7BA-9AE2 ↩︎
Troy Hunt. Your API versioning is wrong, which is why I decided to do it 3 different wrong ways. troyhunt.com, February 2014. Archived at perma.cc/9DSW-DGR5 ↩︎
Brandur Leach. APIs as infrastructure: future-proofing Stripe with versioning. stripe.com, August 2017. Archived at perma.cc/L63K-USFW ↩︎
Alexandre Alves, Assaf Arkin, Sid Askary, et al. Web Services Business Process Execution Language Version 2.0. docs.oasis-open.org, April 2007. ↩︎
What is a Temporal Service? docs.temporal.io, 2024. Archived at perma.cc/32P3-CJ9V ↩︎
Stephan Ewen. Why we built Restate. restate.dev, August 2023. Archived at perma.cc/BJJ2-X75K ↩︎
Keith Tenzer and Joshua Smith. Idempotency and Durable Execution. temporal.io, February 2024. Archived at perma.cc/9LGW-PCLU ↩︎
What is a Temporal Workflow? docs.temporal.io, 2024. Archived at perma.cc/B5C5-Y396 ↩︎ ↩︎
Jack Kleeman. Solving durable execution’s immutability problem. restate.dev, February 2024. Archived at perma.cc/G55L-EYH5 ↩︎
Srinath Perera. Exploring Event-Driven Architecture: A Beginner’s Guide for Cloud Native Developers. wso2.com, August 2023. Archived at archive.org ↩︎
Philip A. Bernstein, Sergey Bykov, Alan Geller, Gabriel Kliot, and Jorgen Thelin. Orleans: Distributed Virtual Actors for Programmability and Scalability. Microsoft Research Technical Report MSR-TR-2014-41, March 2014. Archived at perma.cc/PD3U-WDMF ↩︎
II 分布式数据
一个成功的技术,现实的优先级必须高于公关,你可以糊弄别人,但糊弄不了自然规律。
—— 罗杰斯委员会报告(1986)
在本书的 第一部分 中,我们讨论了数据系统的各个方面,但仅限于数据存储在单台机器上的情况。 现在我们到了 第二部分,进入更高的层次,并提出一个问题:如果 多台机器 参与数据的存储和检索,会发生什么?
你可能会出于各种各样的原因,希望将数据库分布到多台机器上:
- 可伸缩性
- 如果你的数据量、读取负载、写入负载超出单台机器的处理能力,可以将负载分散到多台计算机上。
- 容错 / 高可用性
- 如果你的应用需要在单台机器(或多台机器,网络或整个数据中心)出现故障的情况下仍然能继续工作,则可使用多台机器,以提供冗余。一台故障时,另一台可以接管。
- 延迟
- 如果在世界各地都有用户,你也许会考虑在全球范围部署多个服务器,从而每个用户可以从地理上最近的数据中心获取服务,避免了等待网络数据包穿越半个世界。
伸缩至更高的负载
如果你需要的只是伸缩至更高的 负载(load),最简单的方法就是购买更强大的机器(有时称为 垂直伸缩,即 vertical scaling,或 向上伸缩,即 scale up)。许多处理器,内存和磁盘可以在同一个操作系统下相互连接,快速的相互连接允许任意处理器访问内存或磁盘的任意部分。在这种 共享内存架构(shared-memory architecture) 中,所有的组件都可以看作一台单独的机器。
在大型机中,尽管任意处理器都可以访问内存的任意部分,但总有一些内存区域与一些处理器更接近(称为 非均匀内存访问(nonuniform memory access, NUMA) 1)。为了有效利用这种架构特性,需要对处理进行细分,以便每个处理器主要访问临近的内存,这意味着即使表面上看起来只有一台机器在运行,分区(partitioning) 仍然是必要的。
共享内存方法的问题在于,成本增长速度快于线性增长:一台有着双倍处理器数量,双倍内存大小,双倍磁盘容量的机器,通常成本会远远超过原来的两倍。而且可能因为存在瓶颈,并不足以处理双倍的载荷。
共享内存架构可以提供有限的容错能力,高端机器可以使用热插拔的组件(不关机更换磁盘,内存模块,甚至处理器)—— 但它必然囿于单个地理位置的桎梏。
另一种方法是 共享磁盘架构(shared-disk architecture),它使用多台具有独立处理器和内存的机器,但将数据存储在机器之间共享的磁盘阵列上,这些磁盘通过快速网络连接。这种架构用于某些数据仓库,但竞争和锁定的开销限制了共享磁盘方法的可伸缩性 2。
网络附属存储(Network Attached Storage, NAS),或 存储区网络(Storage Area Network, SAN)
无共享架构
相比之下,无共享架构 3(shared-nothing architecture,有时被称为 水平伸缩,即 horizontal scaling,或 向外伸缩,即 scaling out)已经相当普及。 在这种架构中,运行数据库软件的每台机器 / 虚拟机都称为 节点(node)。每个节点只使用各自的处理器,内存和磁盘。节点之间的任何协调,都是在软件层面使用传统网络实现的。
无共享系统不需要使用特殊的硬件,所以你可以用任意机器 —— 比如性价比最好的机器。你也许可以跨多个地理区域分布数据从而减少用户延迟,或者在损失一整个数据中心的情况下幸免于难。 随着云端虚拟机部署的出现,即使是小公司,现在无需 Google 级别的运维,也可以实现异地分布式架构。
在这一部分里,我们将重点放在无共享架构上。它不见得是所有场景的最佳选择,但它是最需要你谨慎从事的架构。 如果你的数据分布在多个节点上,你需要意识到这样一个分布式系统中约束和权衡 —— 数据库并不能魔术般地把这些东西隐藏起来。
虽然分布式无共享架构有许多优点,但它通常也会给应用带来额外的复杂度,有时也会限制你可用数据模型的表达力。 在某些情况下,一个简单的单线程程序可以比一个拥有超过 100 个 CPU 核的集群表现得更好 4。另一方面,无共享系统可以非常强大。接下来的几章,将详细讨论分布式数据会带来的问题。
复制 vs 分区
数据分布在多个节点上有两种常见的方式:
- 复制(Replication)
- 在几个不同的节点上保存数据的相同副本,可能放在不同的位置。复制提供了冗余:如果一些节点不可用,剩余的节点仍然可以提供数据服务。复制也有助于改善性能。第六章 将讨论复制。
- 分区 (Partitioning)
- 将一个大型数据库拆分成较小的子集(称为 分区,即 partitions),从而不同的分区可以指派给不同的 节点(nodes,亦称 分片,即 sharding)。第七章 将讨论分区。
复制和分区是不同的机制,但它们经常同时使用。如 图 II-1 所示。

理解了这些概念,就可以开始讨论在分布式系统中需要做出的困难抉择。第八章 将讨论 事务(Transaction),这对于了解数据系统中可能出现的各种问题,以及我们可以做些什么很有帮助。 第九章 和 第十章 将讨论分布式系统的根本局限性。
在本书的 第三部分 中,将讨论如何将多个(可能是分布式的)数据存储集成为一个更大的系统,以满足复杂的应用需求。但首先,我们来聊聊分布式的数据。
6. 复制
7. 分片
8. 事务
9. 分布式系统的麻烦
10. 一致性与共识
参考
Ulrich Drepper: “What Every Programmer Should Know About Memory,” akka‐dia.org, November 21, 2007. ↩︎
Ben Stopford: “Shared Nothing vs. Shared Disk Architectures: An Independent View,” benstopford.com, November 24, 2009. ↩︎
Michael Stonebraker: “The Case for Shared Nothing,” IEEE Database EngineeringBulletin, volume 9, number 1, pages 4–9, March 1986. ↩︎
Frank McSherry, Michael Isard, and Derek G. Murray: “Scalability! But at What COST?,” at 15th USENIX Workshop on Hot Topics in Operating Systems (HotOS),May 2015. ↩︎
6 复制

与可能出错的东西比,“不可能”出错的东西最显著的特点就是:一旦真的出错,通常就彻底玩完了。
—— 道格拉斯・亚当斯,《基本无害》(1992)
复制(replication)意味着在通过网络连接的多台机器上保留相同数据的副本。正如 “分布式与单节点系统” 中所讨论的,我们希望复制数据,可能出于以下原因:
- 使数据在地理上更接近用户(从而降低访问延迟)
- 即使系统的一部分发生故障,系统仍能继续工作(从而提高可用性)
- 增加能够处理读查询的机器数量(从而提高读取吞吐量)
本章假设数据集足够小,每台机器都能保存整个数据集的副本。在 第 7 章 中,我们将放宽这一假设,讨论单台机器无法容纳的大型数据集如何进行 分片(sharding,也称 分区,partitioning)。再往后的章节会讨论复制数据系统中可能出现的各种故障,以及应对这些故障的方法。
如果要复制的数据不随时间变化,复制就很简单:只需把数据复制到每个节点一次,便大功告成。复制的全部难点都在于处理被复制数据的 变更,这正是本章的主题。我们将讨论三类在节点之间复制变更的算法:单主复制(single-leader replication)、多主复制(multi-leader replication)和 无主复制(leaderless replication)。几乎所有分布式数据库都采用其中一种。三者各有利弊,本章将逐一详述。
复制需要考虑许多权衡,例如采用 同步复制(synchronous replication)还是 异步复制(asynchronous replication),以及如何处理失效的副本。这些往往都是数据库的配置选项;具体细节因数据库而异,但不同实现背后的基本原理大体相通。本章将讨论这些选择带来的后果。
数据库复制算得上是老生常谈:自 20 世纪 70 年代有人开始研究以来,其基本原理并没有太大变化 1,因为网络的根本约束也一直未变。即便如此,最终一致性(eventual consistency)等概念仍常常引起困惑。在 “复制延迟的问题” 中,我们会更精确地说明最终一致性,并讨论 读己之写(read-your-writes)、单调读(monotonic reads)等保证。
你可能会问:有了复制,是否还需要备份?答案是肯定的,因为二者目的不同。副本会迅速把一个节点上的写入反映到其他节点,而备份保存的是数据在过去某一时刻的快照,以便恢复到先前状态。如果不慎删除了某些数据,复制帮不上忙,因为删除操作也会传播到所有副本;要恢复这些数据,仍然需要备份。
事实上,复制与备份往往相辅相成。正如 “设置新的副本” 中将要看到的,备份有时是建立复制的一环;反过来,归档复制日志也可以成为备份流程的一部分。
有些数据库会在内部维护过去状态的不可变快照,相当于一种内置备份。不过,这意味着旧版本和当前状态要保存在同一类存储介质上。数据量很大时,把旧数据的备份放在针对低频访问优化的对象存储中,往往比放在主存储中便宜;主存储只需保留数据库的当前状态。
单主复制
每个保存数据库拷贝的节点都称为一个 副本(replica)。存在多个副本时,一个问题不可避免:如何确保所有数据最终都出现在所有副本上?
数据库的每次写入都必须由每个副本处理,否则各副本就会包含不同的数据。最常见的解决方案称为 基于领导者的复制(leader-based replication),也称 主备复制(primary-backup)或 主动/被动复制(active/passive)。其工作原理如下(见 图 6-1):
- 其中一个副本被指定为 领导者(leader,也称 主库,primary,或 源,source 2)。客户端要写入数据库时,必须把请求发给领导者;领导者首先将新数据写入本地存储。
- 其他副本称为 追随者(follower,也称 只读副本,read replica,备库,secondary,或 热备,hot standby)。领导者每次把新数据写入本地存储,也会把数据变更作为 复制日志(replication log)或 变更流(change stream)发送给所有追随者。每个追随者取得领导者的日志,按照领导者处理写入的相同顺序应用所有写入,从而更新本地的数据库副本。
- 客户端读取数据库时,可以查询领导者,也可以查询任意追随者;但只有领导者接受写入(从客户端的角度看,追随者是只读的)。

如果数据库做了分片(见 第 7 章),每个分片都有一个领导者。不同分片的领导者可以位于不同节点,但每个分片仍必须有且只有一个领导者。在 “多主复制” 中,我们将讨论另一种模型:同一分片可以同时有多个领导者。
单主复制应用极为广泛。它是 PostgreSQL、MySQL、Oracle Data Guard 3 和 SQL Server Always On 可用性组 4 等许多关系数据库的内置功能;MongoDB、DynamoDB 5 等文档数据库,Kafka 等消息代理,DRBD 等复制块设备,以及一些网络文件系统也采用这种方式。Raft 等许多共识算法同样以单个领导者为基础;CockroachDB 6、TiDB 7、etcd、RabbitMQ 法定人数队列等系统用它来实现复制,并在原领导者失效时自动选举新领导者(第 10 章 将更详细地讨论共识)。
较早的资料中可能会出现 主从复制(master–slave replication)一词。它与基于领导者的复制含义相同,但如今普遍认为这种说法具有冒犯性,应当避免使用 8。
同步复制与异步复制
复制系统的一个重要细节是,复制究竟 同步(synchronous)进行还是 异步(asynchronous)进行。(在关系数据库中,这通常是一个配置项;其他系统往往固定采用其中一种。)
设想 图 6-1 中的情形:某网站用户更新个人头像。客户端在某个时刻向领导者发出更新请求,不久后领导者收到请求;领导者随后在某个时刻把数据变更转发给追随者,并最终通知客户端更新成功。图 6-2 展示了其中一种可能的时序。

在 图 6-2 的例子中,发往追随者 1 的复制是 同步 的:领导者必须等到追随者 1 确认收到写入,才能向用户报告成功,也才能让其他客户端看到这次写入。发往追随者 2 的复制则是 异步 的:领导者发出消息,但不等待追随者响应。
图中追随者 2 处理消息前有一段明显的延迟。通常复制相当快:大多数数据库系统不到一秒便能把变更应用到追随者,但它们并不保证复制一定能在多久内完成。有时追随者可能落后领导者几分钟甚至更久,例如追随者正从失效中恢复、系统在容量极限附近运行,或节点间网络出现问题。
同步复制的优点是,追随者保证拥有与领导者一致的最新数据副本。领导者突然失效时,可以确信数据仍可从追随者取得。缺点是,如果同步追随者没有响应——无论因为崩溃、网络故障还是其他原因——写入就无法继续。领导者必须阻塞所有写入,直至同步副本重新可用。
因此,把所有追随者都设为同步并不现实:任意一个节点停机都会拖垮整个系统。实践中,数据库所谓的同步复制,通常是指 一个 追随者同步,其余追随者异步。如果同步追随者不可用或过慢,就把某个异步追随者切换为同步。这样可以保证至少有两个节点持有最新数据:领导者和一个同步追随者。这种配置有时也称为 半同步(semi-synchronous)。
有些系统会同步更新 多数 副本(例如含领导者在内的 5 个副本中更新 3 个),其余少数副本异步更新。这就是 法定人数 的一个例子,我们会在 “读写仲裁” 中进一步讨论。采用共识协议自动选举领导者的系统经常使用多数法定人数,第 10 章 将再次谈到这个问题。
有时,基于领导者的复制会配置为完全异步。如果领导者失效且无法恢复,所有尚未复制到追随者的写入都会丢失。也就是说,即使已经向客户端确认成功,写入仍不保证持久。不过,完全异步配置也有一个优点:即使所有追随者都已落后,领导者仍可继续处理写入。
削弱持久性听起来不像是划算的取舍,但异步复制依然应用广泛,尤其是在追随者很多或分布于不同地理位置时 9。我们会在 “复制延迟的问题” 中再谈这一点。
设置新的副本
有时需要设置新的追随者,也许是为了增加副本数量,也许是为了替换失效的节点。怎样才能确保新追随者拿到领导者数据的准确副本?
简单地把数据文件从一个节点复制到另一个节点通常并不够:客户端一直在向数据库写入,数据始终处于变化之中,普通的文件复制会在不同时间点读到数据库的不同部分,所得结果可能毫无意义。
可以锁住数据库,让磁盘上的文件保持一致,但这样数据库将无法接受写入,违背了高可用的目标。好在设置追随者通常不需要停机。从概念上讲,其过程如下:
- 取得领导者数据库在某个时刻的一致快照;如果可能,不要锁住整个数据库。大多数数据库都提供这一功能,因为备份同样需要它。有些情况下需要借助第三方工具,例如 MySQL 的 Percona XtraBackup。
- 把快照复制到新的追随者节点。
- 追随者连接领导者,请求从快照生成之后发生的所有数据变更。这要求快照与领导者复制日志中的准确位置相关联。不同系统对这个位置有不同称呼:PostgreSQL 称之为 日志序列号(log sequence number,LSN);MySQL 则有 binlog 位点(binlog coordinates)和 全局事务标识符(global transaction identifiers,GTIDs)两套机制。
- 追随者处理完快照之后积压的数据变更时,就称它已经 赶上进度。此后,它可以继续随时处理领导者产生的数据变更。
设置追随者的实际步骤因数据库而异。有些系统完全自动完成这一过程,另一些系统则需要管理员手工执行一套颇为晦涩的多步骤流程。
还可以把复制日志归档到对象存储;再定期把整个数据库的快照保存到对象存储,就形成了一套很好的数据库备份与灾难恢复方案。建立新追随者时,步骤 1 和 2 也可以通过从对象存储下载这些文件来完成。例如,WAL-G 为 PostgreSQL、MySQL 和 SQL Server 提供了这种功能,Litestream 则为 SQLite 提供了类似功能。
对象存储不只能用于归档。许多数据库已经开始用 Amazon Web Services S3、Google Cloud Storage、Azure Blob Storage 等对象存储为在线查询提供数据。把数据库数据存入对象存储有很多好处:
- 对象存储比其他云存储方案便宜。云数据库因而可以把查询频率较低的数据放到成本更低、延迟更高的存储中,同时用内存、SSD 和 NVMe 保存工作集。
- 对象存储还提供多可用区、双地区或多地区复制,并给出很高的持久性保证;数据库也由此可以避开跨可用区网络费用。
- 数据库可以利用对象存储的 条件写入 功能——本质上是一种 比较并设置(CAS)操作——来实现事务和领导者选举 10 11。
- 把多个数据库的数据放在同一对象存储中,可以简化数据集成,尤其是在使用 Apache Parquet、Apache Iceberg 等开放格式时。
这些好处把事务、领导者选举和复制的责任转交给对象存储,从而大幅简化数据库架构。
以对象存储实现复制的系统也必须面对一些权衡。尤其是,对象存储的读写延迟远高于本地磁盘或 EBS 之类的虚拟块设备。许多云服务商还按 API 调用次数收费,迫使系统把读写合并成批次以降低成本,而批处理又会进一步增加延迟。此外,许多对象存储没有标准的文件系统接口,未集成对象存储的系统便无法直接利用它。用户空间文件系统(FUSE)等接口允许运维人员把对象存储桶挂载成文件系统,应用程序不必知道数据实际位于对象存储中。然而,许多面向对象存储的 FUSE 接口并不支持非顺序写入、符号链接等 POSIX 功能,而系统可能依赖这些功能。
不同系统处理这些权衡的方式各不相同。有些采用 分层存储 架构,把不常访问的数据放到对象存储,把新数据或常用数据放在 SSD、NVMe 乃至内存等更快的存储介质上。另一些系统以对象存储作为主存储层,但另用 Amazon EBS、Neon Safekeepers 12 等低延迟存储系统保存 WAL。近来,一些系统走得更远,采用 零磁盘架构(ZDA):所有数据都持久化到对象存储,磁盘和内存只用作缓存。节点因此无需保存持久状态,运维也大为简化。WarpStream、Confluent Freight、Buf 的 Bufstream 和 Redpanda Serverless 都是采用零磁盘架构构建的 Kafka 兼容系统。几乎所有现代云数据仓库也采用类似架构,向量搜索引擎 Turbopuffer 和云原生 LSM 存储引擎 SlateDB 亦是如此。
处理节点故障
系统中的任何节点都可能停机,既可能是故障意外所致,也可能是计划内维护,例如重启机器以安装内核安全补丁。能够在服务不中断的情况下逐个重启节点,对运维和维护大有裨益。因此,我们的目标是:即使个别节点失效,整个系统仍能继续运行,并尽可能减小节点停机的影响。
如何用基于领导者的复制实现高可用?
追随者失效:追赶恢复
每个追随者都会在本地磁盘上记录从领导者收到的数据变更。如果追随者崩溃后重启,或领导者与追随者之间的网络暂时中断,恢复起来相对容易:追随者可以从日志中得知故障发生前处理的最后一个事务。它随后连接领导者,请求自己断开期间发生的所有数据变更。应用完这些变更后,它便赶上领导者,可以像以前一样继续接收数据变更流。
追随者恢复在概念上很简单,性能上却可能很棘手。如果数据库写入吞吐量很高,或追随者离线很久,需要追赶的写入可能非常多。追赶期间,正在恢复的追随者和领导者都会承受很高负载——领导者还要把积压的写入发送给追随者。
所有追随者确认处理完某段写入日志后,领导者便可将其删除。但如果某个追随者长时间不可用,领导者必须作出选择:要么一直保留日志,等追随者恢复并赶上进度,但要冒领导者磁盘空间耗尽的风险;要么删除尚未得到该追随者确认的日志,这样追随者恢复上线后就无法靠日志追赶,只能从备份恢复。
领导者失效:故障切换
领导者失效处理起来更加棘手:必须把一个追随者提升为新领导者,重新配置客户端以便把写入发给新领导者,并让其他追随者开始消费新领导者的数据变更。这个过程称为 故障切换(failover)。
故障切换可以手工完成——通知管理员领导者已经失效,再由管理员执行必要步骤选出新领导者;也可以自动完成。自动故障切换通常包括以下步骤:
- 确认领导者失效。 可能出问题的地方很多:崩溃、断电、网络故障等等。没有万无一失的办法判断究竟出了什么问题,因此大多数系统只是使用超时:节点之间频繁往返传递消息,如果某个节点在一段时间内(例如 30 秒)没有响应,就认为它已经失效。(因计划维护而主动下线领导者则不适用这一规则。)
- 选择新的领导者。 可以通过选举完成(由剩余副本中的多数选出领导者),也可以由事先指定的 控制器节点 任命 13。最合适的候选者通常是从旧领导者收到数据变更最多、数据最新的副本,这样可以尽量减少数据损失。让所有节点就新领导者达成一致是一个共识问题,第 10 章 将详细讨论。
- 重新配置系统以使用新领导者。 客户端现在必须把写请求发给新领导者(参见 “请求路由”)。如果旧领导者恢复上线,它可能仍以为自己是领导者,没有意识到其他副本已经迫使它退位。系统必须保证旧领导者转为追随者,并承认新领导者。
故障切换过程中有很多地方可能出错:
- 如果使用异步复制,新领导者可能没有收到旧领导者失效前的全部写入。选出新领导者后,原领导者若重新加入集群,那些未复制的写入该怎么办?与此同时,新领导者可能已经收到与之冲突的写入。最常见的办法是直接丢弃旧领导者尚未复制的写入,这意味着你原以为已经提交的写入其实并未持久保存。
- 如果数据库内容还需要与数据库之外的存储系统协调,丢弃写入尤其危险。例如,GitHub 曾发生过一起事故 14:一个数据过时的 MySQL 追随者被提升为领导者。数据库用自增计数器为新行分配主键;新领导者的计数器落后于旧领导者,因而重复使用了旧领导者已经分配过的一些主键。这些主键同时用于 Redis 存储,主键重用造成 MySQL 与 Redis 数据不一致,最终使一些私有数据泄露给了错误的用户。
- 在某些故障场景下(见 第 9 章),可能有两个节点都认为自己是领导者。这种情况称为 脑裂(split brain),非常危险:如果两个领导者都接受写入,而系统又没有冲突解决流程(参见 “多主复制”),数据很可能丢失或损坏。有些系统设有保险机制,一旦发现两个领导者便关闭其中一个节点;但机制设计不当时,也可能把两个节点都关闭 15。而且,等系统发现脑裂并关闭旧节点时,可能已经为时过晚,数据早已损坏。
- 宣布领导者失效前,超时应该设为多长?超时越长,领导者确实失效时恢复所需的时间就越长;超时太短,又容易触发不必要的故障切换。例如,短暂的负载尖峰可能使节点响应时间超过超时值,网络抖动也可能延迟数据包。如果系统已经饱受高负载或网络问题困扰,不必要的故障切换只会让情况更糟。
通过限制或关闭旧领导者来防止脑裂,称为 栅栏(fencing),更形象的说法是 爆彼之头(Shoot The Other Node In The Head,STONITH)。“分布式锁和租约” 将更详细地讨论栅栏机制。
这些问题没有简单的解决方案。因此,即使软件支持自动故障切换,一些运维团队还是更愿意手工执行。
故障切换最重要的是选出一个数据最新的追随者作为新领导者。采用同步或半同步复制时,应选择旧领导者确认写入前所等待的那个追随者;采用异步复制时,则可以选择日志序列号最大的追随者。这样能尽量减少故障切换时的数据损失:丢失几分之一秒内的写入或许尚可容忍,选中一个落后数天的追随者却可能是灾难性的。
节点失效、不可靠的网络,以及围绕副本一致性、持久性、可用性和延迟所作的权衡,都是分布式系统中的根本问题。第 9 章 和 第 10 章 将进一步深入讨论。
复制日志的实现
基于领导者的复制在底层究竟如何工作?实践中采用了几种不同的复制方式,下面逐一简要介绍。
基于语句的复制
最简单的情况下,领导者会记录自己执行的每个写入请求(即 语句),并把这份语句日志发送给追随者。对于关系数据库,这意味着每条 INSERT、UPDATE 或 DELETE 语句都会转发给追随者;每个追随者解析并执行这条 SQL 语句,就像它直接来自客户端一样。
虽然听起来很合理,但这种复制方式有许多可能出错的地方:
- 任何调用非确定性函数的语句,都可能在各副本上产生不同的值,例如用
NOW()取得当前日期和时间,或用RAND()取得随机数。 - 如果语句使用自增列,或依赖数据库中的现有数据(例如
UPDATE … WHERE <some condition>),就必须在每个副本上按完全相同的顺序执行,否则可能产生不同结果。有多个事务并发执行时,这会成为限制。 - 带有副作用的语句(例如触发器、存储过程、用户定义函数),可能在各副本上产生不同的副作用,除非这些副作用完全确定。
这些问题可以绕开。例如,领导者在记录语句时,可以用固定的返回值替换非确定性函数调用,从而让所有追随者得到相同的值。按固定顺序执行确定性语句,与 “事件溯源与 CQRS” 中介绍的事件溯源模型很相似。这种方法也称为 状态机复制(state machine replication);“使用共享日志” 将讨论其理论基础。
MySQL 5.1 以前使用基于语句的复制。由于日志相当紧凑,如今有时仍会采用这种方式;不过默认情况下,只要语句中存在任何非确定性,MySQL 就会切换到稍后介绍的基于行的复制。VoltDB 也采用基于语句的复制,并要求事务必须是确定性的,以保证安全 16。然而,实践中很难确保确定性,因此许多数据库更倾向于其他复制方式。
预写日志(WAL)传输
我们在 第 4 章 中看到,B 树存储引擎需要预写日志才能可靠工作:每次修改都先写入 WAL,以便崩溃后把树恢复到一致状态。WAL 包含把索引和堆恢复到一致状态所需的全部信息,因此同一份日志也能用来在另一个节点上建立副本:领导者除了把日志写入磁盘,还通过网络把它发送给追随者。追随者处理日志后,就会构建出与领导者完全相同的文件副本。
PostgreSQL、Oracle 等数据库采用这种复制方式 17 18。其主要缺点是,日志在非常低的层次描述数据:WAL 记录了哪个磁盘块中的哪些字节发生变化。因此,复制与存储引擎紧密耦合。数据库从一个版本升级到另一个版本、存储格式随之改变时,通常无法在领导者和追随者上运行不同版本的数据库软件。
这看起来只是一个微不足道的实现细节,却可能给运维带来巨大影响。如果复制协议允许追随者运行比领导者更新的软件版本,就可以先升级追随者,再执行故障切换,让一个升级后的节点成为新领导者,从而实现数据库软件的零停机升级。如果复制协议不允许版本不一致——WAL 传输往往如此——这类升级就需要停机。
逻辑(基于行)日志复制
另一种方法是让复制和存储引擎使用不同的日志格式,从而使复制日志与存储引擎的内部实现解耦。这种复制日志称为 逻辑日志(logical log),以区别于存储引擎的(物理,physical)数据表示。
关系数据库的逻辑日志通常由一系列记录组成,以行的粒度描述对数据库表的写入:
- 插入一行时,日志包含所有列的新值。
- 删除一行时,日志包含足以唯一标识被删行的信息,通常是主键;如果表没有主键,则需要记录所有列的旧值。
- 更新一行时,日志包含足以唯一标识被更新行的信息,以及所有列的新值(或者至少包含所有发生变化的列的新值)。
修改多行的事务会生成多条这样的日志记录,随后再跟一条表示事务已经提交的记录。MySQL 配置为基于行的复制时,除了 WAL 之外,还会维护一份称为 binlog 的独立逻辑复制日志。PostgreSQL 则把物理 WAL 解码成行插入、更新和删除事件,以实现逻辑复制 19。
由于逻辑日志与存储引擎的内部实现解耦,更容易保持向后兼容,因而领导者与追随者可以运行不同版本的数据库软件,也就能以极少的停机时间升级到新版本 20。
逻辑日志格式也更容易由外部应用程序解析。如果要把数据库内容发送到外部系统,例如送入数据仓库做离线分析,或构建自定义索引和缓存 21,这一点会很有用。这种技术称为 变更数据捕获(change data capture,CDC),我们会在 “变更数据捕获” 中再次谈到它。
复制延迟的问题
容忍节点失效只是使用复制的一个原因。正如 “分布式与单节点系统” 中提到的,其他原因还包括可伸缩性(处理单台机器无法承受的请求量)和延迟(把副本放在地理上更靠近用户的位置)。
基于领导者的复制要求所有写入经过一个节点,但只读查询可以发往任意副本。对于读多写少的工作负载——在线服务往往如此——有一种很有吸引力的方案:建立许多追随者,把读请求分散到这些追随者上。这样既能减轻领导者的负载,也能由附近的副本处理读请求。
在这种 读扩展 架构中,只需增加追随者,便可提高只读请求的处理能力。不过,这种办法实际上只适用于异步复制。如果尝试同步复制到所有追随者,任意一个节点失效或网络中断都会让整个系统无法写入。节点越多,越可能有某个节点停机,因此完全同步的配置会极不可靠。
不幸的是,应用程序从 异步(asynchronous)追随者读取时,如果追随者落后,就可能看到过时的信息。数据库于是显得不一致:同时在领导者和追随者上执行同一查询,结果可能不同,因为追随者尚未反映所有写入。这种不一致只是暂时的——如果停止写入并等待一段时间,追随者最终会赶上领导者,恢复一致。因此,这种现象称为 最终一致性(eventual consistency)22。
“最终”一词有意保持模糊:一般而言,副本能落后多久并没有上限。正常运行时,从写入发生在领导者上,到变更反映在追随者上,两者之间的延迟——即 复制延迟——可能只有几分之一秒,在实践中难以察觉。但当系统在容量极限附近运行或网络出现问题时,延迟很容易增至几秒甚至几分钟。
延迟一旦大到这种程度,由此造成的不一致就不再只是理论问题,而会成为应用程序面临的真实问题。本节将重点介绍复制延迟容易引发的三类问题,并概述一些解决办法。
读己之写
许多应用程序允许用户提交数据,随后查看自己提交的内容。它可能是客户数据库中的一条记录、讨论主题下的一条评论,或其他类似内容。新数据必须写入领导者,但用户查看时可以从追随者读取。如果数据经常读取、很少写入,这种做法尤其合适。
异步复制在这里会产生问题,如 图 6-3 所示:用户刚写入数据不久便查看它时,新数据可能尚未到达该副本。在用户看来,自己刚刚提交的数据仿佛丢失了,当然会感到不满。

这种情况下需要 写后读一致性(read-after-write consistency),也称 读己之写一致性(read-your-writes consistency)23。它保证用户重新加载页面时,总能看到自己提交的更新。至于其他用户则不作保证:他们的更新可能过一段时间才会出现。但至少用户可以确信,自己的输入已经正确保存。
如何在基于领导者的复制系统中实现写后读一致性?有多种办法,例如:
- 读取用户可能修改过的内容时,从领导者或同步更新的追随者读取;其他内容则从异步更新的追随者读取。这要求系统无需实际查询,就能判断某项内容是否可能被修改。例如,社交网络中的个人资料通常只能由本人编辑。因此可以制定一条简单规则:用户自己的资料总是从领导者读取,其他用户的资料则从追随者读取。
- 如果应用程序中的大部分内容都可能由用户编辑,上述办法就没有效果,因为几乎所有内容都得从领导者读取,读扩展也就失去了意义。这时可以采用其他标准来决定是否从领导者读取。例如,记录最近一次更新时间,此后一分钟内的所有读取都发往领导者 25。也可以监控追随者的复制延迟,不向落后领导者超过一分钟的追随者发送查询。
- 客户端可以记住自己最近一次写入的时间戳,系统再确保为该用户处理读取的副本至少已经反映到这个时间戳。如果副本不够新,就换一个副本处理读取,或让查询等待该副本赶上进度 26。这个时间戳既可以是 逻辑时间戳(例如表示写入顺序的日志序列号),也可以来自实际的系统时钟;后一种情况下,时钟必须准确同步,参见 “不可靠的时钟”。
- 如果副本分布于多个地区(为了靠近用户或提高可用性),还会增加一层复杂性:凡是必须由领导者处理的请求,都要路由到领导者所在的地区。
同一用户通过多个设备访问服务时,例如同时使用桌面浏览器和移动应用,还会出现另一种复杂情况。这时可能需要提供 跨设备 写后读一致性:用户在一台设备上输入信息,随后在另一台设备上查看时,应当看到刚才输入的内容。
还需要考虑以下问题:
- 依赖“记住用户最近一次更新时间戳”的方法会变得更难,因为一台设备上运行的代码不知道另一台设备做了哪些更新。这些元数据需要集中保存。
- 如果副本分布在不同地区,来自不同设备的连接不保证会路由到同一地区。例如,用户的台式机使用家庭宽带,手机使用蜂窝网络,两台设备的网络路径可能完全不同。如果方案要求从领导者读取,可能首先要把该用户所有设备发出的请求都路由到同一地区。
本书用 地区(region)表示同一地理位置上的一个或多个数据中心。云服务商通常会在同一地理区域设置多个数据中心,每个数据中心称为一个 可用区(availability zone),简称 区(zone)。因此,一个云地区由多个可用区组成。每个可用区都是位于独立物理设施中的数据中心,有自己的供电、制冷等基础设施。
同一地区内的可用区之间由高速网络连接,延迟足够低,因此大多数分布式系统可以把节点分散在多个可用区运行,就像它们位于同一个区一样。多可用区配置可以抵御某个可用区整体下线,却无法抵御一个地区内所有可用区均不可用的地区级中断。要在地区级中断时继续运行,分布式系统必须跨多个地区部署,而这可能带来更高延迟、更低吞吐量和更高的云网络费用。我们将在 “多主复制拓扑” 中进一步讨论这些权衡。这里暂且记住:本书所说的地区,是同一地理位置上的一组可用区或数据中心。
单调读
从异步追随者读取时可能发生的第二种异常,是用户可能会看到 时光倒流。
用户连续几次从不同副本读取时,就可能发生这种情况。例如,图 6-4 中,用户 2345 连续执行两次相同查询:第一次查询复制延迟较小的追随者,第二次查询延迟更大的追随者。(用户刷新网页、而每个请求被随机路由到不同服务器时,这种场景很容易出现。)第一次查询返回了用户 1234 最近添加的评论,第二次却什么也没返回,因为落后的追随者还没有收到这次写入。实际上,第二次查询观察到的系统状态比第一次更早。如果第一次查询本就没有结果,倒也问题不大,因为用户 2345 多半不知道用户 1234 刚刚添加过评论;但如果评论先出现又消失,就非常令人困惑。

单调读 22 保证这种异常不会发生。它弱于强一致性,却强于最终一致性。读取数据时仍可能看到旧值;单调读只保证同一用户顺序执行多次读取时,不会看到时间倒退——一旦读到较新的数据,以后就不会再读到更旧的数据。
实现单调读的一种办法,是确保每个用户始终从同一个副本读取(不同用户可以选择不同副本)。例如,可以根据用户 ID 的哈希选择副本,而不是随机选择。如果该副本失效,则需要把用户的查询重新路由到其他副本。
一致前缀读
第三种复制延迟异常违反了因果关系。设想 Poons 先生和 Cake 夫人有下面这段简短对话:
- Poons 先生
- Cake 夫人,你能看到多远的未来?
- Cake 夫人
- 通常大约十秒钟,Poons 先生。
这两句话之间存在因果依赖:Cake 夫人听到 Poons 先生的问题,然后作出回答。
现在设想第三个人通过追随者旁听这段对话。Cake 夫人的话经过复制延迟较小的追随者,Poons 先生的话经过延迟更大的追随者(见 图 6-5)。于是,这位旁听者会听到:
- Cake 夫人
- 通常大约十秒钟,Poons 先生。
- Poons 先生
- Cake 夫人,你能看到多远的未来?
在旁听者看来,Cake 夫人还没听到 Poons 先生提问,就已经回答了问题。这种通灵能力令人印象深刻,却也十分费解 27。

防止这种异常需要另一种保证:一致前缀读(consistent prefix reads)22。它保证,如果一系列写入按某个顺序发生,那么任何人读取这些写入时,也会看到它们以相同顺序出现。
这在分片(分区)数据库中尤其容易成为问题,我们将在 第 7 章 讨论这类数据库。如果数据库始终按相同顺序应用写入,读取就总会看到一致前缀,这种异常也不会发生。然而,在许多分布式数据库中,不同分片彼此独立运行,没有全局写入顺序。用户读取数据库时,可能看到一部分处于较旧状态,另一部分却处于较新状态。
一种解决办法是确保存在因果关系的写入落在同一个分片,但有些应用程序无法高效做到这一点。还有一些算法会显式跟踪因果依赖,我们会在 “先发生”关系与并发 中再次讨论。
复制延迟的解决方案
使用最终一致的系统时,值得认真考虑:如果复制延迟增加到几分钟甚至几小时,应用程序会怎样表现?如果答案是“没有影响”,那当然很好;如果会给用户带来糟糕体验,就必须把系统设计成能够提供写后读之类的更强保证。复制本来是异步的,却假装它是同步的,迟早会酿成问题。
如前所述,应用程序可以提供比底层数据库更强的保证,例如把某些读取发往领导者或同步更新的追随者。不过,在应用程序代码中处理这些问题既复杂又容易出错。
对应用程序开发者而言,最简单的编程模型,是选择一个能为副本提供强一致性保证(例如线性一致性,见 第 10 章)和 ACID 事务(见 第 8 章)的数据库。这样就可以基本忽略复制带来的挑战,把数据库看作只有一个节点。2010 年代初兴起的 NoSQL 运动曾宣扬一种观点:这些特性会限制可伸缩性,大规模系统不得不接受最终一致性。
此后,许多数据库开始在提供强一致性和事务的同时,保留分布式数据库在容错、高可用和可伸缩性方面的优势。正如 “关系模型与文档模型” 中提到的,为与 NoSQL 区分,这一趋势称为 NewSQL(尽管重点并不在 SQL 本身,而在可伸缩事务管理的新方法)。
如今虽已有可伸缩的强一致分布式数据库,一些应用程序仍有充分理由选择一致性保证较弱的其他复制方式:面对网络中断时,它们的韧性可能更强,开销也低于事务型系统。本章余下部分将继续探讨这些方法。
多主复制
到目前为止,本章只讨论了使用单个领导者的复制架构。虽然这是常见做法,但还有一些值得关注的选择。
单主复制有一个主要缺点:所有写入都必须经过唯一的领导者。无论出于什么原因,只要连接不上领导者——例如客户端与领导者之间的网络中断——就无法写入数据库。
单主复制模型可以自然地扩展为允许多个节点接受写入。复制仍以同样方式进行:每个处理写入的节点都必须把数据变更转发给其他所有节点。我们把这种配置称为 多主复制(multi-leader replication),也称 主动/主动复制(active/active)或 双向复制(bidirectional replication)。在这种配置中,每个领导者同时也是其他领导者的追随者。
与单主复制一样,多主复制也可以选择同步或异步。假设有两个领导者 A 和 B,现在要向 A 写入。如果写入必须从 A 同步复制到 B,那么两者之间的网络一旦中断,在网络恢复前就无法向 A 写入。这种同步多主复制提供的模型与单主复制极为相似:也就是说,这等同于把 B 设为领导者,由 A 把所有写请求转发给 B 执行。
因此,本节不再深入讨论同步多主复制,而把它视为等同于单主复制。以下讨论集中于异步多主复制:即使某个领导者与其他领导者之间的连接中断,它仍可处理写入。
跨地域运行
在单个地区内使用多主配置通常没有多少意义,因为所得好处很少能抵消额外的复杂性。不过,在某些场景中,这种配置确实合理。
设想一个数据库在多个地区都有副本,也许是为了在整个地区失效时仍能运行,也许是为了在地理上更接近用户。这种部署称为 地理分布式(geographically distributed)、跨地域分布式(geo-distributed)或 跨地域复制(geo-replicated)。采用单主复制时,领导者必须位于其中 一个 地区,所有写入都要经过该地区。
在多主配置中,每个 地区都可以有一个领导者。图 6-6 展示了这种架构:每个地区内部使用常规的领导者—追随者复制(追随者可以位于与领导者不同的可用区);地区之间,则由各地区的领导者把变更复制给其他地区的领导者。

下面比较单主与多主配置在多地区部署中的表现:
- 性能
- 在单主配置中,每次写入都必须通过互联网发往领导者所在的地区。这可能显著增加写入延迟,甚至违背多地区部署的初衷。在多主配置中,每次写入都能在本地地区处理,再异步复制到其他地区。地区间的网络延迟因而对用户不可见,感知到的性能可能更好。
- 容忍地区停机
- 在单主配置中,如果领导者所在的地区不可用,可以通过故障切换把另一个地区的追随者提升为领导者。在多主配置中,各地区可以彼此独立地继续运行;离线地区恢复上线后,复制会赶上进度。
- 容忍网络问题
- 即使地区之间使用专用连接,其流量也可能不如同一地区内不同可用区之间、或同一可用区内部的流量可靠。单主配置对地区间链路的问题极为敏感:一个地区的客户端要向另一个地区的领导者写入,就必须通过这条链路发出请求,并等待响应后才能完成操作。
异步复制的多主配置更能容忍网络问题:网络暂时中断期间,每个地区的领导者仍可独立处理写入。
- 一致性
- 单主系统可以提供可串行化事务等强一致性保证,我们会在 第 8 章 讨论。多主系统最大的缺点,是它所能提供的一致性要弱得多。例如,无法保证银行账户余额不会变成负数,也无法保证用户名唯一:不同领导者完全可能分别处理单独看来合法的写入(从账户支付一笔钱、注册某个用户名),但把它们与另一个领导者上的写入合在一起,就违反了约束。
这是分布式系统的一项根本限制 28。如果必须强制执行这类约束,最好采用单主系统。不过,正如 “处理写入冲突” 中将要看到的,对于不需要这类约束的大量应用程序,多主系统仍能提供有用的一致性属性。
多主复制不如单主复制常见,但 MySQL、Oracle、SQL Server、YugabyteDB 等许多数据库仍提供支持。有时它以外部附加组件的形式出现,例如 Redis Enterprise、EDB Postgres Distributed 和 pglogical 29。
许多数据库的多主复制都是后来加装的功能,因而常有细微的配置陷阱,也会与其他数据库功能产生出人意料的相互作用。例如,自增键、触发器和完整性约束都可能带来问题。因此,多主复制往往被视为应当尽量避开的危险领域 30。
多主复制拓扑
复制拓扑(replication topology)描述写入从一个节点传播到另一个节点时所经过的通信路径。如果只有两个领导者,如 图 6-9 所示,那么只有一种合理的拓扑:领导者 1 必须把所有写入发送给领导者 2,反之亦然。领导者超过两个时,则有多种拓扑可供选择。图 6-7 给出了三个例子。

最通用的是 图 6-7(c) 所示的 全对全(all-to-all)拓扑,每个领导者都会把写入发送给其他所有领导者。不过,实际系统也会采用限制更多的拓扑。例如在 环形拓扑(circular topology)中,每个节点从一个节点接收写入,再把这些写入连同自己的写入转发给另一个节点。另一种常见拓扑呈 星形(star topology):指定一个根节点,由它把写入转发给所有其他节点。星形拓扑还可以推广成树形。
不要把星形网络拓扑与 星型模式 混为一谈;后者描述的是数据模型结构,参见 “星型与雪花型:分析模式”。
在环形和星形拓扑中,一次写入可能要经过多个节点才能到达所有副本。因此,节点必须转发从其他节点收到的数据变更。为避免无限复制循环,每个节点都有唯一标识符;复制日志中的每次写入都会标记自己经过的全部节点 31。节点收到带有自身标识符的数据变更时,会直接忽略它,因为这说明自己已经处理过该变更。
不同拓扑的问题
环形和星形拓扑有一个问题:只要一个节点失效,就可能中断其他节点之间的复制消息流;在该节点修复前,其他节点无法相互通信。虽然可以重配拓扑以绕过失效节点,但大多数部署都需要手工完成这一操作。连接更密集的拓扑(例如全对全)容错性更好,因为消息可以沿不同路径传播,避开单点故障。
另一方面,全对全拓扑也有问题。尤其是,不同网络链路的速度可能不同(例如受到网络拥塞影响),导致某些复制消息“超越”另一些消息,如 图 6-8 所示。

在 图 6-8 中,客户端 A 在领导者 1 上向表中插入一行,客户端 B 随后在领导者 3 上更新该行。但领导者 2 可能以相反顺序收到这两次写入:先收到更新(在它看来,这是要更新数据库中并不存在的行),稍后才收到本应先发生的插入。
这也是一个因果关系问题,与 “一致前缀读” 中看到的情况相似。更新依赖先前的插入,因此必须保证所有节点先处理插入,再处理更新。仅仅给每次写入附加时间戳并不够,因为不能相信各节点的时钟同步得足以让领导者 2 正确排列这些事件(见 第 9 章)。
要正确排列这些事件,可以采用本章稍后介绍的 版本向量(version vector;见 “检测并发写入”)。不过,许多多主复制系统并未使用可靠的更新排序技术,因而容易遇到 图 6-8 所示的问题。如果使用多主复制,应当了解这些风险,仔细阅读文档,并充分测试数据库,确认它确实提供了你以为它会提供的保证。
同步引擎与本地优先软件
应用程序需要在断网时继续工作,是另一个适合多主复制的场景。
以手机、笔记本电脑和其他设备上的日历应用为例。无论设备有没有联网,你都需要随时查看会议(发出读请求)和添加会议(发出写请求)。离线期间所作的变更,应在设备下次上线时与服务器及其他设备同步。
这种情况下,每台设备都有一个充当领导者的本地数据库副本,可以接受写入;各设备上的日历副本之间则通过异步多主复制过程进行同步。复制延迟可能长达数小时甚至数天,取决于设备何时重新联网。
从架构上看,这种配置相当于把地区间多主复制推到极致:每台设备都是一个“地区”,它们之间的网络连接极不可靠。
实时协作、离线优先和本地优先应用
此外,许多现代 Web 应用还提供 实时协作 功能,例如用于文档和电子表格的 Google Docs 与 Sheets、用于图形设计的 Figma,以及用于项目管理的 Linear。这些应用之所以响应迅速,是因为用户输入会立即反映在界面上,无需等待与服务器的一次网络往返;一位用户所作的编辑也会以很低的延迟呈现给协作者 32 33 34。
这同样形成了多主架构:每个打开共享文件的浏览器标签页都是一个副本,对文件所作的更新会异步复制到其他打开该文件的用户设备上。即使应用程序不支持离线编辑,只要多个用户可以不等服务器响应便各自编辑,它就已经是多主系统。
离线编辑与实时协作需要相似的复制基础设施:应用程序必须捕获用户对文件作出的所有变更,在线时立即发给协作者,离线时则先保存在本地,稍后再发送。同时,应用程序还要接收协作者的变更,将其合并到用户的本地文件副本,并更新界面以显示最新版本。多个用户并发修改文件时,还可能需要用冲突解决逻辑合并这些变更。
支持这一过程的软件库称为 同步引擎(sync engine)。这个想法由来已久,但“同步引擎”一词近来才受到关注 35 36 37。允许用户离线时继续编辑文件的应用程序称为 离线优先(offline-first)应用 38,它可以用同步引擎来实现。本地优先软件(local-first software)则不仅要支持离线优先,还要保证即使软件开发者关闭所有在线服务,协作应用仍能继续工作 39。一种实现方式是采用开放标准的同步协议,并让多个服务提供商都能支持这一协议 40。例如,Git 就是本地优先的协作系统(虽然它不支持实时协作),因为可以通过 GitHub、GitLab 或其他任意代码仓库托管服务进行同步。
同步引擎的利弊
如今构建 Web 应用的主流方式,是让客户端只保留极少的持久状态;每当需要显示新数据或更新数据时,就向服务器发出请求。使用同步引擎时则相反:客户端持有持久状态,与服务器的通信移到后台进行。这种方式有多项优点:
- 数据在本地,用户界面的响应速度可以远快于等待服务调用返回数据。有些应用追求在图形系统的 下一帧 响应用户输入:对于刷新率为 60 Hz 的显示器,这意味着要在 16 毫秒内完成渲染。
- 允许用户离线工作很有价值,尤其是在连接时断时续的移动设备上。使用同步引擎后,应用程序无需另设离线模式:离线不过是网络延迟变得非常大。
- 与在应用代码中显式调用服务相比,同步引擎简化了前端应用的编程模型。正如 “远程过程调用(RPC)的问题” 中所述,每次服务调用都要处理错误。例如,更新服务器数据的请求失败后,用户界面必须以某种方式反映错误。同步引擎让应用直接读写几乎不会失败的本地数据,从而形成更具声明性的编程风格 41。
- 要实时显示其他用户所作的编辑,需要接收变更通知,并据此高效更新用户界面。同步引擎与 响应式编程(reactive programming)模型结合,是实现这一功能的好办法 42。
如果能事先下载用户可能需要的全部数据,并持久保存在客户端,同步引擎的效果最好。这样一来,需要时就能离线访问;但也意味着,如果用户可以访问的数据量非常大,同步引擎便不适用。例如,下载用户自己创建的全部文件通常没问题(单个用户一般不会产生那么多数据),下载一个电子商务网站的全部商品目录则多半不合理。
Lotus Notes 在 20 世纪 80 年代率先采用了同步引擎的思想 43,尽管当时并未使用这个名称;日历等特定应用的同步功能也已存在多年。如今有不少通用同步引擎,其中一些依赖专有后端服务,例如 Google Firestore、Realm 或 Ditto;另一些提供开源后端,适合构建本地优先软件,例如 PouchDB/CouchDB、Automerge 或 Yjs。
多人视频游戏也需要立即响应玩家的本地操作,再与通过网络异步收到的其他玩家操作协调。在游戏开发术语中,与同步引擎对应的部分称为 网络代码(netcode)。网络代码所用的技术针对游戏需求高度定制 44,无法直接移植到其他软件,因此本书不再展开。
处理写入冲突
多主复制最大的难题——无论是地理分布式的服务端数据库,还是终端用户设备上的本地优先同步引擎——都是不同领导者上的并发写入可能彼此冲突,需要解决。
例如,图 6-9 展示了两个用户同时编辑一个维基页面。用户 1 把页面标题从 A 改为 B,用户 2 则独立地把标题从 A 改为 C。两位用户的变更都成功应用到各自的本地领导者,但异步复制这些变更时,系统发现了冲突。单主数据库不会遇到这个问题。

我们称 图 6-9 中的两次写入为 并发写入,因为最初执行写入时,两者都不知道对方。它们在物理时间上是否真的同时发生并不重要;如果写入发生在离线期间,两者甚至可能相隔很久。真正重要的是,一次写入发生时,另一次写入是否已经生效。
我们会在 “检测并发写入” 中讨论数据库如何判断两次写入是否并发。现在先假定冲突已经能够检测,接下来考虑怎样解决才最合适。
冲突避免
一种策略是从一开始就避免冲突。例如,如果应用程序能确保某条记录的所有写入都经过同一个领导者,那么即使整个数据库采用多主复制,也不会产生冲突。同步引擎客户端离线更新时无法使用这种办法,但在跨地域复制的服务端系统中有时可行 30。
例如,在用户只能编辑自己数据的应用程序中,可以保证某位用户的请求总是路由到同一个地区,并使用该地区的领导者读写。不同用户可以有不同的“主”地区(也许根据与用户的地理距离来选择),但从任一用户的角度看,本质上仍是单主配置。
不过,有时需要改变某条记录的指定领导者:可能是一个地区不可用,必须把流量改送另一个地区;也可能是用户搬到了别处,现在离另一个地区更近。如果用户恰好在指定领导者切换期间执行写入,就可能发生冲突,必须用下面某种方法解决。因此,只要允许改变领导者,冲突避免就可能失效。
再举一个冲突避免的例子。假设要插入新记录,并用自增计数器生成唯一 ID。系统有两个领导者时,可以让一个只生成奇数,另一个只生成偶数。这样两个领导者便不会并发地把同一个 ID 分配给不同记录。“ID 生成器和逻辑时钟” 将讨论其他 ID 分配方案。
最后写入者胜(丢弃并发写入)
如果无法避免冲突,最简单的解决办法是给每次写入附加时间戳,并始终采用时间戳最大的值。例如在 图 6-9 中,假设用户 1 写入的时间戳大于用户 2。两个领导者都会判定页面的新标题应为 B,并丢弃把标题设为 C 的写入。如果两次写入碰巧拥有相同时间戳,还可以比较值来决定胜者(例如字符串可以选择字母顺序在前的值)。
这种方法称为 最后写入者胜(last write wins,LWW),因为时间戳最大的写入被视为“最后”一次写入。不过,这个名称容易误导:当两次写入像 图 6-9 中那样并发时,根本无从定义哪次较早、哪次较晚,因此并发写入的时间戳顺序实质上是随机的。
所以,LWW 的真正含义是:同一条记录在不同领导者上并发写入时,随机挑选其中一次作为胜者,其他写入则静默丢弃,即使它们都已在各自的领导者上成功处理。这样固然能让所有副本最终收敛到一致状态,代价却是数据丢失。
如果能够避免冲突——例如只插入以 UUID 等唯一键标识的记录,而且从不更新——LWW 就没有问题。但如果要更新现有记录,或不同领导者可能插入键相同的记录,就必须判断丢失更新对应用程序是否可以接受。不能接受时,应采用下面介绍的其他冲突解决方式。
LWW 还有一个问题:如果写入时间戳来自实时时钟(例如 Unix 时间戳),系统会对时钟同步极为敏感。假如一个节点的时钟快于其他节点,再尝试覆盖该节点写入的值时,新写入的时间戳可能反而更小,因而被忽略,尽管它显然发生得更晚。使用 逻辑时钟 可以解决这个问题,参见 “ID 生成器和逻辑时钟”。
手动冲突解决
如果不愿随机丢弃某些写入,下一个选择是手工解决冲突。你可能熟悉 Git 等版本控制系统中的做法:两个分支上的提交修改了同一文件的同一行,合并分支时就会产生合并冲突,必须先解决冲突才能完成合并。
在数据库中,让一次冲突阻塞整个复制过程,直到有人解决,显然并不现实。数据库通常会保存一条记录的所有并发写入值——例如 图 6-9 中的 B 和 C。这些值有时称为 兄弟值(siblings)。下次查询该记录时,数据库返回 全部 值,而不只是最新的一个。随后可以任意选择解决办法:在应用代码中自动处理(例如把 B 与 C 拼成“B/C”),或询问用户;最后再向数据库写回一个新值,消解冲突。
CouchDB 等系统采用这种冲突解决方式,但它也有不少问题:
- 数据库 API 会发生变化。例如,维基页面标题原本只是字符串,现在却变成一组字符串;通常只有一个元素,发生冲突时却可能有多个。应用代码处理这种数据会相当别扭。
- 让用户手工合并兄弟值,无论对应用开发者还是用户都是沉重负担:开发者必须制作冲突解决界面,用户则可能不明白自己为什么要做这件事、又该做什么。很多情况下,自动合并比打扰用户更合适。
- 自动合并兄弟值如果不够谨慎,也会产生意外结果。例如,亚马逊购物车过去允许并发更新,再把任一兄弟值中出现的所有商品都保留下来,也就是取购物车的并集。如果顾客在一个兄弟值中删除商品,而另一个兄弟值仍含有该商品,已经删除的商品便会意外重现 45。图 6-10 展示了这种情况:设备 1 删除 Book,设备 2 同时删除 DVD,合并冲突后两件商品却都回来了。
- 如果多个节点同时观察到冲突并各自解决,解决过程本身还可能引入新冲突,而且各节点给出的结果可能不一致。例如,如果没有固定排列顺序,一个节点可能把 B 和 C 合并成“B/C”,另一个却合并成“C/B”;再合并“B/C”与“C/B”时,结果可能变成“B/C/C/B”之类的怪东西。

自动冲突解决
对许多应用程序而言,处理冲突的最佳方式,是用算法自动把并发写入合并成一致状态。自动冲突解决可以保证所有副本 收敛 到同一状态:只要处理过相同的一组写入,各副本的状态就相同,与写入到达的顺序无关。
LWW 是冲突解决算法的一个简单例子。针对不同数据类型,人们还开发了更复杂的合并算法,目标是尽可能保留所有更新的预期效果,从而避免数据丢失:
- 如果数据是文本(例如维基页面的标题或正文),可以检测相邻版本之间插入或删除了哪些字符。合并结果会保留任一兄弟值中的所有插入和删除。如果用户在同一位置并发插入文本,可以按确定性的顺序排列,确保所有节点得到相同结果。
- 如果数据是元素集合,无论像待办事项列表一样有序,还是像购物车一样无序,都可以像合并文本那样跟踪插入和删除。为避免 图 6-10 中的购物车异常,算法会记住 Book 和 DVD 已被删除,因此合并结果为 Cart = {Soap}。
- 如果数据是可以递增或递减的整数计数器(例如社交媒体帖子的点赞数),合并算法可以计算各兄弟值上分别发生了多少次递增和递减,再正确相加,既不重复计数,也不丢失更新。
- 如果数据是键值映射,可以对同一个键下的值采用其他某种冲突解决算法;不同键上的更新则可以彼此独立地处理。
冲突解决并非无所不能。例如,如果规定一个列表最多包含五个元素,而多位用户并发添加元素,使总数超过五个,那么唯一的选择就是丢掉其中一些。即便如此,自动冲突解决仍足以构建许多实用应用。一旦决定构建可协作的离线优先或本地优先应用,冲突解决就不可避免,而自动化往往是最佳选择。
CRDT 与操作变换
实现自动冲突解决时,通常使用两类算法:无冲突复制数据类型(CRDT)46 和 操作变换(OT)47。二者的设计理念与性能特征不同,但都能自动合并前面提到的各种数据。
图 6-11 展示了 OT 和 CRDT 分别如何合并文本的并发更新。假设两个副本起初都保存文本“ice”。一个副本在开头插入字母“n”,得到“nice”;与此同时,另一个副本在末尾插入感叹号,得到“ice!”。

两类算法用不同方式得到合并结果“nice!”:
- OT
- 记录字符插入或删除位置的索引:“n”插入索引 0,“!”插入索引 3。然后两个副本交换操作。在索引 0 插入“n”可以原样应用;但如果直接在状态“nice”的索引 3 插入“!”,结果会变成错误的“nic!e”。因此,必须根据已经应用的并发操作变换每个操作的索引。这里,为了计入较小索引处插入的“n”,需要把“!”的插入位置变换为索引 4。
- CRDT
- 大多数 CRDT 不使用索引,而是给每个字符分配唯一且不可变的 ID,再据此确定插入和删除位置。例如在 图 6-11 中,“i”的 ID 是 1A,“c”的 ID 是 2A,依此类推。插入感叹号时,生成的操作既包含新字符的 ID(4B),也包含插入位置之前那个现有字符的 ID(3A)。要插在字符串开头,就把前驱字符 ID 设为“nil”。同一位置的并发插入按字符 ID 排列。这样无需变换操作,也能保证各副本收敛。
许多算法都建立在这些思路的不同变体上。列表和数组可以采用类似方法,把字符换成列表元素;键值映射等其他数据类型也很容易加入。OT 与 CRDT 在性能和功能上各有取舍,但也可以把二者的优点结合到同一种算法中 48。
OT 最常用于文本的实时协作编辑,例如 Google Docs 32;CRDT 则用于 Redis Enterprise、Riak、Azure Cosmos DB 等分布式数据库 49。面向 JSON 数据的同步引擎既可以用 CRDT 实现(如 Automerge、Yjs),也可以用 OT 实现(如 ShareDB)。
什么是冲突?
有些冲突显而易见。在 图 6-9 的例子中,两次写入并发修改同一条记录的同一个字段,把它设成两个不同的值。毫无疑问,这就是冲突。
另一些冲突则更为微妙,不易发现。以会议室预订系统为例,它记录哪个房间在什么时间由哪组人预订。应用程序必须确保同一时刻每个房间只分配给一组人,也就是说,同一房间的预订不能重叠。如果两项不同预订在同一时间占用同一房间,就会产生冲突。即使应用程序在允许预订前检查空闲情况,只要两次预订分别在不同领导者上进行,仍可能发生冲突。
这个问题没有现成的简短答案,不过在接下来的章节中,我们会逐步加深理解。第 8 章 将给出更多冲突示例;“排序事件以捕获因果关系” 则会讨论在复制系统中可伸缩地检测与解决冲突的方法。
无主复制
本章此前讨论的单主复制与多主复制,都基于同一个思路:客户端把写请求发给某个节点(领导者),再由数据库系统负责把写入复制到其他副本。领导者决定处理写入的顺序,追随者则按相同顺序应用领导者的写入。
另一些数据存储系统采取了不同办法:放弃领导者概念,允许任何副本直接接受客户端写入。最早的一些复制数据系统采用的就是无主模型 1 50,但在关系数据库占据主导地位的年代,这个思路几乎被遗忘。2007 年,亚马逊把它用于内部的 Dynamo 系统 45,无主架构由此再度流行。Riak、Cassandra 和 ScyllaDB 都是受 Dynamo 启发、采用无主复制模型的开源数据存储,因此这类数据库也称为 Dynamo 风格(Dynamo-style)数据库。
在一些无主实现中,客户端直接把写入发给多个副本;另一些实现则由协调者节点代客户端完成这件事。不过,与有领导者的数据库不同,协调者不会强制规定写入顺序。我们将看到,这项设计差异会深刻影响数据库的使用方式。
当节点故障时写入数据库
假设一个数据库有三个副本,其中一个暂时不可用,也许正在重启以安装系统更新。在单主配置中,要继续处理写入,可能需要执行故障切换(参见 “处理节点故障”)。
无主配置则根本没有故障切换。图 6-12 展示了此时的情形:客户端(用户 1234)把写入并行发给三个副本;两个可用副本接受写入,不可用副本则错过了它。假设三个副本中有两个确认就足以判定写入成功:用户 1234 收到两个 ok 响应后,系统便认为写入成功,客户端直接忽略有一个副本漏掉写入这一事实。

现在设想不可用的节点恢复上线,客户端开始从它读取。该节点停机期间发生的写入都没有保存在这里,因此从它读取时,响应中可能包含 陈旧(过时)的值。
为解决这个问题,客户端读取数据库时,不能只把请求发给一个副本:读请求也要并行发往多个节点。不同节点可能给出不同响应,例如一个返回最新值,另一个返回陈旧值。
要分辨哪些响应是最新的、哪些已经过时,每个写入的值都必须带有版本号或时间戳,类似 “最后写入者胜(丢弃并发写入)” 中介绍的做法。客户端收到多个读取结果时,采用时间戳最大的值——即使只有一个副本返回该值,其他几个副本都返回旧值。更多细节参见 “检测并发写入”。
追赶错过的写入
复制系统应当保证所有数据最终都会复制到每个副本。不可用节点恢复上线后,怎样补上停机期间错过的写入?Dynamo 风格的数据存储会使用以下几种机制:
- 读修复(read repair)
- 客户端并行读取多个节点时,可以发现陈旧响应。例如在 图 6-12 中,用户 2345 从副本 3 得到版本 6 的值,从副本 1 和副本 2 得到版本 7 的值。客户端发现副本 3 的值已经过时,于是把较新的值写回这个副本。对于经常读取的值,这种方法很有效。
- 提示移交(hinted handoff)
- 某个副本不可用时,另一个副本可以替它保存写入,并把这些写入记录为 提示。原本应接收这些写入的副本恢复后,保存提示的副本会将它们发送过去,然后删除提示。即使某些值从未被读取、无法通过读修复更新,这个 移交 过程也能让副本赶上进度。
- 反熵(anti-entropy)
- 此外,还有一个后台进程定期查找副本之间的数据差异,把缺失的数据从一个副本复制到另一个。与基于领导者的复制日志不同,这个 反熵过程(anti-entropy process)并不按特定顺序复制写入,数据得到复制之前可能有很长延迟。
读写仲裁
在 图 6-12 的例子中,写入只在三个副本中的两个上完成,我们仍判定它成功。如果只有一个副本接受写入呢?这个下限究竟能压到多低?
如果能保证每次成功写入至少保存在三个副本中的两个上,那么最多只有一个副本是陈旧的。因此,只要读取至少两个副本,就可以确信其中至少一个是最新的。即使第三个副本停机或响应缓慢,读取仍能返回最新值。
更一般地说,假设有 n 个副本,每次写入必须得到 w 个节点确认才算成功,每次读取则至少查询 r 个节点。(上述例子中,n = 3、w = 2、r = 2。)只要 w + r > n,读取时就有望得到最新值,因为所查询的 r 个节点中,至少有一个必然是最新的。遵守这些 r、w 取值的操作称为 仲裁读(quorum read)和 仲裁写(quorum write)50。可以把 r 和 w 看作一次读或写要成立所需的最低票数。
在 Dynamo 风格的数据库中,参数 n、w、r 通常都可以配置。常见做法是让 n 取奇数(通常为 3 或 5),并令 w = r = (n + 1) / 2(向上取整);不过也可以根据需要调整。例如,写少读多的工作负载可能适合设为 w = n、r = 1。这样读取更快,缺点是只要一个节点失效,所有数据库写入都会失败。
集群中的节点数可以多于 n,但任意给定值只存储在 n 个节点上。这样就能对数据集进行分片,支持单个节点无法容纳的数据集。我们会在 第 7 章 继续讨论分片。
仲裁条件 w + r > n 使系统能够按以下方式容忍节点不可用:
- 如果 w < n,有一个节点不可用时仍可处理写入。
- 如果 r < n,有一个节点不可用时仍可处理读取。
- 当 n = 3、w = 2、r = 2 时,可以像 图 6-12 那样容忍一个节点不可用。
- 当 n = 5、w = 3、r = 3 时,可以容忍两个节点不可用,如 图 6-13 所示。
通常,读写请求总会并行发送到全部 n 个副本。参数 w 和 r 决定要等待多少个节点,也就是在判定读或写成功之前,n 个节点中必须有多少个报告成功。

如果可用节点少于所需的 w 或 r,写入或读取就会返回错误。节点不可用可能有许多原因:节点停机(崩溃或断电)、执行操作时出错(磁盘已满,无法写入)、客户端与节点之间网络中断,等等。我们只关心节点是否返回成功响应,无需区分故障的具体类型。
仲裁一致性的局限
如果有 n 个副本,并选择满足 w + r > n 的 w 和 r,通常可以期望每次读取都返回某个键最近写入的值。这是因为写入所涉及的节点集合与读取所涉及的节点集合必然有交集;也就是说,读取的节点中至少有一个保存着最新值,如 图 6-13 所示。
r 和 w 通常取节点的多数(多于 n/2),因为这样既能保证 w + r > n,又能容忍最多 n/2(向下取整)个节点失效。不过,法定人数并不一定非得是多数;真正重要的是,读操作与写操作所用的节点集合至少有一个共同节点。法定人数还可以有其他安排,为分布式算法的设计提供一定灵活性 51。
也可以把 w 和 r 设得更小,使 w + r ≤ n,即不满足仲裁条件。此时读写请求仍会发往 n 个节点,只是操作成功所需的成功响应更少。
w 和 r 越小,越容易读到陈旧值,因为读操作更可能没有覆盖保存最新值的节点。好处则是延迟更低、可用性更高:网络中断导致许多副本不可达时,系统仍有更大机会继续处理读写。只有可达副本数低于 w 或 r 时,数据库才会分别变得不可写或不可读。
然而,即使 w + r > n,仍有一些边缘情况会让一致性属性变得难以理解,例如:
- 如果保存新值的节点失效,又从保存旧值的副本恢复数据,保存新值的副本数可能降到 w 以下,破坏仲裁条件。
- 再平衡期间,一部分数据会从一个节点迁移到另一个节点(见 第 7 章),各节点对“某个值的 n 个副本应由哪些节点保存”可能看法不一,使读仲裁与写仲裁不再相交。
- 如果读操作与写操作并发,读取可能看见并发写入的值,也可能看不见。尤其是,某次读取可能看到新值,后续读取却看到旧值,参见 “线性一致性与仲裁”。
- 如果一次写入在部分副本上成功、在其余副本上失败(例如某些节点磁盘已满),总成功数少于 w,那么整体写入会判定失败,但成功副本上的写入不会回滚。这意味着即使系统报告写入失败,后续读取仍可能返回这次写入的值 52。
- 如果数据库用实时时钟的时间戳判断写入的新旧(例如 Cassandra 和 ScyllaDB),另一个时钟较快的节点只要写过同一个键,后续写入就可能被静默丢弃。我们在 “最后写入者胜(丢弃并发写入)” 中已经见过这个问题,还会在 “对同步时钟的依赖” 中进一步讨论。
- 如果两次写入并发发生,一个副本可能先处理其中一次,另一个副本则先处理另一次,由此产生冲突,与多主复制中的情况相似(参见 “处理写入冲突”)。我们会在 “检测并发写入” 中再谈这个问题。
因此,仲裁看似保证读取返回最近写入的值,实际却没有那么简单。Dynamo 风格数据库通常针对能够容忍最终一致性的场景优化。参数 w 和 r 可以调节读到陈旧值的概率 53,却不宜被当作绝对保证。
监控陈旧性
从运维角度看,监控数据库返回的结果是否最新非常重要。即使应用程序能够容忍陈旧读取,也必须了解复制是否健康。如果复制大幅落后,系统应发出告警,以便调查网络故障、节点过载等原因。
采用基于领导者的复制时,数据库通常会暴露复制延迟指标,供监控系统采集。这是因为写入在领导者和追随者上按相同顺序应用,每个节点都有自己在复制日志中的位置,也就是已经在本地应用了多少次写入。用领导者当前位置减去追随者当前位置,便可度量复制延迟。
无主复制系统没有固定的写入应用顺序,监控起来更加困难。副本为了移交而保存的提示数量可以作为一项健康指标,却很难作出有意义的解释 54。最终一致性有意给出了一项模糊保证,但为了可运维性,必须能够量化“最终”究竟有多远。
单主与无主复制的性能
基于单个领导者的复制系统能够提供强一致性保证,而无主系统很难甚至不可能做到。不过,正如 “复制延迟的问题” 中所见,在基于领导者的复制系统里,如果从异步更新的追随者读取,同样可能得到陈旧值。
从领导者读取可以保证响应最新,却存在性能问题:
- 读取吞吐量受领导者处理能力限制;相比之下,读扩展可以把读取分散到异步更新的副本,但这些副本可能返回陈旧值。
- 领导者失效后,必须等系统检测到故障并完成故障切换,才能继续处理请求。即使故障切换很快,响应时间的短暂上升也会被用户察觉;如果耗时很长,系统就会在此期间不可用。
- 系统对领导者的性能问题极其敏感。如果领导者因过载或资源争用而响应缓慢,用户的响应时间也会立即增加。
无主架构的一大优点,是面对这些问题时韧性更强。系统无需故障切换,而且请求原本就会并行发往多个副本,因此一个副本变慢或不可用,对响应时间的影响很小:客户端只需采用响应较快的其他副本所返回的结果。采用最快响应的做法称为 请求对冲(request hedging),可以显著降低尾延迟 55。
无主系统之所以有这种韧性,根本原因是它不区分正常情况和故障情况。这对于处理所谓的 灰色失效(gray failure)尤其有利:节点并未彻底停机,却处于降级状态,处理请求异常缓慢 56;节点单纯过载时也是如此(例如节点离线一段时间后,靠提示移交恢复可能产生大量额外负载)。基于领导者的系统必须判断情况是否严重到需要故障切换,而故障切换本身又可能带来进一步中断;无主系统根本不需要作出这项判断。
当然,无主系统也可能遇到性能问题:
- 即使不需要执行故障切换,也必须由一个副本发现另一个副本不可用,才能替它保存错过写入的提示。不可用副本恢复后,移交过程还要把这些提示发给它。在系统本已承压时,这会给副本增加额外负载 54。
- 副本越多,法定人数越大,请求完成前必须等待的响应也越多。即使只等待最快的 r 或 w 个副本,即使所有请求并行发出,更大的 r 或 w 仍会提高遇到慢副本的概率,从而增加总体响应时间(参见 “响应时间指标的应用”)。
- 大范围网络中断使客户端与大量副本断开时,可能根本无法组成法定人数。有些无主数据库允许任何可达副本接受写入,即使它不属于该键通常所在的副本集合(Riak 和 Dynamo 称之为 宽松仲裁,sloppy quorum 45;Cassandra 和 ScyllaDB 称之为 一致性级别 ANY)。后续读取不保证能看到这次写入,但对某些应用而言,这仍好过写入直接失败。
多主复制抵御网络中断的能力甚至可能强于无主复制,因为读写只需与一个领导者通信,而领导者可以与客户端位于同一地区。不过,一个领导者上的写入会异步传播给其他领导者,读取结果因而可能任意陈旧。仲裁读写提供了一种折中:既有良好的容错能力,也有很高概率读到最新数据。
多地区操作
我们此前把跨地区复制作为多主复制的一个用例(见 “多主复制”)。无主复制同样适合多地区运行,因为它本来就是为了容忍相互冲突的并发写入、网络中断和延迟尖峰而设计的。
Cassandra 和 ScyllaDB 在常规无主模型中实现多地区支持:客户端把写入直接发往所有地区的副本,并可选择多种一致性级别,规定请求至少得到多少响应才算成功。例如,可以要求所有地区的全部副本共同组成一个法定人数,也可以要求每个地区各自组成法定人数,或只要求客户端所在地区达到法定人数。本地法定人数无需等待其他地区的慢请求,但也更容易返回陈旧结果。
Riak 则把客户端与数据库节点之间的所有通信限制在本地地区,因此 n 表示一个地区内的副本数。数据库集群之间的跨地区复制在后台异步进行,方式与多主复制相似。
检测并发写入
与多主复制一样,无主数据库允许对同一个键并发写入,由此产生需要解决的冲突。冲突可能在写入发生时出现,但并非总是如此;它也可能到读修复、提示移交或反熵阶段才被发现。
问题在于,网络延迟会变化,系统还可能部分失效,所以事件抵达不同节点的顺序可能不同。例如,图 6-14 展示了客户端 A 和 B 同时写入三节点数据存储中的键 X:
- 节点 1 收到 A 的写入,但由于短暂中断,一直没有收到 B 的写入。
- 节点 2 先收到 A 的写入,再收到 B 的写入。
- 节点 3 先收到 B 的写入,再收到 A 的写入。

如果每个节点一收到客户端写请求就直接覆盖键的值,各节点将永久不一致,如 图 6-14 最后的 get 请求所示:节点 2 认为 X 的最终值是 B,其他节点却认为是 A。
为了达到最终一致,各副本必须收敛到同一个值。可以采用 “处理写入冲突” 中讨论过的任意冲突解决机制,例如 Cassandra 和 ScyllaDB 使用的最后写入者胜、手工解决,或 “CRDT 与操作变换” 中介绍且 Riak 使用的 CRDT。
最后写入者胜很容易实现:给每次写入附加时间戳,时间戳较大的值总是覆盖较小的值。但时间戳无法告诉你两个值究竟是否冲突:它们可能是并发写入的,也可能先后写入。如果要显式解决冲突,系统必须更仔细地检测并发写入。
“先发生”关系与并发
怎样判断两个操作是否并发?先看几个例子来建立直觉:
- 在 图 6-8 中,两次写入并不并发:A 的插入 先发生于 B 的递增,因为 B 所递增的值正是 A 插入的值。换句话说,B 的操作建立在 A 的操作之上,所以 B 必然发生得更晚。也可以说,B 因果依赖 于 A。
- 图 6-14 中的两次写入则是并发的:每个客户端开始操作时,都不知道另一个客户端也在操作同一个键。因此,两次操作之间没有因果依赖。
如果操作 B 知道 A、依赖 A,或以某种方式建立在 A 之上,就称操作 A 先发生于(happens before)操作 B。一项操作是否先发生于另一项操作,是定义并发的关键。事实上,只要两个操作谁也不先发生于另一个——也就是说,谁都不知道对方——就可以称它们 并发(concurrent)57。
因此,对于任意两个操作 A 与 B,只有三种可能:A 先发生于 B;B 先发生于 A;或者 A 与 B 并发。我们需要一种算法判断两次操作是否并发。如果一项操作先发生于另一项,后发生的操作就应覆盖先前操作;如果两者并发,则出现了需要解决的冲突。
两项操作似乎只有在“同一时刻”发生时才应称为并发,实际上它们在物理时间上是否重叠并不重要。由于分布式系统中的时钟问题,判断两件事是否恰好同时发生相当困难,我们会在 第 9 章 进一步讨论。
定义并发时,精确时间并不重要:只要两项操作彼此都不知道对方,就称它们并发,无论它们实际发生在什么物理时刻。人们有时把这个原理与物理学中的狭义相对论联系起来 57。狭义相对论提出,信息传播不可能超过光速。因此,如果相隔一定距离的两个事件之间,时间差短于光传播这段距离所需的时间,它们就不可能相互影响。
在计算机系统中,即使按光速计算,一项操作原则上来得及影响另一项,两者仍可能并发。例如,当时网络很慢或已经中断,两项操作即使相隔一段时间,仍会因网络问题而彼此无法知晓。
捕获先发生关系
下面看一种算法,它可以判断两项操作是并发的,还是一项先发生于另一项。为简单起见,先从只有一个副本的数据库开始。弄清单副本的做法后,再推广到拥有多个副本的无主数据库。
图 6-15 展示了两个客户端并发地向同一个购物车添加商品。(如果这个例子太无聊,也可以设想两名空中交通管制员并发地把飞机加入各自正在监视的空域。)购物车最初为空,两个客户端先后共向数据库发出五次写入:
- 客户端 1 把
milk加入购物车。这是该键的第一次写入,服务器成功保存它并分配版本 1;然后把值和版本号一起返回给客户端。 - 客户端 2 把
eggs加入购物车,却不知道客户端 1 同时加入了milk(它以为eggs是购物车中唯一的商品)。服务器为这次写入分配版本 2,把eggs和milk保存为两个独立的值(兄弟值),再把 两个 值连同版本号 2 一起返回给客户端。 - 客户端 1 不知道客户端 2 的写入,又想加入
flour,因此它认为购物车内容应为[milk, flour]。它把这个值连同服务器此前给出的版本号 1 一起发送。服务器可以根据版本号判断:[milk, flour]取代了先前的[milk],却与[eggs]并发。因此,服务器为[milk, flour]分配版本 3,覆盖版本 1 的[milk],保留版本 2 的[eggs],并把剩下的两个值都返回给客户端。 - 与此同时,客户端 2 想加入
ham,并不知道客户端 1 刚刚加入flour。客户端 2 在上一次响应中收到了[milk]和[eggs],于是将两者合并,再加入ham,形成新值[eggs, milk, ham]。它把这个值连同先前的版本号 2 一起发给服务器。服务器判断版本 2 可以覆盖[eggs],但与[milk, flour]并发;剩下的两个值便是版本 3 的[milk, flour]和版本 4 的[eggs, milk, ham]。 - 最后,客户端 1 想加入
bacon。它此前在版本 3 的响应中收到[milk, flour]和[eggs],于是合并二者,加入bacon,把最终值[milk, flour, eggs, bacon]连同版本号 3 发给服务器。这个值覆盖[milk, flour]([eggs]已在上一步被覆盖),却与[eggs, milk, ham]并发,因此服务器保留这两个并发值。

图 6-15 中各操作之间的数据流,在 图 6-16 中以图形表示。箭头指出哪项操作 先发生于 另一项,也就是说,后发生的操作 知道 或 依赖 先发生的操作。在这个例子里,客户端从未完全掌握服务器上的最新数据,因为始终有另一项操作并发进行。但值的旧版本最终会被覆盖,而且不会丢失任何写入。

请注意,服务器仅凭版本号就能判断两项操作是否并发,无需解释值本身,因此值可以是任意数据结构。算法如下:
- 服务器为每个键维护一个版本号;每次写入该键时递增版本号,并把新版本号与写入值一同保存。
- 客户端读取一个键时,服务器返回所有兄弟值(即尚未被覆盖的全部值)以及最新版本号。客户端写入前必须先读取。
- 客户端写入一个键时,必须带上前一次读取所得的版本号,还必须把上次读取收到的所有值合并起来,例如使用 CRDT,或询问用户。写请求的响应与读取相似,也会返回所有兄弟值,因此可以像购物车例子那样连续执行多次写入。
- 服务器收到带有特定版本号的写入时,可以覆盖版本号不高于它的所有值,因为这些值已被合并进新值;版本号更高的值则必须保留,因为它们与传入写入并发。
写入带上前一次读取所得的版本号,就说明这次写入基于哪个先前状态。如果写入不含版本号,它就与其他所有写入并发,因而不会覆盖任何内容,只会作为后续读取返回的值之一。
版本向量
图 6-15 的例子只有一个副本。如果没有领导者,而且多个副本都能接受写入,算法需要怎样改变?
图 6-15 用一个版本号捕获操作之间的依赖关系,但多个副本并发接受写入时,一个版本号就不够了。此时必须针对每个键,给 每个副本 分别维护版本号。副本处理写入时递增自己的版本号,同时记录自己见过的其他副本版本号。这些信息表明哪些值应当覆盖,哪些值应作为兄弟值保留。
所有副本的版本号集合称为 版本向量 58。这种思路有若干变体,其中最值得关注的也许是 点化版本向量(dotted version vector)59 60,Riak 2.0 采用了这种变体 61 62。这里不展开细节;它的工作方式与购物车例子非常相似。
与 图 6-15 中的版本号一样,读取时数据库副本会把版本向量发给客户端,随后写入时客户端必须再把它带回数据库。(Riak 把版本向量编码成一个字符串,称为 因果上下文,causal context。)版本向量让数据库能够区分覆盖写入和并发写入。
版本向量还保证:先从一个副本读取,再把写入发给另一个副本,是安全的。这样做可能产生兄弟值,但只要正确合并兄弟值,就不会丢失数据。
总结
本章考察了复制问题。复制有多种用途:
- 高可用性
- 即使一台或多台机器、一个可用区乃至整个地区停机,系统仍能继续运行
- 离线运行
- 网络中断时,应用程序仍能继续工作
- 延迟
- 把数据放在地理上靠近用户的位置,让用户能够更快地与之交互
- 可伸缩性
- 把读取分散到多个副本,处理超出单台机器能力的读取量
复制的目标看似简单——在多台机器上保留相同数据的副本——实际却极其棘手。它要求我们仔细考虑并发、所有可能出错的环节,以及怎样应对故障造成的后果。至少要处理节点不可用和网络中断,而且这还没有算上软件缺陷或硬件错误引起的静默数据损坏等更隐蔽的故障。
我们讨论了三种主要的复制方式:
- 单主复制
- 客户端把所有写入发给一个节点(领导者),领导者再把数据变更事件流发送给其他副本(追随者)。读取可以在任意副本上执行,但追随者返回的结果可能陈旧。
- 多主复制
- 客户端把每次写入发给多个领导者中的一个,任意领导者都能接受写入。各领导者相互发送数据变更事件流,也会将其发送给追随者。
- 无主复制
- 客户端把每次写入发给多个节点,并行读取多个节点,从而发现并修复持有陈旧数据的节点。
每种方式都有优缺点。单主复制很流行,因为它相对容易理解,又能提供强一致性。多主复制和无主复制面对节点故障、网络中断和延迟尖峰时韧性更强,代价是必须解决冲突,而且只能提供较弱的一致性保证。
复制可以同步,也可以异步;发生故障时,这项选择会深刻影响系统行为。系统平稳运行时,异步复制可能很快,但仍必须弄清复制延迟增大或服务器失效时会发生什么。如果领导者失效,而你把一个异步更新的追随者提升为新领导者,最近提交的数据可能丢失。
我们考察了复制延迟可能造成的几种反常现象,并讨论了几种一致性模型,以便判断应用程序在复制延迟下应有怎样的行为:
- 写后读一致性
- 用户应当总能看到自己提交的数据。
- 单调读
- 用户看到某一时刻的数据后,不应在稍后又看到更早时刻的数据。
- 一致前缀读
- 用户看到的数据状态应符合因果关系,例如以正确顺序看到问题及其回答。
最后,我们讨论了多主复制和无主复制如何让所有副本最终收敛到一致状态:用版本向量或类似算法检测哪些写入并发,再用 CRDT 等冲突解决算法合并并发写入的值。最后写入者胜和手工解决冲突也是可选方案。
本章一直假设每个副本都保存整个数据库的完整拷贝,但对大型数据集而言,这并不现实。下一章将介绍 分片,使每台机器只需存储一部分数据。
参考文献
B. G. Lindsay, P. G. Selinger, C. Galtieri, J. N. Gray, R. A. Lorie, T. G. Price, F. Putzolu, I. L. Traiger, and B. W. Wade. Notes on Distributed Databases. IBM Research, Research Report RJ2571(33471), July 1979. Archived at perma.cc/EPZ3-MHDD ↩︎ ↩︎
Kenny Gryp. MySQL Terminology Updates. dev.mysql.com, July 2020. Archived at perma.cc/S62G-6RJ2 ↩︎
Oracle Corporation. Oracle (Active) Data Guard 19c: Real-Time Data Protection and Availability. White Paper, oracle.com, March 2019. Archived at perma.cc/P5ST-RPKE ↩︎
Microsoft. What is an Always On availability group? learn.microsoft.com, September 2024. Archived at perma.cc/ABH6-3MXF ↩︎
Mostafa Elhemali, Niall Gallagher, Nicholas Gordon, Joseph Idziorek, Richard Krog, Colin Lazier, Erben Mo, Akhilesh Mritunjai, Somu Perianayagam, Tim Rath, Swami Sivasubramanian, James Christopher Sorenson III, Sroaj Sosothikul, Doug Terry, and Akshat Vig. Amazon DynamoDB: A Scalable, Predictably Performant, and Fully Managed NoSQL Database Service. At USENIX Annual Technical Conference (ATC), July 2022. ↩︎ ↩︎
Rebecca Taft, Irfan Sharif, Andrei Matei, Nathan VanBenschoten, Jordan Lewis, Tobias Grieger, Kai Niemi, Andy Woods, Anne Birzin, Raphael Poss, Paul Bardea, Amruta Ranade, Ben Darnell, Bram Gruneir, Justin Jaffray, Lucy Zhang, and Peter Mattis. CockroachDB: The Resilient Geo-Distributed SQL Database. At ACM SIGMOD International Conference on Management of Data (SIGMOD), pages 1493–1509, June 2020. doi:10.1145/3318464.3386134 ↩︎
Dongxu Huang, Qi Liu, Qiu Cui, Zhuhe Fang, Xiaoyu Ma, Fei Xu, Li Shen, Liu Tang, Yuxing Zhou, Menglong Huang, Wan Wei, Cong Liu, Jian Zhang, Jianjun Li, Xuelian Wu, Lingyu Song, Ruoxi Sun, Shuaipeng Yu, Lei Zhao, Nicholas Cameron, Liquan Pei, and Xin Tang. TiDB: a Raft-based HTAP database. Proceedings of the VLDB Endowment, volume 13, issue 12, pages 3072–3084. doi:10.14778/3415478.3415535 ↩︎
Mallory Knodel and Niels ten Oever. Terminology, Power, and Inclusive Language in Internet-Drafts and RFCs. IETF Internet-Draft, August 2023. Archived at perma.cc/5ZY9-725E ↩︎
Buck Hodges. Postmortem: VSTS 4 September 2018. devblogs.microsoft.com, September 2018. Archived at perma.cc/ZF5R-DYZS ↩︎
Gunnar Morling. Leader Election With S3 Conditional Writes. www.morling.dev, August 2024. Archived at perma.cc/7V2N-J78Y ↩︎
Vignesh Chandramohan, Rohan Desai, and Chris Riccomini. SlateDB Manifest Design. github.com, May 2024. Archived at perma.cc/8EUY-P32Z ↩︎
Stas Kelvich. Why does Neon use Paxos instead of Raft, and what’s the difference? neon.tech, August 2022. Archived at perma.cc/SEZ4-2GXU ↩︎
Dimitri Fontaine. An introduction to the pg_auto_failover project. tapoueh.org, November 2021. Archived at perma.cc/3WH5-6BAF ↩︎
Jesse Newland. GitHub availability this week. github.blog, September 2012. Archived at perma.cc/3YRF-FTFJ ↩︎
Mark Imbriaco. Downtime last Saturday. github.blog, December 2012. Archived at perma.cc/M7X5-E8SQ ↩︎
John Hugg. ‘All In’ with Determinism for Performance and Testing in Distributed Systems. At Strange Loop, September 2015. ↩︎
Hironobu Suzuki. The Internals of PostgreSQL. interdb.jp, 2017. ↩︎
Amit Kapila. WAL Internals of PostgreSQL. At PostgreSQL Conference (PGCon), May 2012. Archived at perma.cc/6225-3SUX ↩︎
Amit Kapila. Evolution of Logical Replication. amitkapila16.blogspot.com, September 2023. Archived at perma.cc/F9VX-JLER ↩︎
Aru Petchimuthu. Upgrade your Amazon RDS for PostgreSQL or Amazon Aurora PostgreSQL database, Part 2: Using the pglogical extension. aws.amazon.com, August 2021. Archived at perma.cc/RXT8-FS2T ↩︎
Yogeshwer Sharma, Philippe Ajoux, Petchean Ang, David Callies, Abhishek Choudhary, Laurent Demailly, Thomas Fersch, Liat Atsmon Guz, Andrzej Kotulski, Sachin Kulkarni, Sanjeev Kumar, Harry Li, Jun Li, Evgeniy Makeev, Kowshik Prakasam, Robbert van Renesse, Sabyasachi Roy, Pratyush Seth, Yee Jiun Song, Benjamin Wester, Kaushik Veeraraghavan, and Peter Xie. Wormhole: Reliable Pub-Sub to Support Geo-Replicated Internet Services. At 12th USENIX Symposium on Networked Systems Design and Implementation (NSDI), May 2015. ↩︎
Douglas B. Terry. Replicated Data Consistency Explained Through Baseball. Microsoft Research, Technical Report MSR-TR-2011-137, October 2011. Archived at perma.cc/F4KZ-AR38 ↩︎ ↩︎ ↩︎
Douglas B. Terry, Alan J. Demers, Karin Petersen, Mike J. Spreitzer, Marvin M. Theher, and Brent B. Welch. Session Guarantees for Weakly Consistent Replicated Data. At 3rd International Conference on Parallel and Distributed Information Systems (PDIS), September 1994. doi:10.1109/PDIS.1994.331722 ↩︎ ↩︎
Werner Vogels. Eventually Consistent. ACM Queue, volume 6, issue 6, pages 14–19, October 2008. doi:10.1145/1466443.1466448 ↩︎
Simon Willison. Reply to: “My thoughts about Fly.io (so far) and other newish technology I’m getting into”. news.ycombinator.com, May 2022. Archived at perma.cc/ZRV4-WWV8 ↩︎
Nithin Tharakan. Scaling Bitbucket’s Database. atlassian.com, October 2020. Archived at perma.cc/JAB7-9FGX ↩︎
Terry Pratchett. Reaper Man: A Discworld Novel. Victor Gollancz, 1991. ISBN: 978-0-575-04979-6 ↩︎
Peter Bailis, Alan Fekete, Michael J. Franklin, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. Coordination Avoidance in Database Systems. Proceedings of the VLDB Endowment, volume 8, issue 3, pages 185–196, November 2014. doi:10.14778/2735508.2735509 ↩︎
Yaser Raja and Peter Celentano. PostgreSQL bi-directional replication using pglogical. aws.amazon.com, January 2022. Archived at https://perma.cc/BUQ2-5QWN ↩︎
Robert Hodges. If You *Must* Deploy Multi-Master Replication, Read This First. scale-out-blog.blogspot.com, April 2012. Archived at perma.cc/C2JN-F6Y8 ↩︎ ↩︎
Lars Hofhansl. HBASE-7709: Infinite Loop Possible in Master/Master Replication. issues.apache.org, January 2013. Archived at perma.cc/24G2-8NLC ↩︎
John Day-Richter. What’s Different About the New Google Docs: Making Collaboration Fast. drive.googleblog.com, September 2010. Archived at perma.cc/5TL8-TSJ2 ↩︎ ↩︎
Evan Wallace. How Figma’s multiplayer technology works. figma.com, October 2019. Archived at perma.cc/L49H-LY4D ↩︎
Tuomas Artman. Scaling the Linear Sync Engine. linear.app, June 2023. ↩︎
Amr Saafan. Why Sync Engines Might Be the Future of Web Applications. nilebits.com, September 2024. Archived at perma.cc/5N73-5M3V ↩︎
Isaac Hagoel. Are Sync Engines The Future of Web Applications? dev.to, July 2024. Archived at perma.cc/R9HF-BKKL ↩︎
Sujay Jayakar. A Map of Sync. stack.convex.dev, October 2024. Archived at perma.cc/82R3-H42A ↩︎
Alex Feyerke. Designing Offline-First Web Apps. alistapart.com, December 2013. Archived at perma.cc/WH7R-S2DS ↩︎
Martin Kleppmann, Adam Wiggins, Peter van Hardenberg, and Mark McGranaghan. Local-first software: You own your data, in spite of the cloud. At ACM SIGPLAN International Symposium on New Ideas, New Paradigms, and Reflections on Programming and Software (Onward!), October 2019, pages 154–178. doi:10.1145/3359591.3359737 ↩︎
Martin Kleppmann. The past, present, and future of local-first. At Local-First Conference, May 2024. ↩︎
Conrad Hofmeyr. API Calling is to Sync Engines as jQuery is to React. powersync.com, November 2024. Archived at perma.cc/2FP9-7WJJ ↩︎
Peter van Hardenberg and Martin Kleppmann. PushPin: Towards Production-Quality Peer-to-Peer Collaboration. At 7th Workshop on Principles and Practice of Consistency for Distributed Data (PaPoC), April 2020. doi:10.1145/3380787.3393683 ↩︎
Leonard Kawell, Jr., Steven Beckhardt, Timothy Halvorsen, Raymond Ozzie, and Irene Greif. Replicated document management in a group communication system. At ACM Conference on Computer-Supported Cooperative Work (CSCW), September 1988. doi:10.1145/62266.1024798 ↩︎
Ricky Pusch. Explaining how fighting games use delay-based and rollback netcode. words.infil.net and arstechnica.com, October 2019. Archived at perma.cc/DE7W-RDJ8 ↩︎
Giuseppe DeCandia, Deniz Hastorun, Madan Jampani, Gunavardhan Kakulapati, Avinash Lakshman, Alex Pilchin, Swaminathan Sivasubramanian, Peter Vosshall, and Werner Vogels. Dynamo: Amazon’s Highly Available Key-Value Store. At 21st ACM Symposium on Operating Systems Principles (SOSP), October 2007. doi:10.1145/1323293.1294281 ↩︎ ↩︎ ↩︎ ↩︎
Marc Shapiro, Nuno Preguiça, Carlos Baquero, and Marek Zawirski. A Comprehensive Study of Convergent and Commutative Replicated Data Types. INRIA Research Report no. 7506, January 2011. ↩︎
Chengzheng Sun and Clarence Ellis. Operational Transformation in Real-Time Group Editors: Issues, Algorithms, and Achievements. At ACM Conference on Computer Supported Cooperative Work (CSCW), November 1998. doi:10.1145/289444.289469 ↩︎
Joseph Gentle and Martin Kleppmann. Collaborative Text Editing with Eg-walker: Better, Faster, Smaller. At 20th European Conference on Computer Systems (EuroSys), March 2025. doi:10.1145/3689031.3696076 ↩︎
Dharma Shukla. Azure Cosmos DB: Pushing the frontier of globally distributed databases. azure.microsoft.com, September 2018. Archived at perma.cc/UT3B-HH6R ↩︎
David K. Gifford. Weighted Voting for Replicated Data. At 7th ACM Symposium on Operating Systems Principles (SOSP), December 1979. doi:10.1145/800215.806583 ↩︎ ↩︎
Heidi Howard, Dahlia Malkhi, and Alexander Spiegelman. Flexible Paxos: Quorum Intersection Revisited. At 20th International Conference on Principles of Distributed Systems (OPODIS), December 2016. doi:10.4230/LIPIcs.OPODIS.2016.25 ↩︎
Joseph Blomstedt. Bringing Consistency to Riak. At RICON West, October 2012. ↩︎
Peter Bailis, Shivaram Venkataraman, Michael J. Franklin, Joseph M. Hellerstein, and Ion Stoica. Quantifying eventual consistency with PBS. The VLDB Journal, volume 23, pages 279–302, April 2014. doi:10.1007/s00778-013-0330-1 ↩︎
Colin Breck. Shared-Nothing Architectures for Server Replication and Synchronization. blog.colinbreck.com, December 2019. Archived at perma.cc/48P3-J6CJ ↩︎ ↩︎
Jeffrey Dean and Luiz André Barroso. The Tail at Scale. Communications of the ACM, volume 56, issue 2, pages 74–80, February 2013. doi:10.1145/2408776.2408794 ↩︎
Peng Huang, Chuanxiong Guo, Lidong Zhou, Jacob R. Lorch, Yingnong Dang, Murali Chintalapati, and Randolph Yao. Gray Failure: The Achilles’ Heel of Cloud-Scale Systems. At 16th Workshop on Hot Topics in Operating Systems (HotOS), May 2017. doi:10.1145/3102980.3103005 ↩︎
Leslie Lamport. Time, Clocks, and the Ordering of Events in a Distributed System. Communications of the ACM, volume 21, issue 7, pages 558–565, July 1978. doi:10.1145/359545.359563 ↩︎ ↩︎
D. Stott Parker Jr., Gerald J. Popek, Gerard Rudisin, Allen Stoughton, Bruce J. Walker, Evelyn Walton, Johanna M. Chow, David Edwards, Stephen Kiser, and Charles Kline. Detection of Mutual Inconsistency in Distributed Systems. IEEE Transactions on Software Engineering, volume SE-9, issue 3, pages 240–247, May 1983. doi:10.1109/TSE.1983.236733 ↩︎
Nuno Preguiça, Carlos Baquero, Paulo Sérgio Almeida, Victor Fonte, and Ricardo Gonçalves. Dotted Version Vectors: Logical Clocks for Optimistic Replication. arXiv:1011.5808, November 2010. ↩︎
Giridhar Manepalli. Clocks and Causality - Ordering Events in Distributed Systems. exhypothesi.com, November 2022. Archived at perma.cc/8REU-KVLQ ↩︎ ↩︎
Sean Cribbs. A Brief History of Time in Riak. At RICON, October 2014. Archived at perma.cc/7U9P-6JFX ↩︎
Russell Brown. Vector Clocks Revisited Part 2: Dotted Version Vectors. riak.com, November 2015. Archived at perma.cc/96QP-W98R ↩︎
Carlos Baquero. Version Vectors Are Not Vector Clocks. haslab.wordpress.com, July 2011. Archived at perma.cc/7PNU-4AMG ↩︎
Reinhard Schwarz and Friedemann Mattern. Detecting Causal Relationships in Distributed Computations: In Search of the Holy Grail. Distributed Computing, volume 7, issue 3, pages 149–174, March 1994. doi:10.1007/BF02277859 ↩︎
7 分片

显然,我们必须跳出电脑指令序列的窠臼,不能让计算机受制于此。我们必须陈述定义、指明优先级、描述数据;我们必须阐明关系,而不是编写过程。
Grace Murray Hopper,未来的计算机及其管理(1962)
分布式数据库通常通过两种方式在节点间分布数据:
- 在多个节点上保存相同数据的副本:这就是 复制(replication),我们已在 第 6 章 中讨论过。
- 如果不想让每个节点都存储全部数据,可以将大规模数据集拆成更小的 分片(shard) 或 分区(partition),再把不同分片存放到不同节点上。本章讨论的就是分片。
通常情况下,每条数据(每条记录、每行或每个文档)属于且仅属于一个分片。实现这一点有多种方法,本章将深入讨论其中几种。实际上,每个分片都是自己的小型数据库,尽管有些数据库支持同时涉及多个分片的操作。
分片通常与复制结合使用,使得每个分片的副本存储在多个节点上。这意味着,即使每条记录只属于一个分片,它仍然可以存储在多个不同的节点上以获得容错能力。
一个节点可能存储多个分片。如果使用单主复制模型,则分片和复制的组合可能如 图 7-1 所示。每个分片的领导者被分配给一个节点,追随者被分配给其他节点。每个节点可能是某些分片的领导者,同时是其他分片的追随者,但每个分片仍然只有一个领导者。

我们在 第 6 章 中讨论的关于数据库复制的所有内容,同样适用于分片的复制。大多数情况下,分片方案与复制方案可以独立选择;为简单起见,本章将忽略复制。
本章所谓的 分片,在不同软件中有许多不同名称:Kafka 称其为 分区(partition),CockroachDB 称为 范围(range),HBase 和 TiDB 称为 区域(region),Bigtable 和 YugabyteDB 称为 表分片(tablet),Cassandra、ScyllaDB 和 Riak 称为 虚节点(vnode),Couchbase 则称为 虚桶(vBucket)——这里只列举了其中几种。
一些数据库把分区和分片视为两个不同概念。例如在 PostgreSQL 中,分区是把一张大表拆成存储在同一台机器上的多个文件(这样做有若干好处,比如可以极快地删除整个分区);分片则是把数据集拆分到多台机器上 1 2。而在许多其他系统中,分区不过是分片的另一个名称。
分区 一词相当直白,分片 这个叫法却有些出人意料。一种说法认为,它源于在线角色扮演游戏《网络创世纪》(Ultima Online):游戏里一块魔法水晶碎裂成许多片,每块碎片都映照出一份游戏世界 3。于是,分片 后来指一组并行游戏服务器中的一台,并进一步沿用到了数据库领域。另一种说法是,shard 原本是 System for Highly Available Replicated Data(高可用复制数据系统)的首字母缩写;据说这是 20 世纪 80 年代的一种数据库,但其详情已湮没在历史中。
顺便说一句,分区与 网络分区(network partition,也称 netsplit)毫无关系;后者是节点间网络发生的一类故障,我们将在 第 9 章 中讨论。
分片的利与弊
对数据库进行分片,主要是为了获得 可伸缩性(scalability):当数据量或写入吞吐量大到单个节点无法承受时,分片可以把数据和写入分散到多个节点上。(如果瓶颈是读取吞吐量,则未必需要分片,可以采用 第 6 章 介绍的 读扩展,read scaling。)
事实上,分片是实现 水平扩展(horizontal scaling,也称 横向扩展,scale-out 架构)的主要手段之一,正如 “共享内存、共享磁盘与无共享架构” 所述:系统不必换用更大的机器,而是通过增加更多(较小的)机器来扩充容量。如果能合理划分工作负载,让每个分片承担大致相等的份额,就可以把这些分片分配给不同机器,并行处理其中的数据和查询。
复制可以提供容错和离线运行能力,因而无论规模大小都有用;分片却是一种重量级方案,主要适用于大规模场景。如果数据量和写入吞吐量仍可由单台机器处理(如今单机的能力可不容小觑!),通常最好避免分片,坚持使用单分片数据库。
之所以这样建议,是因为分片往往会增加复杂性。通常需要选择一个 分区键(partition key),据此决定每条记录应放入哪个分片;分区键相同的记录都会进入同一分片 4。这个选择十分重要:如果知道记录在哪个分片,访问就很快;如果不知道,就只能低效地搜索所有分片,而且日后很难更改分片方案。
因此,分片通常很适合键值数据,因为可以直接按键分片;关系数据则比较棘手,因为你可能需要通过二级索引搜索,或连接散落在不同分片中的记录。我们将在 “分片与二级索引” 中进一步讨论这个问题。
分片还有一个问题:一次写入可能需要更新多个不同分片中的相关记录。单节点事务相当普遍(参见 第 8 章),但要保证多个分片之间的一致性,就需要 分布式事务(distributed transaction)。正如 第 8 章 将要说明的,有些数据库支持分布式事务,但这类事务通常比单节点事务慢得多,可能成为整个系统的瓶颈;还有些系统根本不支持分布式事务。
有些系统甚至会在单台机器上使用分片,通常是在每个 CPU 核心上运行一个单线程进程,以利用 CPU 的并行能力;或者利用 非一致性内存访问(NUMA)架构,因为其中某些内存区域离特定 CPU 比其他 CPU 更近 5。例如,Redis、VoltDB 和 FoundationDB 都采用每个核心一个进程的方式,并依靠分片把负载分摊到同一台机器的各个 CPU 核心上 6。
面向多租户的分片
软件即服务(SaaS)产品和云服务通常采用 多租户(multitenant)模式,每个租户对应一个客户。同一租户可以有多个用户账号,但每个租户拥有一份自成一体、与其他租户隔离的数据集。例如在电子邮件营销服务中,每家注册企业通常都是一个独立租户,因为各家企业的简报订阅信息、投递数据等彼此无关。
多租户系统有时通过分片来实现:可以为每个租户分配一个独立分片,也可以把多个小租户归入一个较大的分片。这些分片可以是物理上相互独立的数据库(我们曾在 “嵌入式存储引擎” 中提到),也可以是一个更大逻辑数据库中能够单独管理的组成部分 7。用分片实现多租户有以下优点:
- 资源隔离
- 如果某个租户执行计算开销很大的操作,只要它与其他租户位于不同分片,其他租户的性能就不太容易受到影响。
- 权限隔离
- 如果访问控制逻辑存在漏洞,只要各租户的数据集在物理上彼此隔离,意外让一个租户访问另一租户数据的可能性就会降低。
- 单元化架构
- 分片不仅可以用在数据存储层,也可以用来划分运行应用代码的服务。在 单元化架构(cell-based architecture)中,为一组特定租户服务的应用与存储会组成一个自包含的 单元(cell),不同单元大体可以彼此独立地运行。这种方法能够实现 故障隔离(fault isolation):一个单元里的故障只影响该单元,不会殃及其他单元中的租户 8。
- 按租户备份和恢复
- 分别备份每个租户的分片,就能从备份中恢复某个租户的状态,而不影响其他租户。租户意外删除或覆盖重要数据时,这一能力很有用 9。
- 法规合规性
- GDPR 等数据隐私法规赋予个人访问并删除关于自己的全部存储数据的权利。如果每个人的数据都存放在独立分片中,实现这一权利就只需对相应分片执行简单的数据导出和删除操作 10。
- 数据驻留
- 如果数据驻留法规要求某个租户的数据必须存放在特定司法管辖区,那么区域感知数据库可以把该租户的分片分配到指定区域。
- 逐步推出模式变更
- 模式迁移(前文已在 “文档模型中的模式灵活性” 中讨论)可以逐步推出,每次只迁移一个租户。这样能在问题波及所有租户之前将其发现,从而降低风险,不过很难以事务方式完成 11。
使用分片实现多租户的主要挑战是:
- 这种做法假定每个租户的数据量都足够小,能装进单个节点。如果某个租户大到一台机器容纳不下,就还得在租户内部继续分片,于是问题又回到了为了可伸缩性而分片 12。
- 如果小租户很多,为每个租户单独建立分片的开销可能过大。可以把多个小租户合并到一个较大的分片里,但随着租户成长,又会遇到如何把它从一个分片迁移到另一个分片的问题。
- 如果日后需要支持跨租户关联数据的功能,那么跨多个分片连接数据会使这些功能更难实现。
键值数据的分片
假设你有大量数据并且想要分片,如何决定在哪些节点上存储哪些记录呢?
分片的目标是将数据和查询负载均匀分布在各个节点上。如果每个节点公平分担数据和负载,那么理论上,10 个节点应该能够处理单个节点 10 倍的数据量和 10 倍的读写吞吐量(暂时忽略复制)。此外,在添加或移除节点时,我们希望能够 再平衡(rebalance)负载,使它均匀分布在增加后的 11 个节点上,或移除节点后剩余的 9 个节点上。
如果分片不公平,某些分片承载的数据或查询比其他分片更多,我们就称其为 倾斜(skew)。倾斜会大幅降低分片的效果。在极端情况下,全部负载都可能集中到一个分片上,10 个节点中有 9 个闲置,瓶颈却卡在唯一繁忙的节点上。负载高得不成比例的分片称为 热分片(hot shard)或 热点(hot spot);如果某个键的负载特别高(例如社交网络中的名人账号),则称为 热键(hot key)。
因此,我们需要一种算法,以记录的分区键为输入,指出这条记录属于哪个分片。在键值存储中,分区键通常就是键或键的第一部分;在关系模型中,它可以是表中的某一列,不一定非得是主键。为了缓解热点,这种算法还必须便于再平衡。
按键的范围分片
一种分片方法,是为每个分片指定一段连续的分区键范围(从某个最小值到某个最大值),就像纸质百科全书的各卷,如 图 7-2 所示。在这个例子中,词条标题就是分区键。如果知道各范围之间的边界,就能找到键范围涵盖该标题的卷,轻松确定词条所在的分片,并从书架上取下正确的书。

各段键范围不一定等宽,因为数据本身很可能分布不均。例如在 图 7-2 中,第 1 卷收录以 A 和 B 开头的单词,第 12 卷却收录以 T、U、V、W、X、Y 和 Z 开头的单词。如果简单地规定每两个字母一卷,有些卷就会比其他卷厚得多。为了均匀分布数据,分片边界必须根据数据进行调整。
分片边界既可以由管理员手工选择,也可以由数据库自动确定。例如,Vitess(MySQL 的分片层)采用手动的键范围分片;Bigtable、其开源版本 HBase、MongoDB 的范围分片选项、CockroachDB、RethinkDB 和 FoundationDB 则采用自动方式 6。YugabyteDB 同时支持手动和自动拆分表分片。
每个分片内部都按顺序存储键,例如使用 B 树或 SSTable(参见 第 4 章)。这样很容易执行范围扫描,也可以把键当作联合索引,在一次查询中获取多条相关记录(参见 “多维索引与全文索引”)。例如,某个应用程序存储传感器网络的数据,并以测量时间戳作为键;范围扫描在这里就非常有用,可以轻松取出某个月份的全部读数。
键范围分片的缺点是,如果大量写入集中在相邻的键上,很容易形成热分片。例如,键若是时间戳,分片就对应不同时间范围,比如每个月一个分片。遗憾的是,如果传感器在产生测量值时就立即写入数据库,所有写入都会落到同一个分片(本月的分片)中。结果该分片可能被写入压垮,其他分片却无所事事 13。
为了避免传感器数据库出现这个问题,键的第一部分就不能只用时间戳。例如,可以在每个时间戳前加上传感器 ID,使键先按传感器 ID、再按时间戳排序。只要有许多传感器同时工作,写入负载就会更均匀地分布到各个分片。代价是,要获取多个传感器在某段时间内的测量值,现在必须为每个传感器分别执行一次范围查询。
再平衡键范围分片数据
首次建立数据库时,还没有数据可供划定键范围。一些数据库(如 HBase 和 MongoDB)允许在空数据库上配置一组初始分片,这称为 预拆分(pre-splitting)。采用这种办法,必须事先大致了解键将如何分布,才能选出合适的键范围边界 14。
此后,随着数据量和写入吞吐量增长,采用键范围分片的系统会把现有分片拆成两个或更多较小分片,每个新分片都保存原键范围中的一段连续子范围;这些较小的分片随后可以分散到多个节点上。如果大量数据被删除,几个相邻且已经变小的分片也可能需要合并成一个较大的分片。这个过程类似于 B 树顶层发生的变化(参见 “B 树”)。
对于自动管理分片边界的数据库,分片的拆分通常由以下情况触发:
- 分片达到配置的大小(例如 HBase 默认为 10 GB);或者
- 在某些系统中,写入吞吐量持续高于某个阈值。因此,即使一个热分片存储的数据不多,也可能被拆分,以便将其写入负载分布得更加均匀。
键范围分片的优点是,分片数量能够随数据量调整。数据很少时,只需少量分片,开销也很小;数据量巨大时,每个分片的大小仍会被限制在可配置的上限之内 15。
这种方法的缺点是,拆分分片代价很高:必须把其中的全部数据重写到新文件里,类似于日志结构存储引擎的压实操作。需要拆分的分片往往本就处于高负载,拆分开销还会雪上加霜,甚至使它彻底过载。
按键的哈希分片
如果希望相邻(但不同)的分区键进入同一个分片,键范围分片就很有用,时间戳便是一个例子。如果不关心分区键是否相邻(例如多租户应用中的租户 ID),常见做法是先计算分区键的哈希值,再将它映射到分片。
好的哈希函数可以把倾斜的数据均匀打散。假设有一个接受字符串输入的 32 位哈希函数,每输入一个新字符串,它都会返回一个看似随机、介于 0 和 2³² − 1 之间的数。即使输入字符串非常相似,所得哈希值也会均匀分布在这个范围内(不过相同输入总会产生相同输出)。
用于分片的哈希函数不必具备密码学强度:例如 MongoDB 使用 MD5,Cassandra 和 ScyllaDB 则使用 Murmur3。许多编程语言都内置了用于哈希表的简单哈希函数,但它们未必适合分片。例如,Java 的 Object.hashCode() 和 Ruby 的 Object#hash 可能会让同一个键在不同进程中得到不同哈希值,因此不能用于分片 16。
哈希取模节点数
算出键的哈希值之后,该如何选择存储它的分片?你首先想到的也许是让哈希值对系统中的节点数 取模(许多编程语言使用 % 运算符)。例如,hash(key) % 10 会返回 0 到 9 之间的数;如果把哈希值写成十进制,hash % 10 就是它的末位数字。假设有 10 个节点,编号为 0 到 9,这似乎是把键分配到节点的简单办法。
模 N 方法的问题在于,只要节点数 N 发生变化,大多数键就必须从一个节点移到另一个节点。图 7-3 展示了三个节点增加到四个时的情况。再平衡之前,节点 0 存储哈希值为 0、3、6、9 等的键;加入第四个节点之后,哈希值为 3 的键移到节点 3,哈希值为 6 的键移到节点 2,哈希值为 9 的键移到节点 1,依此类推。

模 N 很容易计算,却会导致极其低效的再平衡,因为大量记录在节点之间进行了不必要的迁移。我们需要一种只移动必要数据的办法。
固定数量的分片
一种简单而常用的解决方案,是创建远多于节点数的分片,再给每个节点分配多个分片。例如,一个运行在 10 节点集群上的数据库可以从一开始就划分成 1,000 个分片,每个节点分得 100 个。键会存入编号为 hash(key) % 1,000 的分片,而系统另行记录每个分片存放在哪个节点上。
如果向集群加入一个节点,系统可以把现有节点上的一部分分片重新分配给新节点,直到分片再次均匀分布。图 7-4 展示了这一过程。移除节点时,则反向执行同样的操作。

在这种模型中,只有完整的分片在节点之间移动,成本低于拆分分片。分片的数量不会改变,键所指定的分片也不会改变;唯一改变的是分片所在的节点。这种变更并非即时——在网络上传输大量数据需要时间——所以传输期间发生的读写,仍按原有的分片到节点映射处理。
分片数量通常会选成一个因数很多的数字,使数据集能够均匀分配到多种不同规模的节点集群中,例如不必要求节点数是 2 的幂 4。甚至还可以照顾集群中的硬件差异:给性能更强的节点分配更多分片,让它们承担更大比例的负载。
Citus(PostgreSQL 的分片层)、Riak、Elasticsearch 和 Couchbase 等系统都采用这种分片方法。只要首次创建数据库时能较准确地估计所需分片数,它就很好用:此后可以轻松增删节点,不过节点数不能超过分片数。
如果发现最初配置的分片数不合适——例如系统规模已经大到所需节点数超过分片数——就必须执行代价高昂的重新分片。这个过程要拆开每个分片、写出新文件,并占用大量额外磁盘空间。有些系统不允许在数据库继续接受写入时重新分片,因此很难在不停机的情况下改变分片数量。
如果数据集总量变化很大(例如开始时很小,随后可能增长许多倍),选择合适的分片数就很困难。由于每个分片包含总数据量的固定比例,其大小会随集群中的数据总量同比增长。分片太大,再平衡和从节点失效中恢复都会十分昂贵;分片太小,又会带来过多管理开销。分片大小不大不小、“恰到好处”时性能最佳,但在分片数固定而数据集大小不断变化时,这一状态很难维持。
按哈希范围分片
如果无法事先预测需要多少分片,最好采用一种能让分片数量轻松适应工作负载的方案。前述键范围分片具备这一性质,但大量写入集中到相邻键时容易形成热点。一种解决办法是将键范围分片与哈希函数结合,使每个分片包含一段 哈希值 范围,而不是一段 键 范围。
图 7-5 展示了一个 16 位哈希函数,它会返回 0 到 65,535 = 2¹⁶ − 1 之间的数(实际使用的哈希通常至少有 32 位)。即使输入键十分相似(例如连续的时间戳),它们的哈希值也会均匀分布在这个范围内。于是,可以为每个分片分配一段哈希值范围:例如 0 到 16,383 归分片 0,16,384 到 32,767 归分片 1,依此类推。

与键范围分片一样,哈希范围分片也可以在分片过大或负载过重时将其拆分。这个操作依然昂贵,但可以按需执行,因此分片数量会随数据量调整,而不是预先固定不变。
它相对于键范围分片的缺点,是无法高效地对分区键执行范围查询,因为范围内的键如今散布在所有分片中。不过,如果键由两列或更多列组成,而分区键只是其中第一列,仍然可以对第二列及之后的列高效执行范围查询:只要范围查询中的所有记录拥有相同分区键,它们就会落在同一个分片中。
BigQuery、Snowflake 和 Delta Lake 等数据仓库也支持类似的索引方式,只是术语有所不同。例如在 BigQuery 中,分区键决定记录属于哪个分区,而“聚簇列”决定记录在分区内的排序方式。Snowflake 会自动把记录分配给“微分区”,但允许用户为表定义聚簇键。Delta Lake 同时支持手动与自动分配分区,也支持聚簇键。对数据进行聚簇,不仅能改善范围扫描的性能,还能提高压缩率和过滤效率。
YugabyteDB 和 DynamoDB 采用哈希范围分片 17,MongoDB 也把它作为一种可选方案。Cassandra 和 ScyllaDB 则采用这种方法的一个变体,如 图 7-6 所示:它们把哈希值空间划分成若干范围,范围数与节点数成正比(图 7-6 中每个节点有 3 个范围;实际默认值是 Cassandra 每个节点 8 个、ScyllaDB 每个节点 256 个),各范围之间的边界随机选定。这样有些范围会比其他范围大,但每个节点拥有多个范围之后,这些不均衡往往能相互抵消 15 18。

添加或移除节点时,系统会相应增删范围边界,并拆分或合并分片 19。在 图 7-6 的例子中,加入节点 3 之后,节点 1 把自己两个范围中的一部分交给节点 3,节点 2 也把一个范围中的一部分交给节点 3。这样,新节点便能分得大致公平的一份数据,同时避免在节点间传输不必要的数据。
一致性哈希
一致性哈希(consistent hashing)算法是一种哈希函数,它把键映射到指定数量的分片,并满足两个性质:
- 映射到各个分片的键数大致相等;
- 分片数量改变时,尽可能少地在分片之间迁移键。
注意,这里的 一致性 与副本一致性(参见 第 6 章)或 ACID 一致性(参见 第 8 章)毫无关系;它描述的是让一个键尽量留在原分片中的倾向。
Cassandra 和 ScyllaDB 的分片算法与一致性哈希的原始定义相似 20,此外还有人提出了多种其他一致性哈希算法 21,例如 最高随机权重(highest random weight,也称 约会哈希,rendezvous hashing)22 和 跳跃一致性哈希(jump consistent hash)23。采用 Cassandra 的算法时,加入一个节点会把少量现有分片拆成若干子范围;采用约会哈希或跳跃一致性哈希时,新节点得到的则是此前散布在所有其他节点上的一个个键。哪种方式更合适,取决于具体应用。
倾斜的工作负载与缓解热点
一致性哈希可以保证键大致均匀地分布到各节点,却不能保证实际负载也同样均匀。如果工作负载高度倾斜——也就是某些分区键下的数据量远大于其他键,或者某些键的请求速率远高于其他键——仍然可能有些服务器不堪重负,另一些服务器却几乎闲置。
例如在社交媒体网站上,一个拥有数百万粉丝的名人做出某个举动,可能引发一场活动风暴 24,进而产生针对同一个键的大量读写(分区键也许是该名人的用户 ID,也许是众人正在评论的事件 ID)。
这种情况需要更加灵活的分片策略 25 26。如果系统按键范围(或哈希范围)定义分片,就可以把一个热键单独放进一个分片,甚至给它分配一台专用机器 27。
也可以在应用层补偿倾斜。例如,如果已知某个键非常热,一种简单办法是在键的开头或末尾添加随机数。只需两位十进制随机数,就能把针对该键的写入均匀拆成 100 个不同的键,让它们分布到不同分片。
不过,写入分散到不同键之后,读取就得付出额外代价:必须从全部 100 个键读取数据,再把结果合并起来。热键分散后,每个分片承受的读取量并没有减少,降低的只有写入负载。这种技术还需要额外的记录工作:只有少数热键值得添加随机数;对于写入吞吐量很低的绝大多数键,这样做只会徒增开销。因此,还需要记录哪些键已被拆分,并设计一个流程,把普通键转换成需要特殊管理的热键。
负载还会随时间变化,使问题更加复杂。例如,某条突然爆火的社交媒体帖子可能连续几天承受很高负载,之后又很快归于平静。此外,有些键是写入热点,有些则是读取热点,二者需要采用不同的处理策略。
一些系统(尤其是面向大规模场景设计的云服务)能够自动处理热分片;例如,Amazon 把相关机制称为 热度管理(heat management)28 或 自适应容量(adaptive capacity)17。这些系统的具体工作方式超出了本书的讨论范围。
运维:自动/手动再平衡
关于再平衡有一个此前略过的重要问题:自动还是手动进行?
有些系统无需人工介入,会自动决定何时拆分分片、何时把分片从一个节点迁移到另一个节点;另一些系统则要求管理员显式配置分片。两者之间也有折中方案:例如,Couchbase 和 Riak 会自动生成建议的分片分配,但必须由管理员确认提交后才会生效。
全自动再平衡很方便,因为日常维护所需的运维工作更少;这样的系统甚至可以自动伸缩,以适应工作负载的变化。DynamoDB 等云数据库宣称,能够在几分钟内自动增删分片,应对负载的大幅升降 17 29。
然而,自动分片管理也可能难以预测。再平衡代价很高,因为它要重新路由请求,并在节点间迁移大量数据。如果处理不够谨慎,这一过程可能使网络或节点过载,拖累其他请求的性能。系统在再平衡期间还必须继续处理写入;如果已经接近最大写入吞吐量,分片拆分的速度甚至可能赶不上新写入到达的速度 29。
这种自动化机制如果再与自动失效检测结合,可能十分危险。假设某个节点过载,暂时无法及时响应请求;其他节点据此断定它已经失效,于是自动对集群进行再平衡,把负载从该节点移走。这会给其他节点和网络施加额外负载,让局面进一步恶化,甚至引发级联失效:其他节点也相继过载,并被错误地判定为已经宕机。
出于这个原因,让人参与再平衡过程是一件好事。这比全自动流程慢,但有助于防止运维意外。
请求路由
我们已经讨论了如何把数据集分片到多个节点,以及如何在增删节点时再平衡这些分片。现在来看下一个问题:如果想读写某个特定的键,怎样知道应该连接哪个节点——也就是哪个 IP 地址和端口?
这个问题称为 请求路由(request routing),与前文 “负载均衡器、服务发现和服务网格” 讨论的 服务发现(service discovery)十分相似。二者最大的区别在于:运行应用代码的服务实例通常是无状态的,负载均衡器可以把请求发给任意实例;而在分片数据库中,某个键的请求只能交给持有该键所在分片副本的节点处理。
因此,请求路由必须了解键到分片、以及分片到节点的映射。概括来说,有以下几种办法(如 图 7-7 所示):
- 允许客户端连接任意节点(例如通过轮询负载均衡器)。如果该节点恰好持有请求涉及的分片,就直接处理请求;否则,它把请求转发给正确的节点,收到响应后再转交给客户端。
- 客户端的所有请求都先发送到一个路由层,由路由层判断哪个节点应当处理每个请求,再相应地转发。路由层本身并不处理请求,只充当一个能够感知分片的负载均衡器。
- 让客户端了解分片方式以及分片到节点的分配关系。这样,客户端无须经过任何中间层,就能直接连接到正确的节点。

在所有情况下,都有一些关键问题:
- 由谁决定每个分片应当放在哪个节点?最简单的办法是由单一协调者来决定,但如果运行协调者的节点宕机,怎样让协调者具备容错能力?如果协调者能够故障切换到另一个节点,又该如何防止发生脑裂(参见 “处理节点故障”),让两个协调者作出相互矛盾的分片分配?
- 负责路由的组件(可以是某个数据库节点、路由层或客户端)怎样得知分片到节点的分配发生了变化?
- 分片从一个节点迁移到另一个节点时,会有一段切换期:新节点已经接管,但发往旧节点的请求可能仍在途中。应当如何处理这些请求?
许多分布式数据系统依靠 ZooKeeper、etcd 等独立协调服务来记录分片分配,如 图 7-8 所示。这些服务使用共识算法(参见 第 10 章)实现容错并防止脑裂。每个节点都在 ZooKeeper 中注册,ZooKeeper 维护分片到节点的权威映射;路由层或能够感知分片的客户端等其他参与者,可以订阅 ZooKeeper 中的信息。只要分片易主,或有节点加入、退出,ZooKeeper 就会通知路由层,使其路由信息保持最新。

例如,HBase 和 SolrCloud 使用 ZooKeeper 管理分片分配,Kubernetes 使用 etcd 记录每个服务实例的运行位置。MongoDB 的架构与之相似,不过它依靠自有的 配置服务器(config server)实现,并以 mongos 守护进程作为路由层。Kafka、YugabyteDB 和 TiDB 则使用内置的 Raft 共识协议实现这项协调功能。
Cassandra、ScyllaDB 和 Riak 采用另一种办法:节点之间通过 流言协议(gossip protocol)传播集群状态的变化。它提供的一致性比共识协议弱得多,因而可能出现脑裂,使集群的不同部分对同一个分片持有不同的节点分配。无主数据库可以容忍这种情况,因为它们本就只提供较弱的一致性保证(参见 “仲裁一致性的局限”)。
无论使用路由层还是把请求发送给随机节点,客户端仍然要先找到可供连接的 IP 地址。IP 地址的变化没有分片到节点的分配那么频繁,因此通常用 DNS 就足够了。
以上请求路由主要关注如何为单个键找到对应分片,这最适用于分片的 OLTP 数据库。分析型数据库通常也会分片,但其查询执行方式截然不同:查询一般不是在单个分片中执行,而是要并行聚合并连接来自许多分片的数据。我们将在 “JOIN 与 GROUP BY” 中讨论这类并行查询执行技术。
分片与二级索引
到目前为止讨论的分片方案,都要求客户端知道待访问记录的分区键。这在键值数据模型中最容易做到:分区键是主键的第一部分(或整个主键),因此可以据此确定分片,并把读写请求路由到负责该键的节点。
涉及二级索引时,情况会复杂得多(另见 “多列索引与二级索引”)。二级索引通常不能唯一标识一条记录,而是用来搜索某个特定值出现在哪里:例如,查找用户 123 的所有操作、所有包含单词 hogwash 的文章,或所有颜色为 red 的汽车。
键值存储通常没有二级索引,但它是关系数据库的基础能力,在文档数据库中也十分常见,更是 Solr、Elasticsearch 等全文检索引擎的 立身之本。二级索引的问题在于,它无法干净利落地映射到分片。对带有二级索引的数据库进行分片,主要有两种办法:本地索引和全局索引。
本地二级索引
假设你正在运营一个二手车交易网站(如 图 7-9 所示)。每条车辆信息都有唯一 ID,并以该 ID 作为分区键进行分片(例如,ID 0 到 499 归分片 0,ID 500 到 999 归分片 1,依此类推)。
如果要让用户搜索车辆,并按颜色与品牌筛选,就需要在 color 和 make 上建立二级索引(在文档数据库中它们是字段,在关系数据库中则是列)。声明索引后,数据库会自动维护它。例如,每增加一辆红色汽车,所在分片就会自动把它的 ID 加入索引条目 color:red 对应的 ID 列表。正如 第 4 章 所述,这种 ID 列表也称为 倒排列表(postings list)。

如果数据库只支持键值模型,你也许会想在应用代码中建立值到 ID 的映射,自行实现二级索引。如果选择这条路,务必万分小心,确保索引与底层数据始终一致。竞态条件和间歇性写入失败(有些变更保存成功,另一些却没有)很容易让两者失去同步——参见 “多对象事务的需求”。
在这种索引方式中,每个分片都完全独立:各自维护自己的二级索引,只覆盖本分片中的记录,而不关心其他分片保存了什么数据。每次写入数据库——添加、删除或更新记录——只需处理包含该记录的分片。因此,这种二级索引称为 本地索引(local index);在信息检索领域,它也称为 按文档分区的索引(document-partitioned index)30。
读取本地二级索引时,如果已经知道目标记录的分区键,就只需在对应分片上搜索。如果只想获得 部分 结果而不要求全部,也可以把请求发给任意分片。
但是,如果需要全部结果,又事先不知道这些记录的分区键,就必须把查询发送到所有分片,再合并返回结果,因为匹配的记录可能散布在每个分片中。在 图 7-9 中,分片 0 和分片 1 都有红色汽车。
这种查询分片数据库的方式,会让二级索引上的读取查询变得相当昂贵。即使并行查询所有分片,也很容易出现尾部延迟放大(参见 “响应时间指标的应用”)。它还会限制应用的可伸缩性:增加分片能容纳更多数据,但如果每次查询仍要由所有分片处理,查询吞吐量并不会随之提高。
尽管如此,本地二级索引依然应用广泛 31:MongoDB、Riak、Cassandra 32、Elasticsearch 33、SolrCloud 和 VoltDB 34 都采用这种索引。
全局二级索引
除了让每个分片各自维护本地二级索引,也可以构建一个覆盖所有分片数据的 全局索引(global index)。不过,不能只把这个索引存放在单个节点上,否则它很可能成为瓶颈,使分片失去意义。因此全局索引本身也必须分片,但可以采用与主键索引不同的分片方式。
图 7-10 展示了它可能采用的形式:来自所有分片的红色汽车 ID 都列在索引的 color:red 条目下;索引本身则经过分片,以字母 a 到 r 开头的颜色归分片 0,以 s 到 z 开头的颜色归分片 1。汽车品牌索引也以类似方式分片,边界位于 f 与 h 之间。

这种索引也称为 按词项分区(term-partitioned)30。回顾 “全文检索”:在全文检索中,词项(term)是文本中可供搜索的关键字;这里我们把它推广为二级索引中任何可供搜索的值。
全局索引以词项作为分区键,因此查找某个词项或值时,可以直接确定需要查询哪个分片。和前面一样,每个分片可以包含一段连续的词项范围(如 图 7-10 所示),也可以根据词项的哈希值把词项分配到各个分片。
全局索引的优点是,如果查询只有一个条件(如 color = red),只需读取一个分片就能取得倒排列表。不过,如果想要的不只是 ID,而是完整记录,仍需读取负责存储这些 ID 的所有分片。
如果查询包含多个条件或词项(例如搜索某种颜色且属于某个品牌的汽车,或搜索同一段文本中同时出现的多个单词),这些词项很可能分属不同分片。为了计算两个条件的逻辑 AND,系统必须找出同时出现在两个倒排列表中的 ID。倒排列表较短时并不难;但如果列表很长,通过网络传输它们再计算交集,速度就可能很慢 30。
全局二级索引的另一个难题,是写入比本地索引复杂:写入一条记录可能影响索引的多个分片(文档中的每个词项都可能位于不同分片)。因此,二级索引很难与底层数据保持同步。一种办法是使用分布式事务,以原子方式更新保存主记录的分片及其二级索引分片(参见 第 8 章)。
CockroachDB、TiDB 和 YugabyteDB 都使用全局二级索引;DynamoDB 则同时支持本地和全局二级索引。在 DynamoDB 中,写入会异步反映到全局索引,因此从全局索引读到的结果可能是陈旧的(类似于 “复制延迟的问题”)。尽管如此,如果读取吞吐量高于写入吞吐量,而且倒排列表不太长,全局索引仍然很有用。
总结
在本章中,我们探讨了将大数据集划分成更小子集的不同方法。数据量非常大的时候,在单台机器上存储和处理不再可行,而分片则十分必要。
分片的目标是在多台机器上均匀分布数据和查询负载,避免出现热点(负载不成比例的节点)。这需要选择适合数据的分片方案,并在将节点添加到集群或从集群删除时重新平衡分片。
我们讨论了两种主要的分片方法:
键范围分片:键按顺序排列,每个分片拥有从某个最小值到某个最大值之间的所有键。有序存储的优点是能够高效执行范围查询,但如果应用经常访问排序位置彼此接近的键,就可能形成热点。
采用这种方法时,分片过大之后通常会把键范围拆成两个子范围,从而动态地再平衡分片。
哈希分片:先对每个键应用哈希函数,每个分片拥有一段哈希值范围(也可以采用其他一致性哈希算法,把哈希映射到分片)。这种方法破坏了键的顺序,使范围查询效率降低,却可能让负载分布得更加均匀。
按哈希分片时,通常会预先创建固定数量的分片,给每个节点分配多个分片;增删节点时,再把整个分片从一个节点迁移到另一个节点。也可以像键范围分片那样拆分分片。
常见做法是以键的第一部分作为分区键(即用来确定分片),再按键的其余部分对分片内的记录排序。这样,对于分区键相同的记录,仍然可以高效执行范围查询。
我们还讨论了分片与二级索引的相互作用。二级索引也需要分片,有两种方法:
- 本地二级索引:二级索引与主键及其值存储在同一个分片。因此写入时只需更新一个分片,但查找二级索引时必须读取所有分片。
- 全局二级索引:根据索引值采用另一套分片方式。二级索引条目可以引用来自主键任意分片的记录。写入记录时,可能需要更新多个二级索引分片;但读取倒排列表时,只需访问一个分片(获取实际记录仍然要读取多个分片)。
最后,我们讨论了如何把查询路由到正确的分片,以及如何通过协调服务记录分片到节点的分配关系。
从设计上说,每个分片大体独立运行——正因如此,分片数据库才能伸缩到多台机器。然而,需要写入多个分片的操作会变得很棘手:例如,一个分片写入成功,另一个分片却失败时会怎样?我们将在接下来的章节中回答这个问题。
参考文献
Claire Giordano. Understanding partitioning and sharding in Postgres and Citus. citusdata.com, August 2023. Archived at perma.cc/8BTK-8959 ↩︎
Brandur Leach. Partitioning in Postgres, 2022 edition. brandur.org, October 2022. Archived at perma.cc/Z5LE-6AKX ↩︎
Raph Koster. Database “sharding” came from UO? raphkoster.com, January 2009. Archived at perma.cc/4N9U-5KYF ↩︎
Garrett Fidalgo. Herding elephants: Lessons learned from sharding Postgres at Notion. notion.com, October 2021. Archived at perma.cc/5J5V-W2VX ↩︎ ↩︎
Ulrich Drepper. What Every Programmer Should Know About Memory. akkadia.org, November 2007. Archived at perma.cc/NU6Q-DRXZ ↩︎
Jingyu Zhou, Meng Xu, Alexander Shraer, Bala Namasivayam, Alex Miller, Evan Tschannen, Steve Atherton, Andrew J. Beamon, Rusty Sears, John Leach, Dave Rosenthal, Xin Dong, Will Wilson, Ben Collins, David Scherer, Alec Grieser, Young Liu, Alvin Moore, Bhaskar Muppana, Xiaoge Su, and Vishesh Yadav. FoundationDB: A Distributed Unbundled Transactional Key Value Store. At ACM International Conference on Management of Data (SIGMOD), June 2021. doi:10.1145/3448016.3457559 ↩︎ ↩︎
Marco Slot. Citus 12: Schema-based sharding for PostgreSQL. citusdata.com, July 2023. Archived at perma.cc/R874-EC9W ↩︎
Robisson Oliveira. Reducing the Scope of Impact with Cell-Based Architecture. AWS Well-Architected white paper, Amazon Web Services, September 2023. Archived at perma.cc/4KWW-47NR ↩︎
Gwen Shapira. Things DBs Don’t Do - But Should. thenile.dev, February 2023. Archived at perma.cc/C3J4-JSFW ↩︎
Malte Schwarzkopf, Eddie Kohler, M. Frans Kaashoek, and Robert Morris. Position: GDPR Compliance by Construction. At Towards Polystores that manage multiple Databases, Privacy, Security and/or Policy Issues for Heterogenous Data (Poly), August 2019. doi:10.1007/978-3-030-33752-0_3 ↩︎
Gwen Shapira. Introducing pg_karnak: Transactional schema migration across tenant databases. thenile.dev, November 2024. Archived at perma.cc/R5RD-8HR9 ↩︎
Arka Ganguli, Guido Iaquinti, Maggie Zhou, and Rafael Chacón. Scaling Datastores at Slack with Vitess. slack.engineering, December 2020. Archived at perma.cc/UW8F-ALJK ↩︎
Ikai Lan. App Engine Datastore Tip: Monotonically Increasing Values Are Bad. ikaisays.com, January 2011. Archived at perma.cc/BPX8-RPJB ↩︎
Enis Soztutar. Apache HBase Region Splitting and Merging. cloudera.com, February 2013. Archived at perma.cc/S9HS-2X2C ↩︎
Eric Evans. Rethinking Topology in Cassandra. At Cassandra Summit, June 2013. Archived at perma.cc/2DKM-F438 ↩︎ ↩︎
Martin Kleppmann. Java’s hashCode Is Not Safe for Distributed Systems. martin.kleppmann.com, June 2012. Archived at perma.cc/LK5U-VZSN ↩︎
Mostafa Elhemali, Niall Gallagher, Nicholas Gordon, Joseph Idziorek, Richard Krog, Colin Lazier, Erben Mo, Akhilesh Mritunjai, Somu Perianayagam, Tim Rath, Swami Sivasubramanian, James Christopher Sorenson III, Sroaj Sosothikul, Doug Terry, and Akshat Vig. Amazon DynamoDB: A Scalable, Predictably Performant, and Fully Managed NoSQL Database Service. At USENIX Annual Technical Conference (ATC), July 2022. ↩︎ ↩︎ ↩︎
Brandon Williams. Virtual Nodes in Cassandra 1.2. datastax.com, December 2012. Archived at perma.cc/N385-EQXV ↩︎
Branimir Lambov. New Token Allocation Algorithm in Cassandra 3.0. datastax.com, January 2016. Archived at perma.cc/2BG7-LDWY ↩︎
David Karger, Eric Lehman, Tom Leighton, Rina Panigrahy, Matthew Levine, and Daniel Lewin. Consistent Hashing and Random Trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web. At 29th Annual ACM Symposium on Theory of Computing (STOC), May 1997. doi:10.1145/258533.258660 ↩︎
Damian Gryski. Consistent Hashing: Algorithmic Tradeoffs. dgryski.medium.com, April 2018. Archived at perma.cc/B2WF-TYQ8 ↩︎
David G. Thaler and Chinya V. Ravishankar. Using name-based mappings to increase hit rates. IEEE/ACM Transactions on Networking, volume 6, issue 1, pages 1–14, February 1998. doi:10.1109/90.663936 ↩︎
John Lamping and Eric Veach. A Fast, Minimal Memory, Consistent Hash Algorithm. arxiv.org, June 2014. ↩︎
Samuel Axon. 3% of Twitter’s Servers Dedicated to Justin Bieber. mashable.com, September 2010. Archived at perma.cc/F35N-CGVX ↩︎
Gerald Guo and Thawan Kooburat. Scaling services with Shard Manager. engineering.fb.com, August 2020. Archived at perma.cc/EFS3-XQYT ↩︎
Sangmin Lee, Zhenhua Guo, Omer Sunercan, Jun Ying, Thawan Kooburat, Suryadeep Biswal, Jun Chen, Kun Huang, Yatpang Cheung, Yiding Zhou, Kaushik Veeraraghavan, Biren Damani, Pol Mauri Ruiz, Vikas Mehta, and Chunqiang Tang. Shard Manager: A Generic Shard Management Framework for Geo-distributed Applications. 28th ACM SIGOPS Symposium on Operating Systems Principles (SOSP), pages 553–569, October 2021. doi:10.1145/3477132.3483546 ↩︎
Scott Lystig Fritchie. A Critique of Resizable Hash Tables: Riak Core & Random Slicing. infoq.com, August 2018. Archived at perma.cc/RPX7-7BLN ↩︎
Andy Warfield. Building and operating a pretty big storage system called S3. allthingsdistributed.com, July 2023. Archived at perma.cc/6S7P-GLM4 ↩︎
Rich Houlihan. DynamoDB adaptive capacity: smooth performance for chaotic workloads (DAT327). At AWS re:Invent, November 2017. ↩︎ ↩︎
Christopher D. Manning, Prabhakar Raghavan, and Hinrich Schütze. Introduction to Information Retrieval. Cambridge University Press, 2008. ISBN: 978-0-521-86571-5, available online at nlp.stanford.edu/IR-book ↩︎ ↩︎ ↩︎
Michael Busch, Krishna Gade, Brian Larson, Patrick Lok, Samuel Luckenbill, and Jimmy Lin. Earlybird: Real-Time Search at Twitter. At 28th IEEE International Conference on Data Engineering (ICDE), April 2012. doi:10.1109/ICDE.2012.149 ↩︎
Nadav Har’El. Indexing in Cassandra 3. github.com, April 2017. Archived at perma.cc/3ENV-8T9P ↩︎
Zachary Tong. Customizing Your Document Routing. elastic.co, June 2013. Archived at perma.cc/97VM-MREN ↩︎
Andrew Pavlo. H-Store Frequently Asked Questions. hstore.cs.brown.edu, October 2013. Archived at perma.cc/X3ZA-DW6Z ↩︎
8 事务

有些作者声称,通用的两阶段提交代价太高,会带来性能或可用性问题。我们认为,与其让应用程序员始终为缺少事务而另想办法,不如等事务被过度使用并形成瓶颈时,再由他们处理相应的性能问题。
James Corbett 等人,Spanner:Google 的全球分布式数据库(2012)
在数据系统的残酷现实中,许多事情都可能出错:
- 数据库软件或硬件随时可能发生故障(包括写操作进行到一半时)。
- 应用程序可能在任意时刻崩溃(包括一系列操作的中间)。
- 网络中断可能会意外切断应用程序与数据库之间,或数据库节点彼此之间的连接。
- 多个客户端可能会同时写入数据库,覆盖彼此的更改。
- 客户端可能读取到无意义的数据,因为数据只更新了一部分。
- 客户端之间的竞态条件可能导致令人惊讶的错误。
要做到可靠,系统就必须处理这些故障,确保它们不会导致整个系统灾难性地失效。然而,实现容错机制的工作量很大:既要审慎考虑所有可能出错的情况,又要经过大量测试,才能确保解决方案真正有效。
数十年来,事务(transaction)一直是简化这些问题的首选机制。应用程序通过事务将多个读写操作组合成一个逻辑单元。从概念上讲,事务中的所有读写被当作一次操作执行:整个事务要么成功(提交,commit),要么失败(中止,abort;回滚,rollback)。如果失败,应用程序可以安全重试。有了事务,应用程序的错误处理就简单多了,因为它不必担心部分失效——即无论出于何种原因,有些操作成功、有些操作失败。
如果你与事务打了多年交道,可能会觉得这一切理所当然,但事务并非自然法则。人们创造事务自有其目的:简化 访问数据库的 应用编程模型(programming model)。有了事务,应用程序便可以不去考虑某些潜在的错误场景和并发问题,因为数据库会代为处理这些问题(我们称之为 安全保证,safety guarantee)。
并非所有应用程序都需要事务;有时弱化事务保证,甚至彻底放弃事务也有好处(例如为了提高性能或可用性)。有些安全属性也可以在没有事务的情况下实现。另一方面,事务能够避免许多麻烦:例如,邮局 Horizon 丑闻(参见“可靠性有多重要?”)背后的技术原因,很可能就是底层会计系统缺少 ACID 事务1。
怎样判断自己是否需要事务?要回答这个问题,首先必须确切理解事务能提供哪些安全保证,以及需要为此付出什么代价。事务乍看简单,其中却有许多微妙而重要的细节。
本章将考察许多可能出错的案例,并探讨数据库用来防范这些问题的算法。我们尤其会深入 并发控制(concurrency control)领域,讨论可能出现的各种竞态条件,以及数据库如何实现 读已提交(read committed)、快照隔离(snapshot isolation)和 可串行化(serializable)等隔离级别。
无论对单节点数据库还是分布式数据库,并发控制都很重要。在本章稍后的“分布式事务”一节中,我们将考察 两阶段提交(two-phase commit,2PC)协议,以及在分布式事务中实现原子性所面临的挑战。
事务到底是什么?
如今,几乎所有关系型数据库和一部分非关系数据库都支持事务。它们大多沿袭 1975 年由第一个 SQL 数据库 IBM System R 开创的风格2 3 4。尽管一些实现细节发生了变化,但 50 年来总体思路几乎原封未动:MySQL、PostgreSQL、Oracle 和 SQL Server 等数据库的事务支持与 System R 异乎寻常地相似。
2000 年代后期,非关系型(NoSQL)数据库开始流行。它们试图打破关系型数据库的既有格局:不仅提供新的数据模型选择(参见第 3 章),还默认内置复制(第 6 章)和分片(第 7 章)。事务成了这场运动的主要牺牲品:这一代数据库中,许多彻底放弃了事务,或者重新定义了“事务”一词,用它来描述一套远弱于以往认识的保证。
围绕 NoSQL 分布式数据库的炒作催生了一种流行观点:事务从根本上无法伸缩,任何大规模系统若想保持良好性能和高可用性,都必须放弃事务。近来事实已经证明这种观点是错误的。CockroachDB5、TiDB6、Spanner7、FoundationDB8 和 YugabyteDB 等所谓的“NewSQL”数据库表明,事务系统同样可以扩展到很大的数据量和很高的吞吐量。这些系统将分片与共识协议(第 10 章)结合起来,从而在大规模场景下提供强 ACID 保证。
不过,这也不意味着每个系统都必须支持事务。和其他技术设计选择一样,事务既有优势,也有局限。要理解其中的权衡,就必须深入了解事务究竟能提供哪些保证——无论是在正常运行时,还是在各种极端但切实可能发生的情况下。
ACID 的含义
事务提供的安全保证,通常用众所周知的首字母缩略词 ACID 来描述,分别代表 原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)和 持久性(Durability)。Theo Härder 和 Andreas Reuter 于 1983 年提出了这一术语9,试图为数据库的容错机制建立一套精确的表述。
然而在实践中,不同数据库对 ACID 的实现并不相同。例如,我们很快就会看到,隔离性 的含义存在许多歧义10。总体思路固然合理,魔鬼却藏在细节里。如今,一个系统即便声称自己“符合 ACID”,你也很难知道它究竟提供哪些保证。遗憾的是,ACID 基本上已经沦为营销术语。
(不符合 ACID 标准的系统有时称为 BASE,即 基本可用(Basically Available)、软状态(Soft State)和 最终一致性(Eventual Consistency)11。这个定义比 ACID 还要模糊。BASE 唯一说得通的定义似乎就是“非 ACID”;换句话说,它几乎可以任人解释。)
下面深入了解原子性、一致性、隔离性和持久性的定义,以便进一步厘清事务的含义。
原子性
一般而言,原子 是指不可再分的事物。这个词在计算机的不同领域中含义相近,却又有细微差别。例如在多线程编程中,如果一个线程执行原子操作,另一个线程就不可能看到该操作只完成一半的结果。系统只能处于操作之前或之后的状态,而不会处于两者之间。
相比之下,ACID 中的原子性与并发 无关。它并不描述多个进程同时访问相同数据时会发生什么;那是字母 I 所代表的 隔离性 要处理的问题(参见“隔离性”)。
ACID 的原子性描述的是另一类情况:客户端想执行多次写入,却在其中一些写入处理完毕后遇到故障——例如进程崩溃、网络连接中断、磁盘空间耗尽,或者违反了某项完整性约束。如果这些写入被组合到一个原子事务中,而故障使事务无法完成(提交),那么事务就会 中止,数据库必须丢弃或撤销该事务此前完成的所有写入。
如果没有原子性,在多项变更执行到一半时发生错误,应用程序很难知道哪些变更已经生效、哪些尚未生效。它可以再试一次,却可能把同一项变更执行两遍,造成重复或错误的数据。原子性简化了这个问题:如果事务已经中止,应用程序便能确定它没有改变任何内容,因此可以安全重试。
遇到错误时中止事务,并丢弃该事务的所有写入,正是 ACID 原子性的定义性特征。或许称为 可中止性(abortability)比 原子性 更贴切,但既然“原子性”是惯用说法,本书仍沿用这一术语。
一致性
一致性 这个词被严重滥用:
- 在第 6 章中,我们讨论了 副本一致性,以及异步复制系统中的 最终一致性 问题(参见“复制延迟的问题”)。
- 数据库的 一致快照(例如用于备份)是整个数据库在某一时刻的快照。更准确地说,它与先发生关系(happens-before relation)一致(参见“‘先发生’关系与并发”):如果快照包含某个时刻写入的值,那么它也会反映发生在这次写入之前的所有写入。
- 一致性哈希 是某些系统在再平衡时采用的一种分片方法(参见“一致性哈希”)。
- 在 CAP 定理中(参见第 10 章),一致性 一词指的是 线性一致性(参见“线性一致性”)。
- 在 ACID 的语境下,一致性 指的是由具体应用定义的数据库“良好状态”。
遗憾的是,同一个词竟有至少五种不同的含义。
ACID 一致性的基本思想是:关于数据的某些陈述(即 不变式,invariant)必须始终成立。例如,在会计系统中,所有账户的贷记与借记必须始终相抵。如果事务开始时数据库满足这些不变式,事务中的所有写入又能维持其有效性,就可以确信不变式始终成立。(不变式在事务执行期间可以暂时被打破,但到事务提交时必须重新得到满足。)
如果希望由数据库强制执行不变式,就需要把它们声明为模式中的 约束(constraint)。外键约束、唯一性约束或检查约束(限制单行中可以出现的值)常用来表达特定类型的不变式。更复杂的一致性要求有时也可以用触发器或物化视图来表达12。
不过,数据库通常提供的约束可能很难、甚至根本无法表达复杂的不变式。此时,应用程序就有责任正确定义事务,使其维持一致性。如果应用写入了违反不变式的错误数据,却没有事先声明这些不变式,数据库也无从阻止。因此,ACID 中的 C 往往取决于应用程序如何使用数据库,并非数据库自身的属性。
隔离性
大多数数据库都会同时接受多个客户端的访问。如果各客户端读写数据库的不同部分,自然没有问题;但如果它们访问相同的数据库记录,就可能遇到并发问题(竞态条件)。
图 8-1给出了这类问题的一个简单例子。假设两个客户端同时递增数据库中的一个计数器。每个客户端都要读取当前值,将其加 1,再把新值写回去(假设数据库没有内置的递增操作)。在图 8-1中,计数器经过两次递增,本应从 42 变成 44,却因竞态条件最终只变成了 43。

ACID 意义上的 隔离性 是指并发执行的事务彼此隔离,不能相互干扰。经典数据库教科书将隔离性形式化为 可串行化:每个事务都可以假装自己是整个数据库中唯一正在运行的事务。数据库保证,所有事务提交后的结果与它们 串行 运行(逐个运行)的结果相同,尽管实际上这些事务可能是并发执行的13。
然而,可串行化是有性能代价的。实践中,许多数据库采用弱于可串行化的隔离形式,也就是允许并发事务在有限范围内相互干扰。一些流行数据库(例如 Oracle)甚至没有实现可串行化:Oracle 虽有一个名为“可串行化”的隔离级别,实际实现的却是保证更弱的 快照隔离10 14。因此,某些竞态条件仍有可能发生。我们将在“弱隔离级别”中考察快照隔离和其他隔离形式。
持久性
数据库系统的目的,是提供一个可以放心存放数据而无须担心丢失的安全场所。持久性 作出这样的承诺:事务一旦成功提交,其写入的任何数据都不会遗失,即使发生硬件故障或数据库崩溃也不例外。
在单节点数据库中,持久性通常意味着数据已经写入硬盘或 SSD 等非易失性存储。普通文件写入通常会先在内存中缓冲,稍后才送往磁盘,突然断电时便可能丢失;因此,许多数据库使用 fsync() 系统调用,确保数据确实已经落盘。数据库通常还有预写日志或类似机制(参见“使 B 树可靠”),以便在写入中途崩溃后恢复。
在复制数据库中,持久性可能意味着数据已经成功复制到一定数量的节点。数据库必须等到这些写入或复制操作完成,才能报告事务已成功提交。不过,正如“可靠性与容错”所说,完美的持久性并不存在:如果所有硬盘和备份同时被毁,数据库显然也无能为力。
历史上,持久性意味着写入归档磁带;后来,它指写入磁盘或 SSD;近来,这个概念又被扩展到复制。哪种实现更好?
事实是,没有一种方案十全十美:
- 如果数据写入磁盘后机器宕机,那么即使数据没有丢失,在修好机器或把磁盘转移到另一台机器之前也无法访问。复制系统则可以继续保持可用。
- 关联故障——例如停电,或某个缺陷使所有节点在遇到特定输入时崩溃——可能一次击垮所有副本(参见“可靠性与容错”),使仅存在内存中的数据全部丢失。因此,即使是复制数据库,写入磁盘仍然很重要。
- 在异步复制系统中,领导者不可用时,最近的写入可能丢失(参见“处理节点故障”)。
- 突然断电时,SSD 尤其可能违背它本应提供的保证:甚至
fsync也不一定能正常发挥作用15。和其他软件一样,磁盘固件也会有缺陷16 17;例如,某种缺陷会让硬盘在恰好运行 32,768 小时后失效18。此外,fsync很难正确使用,就连 PostgreSQL 也曾错误使用它长达 20 多年19 20 21。 - 存储引擎与文件系统实现之间的微妙交互,可能引发难以追查的缺陷,使磁盘文件在崩溃后损坏22 23。一个副本上的文件系统错误有时还会蔓延到其他副本24。
- 磁盘上的数据可能在无人察觉的情况下逐渐损坏25。如果损坏已经持续了一段时间,副本和近期备份也可能同样受损。此时只能尝试从更早的历史备份中恢复数据。
- 一项 SSD 研究发现,驱动器在投入使用后的头四年里,有 30% 到 80% 会出现至少一个坏块,而且只有一部分坏块能由固件纠正26。机械硬盘的坏扇区率较低,但彻底失效的概率高于 SSD。
- 磨损严重(经历了大量写入/擦除周期)的 SSD 断电后,可能在数周至数月内开始丢失数据,具体时间取决于温度27。磨损程度较低的驱动器则没有这么严重28。
实践中,没有任何一种技术能提供绝对保证,只有写入磁盘、复制到远程机器和备份等降低风险的手段——它们可以、也应该组合使用。一如既往,面对任何理论上的“保证”,都应保持适度怀疑。
单对象与多对象操作
回顾一下,在 ACID 中,原子性和隔离性描述了客户端在同一事务中进行多次写入时,数据库应当如何处理:
- 原子性
- 如果一系列写入执行到一半时发生错误,事务就应中止,之前完成的写入也应丢弃。换句话说,数据库以“全有或全无”的保证,免去你对部分失效的担忧。
- 隔离性
- 并发运行的事务不应相互干扰。例如,一个事务进行了多次写入,另一个事务就应当要么看到全部写入,要么一项也看不到,而不能只看到其中一部分。
这些定义假设你想同时修改多个对象(行、文档或记录)。当多项数据需要保持同步时,通常就要用到这种 多对象事务。图 8-2展示了一个电子邮件应用的例子。要显示用户的未读邮件数,可以执行如下查询:

不过,邮件数量很多时,这条查询可能太慢,于是你决定把未读邮件数另存到一个单独的字段中(这是一种反规范化,参见“规范化、反规范化与连接”)。这样,每当新邮件到达时,就必须递增未读计数器;每当邮件被标为已读时,也必须递减该计数器。
在图 8-2中,用户 2 遇到了异常:邮箱列表中已经出现一封未读邮件,未读计数却仍为零,因为计数器尚未递增。(如果电子邮件应用中的错误计数无关紧要,不妨把未读计数换成客户账户余额,把邮件换成支付事务。)隔离性可以防止这个问题:它保证用户 2 要么同时看到新插入的邮件和更新后的计数,要么两者都看不到,而不会看到不一致的中间状态。
图 8-3说明了为何需要原子性:如果事务进行到一半时发生错误,邮箱内容和未读计数可能失去同步。在原子事务中,如果计数器更新失败,事务就会中止,已经插入的邮件也会回滚。

多对象事务需要某种方式来确定哪些读写操作属于同一个事务。在关系型数据库中,这通常以客户端到数据库服务器的 TCP 连接为依据:同一条连接上,BEGIN TRANSACTION 与 COMMIT 语句之间的所有操作都属于同一个事务。如果 TCP 连接中断,事务就必须中止。
另一方面,许多非关系型数据库并没有这种组合操作的机制。即便提供了多对象 API(例如键值存储可能提供一次更新多个键的 multi-put 操作),也不一定具备事务语义:命令可能只更新了其中一些键,另一些却失败了,使数据库停留在部分更新的状态。
单对象写入
原子性和隔离性也适用于单个对象的变更。例如,假设你正在向数据库写入一份 20 KB 的 JSON 文档:
- 如果前 10 KB 发送完毕后网络连接中断,数据库会不会存下一段无法解析的 10 KB JSON 残片?
- 如果数据库覆盖磁盘上的旧值时突然断电,最后会不会把新旧值拼接在一起?
- 如果另一个客户端在写入过程中读取该文档,会不会看到只更新了一部分的值?
这些问题会让人无所适从。因此,几乎所有存储引擎都力求在单个节点的单个对象(例如键值对)层面提供原子性和隔离性。原子性可以通过日志和崩溃恢复来实现(参见“使 B 树可靠”),隔离性则可以通过为每个对象加锁来实现(同一时刻只允许一个线程访问对象)。
有些数据库还提供更复杂的原子操作,例如递增操作,从而不必执行图 8-1中的读取—修改—写入循环。同样常见的还有 条件写入:只有当该值未被其他人并发修改时,写入才会发生(参见“条件写入(比较并设置)”)。它类似于共享内存并发中的比较并设置或比较并交换(CAS)操作。
严格来说,原子递增(atomic increment)中的“原子”采用的是多线程编程中的含义。在 ACID 的语境下,它其实应称为 隔离递增(isolated increment)或 可串行化递增(serializable increment),但通常并不这样叫。
这些单对象操作很有用,因为它们能避免多个客户端同时写入同一对象时发生丢失更新(参见“防止丢失更新”)。但它们并不是通常意义上的事务。例如,Cassandra 和 ScyllaDB 的“轻量级事务”功能,以及 Aerospike 的“强一致性”模式,都能在单个对象上提供线性一致的读取和条件写入(参见“线性一致性”),却不为多个对象之间的操作提供保证。
多对象事务的需求
我们真的需要多对象事务吗?能否只靠键值数据模型和单对象操作来实现任何应用程序?
有些用例只需插入、更新或删除单个对象就足够了。但在许多其他场景中,必须协调对多个不同对象的写入:
- 在关系数据模型中,一个表中的行经常通过外键引用另一个表中的行。与之类似,在图数据模型中,一个顶点会通过边指向其他顶点。多对象事务可以确保这些引用始终有效:插入若干相互引用的记录时,外键必须正确且保持最新,否则数据便失去意义。
- 在文档数据模型中,需要一同更新的字段通常位于同一份文档内,而文档被视为单个对象,因此更新一份文档无须多对象事务。不过,缺乏连接功能的文档数据库也鼓励反规范化(参见“何时使用哪种模型”)。当反规范化的信息需要更新时——例如图 8-2中的情形——就必须一次更新多份文档。事务在这里很有用,可以防止反规范化数据彼此失去同步。
- 在具有二级索引的数据库中(纯键值存储以外的数据库几乎都属于此列),每次修改值时也要更新索引。从事务的角度看,这些索引是不同的数据库对象。例如,没有事务隔离时,一条记录可能出现在某个索引中,却没有出现在另一个索引中,因为第二个索引尚未更新(参见“分片与二级索引”)。
这类应用即使没有事务也能实现。不过,没有原子性,错误处理就会复杂得多;缺少隔离性,又可能引发并发问题。我们将在“弱隔离级别”中讨论这些问题,并在“衍生数据与分布式事务”中探讨替代方案。
处理错误和中止
事务的一个关键特性是:遇到错误时,可以中止并安全重试。ACID 数据库遵循这样的原则:只要原子性、隔离性或持久性保证有遭到破坏的风险,数据库宁可彻底放弃事务,也不会让它停留在半完成状态。
不过,并非所有系统都遵循这一原则。尤其是采用无主复制的数据存储(参见“无主复制”),更多是以“尽力而为”的方式工作。概括来说就是:“数据库能做多少便做多少;如果遇到错误,也不会撤销已经完成的操作。”因此,从错误中恢复成了应用程序的责任。
错误不可避免,许多软件开发者却宁愿只考虑一切顺利的正常路径,不愿面对错误处理的复杂细节。例如,Rails 的 ActiveRecord 和 Django 等流行的对象关系映射(ORM)框架都不会重试已中止的事务——错误通常会以异常的形式沿调用栈向上传播,于是用户输入被丢弃,只收到一条错误消息。这很可惜,因为中止的意义恰恰在于允许安全重试。
尽管重试已中止的事务是一种简单有效的错误处理机制,却并非完美无缺:
- 事务可能实际上已经成功,只是在服务器向客户端确认提交成功时网络中断,导致客户端等待超时。此时重试会让事务执行两遍,除非应用层另有去重机制。
- 如果错误源于过载或并发事务之间的严重争用,重试只会雪上加霜。要避免这种反馈循环,可以限制重试次数、采用指数退避,并将过载相关错误与其他错误区别处理(参见“当过载系统无法恢复时”)。
- 只有瞬态错误(例如死锁、违反隔离、临时网络中断或故障切换)才值得重试;遇到永久性错误(例如违反约束)时,重试毫无意义。
- 如果事务还会在数据库之外产生副作用,那么即使事务中止,副作用也可能已经发生。例如,事务每重试一次就再发一封邮件,显然不是你想要的结果。如果要确保几个不同的系统共同提交或共同中止,两阶段提交可以提供帮助(参见“两阶段提交(2PC)”)。
- 如果客户端进程在重试期间崩溃,它本想写入数据库的数据便会丢失。
弱隔离级别
如果两个事务不访问相同的数据,或者两者都是只读事务,它们就可以安全地并行运行,因为彼此并无依赖。只有当一个事务读取的数据正被另一个事务并发修改,或者两个事务试图同时修改相同数据时,才会出现并发问题(竞态条件)。
并发缺陷很难通过测试发现,因为它们只有在时序碰巧不利时才会触发。这种时序问题可能极少发生,通常也难以重现。并发行为本身同样难以推理,尤其是在大型应用中,你未必知道还有哪些代码正在访问数据库。即使每次只有一个用户,应用开发也已经不容易;面对许多并发用户则更为困难,因为任何数据都可能随时发生意料之外的变化。
正因如此,数据库长期以来一直试图通过 事务隔离(transaction isolation)向应用开发者隐藏并发问题。理论上,隔离让你可以假装并发根本不存在:可串行化 隔离意味着,数据库保证事务产生的效果与 串行 运行(即逐个运行、毫无并发)相同。
遗憾的是,实践中的隔离并没有这么简单。可串行化隔离有性能代价,许多数据库不愿为此买单10。因此,系统普遍采用较弱的隔离级别,只防范 一部分 而非全部并发问题。这些隔离级别更难理解,也可能引发微妙的错误,却仍在实践中广泛使用29。
弱事务隔离导致的并发缺陷绝非纸上谈兵:它们曾造成巨额资金损失30 31 32,招致财务审计人员介入调查33,也曾破坏客户数据34。这类问题曝光后,人们常会说:“处理财务数据就该使用 ACID 数据库!”但这没有抓住要害。即使是许多通常被视为“ACID”的流行关系型数据库,也采用弱隔离,因而未必能防止这些问题。
顺带一提,银行体系很大一部分依赖通过安全 FTP 交换的文本文件35。在这种环境中,审计跟踪和某些由人参与的反欺诈措施,其实比 ACID 属性更重要。
这些例子还凸显了一个要点:即使并发问题在正常运行中很少发生,也必须考虑攻击者向 API 刻意发送一波高度并发的请求,专门利用并发缺陷的可能性30。因此,要构建可靠且安全的应用,就必须系统性地防范这类缺陷。
本节将考察实践中使用的几种弱隔离级别(即非可串行化隔离),详细讨论哪些竞态条件可能发生、哪些不会发生,以便你判断哪一种适合自己的应用。随后,我们再深入讨论可串行化(参见“可串行化”)。这里将通过例子作非形式化的说明;严格定义及其性质分析可在学术文献中找到36 37 38 39。
读已提交
最基本的事务隔离级别是 读已提交(read committed),它提供两项保证:
- 从数据库读取时,只能看到已经提交的数据(没有 脏读,dirty read)。
- 向数据库写入时,只能覆盖已经提交的数据(没有 脏写,dirty write)。
有些数据库还支持更弱的 读未提交 隔离级别。它能防止脏写,却不能防止脏读。下面详细讨论这两项保证。
没有脏读
设想一个事务已经向数据库写入数据,却尚未提交或中止。另一个事务能否看到这些未提交的数据?如果能,这就是 脏读3。
运行在读已提交隔离级别下的事务必须防止脏读。这意味着,一个事务的所有写入都要等到该事务提交时,才会同时对其他事务可见。图 8-4中,用户 1 已将 x 设为 3,但由于其事务尚未提交,用户 2 的 get x 仍返回旧值 2。

防止脏读有以下几个好处:
- 如果事务要更新多行,脏读会让另一个事务只看到其中一部分更新。例如在图 8-2中,用户看到了新到的未读邮件,却没有看到更新后的计数器。这就是对邮件的脏读。数据库呈现出部分更新的状态,不仅令人困惑,还可能诱使其他事务作出错误决定。
- 如果事务中止,其所有写入都需要回滚(如图 8-3)。允许脏读,就意味着事务可能读到后来被回滚、从未真正提交进数据库的数据。凡是读取过未提交数据的事务也必须一并中止,从而造成所谓的 级联中止。
没有脏写
如果两个事务并发更新数据库中的同一行,会发生什么?写入次序虽然无法预知,但我们通常认为后一次写入会覆盖前一次写入。
可是,如果前一次写入属于尚未提交的事务,后一次写入覆盖了这个未提交值,又会怎样?这就是 脏写36。运行在读已提交隔离级别下的事务必须防止脏写;通常的做法是推迟第二次写入,直到执行第一次写入的事务提交或中止。
防止脏写可以避免某些并发问题:
- 如果事务更新多行,脏写可能产生非常糟糕的结果。图 8-5展示了一家二手车交易网站:Aaliyah 和 Bryce 同时购买同一辆车。买车涉及两次数据库写入:网站上的商品信息要更新为买家的姓名,销售发票也要开给买家。在图 8-5所示的情况下,车辆最终卖给了 Bryce(他对
listings表的更新胜出),发票却开给了 Aaliyah(她对invoices表的更新胜出)。读已提交可以防止这种事故。 - 不过,读已提交 不能 防止图 8-1中两个计数器递增操作之间的竞态条件。这里的第二次写入发生在第一个事务提交之后,所以并非脏写。结果仍然有误,只是原因不同;“防止丢失更新”将介绍如何安全地执行这类计数器递增操作。

实现读已提交
读已提交是一种非常流行的隔离级别,也是 Oracle Database、PostgreSQL、SQL Server 等许多数据库的默认设置10。
数据库防止脏写最常见的办法是使用行级锁:事务想修改某一行(或文档等其他对象)时,必须先取得该行的锁,并一直持有到事务提交或中止。任何一行在同一时刻只能由一个事务持锁;另一个事务若想写入同一行,就必须等前一个事务提交或中止后,才能取得锁并继续执行。在读已提交模式(或更强的隔离级别)下,数据库会自动完成这些加锁操作。
那么怎样防止脏读?一种办法仍是使用同一把锁:要求任何想读取某行的事务都短暂取得该锁,读完后立即释放。这样,当该行包含未提交的脏值时就无法读取,因为执行写入的事务仍持有这把锁。
然而,要求读操作加锁在实践中效果不佳。一个长期运行的写事务,可能迫使许多只读事务一直等到它结束。这不仅损害只读事务的响应时间,也不利于可运维性:应用某个部分一旦变慢,等待锁便可能引发连锁反应,波及完全不相干的其他部分。
尽管如此,仍有一些数据库使用锁来防止脏读,例如 IBM Db2,以及将 read_committed_snapshot=off 的 Microsoft SQL Server29。
更常见的防脏读办法如图 8-4所示:对于每一行写入,数据库同时保留旧的已提交值,以及当前持有写锁的事务写入的新值。该事务进行期间,其他事务读取这一行时只会得到旧值;等新值提交后,才改为读取新值(详见“多版本并发控制(MVCC)”)。
快照隔离与可重复读
乍看之下,人们很容易以为读已提交已经具备了事务所需的一切:它允许中止(原子性所必需),避免读取事务未完成的结果,也防止并发写入相互混杂。的确,这些功能很有用,提供的保证也比完全没有事务的系统强得多。
然而,在这个隔离级别下,并发缺陷仍可能以许多方式出现。图 8-6就展示了读已提交可能遇到的一个问题。

假设 Aaliyah 在银行有 1,000 美元存款,分别存在两个账户中,每个账户 500 美元。现在有一笔事务从其中一个账户向另一个账户转账 100 美元。如果她偏偏在转账事务处理的同时查看账户余额,可能会先看到一个账户尚未收到转入款项时的余额(500 美元),再看到另一个账户已经转出款项后的余额(400 美元)。在 Aaliyah 看来,两个账户总共只剩 900 美元——仿佛有 100 美元凭空消失了。
这种异常称为 读偏差(read skew),是 不可重复读(nonrepeatable read)的一种:如果 Aaliyah 在转账事务结束后再次读取账户 1 的余额,会得到 600 美元,与上一次查询看到的值不同。读已提交隔离允许读偏差,因为 Aaliyah 读到各账户余额的那一刻,它们确实都已经提交。
遗憾的是,偏差(skew)一词有多重含义:前文曾用它指 存在热点的不均衡工作负载(参见“倾斜的工作负载与缓解热点”),这里指的则是 时序异常。
对 Aaliyah 来说,这个问题不会持续太久:几秒钟后刷新网上银行页面,她多半就能看到一致的账户余额。但有些场景无法容忍哪怕暂时的不一致:
- 备份
- 备份需要复制整个数据库,大型数据库可能要花上几个小时。备份期间,数据库仍在不断接受写入。结果,备份的一部分可能包含较旧版本的数据,另一部分却包含较新版本。一旦从这样的备份恢复,原本暂时的不一致(例如凭空消失的钱)就会固化下来。
- 分析查询和完整性检查
- 有时需要运行扫描数据库大部分内容的查询。这类查询在分析场景中很常见(参见“分析型与事务型系统”),也可能用于定期执行完整性检查,确认一切正常(即监测数据损坏)。如果查询在不同时间点观察数据库的不同部分,返回的结果很可能毫无意义。
快照隔离36是解决这个问题最常用的办法。其核心思想是,每个事务都从数据库的 一致快照 读取数据——也就是说,事务只看到它开始时数据库中已经提交的全部数据。即使其他事务后来修改了数据,它看到的仍是那个特定时刻的旧数据。
快照隔离对于备份、分析等长期运行的只读查询是一大福音。如果查询所处理的数据在执行期间不断变化,查询结果就很难解释;如果事务看到的是冻结在某个时刻的数据库一致快照,理解起来就容易多了。
快照隔离是一项常见功能:PostgreSQL、采用 InnoDB 存储引擎的 MySQL、Oracle、SQL Server 等数据库都支持它的某种变体,尽管各系统的具体行为有所不同29 40 41。Oracle、TiDB 和 Aurora DSQL 等数据库甚至把快照隔离作为自身最高的隔离级别。
多版本并发控制(MVCC)
和读已提交一样,快照隔离通常用写锁来防止脏写(参见“实现读已提交”)。因此,一个写事务可以阻塞另一个写入同一行的事务。不过,读取无须取得任何锁。从性能角度看,快照隔离的一项关键原则是:读不阻塞写,写也不阻塞读。这样,数据库可以一边在一致快照上执行长期读查询,一边正常处理写入,二者不会争用锁。
为实现快照隔离,数据库把图 8-4中的防脏读机制推广开来。数据库不再只为每行保留两个版本(已提交版本,以及覆盖它但尚未提交的新版本),而是可能需要保留多个不同的已提交版本,因为正在运行的不同事务可能要观察数据库在不同时刻的状态。由于同一行的多个版本并存,这项技术称为 多版本并发控制(multi-version concurrency control,MVCC)。
图 8-7展示了 PostgreSQL 如何基于 MVCC 实现快照隔离40 42 43(其他实现与之类似)。事务启动时会获得一个唯一且单调递增的事务 ID(txid)。事务写入数据库的任何数据,都会以写入者的事务 ID 标记。(严格来说,PostgreSQL 的事务 ID 是 32 位整数,大约经过 40 亿个事务就会溢出;vacuum 进程负责清理,确保溢出不会影响数据。)

表中每一行都有一个 inserted_by 字段,保存将该行插入表中的事务 ID;还有一个初始为空的 deleted_by 字段。事务删除某行时,并不会立即将其从数据库中移除,而只是把 deleted_by 设为请求删除的事务 ID,以此标记删除。等到确定再也没有事务能访问这些已删除数据时,数据库的垃圾收集进程才会移除带删除标记的行并释放空间。
更新在内部会转换成一次删除和一次插入44。例如,在图 8-7中,事务 13 从账户 2 扣除 100 美元,把余额从 500 美元改为 400 美元。此时 accounts 表实际上包含账户 2 的两行:余额 500 美元的行由事务 13 标记为删除,余额 400 美元的行则由事务 13 插入。
一行的所有版本都存放在同一个数据库堆中(参见“在索引中存储值”),不论写入它们的事务是否已经提交。同一行的各个版本组成链表,可以从最新版本连到最旧版本,也可以反向连接,使查询能在内部遍历该行的所有版本45 46。
观察一致快照的可见性规则
事务读取数据库时,系统根据事务 ID 判断哪些行版本可见、哪些不可见。只要审慎定义可见性规则,数据库就能向应用程序呈现一致快照。其工作方式大致如下43:
- 每个事务开始时,数据库列出当时仍在进行(尚未提交或中止)的所有其他事务。即使这些事务后来提交,其写入也一律忽略。这样便能看到不受其他事务随后提交影响的一致快照。
- 事务 ID 较晚的事务(即在当前事务开始之后启动,因而不在上述进行中事务列表里)所做的写入一律忽略,无论它们是否已经提交。
- 已中止事务的写入一律忽略,无论中止发生在何时。这样一来,事务中止后无须立刻从存储中删除它写入的行,因为可见性规则会将它们过滤掉,垃圾收集进程可以稍后再清理。
- 其余写入均对应用程序的查询可见。
这些规则既适用于插入行,也适用于删除行。在图 8-7中,事务 12 读取账户 2 时看到的余额是 500 美元:删除 500 美元余额的是事务 13,而根据规则 2,事务 12 看不到事务 13 执行的删除;同理,插入的 400 美元余额也尚不可见。
换句话说,只有同时满足以下两个条件,一行才可见:
- 读事务开始时,插入该行的事务已经提交。
- 该行没有标记为删除;或者虽已标记为删除,但请求删除的事务在读事务开始时尚未提交。
长期运行的事务可能一直使用同一个快照,继续读取在其他事务看来早已被覆盖或删除的值。数据库从不原地更新值,而是在每次变更时插入新版本,因而只需很小的开销就能提供一致快照。
索引与快照隔离
多版本数据库中的索引如何工作?最常见的做法是,每个索引项指向与其匹配的某个行版本(最旧或最新版本)。每个行版本可以引用下一个更旧或更新的版本。使用索引的查询必须沿行版本遍历,找到既对当前事务可见、值又符合查询条件的那一行。垃圾收集移除不再对任何事务可见的旧行版本时,也可以一并删除相应的索引项。
许多实现细节都会影响多版本并发控制的性能45 46。例如,如果同一行的不同版本可以容纳在同一个页面中,PostgreSQL 会通过优化避免更新索引40。另一些数据库则不保存修改后行的完整副本,只保存版本间的差异以节省空间。
CouchDB、Datomic 和 LMDB 采用另一种方法。它们同样使用 B 树(参见“B 树”),但采用 不可变(写时复制)的变体:更新时不覆盖树页面,而是为每个被修改的页面创建新副本。从其父页面一直到树根,也都会复制并更新,以指向新版子页面。未受写入影响的页面无须复制,可由新树继续共享47。
采用不可变 B 树时,每个写事务(或一批事务)都会创建一个新的 B 树根;某个特定的树根,就是它创建时数据库的一致快照。由于后续写入无法修改现有 B 树,只能创建新的树根,因此无须根据事务 ID 过滤行。这种方法同样需要后台进程执行压缩和垃圾收集。
快照隔离、可重复读和命名混淆
MVCC 是数据库常用的实现技术,也经常用来实现快照隔离。不过,不同数据库有时会用不同术语指代同一件事:例如,快照隔离在 PostgreSQL 中称为“可重复读(repeatable read)”,在 Oracle 中称为“可串行化”29。反过来,不同系统也会用同一个术语表示不同事物:PostgreSQL 的“可重复读”指快照隔离,MySQL 的“可重复读”却是一个一致性弱于快照隔离的 MVCC 实现41。
之所以会出现这种命名混乱,是因为 SQL 标准没有快照隔离的概念。该标准建立在 System R 于 1975 年定义的隔离级别之上3,而那时快照隔离尚未问世。标准定义的是表面上与快照隔离相似的“可重复读”。PostgreSQL 的快照隔离符合这项标准要求,于是将它称为“可重复读”,从而可以宣称符合标准。
遗憾的是,SQL 标准对隔离级别的定义存在缺陷:含糊、不精确,也没有做到标准理应具备的实现无关性36。好几种数据库都声称实现了可重复读,实际提供的保证却相去甚远,尽管它名义上已经标准化29。研究文献给出了可重复读的正式定义37 38,但大多数实现都不符合这个定义。更添混乱的是,IBM Db2 还用“可重复读”来指可串行化10。
结果,谁也说不清“可重复读”究竟是什么意思。
防止丢失更新
到目前为止,读已提交和快照隔离主要保证的是:存在并发写入时,只读事务能够看到什么。我们基本没有讨论两个事务并发写入的问题,只讲过一种特定的写—写冲突——脏写(参见“没有脏写”)。
并发写事务之间还可能出现其他几类值得关注的冲突,其中最著名的便是 丢失更新(lost update)。图 8-1以两个并发递增计数器的事务为例,展示了这个问题。
应用程序从数据库读取一个值,修改后再写回去,这个过程称为 读取—修改—写入循环(read-modify-write cycle),可能发生丢失更新。如果两个事务并发执行这样的循环,其中一项修改可能丢失,因为后一次写入没有包含前一个事务的修改。(有时也说后一次写入 抹掉 了前一次写入。)这种模式会出现在许多场景中:
- 递增计数器或更新账户余额(读取当前值、计算新值,再把新值写回);
- 局部修改复杂值,例如向 JSON 文档内的列表添加元素(解析文档、作出修改,再把修改后的文档写回);
- 两个用户同时编辑一个 wiki 页面,各自把整页内容发送给服务器来保存修改,从而覆盖数据库中的现有内容。
这个问题非常普遍,因此人们提出了多种解决方案48。
原子写操作
许多数据库提供 原子写操作(atomic write operation),使应用程序不必自行实现读取—修改—写入循环。如果业务逻辑可以用这些操作表达,它们通常是最佳方案。例如,下面这条语句在大多数关系型数据库中都能安全地并发执行:
类似地,MongoDB 等文档数据库提供原子操作,供应用局部修改 JSON 文档;Redis 则提供修改优先队列等数据结构的原子操作。并非所有写入都容易表示成原子操作——例如,更新 wiki 页面涉及任意文本编辑,可以用“CRDT 与操作变换”介绍的算法处理——但只要能够使用,原子操作通常就是最佳选择。
原子操作通常这样实现:读取对象时取得 排他锁(exclusive lock),使其他事务在更新完成之前无法读取该对象。另一种办法则是强制所有原子操作都在单个线程上执行。
遗憾的是,对象关系映射(ORM)框架很容易让人无意中写出不安全的读取—修改—写入循环,而没有使用数据库提供的原子操作49 50 51。由此产生的缺陷往往十分隐蔽,很难通过测试发现。
显式锁定
如果数据库内置的原子操作无法满足需求,还可以由应用程序 显式锁定(explicit locking)即将更新的对象,再执行读取—修改—写入循环。其他事务若试图并发更新或锁定同一对象,就必须等前一个循环完成。
以多人游戏为例,几个玩家都可以移动同一个棋子。这时原子操作可能还不够,因为应用还要确保走法符合游戏规则,而其中一些逻辑很难合理地写成数据库查询。此时可以加锁,防止两个玩家同时移动同一个棋子,如示例 8-1所示。
❶
FOR UPDATE子句表示数据库应当锁定这条查询返回的所有行。
这个办法行得通,但必须仔细推敲应用逻辑才能用对。代码中很容易漏掉某处必要的加锁,进而引入竞态条件。
此外,锁定多个对象会带来死锁风险:两个或更多事务彼此等待对方释放锁。许多数据库会自动检测死锁,并中止其中一个事务,让系统得以继续推进。应用程序只需重试这个被中止的事务即可。
自动检测丢失更新
原子操作和锁通过强制读取—修改—写入循环依次执行来防止丢失更新。另一种思路是允许这些循环并行执行;事务管理器一旦检测到丢失更新,便中止相应事务,迫使它重试整个循环。
这种方法的一项优势是,数据库可以结合快照隔离高效完成检查。事实上,PostgreSQL 的可重复读、Oracle 的可串行化和 SQL Server 的快照隔离,都会自动检测丢失更新并中止发生冲突的事务。MySQL/InnoDB 的可重复读则不会检测丢失更新29 41。一些作者认为36 38,数据库只有能够防止丢失更新,才算提供快照隔离;按照这个定义,MySQL 并没有提供快照隔离。
自动检测丢失更新是一项很实用的功能,因为应用代码无须使用任何特殊数据库功能。开发者可能忘记加锁或使用原子操作而引入缺陷,自动检测则不容易遗漏。不过,应用程序仍须负责重试被中止的事务。
条件写入(比较并设置)
不提供事务的数据库有时会提供 条件写入 操作(前文“单对象写入”已经提到):只有当值自上次读取后未发生变化,才允许更新,从而防止丢失更新。如果当前值与先前读到的值不符,更新便不生效,应用必须重试读取—修改—写入循环。它相当于数据库版本的原子 比较并设置(compare-and-set)或 比较并交换(compare-and-swap,CAS)指令,许多 CPU 都支持此类指令。
例如,为防止两个用户同时更新同一个 wiki 页面,可以尝试如下写法:只有当页面内容在用户开始编辑后没有变化时,更新才会发生。
如果内容已经变化,不再与 'old content' 匹配,更新就不会生效;因此需要检查更新结果,必要时重试。也可以不比较完整内容,而是使用一个每次更新都递增的版本号列,只在当前版本号未变化时应用更新。这种方法有时称为 乐观锁定(optimistic locking)52。
如果另一个事务并发修改了 content,按照 MVCC 可见性规则,新内容可能并不可见(参见“观察一致快照的可见性规则”)。许多 MVCC 实现会针对这种场景作出例外:其他事务写入的值即便在快照中不可见,计算 UPDATE 和 DELETE 查询的 WHERE 子句时仍然可见。
冲突解决与复制
在复制数据库中(参见第 6 章),防止丢失更新又多了一个维度:数据副本分布在多个节点上,并可能在不同节点被并发修改,因此还需采取额外措施。
锁和条件写入操作都假定存在唯一的最新数据副本。但采用多主复制或无主复制的数据库,通常允许多项写入并发发生,再异步复制到其他节点,因而无法保证存在唯一的最新副本。所以,基于锁或条件写入的技术并不适用于这种场景。(“线性一致性”将更深入地讨论这个问题。)
这类复制数据库通常采用另一种办法,正如“处理写入冲突”所述:允许并发写入产生同一个值的多个冲突版本(也称为 兄弟值,siblings),再由应用代码或特殊数据结构事后解决冲突并合并版本。
如果更新是可交换的——即在不同副本上按不同顺序应用,仍会得到相同结果——那么合并冲突值便可防止丢失更新。递增计数器、向集合添加元素都是可交换操作。这正是“CRDT 与操作变换”介绍的 CRDT 背后的思想。不过,条件写入等操作无法变成可交换操作。
另一方面,最后写入者胜(LWW)这种冲突解决办法很容易丢失更新,详见“最后写入者胜(丢弃并发写入)”。遗憾的是,许多复制数据库都默认采用 LWW。
写偏差与幻读
前面介绍了 脏写 和 丢失更新:不同事务并发写入相同对象时,可能出现这两种竞态条件。要避免数据损坏,就必须防止它们发生——可以由数据库自动防范,也可以手动使用锁、原子写操作等保护措施。
然而,并发写入之间的潜在竞态条件远不止这些。本节将考察一些更为微妙的冲突。
先来看一个例子:你正在编写一款供医生管理医院值班安排的应用。医院通常希望任何时候都有几位医生值班,但底线是至少必须有一位。医生可以放弃自己的班次(例如本人也生病了),前提是同一班次至少还有一位同事继续值班53 54。
假设某个班次只有 Aaliyah 和 Bryce 两位值班医生。两人都身体不适,决定请假,偏偏又几乎同时点击了退出值班的按钮。接下来发生的事情如图 8-8所示。

每个事务都先检查当前是否至少有两位医生值班;如果是,应用就认为其中一位可以安全退出。由于数据库采用快照隔离,两次检查都返回 2,两个事务于是都进入下一阶段。Aaliyah 更新自己的记录,退出值班;Bryce 也作出同样的更新。两个事务都成功提交,结果却没有任何医生值班,违反了“至少一位医生值班”的要求。
写偏差的特征
这种异常称为 写偏差(write skew)36。它既不是脏写,也不是丢失更新,因为两个事务更新的是不同对象——分别是 Aaliyah 和 Bryce 的值班记录。这里的冲突不那么明显,却确实是一种竞态条件:如果两个事务依次运行,第二位医生就无法退出值班。只有并发执行事务,才会出现这种异常行为。
可以把写偏差看作丢失更新的推广:两个事务读取相同的一组对象,随后各自更新其中一些对象(不同事务可以更新不同对象),就可能发生写偏差。若不同事务碰巧更新同一个对象,则会表现为脏写或丢失更新,具体取决于时序。
防止丢失更新的办法有很多,处理写偏差时可选手段却少得多:
单对象原子操作无济于事,因为这里涉及多个对象。
一些快照隔离实现能够自动检测丢失更新,但遗憾的是,这对写偏差也无济于事。PostgreSQL 的可重复读、MySQL/InnoDB 的可重复读、Oracle 的可串行化以及 SQL Server 的快照隔离,都不会自动检测写偏差29。要自动防止写偏差,必须采用真正的可串行化隔离(参见“可串行化”)。
有些数据库允许配置由数据库强制执行的约束,例如唯一性约束、外键约束或对特定值的限制。但要表达“至少有一位医生值班”,就需要涉及多个对象的约束。大多数数据库没有内置支持这类约束,不过可以尝试用触发器或物化视图来实现,正如“一致性”所述12。
如果无法使用可串行化隔离,这里的次优选择大概是显式锁定事务所依赖的行。在医生值班的例子中,可以这样写:
❶ 与之前一样,
FOR UPDATE要求数据库锁定这条查询返回的所有行。
写偏差的更多例子
写偏差乍看似乎很深奥,一旦意识到它的存在,就会发现它可能出现在许多场景中。再看几个例子:
- 会议室预订系统
- 假设你要保证同一间会议室在同一时段不能被重复预订55。有人发起预订时,先检查是否存在冲突(即同一房间是否有时间范围重叠的预订);若没有,再创建会议(参见示例 8-2)。
示例 8-2 会议室预订系统试图避免重复预订(在快照隔离下并不安全) 遗憾的是,快照隔离无法阻止另一个用户并发插入冲突的会议。要保证安排不会冲突,还是得采用可串行化隔离。
- 多人游戏
- 在示例 8-1中,我们用锁防止丢失更新,也就是确保两名玩家不能同时移动同一个棋子。但这把锁无法阻止玩家把两个不同棋子移动到棋盘上的同一位置,也无法阻止其他违反规则的走法。视具体规则而定,有时可以使用唯一性约束;否则就很容易发生写偏差。
- 声明用户名
- 在要求用户名唯一的网站上,两个用户可能同时尝试用同一个名字创建账户。可以用事务先检查用户名是否已被占用,如果没有,再用它创建账户。但和前面的例子一样,这在快照隔离下并不安全。好在唯一性约束就能轻松解决这个问题:第二个尝试注册该用户名的事务会因违反约束而中止。
- 防止重复消费
- 允许用户消费金钱或积分的服务,必须确保用户的支出不超过余额。一种实现方式是先在用户账户中插入暂定支出项,再列出账户中的所有项目,检查合计余额是否仍为正数。发生写偏差时,两个支出项可能被并发插入,合在一起使余额变成负数,两个事务却都没有察觉对方。
导致写偏差的幻读
这些例子都遵循相似的模式:
SELECT查询搜索符合某项条件的行,以检查是否满足要求(至少有两位医生值班、该会议室在相应时段没有预订、棋盘上的目标位置没有其他棋子、用户名尚未占用、账户仍有余额)。- 应用代码根据第一次查询的结果决定下一步:继续执行,或者向用户报告错误并中止。
- 如果决定继续,应用便向数据库写入(
INSERT、UPDATE或DELETE),然后提交事务。
这次写入改变了步骤 2 作出决定时所依据的前提。换句话说,写入提交后再次执行步骤 1 的 SELECT,结果就会不同,因为符合搜索条件的行集合已经改变(少了一位值班医生、会议室在该时段已有预订、棋盘上的目标位置已被刚移入的棋子占据、用户名已被占用,或账户余额已经减少)。
这些步骤也可以采用不同顺序。例如,可以先写入,再执行 SELECT 查询,最后根据查询结果决定中止还是提交。
在医生值班的例子中,步骤 3 修改的是步骤 1 返回的某一行,因此可以在步骤 1 中锁定这些行(SELECT FOR UPDATE),使事务安全并避免写偏差。但其余四个例子不同:它们检查的是 不存在 符合某项条件的行,随后的写入则 添加 了一行,使其符合相同条件。如果步骤 1 的查询没有返回任何行,SELECT FOR UPDATE 便无处加锁56。
一个事务的写入改变了另一个事务中搜索查询的结果,这种现象称为 幻读(phantom)4。快照隔离可以避免只读查询中的幻读,但在上述读写事务中,幻读可能引发格外棘手的写偏差。ORM 生成的 SQL 也很容易遇到写偏差50 51。
物化冲突
如果幻读的问题在于没有对象可供加锁,或许可以人为地在数据库中引入一个锁对象?
以会议室预订为例,可以创建一张房间与时段表。表中每一行对应某个房间的某个特定时段(例如 15 分钟),提前为未来六个月内所有可能的房间与时段组合建好行。
现在,创建预订的事务可以锁定(SELECT FOR UPDATE)表中与目标房间和时段对应的行。取得锁后,再照常检查重叠预订并插入新预订。请注意,这张附加表并不存储预订信息——它纯粹是一组锁,用来防止同一房间、同一时间范围内的预订被并发修改。
这种方法称为 物化冲突(materializing conflicts):它把幻读转化为数据库中一组具体行上的锁冲突14。遗憾的是,怎样物化冲突既难设计又容易出错,而且让并发控制机制渗入应用数据模型也很不美观。因此,物化冲突只能在别无选择时作为最后手段;大多数情况下,可串行化隔离要好得多。
可串行化
本章已经介绍了几类容易出现竞态条件的事务。读已提交和快照隔离可以防止其中一部分,却无法防止其他类型,写偏差和幻读尤其棘手。当前的处境着实令人沮丧:
- 隔离级别难以理解,不同数据库的实现又不一致(例如“可重复读”的含义相差很大)。
- 单看应用代码,很难判断它在特定隔离级别下运行是否安全。大型应用尤其如此,因为你未必知道还有哪些操作可能并发发生。
- 没有好用的工具可以帮助检测竞态条件。原则上静态分析或许能派上用场33,研究成果却尚未进入实际应用。并发问题通常具有非确定性,只有时序碰巧不利时才会出现,因此也很难通过测试发现。
这并不是新问题——自 20 世纪 70 年代引入弱隔离级别以来,情况一直如此3。研究人员给出的答案始终很简单:使用 可串行化 隔离!
可串行化是最强的隔离级别。它保证即使事务实际并行执行,最终结果也与它们 串行 执行(逐个执行、毫无并发)相同。因此,只要事务单独运行时行为正确,数据库就能保证它们并发运行时仍然正确。换句话说,数据库可以防止 所有 可能的竞态条件。
既然可串行化远胜于弱隔离带来的混乱,为什么大家不都使用它?要回答这个问题,就要看看可串行化有哪些实现方式,以及它们的性能如何。目前提供可串行化的大多数数据库都采用以下三种技术之一,本章余下内容将逐一探讨:
- 严格按照串行顺序执行事务(参见“实际串行执行”);
- 两阶段锁定(参见“两阶段锁定(2PL)”),几十年来这是唯一可行的选择;
- 可串行化快照隔离等乐观并发控制技术(参见“可串行化快照隔离(SSI)”)。
实际串行执行
避免并发问题最简单的办法,就是彻底消除并发:在单个线程上按照串行顺序,每次只执行一个事务。这样便完全绕开了检测和防止事务冲突的问题,而得到的隔离按定义就是可串行化的。
这个想法看似显而易见,数据库设计者却直到 2000 年代才认定,用单线程循环执行事务切实可行57。此前 30 年间,多线程并发一直被视为取得良好性能的必要条件,究竟是什么变化让单线程执行成为可能?
两项进展促成了这次重新思考:
- RAM 已经足够便宜,许多用例都能把整个活跃数据集放进内存(参见“全内存存储”)。事务所需的全部数据都在内存中时,执行速度远快于等待从磁盘加载数据。
- 数据库设计者意识到,OLTP 事务通常很短,只执行少量读写(参见“分析型与事务型系统”)。长期运行的分析查询则通常只读,可以在串行执行循环之外,基于一致快照运行(使用快照隔离)。
VoltDB/H-Store、Redis 和 Datomic 等系统采用了串行执行事务的方式58 59 60。为单线程执行而设计的系统有时反而比支持并发的系统性能更好,因为它省去了加锁的协调开销。不过,其吞吐量受限于单个 CPU 核。要充分利用这条线程,事务的组织方式必须不同于传统形式。
将事务封装在存储过程中
数据库诞生之初,人们设想事务可以涵盖用户活动的整个流程。例如,预订机票要经过多个阶段:搜索航线、票价和空余座位;确定行程;预订每一段航班的座位;填写乘客信息;最后付款。数据库设计者认为,如果把整个流程作为一个事务原子提交,会非常理想。
遗憾的是,人类作出决定和响应的速度很慢。如果数据库事务要等待用户输入,数据库就必须支持数量可能极其庞大的并发事务,而且其中大部分都处于空闲状态。绝大多数数据库无法高效做到这一点,因此几乎所有 OLTP 应用都会避免在事务中交互等待用户,以保持事务简短。在 Web 应用中,这意味着事务要在同一个 HTTP 请求内提交,不能跨越多个请求;新的 HTTP 请求会启动新的事务。
即使已经把人从关键路径中移除,事务仍往往采用交互式客户端/服务器模式,逐条执行语句。应用发出查询、读取结果,再根据第一次查询的结果决定是否发出下一条查询,如此往复。查询与结果不断在应用代码所在的机器和数据库服务器之间来回传递。
这种交互式事务把大量时间耗在应用与数据库之间的网络通信上。如果数据库禁止并发、每次只处理一个事务,吞吐量会低得可怕:数据库大部分时间都在等待应用发出当前事务的下一条查询。采用这种模式的数据库必须并发处理多个事务,才能获得合理性能。
因此,单线程串行处理事务的系统不允许交互式多语句事务。应用要么只使用单语句事务,要么提前把整个事务的代码作为 存储过程(stored procedure)提交给数据库61。
交互式事务与存储过程的差别如图 8-9所示。只要事务所需的全部数据都在内存中,存储过程就能快速执行,无须等待任何网络或磁盘 I/O。

存储过程的利弊
存储过程早已存在于关系型数据库中,并从 1999 年起成为 SQL 标准(SQL/PSM)的一部分。不过,它们因种种原因名声不佳:
- 传统上,每家数据库厂商都有自己的存储过程语言(Oracle 使用 PL/SQL,SQL Server 使用 T-SQL,PostgreSQL 使用 PL/pgSQL 等)。这些语言没有跟上通用编程语言的发展,今天看来颇为丑陋陈旧,也缺少大多数编程语言拥有的库生态。
- 在数据库中运行的代码难以管理:与应用服务器相比,它更难调试,不便进行版本控制和部署,测试更麻烦,也难以接入采集指标的监控系统。
- 数据库通常比应用服务器对性能更加敏感,因为一个数据库实例往往由许多应用服务器共享。一个写得很差的存储过程(例如占用大量内存或 CPU 时间),可能比应用服务器上同样糟糕的代码造成更大麻烦。
- 在允许租户自行编写存储过程的多租户系统中,让不受信任的代码与数据库内核运行在同一个进程里,会带来安全风险62。
不过,这些问题并非无法克服。现代存储过程实现已经放弃 PL/SQL,转而采用现有的通用编程语言:VoltDB 使用 Java 或 Groovy,Datomic 使用 Java 或 Clojure,Redis 使用 Lua,MongoDB 使用 JavaScript。
当应用逻辑不便嵌入其他位置时,存储过程也很有用。例如,使用 GraphQL 的应用可能通过 GraphQL 代理直接开放数据库。若代理不支持复杂的验证逻辑,就可以用存储过程把这类逻辑直接嵌入数据库;如果数据库不支持存储过程,则只能在代理与数据库之间另行部署验证服务。
存储过程配合内存数据,使所有事务都在单线程上执行成为可行方案。只要存储过程无须等待 I/O,又能避开其他并发控制机制的开销,单线程也可以达到相当可观的吞吐量。
VoltDB 还利用存储过程进行复制:它不把事务写入从一个节点复制到另一个节点,而是在每个副本上执行同一个存储过程。因此,VoltDB 要求存储过程必须是 确定性的(deterministic),即在不同节点运行时产生相同结果。例如,事务若要使用当前日期和时间,就必须通过特殊的确定性 API 获取(关于确定性操作的更多细节,参见“持久化执行与工作流”)。这种方法称为 状态机复制(state machine replication),我们将在第 10 章再次讨论它。
分片
串行执行所有事务大大简化了并发控制,却也把数据库的事务吞吐量限制在单台机器、单个 CPU 核的处理能力以内。只读事务可以通过快照隔离在别处执行;但对写入吞吐量很高的应用而言,单线程事务处理器可能成为严重瓶颈。
要扩展到多个 CPU 核和多个节点,可以像 VoltDB 那样对数据分片(参见第 7 章)。如果能让每个事务只读写单个分片内的数据,那么每个分片都可以拥有自己的事务处理线程,彼此独立运行。此时可以为每个 CPU 核分配一个分片,使事务吞吐量随 CPU 核数线性增长59。
但凡事务需要访问多个分片,数据库就必须在所有涉及的分片之间进行协调。存储过程要在这些分片上步调一致地执行,才能保证整个系统的可串行化。
跨分片事务有额外的协调开销,因此远慢于单分片事务。VoltDB 报告的跨分片写入吞吐量约为每秒 1,000 次,比单分片吞吐量低几个数量级,而且无法靠增加机器来提升61。近来的研究探索了让多分片事务更具可伸缩性的办法63。
事务能否限制在单个分片内,很大程度上取决于应用所用的数据结构。简单的键值数据通常很容易分片;具有多个二级索引的数据则很可能需要大量跨分片协调(参见“分片与二级索引”)。
串行执行总结
在满足特定约束的情况下,串行执行事务已经成为实现可串行化隔离的一种可行办法:
- 每个事务都必须短小迅速,因为一个慢事务就足以拖住所有事务处理。
- 这种办法最适合活跃数据集能够装进内存的场景。不常访问的数据可以移到磁盘,但单线程事务一旦需要访问这些数据,系统就会变得很慢。
- 写入吞吐量必须足够低,能由单个 CPU 核处理;否则,事务必须能够分片执行,并且不需要跨分片协调。
- 跨分片事务虽然可行,其吞吐量却很难扩展。
两阶段锁定(2PL)
大约 30 年间,数据库领域只有一种得到广泛应用的可串行化算法:两阶段锁定(two-phase locking,2PL)。它有时也称为 强严格两阶段锁定(strong strict two-phase locking,SS2PL),以区别于 2PL 的其他变体。
两阶段 锁定(2PL)与两阶段 提交(2PC)是完全不同的两回事。2PL 提供可串行化隔离,2PC 则为分布式数据库提供原子提交(参见“两阶段提交(2PC)”)。为免混淆,最好把它们当成彼此独立的概念,不必理会名称上这种不巧的相似。
前文已经看到,锁通常用于防止脏写(参见“没有脏写”):若两个事务并发写入同一对象,锁会迫使第二个写入者等待,直到第一个事务提交或中止后才能继续。
两阶段锁定与此类似,但加锁要求严格得多。只要没有写入,多个事务可以并发读取同一个对象;但只要有事务想写入(修改或删除)对象,就必须取得独占访问权:
- 如果事务 A 已读取某个对象,而事务 B 想写入该对象,B 必须等 A 提交或中止后才能继续。(这样可以确保 B 不会在 A 不知情的情况下改变对象。)
- 如果事务 A 已写入某个对象,而事务 B 想读取该对象,B 必须等 A 提交或中止后才能继续。(2PL 不允许像图 8-4那样读取对象的旧版本。)
在 2PL 中,写会阻塞其他写,也会阻塞读;反过来,读同样会阻塞写。快照隔离则奉行“读不阻塞写,写也不阻塞读”(参见“多版本并发控制(MVCC)”),这正是快照隔离与两阶段锁定的关键区别。另一方面,2PL 提供可串行化,能够防止前面讨论的所有竞态条件,包括丢失更新和写偏差。
两阶段锁定的实现
MySQL(InnoDB)和 SQL Server 的可串行化隔离级别,以及 Db2 的可重复读隔离级别,都采用 2PL29。
数据库通过为每个对象设置一把锁来阻塞读写操作。锁可以处于 共享模式(shared mode)或 独占模式(exclusive mode),这也称为 多读者单写者(multi-reader single-writer)锁。具体规则如下:
- 事务要读取对象,必须先以共享模式取得锁。多个事务可以同时持有共享锁;但如果另一个事务已持有该对象的独占锁,读事务就必须等待。
- 事务要写入对象,必须先以独占模式取得锁。此时不允许其他事务以任何模式持锁;只要对象上已有锁,写事务就必须等待。
- 事务先读后写时,可以把共享锁升级为独占锁。升级规则与直接取得独占锁相同。
- 事务取得锁后,必须一直持有到事务结束(提交或中止)。这正是“两阶段”名称的由来:第一阶段在事务执行期间获取锁,第二阶段在事务结束时一次释放所有锁。
由于大量使用锁,很容易出现事务 A 等待事务 B 释放锁、事务 B 又反过来等待事务 A 的情况,这称为 死锁(deadlock)。数据库会自动检测事务之间的死锁并中止其中一个,让其他事务能够继续推进;被中止的事务则由应用程序重试。
两阶段锁定的性能
两阶段锁定最大的缺点,也是它自 20 世纪 70 年代以来始终没有普及到所有数据库的原因,就是性能:在两阶段锁定下,事务吞吐量和查询响应时间都明显逊于弱隔离。
这部分源于获取和释放大量锁的开销,更主要的原因则是并发度降低。按照设计,只要两个并发事务执行的操作有任何可能引发竞态条件,其中一个就必须等另一个完成。
例如,一个事务需要读取整张表,用于备份、分析查询或完整性检查(参见“快照隔离与可重复读”),就必须为整张表取得共享锁。读事务首先要等待所有正在写表的事务结束;随后,在它读取整张表期间(大表可能耗时很久),所有想写入该表的事务又会被阻塞,直至这个大型只读事务提交。实际上,数据库会在很长一段时间内无法接受写入。
因此,采用 2PL 的数据库延迟可能相当不稳定;工作负载一旦存在争用,高百分位延迟就可能非常糟糕(参见“描述性能”)。仅仅一个慢事务,或者一个访问大量数据、取得许多锁的事务,就可能让系统其余部分陷入停顿。
基于锁的读已提交也会发生死锁,但在 2PL 可串行化隔离下,死锁往往更为频繁(具体取决于事务的访问模式)。这又会带来额外的性能问题:事务因死锁而中止、重试时,必须从头重做全部工作。若死锁频繁,浪费的计算量会相当可观。
谓词锁
前面对锁的描述略过了一个微妙却重要的细节。“导致写偏差的幻读”介绍过 幻读:一个事务改变了另一个事务的搜索查询结果。提供可串行化隔离的数据库必须防止幻读。
在会议室预订的例子中,如果一个事务已经搜索某个房间在特定时段内的现有预订(参见示例 8-2),另一个事务就不能并发插入或更新同一房间、同一时段的预订。(并发预订其他房间,或者预订同一房间但互不影响的其他时段,则没有问题。)
怎样实现这一点?从概念上讲,需要使用 谓词锁(predicate lock)4。它的工作方式类似前面介绍的共享锁和独占锁,却不属于某个特定对象(例如表中的一行),而是属于所有符合某项搜索条件的对象,例如:
谓词锁限制访问如下:
- 事务 A 想读取符合某项条件的对象(如上面的
SELECT),必须先在查询条件上取得共享模式的谓词锁。如果事务 B 已经对任何符合条件的对象持有独占锁,A 就要等 B 释放锁后才能查询。 - 事务 A 想插入、更新或删除对象,必须先检查旧值或新值是否符合任何已有谓词锁。如果发现事务 B 持有匹配的谓词锁,A 就要等 B 提交或中止后才能继续。
关键在于,谓词锁甚至适用于数据库中尚不存在、未来却可能加入的对象(即幻读)。两阶段锁定若包含谓词锁,数据库就能防止各种形式的写偏差和其他竞态条件,使隔离达到可串行化。
索引范围锁
遗憾的是,谓词锁性能不佳:活跃事务持有大量锁时,检查是否有匹配的锁会非常耗时。因此,大多数采用 2PL 的数据库实际实现的是 索引范围锁(index-range lock,也称为 next-key locking),即谓词锁的一种简化近似54 64。
把谓词放宽到匹配更大的对象集合,是一种安全的简化。例如,要锁定 123 号房间从中午 12 点到下午 1 点的预订,可以近似为锁定 123 号房间全天所有预订;也可以近似为锁定中午 12 点到下午 1 点所有房间的预订。这样做是安全的,因为任何符合原始谓词的写入,必然也符合近似后的条件。
会议室预订数据库很可能在 room_id 列上建有索引,或在 start_time 和 end_time 上建有索引(否则前述查询面对大型数据库会非常慢):
- 假设索引建在
room_id上,数据库用它查找 123 号房间的现有预订。数据库可以直接把共享锁附加到这条索引项上,表示某个事务已搜索过 123 号房间的预订。 - 如果数据库使用时间索引查找现有预订,则可以把共享锁附加到索引中的一段值域上,表示某个事务已经搜索过与 2025 年 1 月 1 日中午 12 点至下午 1 点重叠的预订。
无论采用哪种索引,搜索条件的近似都会附着在其中一个索引上。另一个事务若想插入、更新或删除同一房间和/或重叠时段的预订,就必须更新索引的同一部分,于是会碰到共享锁,被迫等到锁释放。
这样便能有效防止幻读和写偏差。索引范围锁不如谓词锁精确,可能会锁住比维持可串行化严格所需更大范围的对象;但它的开销低得多,是一种很好的折中。
如果没有合适的索引可供附加范围锁,数据库可以退回到对整张表加共享锁。这样会阻塞所有其他事务写表,性能很差,却是安全的后备方案。
可串行化快照隔离(SSI)
到目前为止,数据库并发控制的前景显得颇为黯淡:一边是性能不佳的两阶段锁定,以及伸缩性不佳的串行执行;另一边是性能虽好,却容易出现丢失更新、写偏差、幻读等竞态条件的弱隔离。可串行化隔离与良好性能从根本上就无法兼得吗?
看来并非如此。一种名为 可串行化快照隔离(serializable snapshot isolation,SSI)的算法能够提供完整的可串行化,与快照隔离相比只付出很小的性能代价。SSI 相对较新,最早于 2008 年提出53 65。
如今,SSI 及类似算法已经用于单节点数据库(PostgreSQL 的可串行化隔离级别54、SQL Server 的内存 OLTP/Hekaton66 和 HyPer67)、分布式数据库(CockroachDB5 和 FoundationDB8),以及 BadgerDB 等嵌入式存储引擎。
悲观并发控制与乐观并发控制
两阶段锁定属于所谓的 悲观(pessimistic)并发控制机制。它遵循这样的原则:只要有任何出错的可能(例如另一个事务持有锁),就先等待,直到局面重新安全后再行动。这类似于多线程编程中用来保护数据结构的 互斥(mutual exclusion)。
从某种意义上说,串行执行把悲观推到了极致:本质上,每个事务在执行期间都像是对整个数据库(或一个数据库分片)持有独占锁。作为补偿,每个事务都要尽快执行,使这把“锁”只持有很短时间。
相比之下,可串行化快照隔离是一种 乐观(optimistic)并发控制技术。这里的“乐观”是指:即使出现潜在危险,也不阻塞事务,而是让它继续运行,寄望最终不会出问题。等事务准备提交时,数据库再检查是否发生了坏事(即隔离是否遭到破坏);若有,就中止并重试事务。只有执行结果可串行化的事务才能提交。
乐观并发控制是个古老的思想68,其利弊也已争论多年69。存在严重争用(许多事务访问相同对象)时,它表现很差,因为很大比例的事务都不得不中止。若系统已经接近最大吞吐量,重试事务带来的额外负载还会进一步拖累性能。
不过,如果系统有充足的余量,事务之间争用又不严重,乐观并发控制往往优于悲观方案。可交换的原子操作还能降低争用:例如,多个事务并发递增计数器时,应用这些增量的顺序无关紧要(只要同一事务没有读取该计数器),因此所有并发增量都可以执行而不会冲突。
顾名思义,SSI 建立在快照隔离之上:事务中的所有读取都来自数据库的一致快照(参见“快照隔离与可重复读”)。在此基础上,SSI 加入算法来检测读写之间的可串行化冲突,并决定应当中止哪些事务。
基于过时前提的决策
前面讨论快照隔离中的写偏差时(参见“写偏差与幻读”),我们反复看到一种模式:事务从数据库读取数据、检查查询结果,再根据结果决定执行某项操作(向数据库写入)。然而在快照隔离下,等事务提交时,原查询结果可能已经过时,因为数据在此期间可能被修改。
换句话说,事务根据某个 前提 行动——即事务开始时为真的事实,例如“当前有两名医生值班”。等到事务准备提交时,原始数据可能已经变化,原先的前提不再成立。
应用发出查询(例如“当前有多少医生值班?”)时,数据库并不知道应用逻辑会如何使用查询结果。为确保安全,数据库必须假定:查询结果(即前提)一有变化,该事务中的写入就可能失效。也就是说,事务中的查询与写入之间可能存在因果依赖。为了提供可串行化隔离,数据库必须检测事务是否可能依据过时前提行事,并在这种情况下中止事务。
数据库怎样判断查询结果可能已经变化?需要考虑两种情况:
- 检测是否读取了过时的 MVCC 对象版本(未提交的写入发生在读取之前);
- 检测是否有写入影响了先前的读取(写入发生在读取之后)。
检测陈旧的 MVCC 读取
回想一下,快照隔离通常通过多版本并发控制实现(MVCC;参见“多版本并发控制(MVCC)”)。事务从 MVCC 数据库的一致快照读取时,会忽略其他事务在快照生成时尚未提交的所有写入。
在图 8-10中,事务 43 看到 Aaliyah 的 on_call = true,因为修改其值班状态的事务 42 尚未提交。但等事务 43 准备提交时,事务 42 已经提交。这意味着,读取一致快照时被忽略的写入现在已经生效,事务 43 的前提不再成立。如果写入者插入的是此前不存在的数据,情况还会更复杂(参见“导致写偏差的幻读”)。“检测影响先前读取的写入”将介绍 SSI 如何检测幻写。

为防止这种异常,数据库必须跟踪事务何时因 MVCC 可见性规则而忽略了其他事务的写入。等事务准备提交时,再检查这些被忽略的写入是否已经提交;若是,就必须中止该事务。
为什么非要等到提交?为什么不在发现过时读取时立刻中止事务 43?如果事务 43 是只读事务,就没有写偏差风险,无须中止;而在它读取时,数据库还不知道它稍后是否会写入。此外,事务 42 可能最终中止,也可能在事务 43 提交时仍未提交,于是这次读取到头来并未过时。通过避免不必要的中止,SSI 保留了快照隔离支持长期读取一致快照的优点。
检测影响先前读取的写入
第二种情况,是数据被读取后又遭另一个事务修改,如图 8-11所示。

讨论两阶段锁定时,我们介绍过索引范围锁(参见“索引范围锁”),数据库可以借此锁定所有符合某项查询条件的行,例如 WHERE shift_id = 1234。SSI 可以使用类似技术,区别在于 SSI 的锁不会阻塞其他事务。
在图 8-11中,事务 42 和 43 都查询了班次 1234 的值班医生。如果 shift_id 上有索引,数据库就能利用索引项 1234 记录事务 42 和 43 读过这项数据。(没有索引时,也可以在表级别跟踪。)这些信息只需保留一段时间:等事务结束(提交或中止),并且所有与之并发的事务也结束后,数据库就可以忘掉它读过哪些数据。
事务写入数据库时,必须在索引中查找近期读过受影响数据的其他事务。这个过程类似为受影响的键范围取得写锁,但它不会一直阻塞到读事务提交,而是像警戒线一样:只负责通知相关事务,它们读过的数据可能已经过时。
在图 8-11中,事务 43 通知事务 42:它先前读过的数据已经过时;事务 42 也反过来通知事务 43。事务 42 率先提交并获得成功:虽然事务 43 的写入影响了事务 42,但事务 43 尚未提交,所以写入还未生效。等事务 43 准备提交时,事务 42 的冲突写入已经提交,因此事务 43 必须中止。
可串行化快照隔离的性能
一如既往,许多工程细节会影响算法的实际表现。例如,需要权衡以多细的粒度跟踪事务读写。如果数据库详细记录每个事务的活动,就能精确判断哪些事务应当中止,但记账开销可能很大;较粗粒度的跟踪更快,却可能中止一些本来无须中止的事务。
有些情况下,事务读到被另一事务覆盖的信息也没有关系:结合其他事件,有时可以证明执行结果仍然可串行化。PostgreSQL 利用这一理论来减少不必要的中止14 54。
与两阶段锁定相比,可串行化快照隔离的主要优势是:事务无须因等待另一个事务持有的锁而阻塞。与快照隔离一样,写不阻塞读,读也不阻塞写。这项设计原则让查询延迟更加可预测,波动也更小。尤其是只读查询可以无须任何锁、直接运行在一致快照上,对读取密集型工作负载很有吸引力。
与串行执行相比,可串行化快照隔离不受单个 CPU 核吞吐量的限制。例如,FoundationDB 把可串行化冲突检测分散到多台机器上,因而可以扩展到很高的吞吐量。即使数据分片存放在多台机器上,事务仍可读写多个分片,同时保证可串行化隔离。
与非可串行化的快照隔离相比,检查可串行化违规会带来一些性能开销。这项开销究竟有多大,仍有争议:有人认为可串行化检查得不偿失70;也有人认为如今可串行化性能已经足够好,没必要再采用较弱的快照隔离67。
中止率会显著影响 SSI 的总体性能。一个长期读写数据的事务很可能遇到冲突而中止,因此 SSI 要求读写事务相当短小(长期运行的只读事务没有问题)。不过,与两阶段锁定或串行执行相比,SSI 对慢事务没有那么敏感。
分布式事务
前几节重点讨论了实现隔离性(即 ACID 中的 I)所需的并发控制。前面介绍的算法既适用于单节点数据库,也适用于分布式数据库。尽管并发控制算法在伸缩时会遇到挑战(例如为 SSI 执行分布式可串行化检查),分布式并发控制的总体思路仍与单节点并发控制相似8。
转向分布式事务后,一致性和持久性也没有太大变化;但原子性需要格外小心。
对于只在单个数据库节点上执行的事务,原子性通常由存储引擎实现。客户端请求数据库节点提交时,数据库先将事务写入持久化(通常写入预写日志;参见“使 B 树可靠”),再向磁盘日志追加一条提交记录。如果数据库在此过程中崩溃,节点重启后便从日志恢复事务:若提交记录在崩溃前已经成功落盘,事务视为已提交;否则,该事务的所有写入都会回滚。
因此在单节点上,事务能否提交,关键取决于数据持久化落盘的 顺序:先写数据,再写提交记录22。决定事务提交还是中止的关键时刻,就是磁盘完成提交记录写入的一刻:在此之前,事务仍可能因崩溃而中止;在此之后,即使数据库崩溃,事务也已经提交。换言之,是一个单独的设备——连接在特定节点上的某块磁盘的控制器——使提交具备原子性。
可是,如果事务涉及多个节点呢?例如,分片数据库中可能有多对象事务,也可能有全局二级索引,其中索引项和主数据位于不同节点(参见“分片与二级索引”)。大多数“NoSQL”分布式数据存储不支持这类分布式事务,但不少分布式关系型数据库支持。
此时,仅仅向所有节点发送提交请求,让每个节点独立提交事务并不够。如图 8-12所示,提交很容易在一部分节点上成功,却在另一部分节点上失败:
- 某些节点可能检测到约束违规或冲突,因而必须中止,其他节点却能成功提交;
- 某些提交请求可能在网络中丢失,最终因超时而中止,其他请求却顺利抵达;
- 某些节点可能在提交记录完全写入前崩溃,恢复时回滚事务,其他节点却成功提交。

如果有些节点提交、有些节点中止,节点之间便会出现不一致。而事务一旦在某个节点上提交,即便后来发现它在另一个节点上中止,也不能再撤回。因为数据提交后,在 读已提交 或更强隔离下就会对其他事务可见。例如,在图 8-12中,当用户 1 发现数据库 1 提交失败时,用户 2 已经在数据库 2 读到了同一事务写入的数据。如果事后再中止用户 1 的事务,就连用户 2 的事务也必须撤销,因为它所依据的数据被追溯宣布为从未存在。
更好的办法是确保参与事务的节点要么全部提交,要么全部中止,绝不允许两种结果混杂。这就是所谓的 原子提交(atomic commitment)问题。
两阶段提交(2PC)
两阶段提交是一种跨多个节点实现原子事务提交的算法,也是分布式数据库中的经典算法13 71 72。有些数据库在内部使用 2PC;它也以 XA 事务73的形式开放给应用程序(例如 Java 事务 API 就支持 XA),或者通过 WS-AtomicTransaction 用于 SOAP Web 服务74 75。
2PC 的基本流程如图 8-13所示。单节点事务只需一次提交请求,2PC 则把提交或中止过程分成两个阶段,名称也由此而来。

2PC 引入了一个单节点事务中通常没有的组件:协调者(coordinator,也称为 事务管理器,transaction manager)。协调者通常实现为一个库,与发起事务的应用运行在同一进程中(例如嵌入 Java EE 容器);也可以作为独立进程或服务运行。Narayana、JOTM、BTM 和 MSDTC 都属于此类协调者。
使用 2PC 时,分布式事务照常开始:应用在多个数据库节点上读写数据,这些节点称为事务的 参与者(participant)。应用准备提交时,协调者进入第一阶段,向每个参与者发送 准备(prepare)请求,询问它是否能够提交,并收集各参与者的响应:
- 如果所有参与者都回答“是”,表示已准备好提交,协调者就在第二阶段发出 提交 请求,真正执行提交;
- 如果任何参与者回答“否”,协调者就在第二阶段向所有节点发送 中止 请求。
这个过程有点像西方传统婚礼:牧师分别询问新娘和新郎是否愿意与对方结婚,通常两人都会回答“我愿意”。收到双方确认后,牧师宣布二人结为夫妻——事务提交,这一喜讯也广播给所有来宾。如果任何一方没有回答“愿意”,仪式就会中止76。
系统承诺
仅凭上面的简短描述,或许还看不出为什么两阶段提交能够保证原子性,跨多个节点的一阶段提交却不能。毕竟在两阶段流程中,准备和提交请求同样可能丢失。2PC 究竟有何不同?
要理解它为何有效,需要把过程进一步拆解:
- 应用要启动分布式事务时,先向协调者申请一个全局唯一的事务 ID。
- 应用在每个参与者上启动一个单节点事务,并为其附上这个全局事务 ID。所有读写都在这些单节点事务中完成。如果此阶段出现任何问题(例如节点崩溃或请求超时),协调者或任何参与者都可以中止事务。
- 应用准备提交时,协调者向所有参与者发送带全局事务 ID 的准备请求。任何一个请求失败或超时,协调者都会向所有参与者发送该事务 ID 的中止请求。
- 参与者收到准备请求后,必须确保自己在任何情况下都一定能提交事务。这既包括把全部事务数据写入磁盘(崩溃、断电或磁盘空间耗尽都不能成为以后拒绝提交的理由),也包括检查冲突和约束违规。节点向协调者回答“是”,就等于承诺:只要收到要求,事务一定能够无误提交。换句话说,参与者尚未真正提交,却已经放弃了自行中止事务的权利。
- 协调者收到所有准备请求的响应后,便对提交还是中止作出最终决定(只有所有参与者都投“是”才会提交)。协调者必须把决定写入磁盘上的事务日志,这样即使随后崩溃,恢复后也知道自己作过什么决定。这一时刻称为 提交点(commit point)。
- 协调者的决定一旦落盘,就向所有参与者发送提交或中止请求。请求若失败或超时,协调者必须不断重试,直到成功为止。此时再无回头路:如果决定提交,就必须执行到底,无论需要重试多少次。参与者若在此期间崩溃,恢复后也必须提交事务——既然它已经投了“是”,就不能反悔。
因此,协议中有两个关键的“不归点”:参与者投“是”时,承诺自己日后一定能够提交(尽管协调者仍可决定中止);协调者一旦作出决定,该决定便不可撤销。正是这套承诺保证了 2PC 的原子性。(单节点原子提交把这两件事合并成一步:将提交记录写入事务日志。)
回到婚礼的比喻:说出“我愿意”之前,你或准配偶都可以用“绝对不行!”之类的回答中止事务;一旦说出“我愿意”,就不能撤回。即使说完后昏了过去,没有听见牧师宣布“你们现在结为夫妻”,也不会改变事务已经提交的事实。恢复意识后,可以向牧师查询全局事务 ID 的状态,确认自己是否已经成婚;也可以等待牧师再次发送提交请求——在你昏迷期间,他一直都在重试。
协调者失效
我们已经讨论过 2PC 期间参与者或网络发生故障时会怎样:任何准备请求失败或超时,协调者都会中止事务;任何提交或中止请求失败,协调者都会无限重试。但协调者自身崩溃时会发生什么,就没那么清楚了。
如果协调者在发送准备请求前失效,参与者可以安全中止事务。但参与者一旦收到准备请求并投出“是”,便不能再单方面中止,必须等待协调者告知事务究竟提交还是中止。如果协调者此时崩溃或网络发生故障,参与者只能等待。这种状态下的事务称为 存疑(in doubt)或 不确定(uncertain)事务。
图 8-14展示了这种情况。在图中的例子里,协调者实际决定提交,数据库 2 也收到了提交请求;但协调者还没来得及把提交请求发给数据库 1 就崩溃了,所以数据库 1 不知道该提交还是中止。超时对此也无济于事:数据库 1 若在超时后自行中止,就会与已经提交的数据库 2 不一致;自行提交同样不安全,因为另一个参与者可能已经中止。

收不到协调者的消息,参与者就无从知道应提交还是中止。原则上,参与者可以相互通信,了解各自如何投票并达成某种协议,但这并不属于 2PC 协议。
完成 2PC 的唯一办法,就是等待协调者恢复。这正是协调者必须先把提交或中止决定写入磁盘事务日志,再向参与者发送请求的原因。协调者恢复后,通过读取事务日志来确定所有存疑事务的状态;协调者日志中没有提交记录的事务一律中止。因此,2PC 的提交点归根结底是协调者上的一次普通单节点原子提交。
三阶段提交
由于 2PC 可能卡住并一直等待协调者恢复,两阶段提交也称为 阻塞式(blocking)原子提交协议。理论上可以设计 非阻塞式(nonblocking)原子提交协议,使它在节点发生故障时不会卡住;但要在实践中做到这一点并不容易。
有人提出 三阶段提交(three-phase commit,3PC)作为 2PC 的替代方案13 77。然而,3PC 假设网络延迟有上界、节点响应时间也有上界;大多数现实系统都存在无界网络延迟和进程暂停(参见第 9 章),3PC 在其中无法保证原子性。
实践中更好的办法,是用容错共识协议替代单节点协调者。第 10 章将介绍如何做到这一点。
跨不同系统的分布式事务
分布式事务和两阶段提交的名声毁誉参半。一方面,它们提供了难以用其他方式实现的重要安全保证;另一方面,它们又因引发运维问题、严重损害性能,以及作出力所不及的承诺而备受批评78 79 80 81。许多云服务正是出于这些运维问题,选择不实现分布式事务82。
某些分布式事务实现会带来沉重的性能代价。两阶段提交的固有开销,大多来自崩溃恢复所需的额外强制刷盘(fsync)和额外网络往返。
不过,我们不应就此全盘否定分布式事务,而应仔细审视,从中汲取重要经验。首先要明确“分布式事务”究竟指什么,因为人们经常混淆两种截然不同的分布式事务:
- 数据库内部分布式事务
- 一些分布式数据库(即标准配置就使用复制和分片的数据库)支持数据库节点之间的内部事务。例如,YugabyteDB、TiDB、FoundationDB、Spanner、VoltDB,以及 MySQL Cluster 的 NDB 存储引擎都支持内部事务。此时,参与事务的所有节点运行的都是同一种数据库软件。
- 异构分布式事务
- 异构 事务的参与者来自两种或更多不同技术,例如不同厂商的两种数据库,甚至还包括消息代理等非数据库系统。即使底层系统截然不同,跨系统分布式事务仍必须保证原子提交。
数据库内部事务无须与其他系统兼容,因而可以采用任意协议,并针对具体技术进行优化。所以,数据库内部的分布式事务通常运转良好;跨异构技术的事务则困难得多。
恰好一次消息处理
异构分布式事务可以用强有力的方式集成不同系统。例如,当且仅当处理消息的数据库事务成功提交,才确认消息队列中的那条消息已经处理。实现方法是在同一个事务中原子提交 消息确认 和 数据库写入。有了分布式事务,即使消息代理与数据库是运行在不同机器上的两种互不相关的技术,也能做到这一点。
如果消息传递或数据库事务任一失败,两者都会中止,消息代理稍后便可安全地重新投递。通过原子提交消息及其处理副作用,可以确保消息实际上 恰好处理一次,即使成功之前重试了好几次。每次中止都会丢弃未完成事务产生的所有副作用。这就是 恰好一次语义(exactly-once semantics)。
不过,只有事务影响的所有系统都能采用同一种原子提交协议,这类分布式事务才有可能实现。例如,假设处理消息的副作用是发送邮件,而邮件服务器不支持两阶段提交;一旦消息处理失败并重试,邮件就可能发送两次甚至更多次。反之,如果事务中止时,消息处理产生的所有副作用都能回滚,那么处理过程便可安全重试,就像什么也没有发生一样。
本章稍后还会回到恰好一次语义。现在先来看看支持这类异构分布式事务的原子提交协议。
XA 事务
X/Open XA(eXtended Architecture,即扩展架构的缩写)是跨异构技术实现两阶段提交的标准73。它于 1991 年发布,如今已得到广泛实现:许多传统关系型数据库(包括 PostgreSQL、MySQL、Db2、SQL Server 和 Oracle)和消息代理(包括 ActiveMQ、HornetQ、MSMQ 和 IBM MQ)都支持 XA。
XA 并不是网络协议,而只是一套与事务协调者交互的 C API。其他语言也提供相应绑定。例如,在 Java EE 应用中,XA 事务通过 Java 事务 API(JTA)实现;许多使用 Java 数据库连接(JDBC)的数据库驱动,以及使用 Java 消息服务(JMS)API 的消息代理驱动都支持 JTA。
XA 假定应用通过网络驱动或客户端库,与参与者数据库或消息服务通信。驱动支持 XA,意味着它会调用 XA API,判断某项操作是否属于分布式事务;若是,就把必要信息发送给数据库服务器。驱动还会暴露回调接口,供协调者要求参与者准备、提交或中止。
事务协调者负责实现 XA API。标准没有规定具体实现方式;实践中,协调者通常只是一个加载到事务发起应用同一进程中的库,而不是独立服务。它跟踪事务中的所有参与者,要求它们准备后通过驱动回调收集响应,并用本地磁盘日志记录每个事务的提交或中止决定。
如果应用进程崩溃,或运行应用的机器宕机,协调者也会随之消失。所有持有已准备但尚未提交事务的参与者,都会陷入存疑状态。协调者日志位于应用服务器的本地磁盘上,因此必须重启这台服务器,再由协调者库读取日志,恢复各事务的提交或中止结果。之后,协调者才能通过数据库驱动的 XA 回调,要求参与者提交或中止。数据库服务器无法直接联系协调者,因为所有通信都必须经过客户端库。
存疑时持有锁
为什么要如此在意存疑事务?难道系统其他部分不能照常工作,暂且忽略这些最终总会清理掉的事务吗?
问题出在 锁 上。正如“读已提交”所述,数据库事务通常会对修改的每一行取得行级独占锁,以防止脏写。如果还要求可串行化隔离,那么采用两阶段锁定的数据库也必须为事务 读取 的每一行取得共享锁。
事务提交或中止之前,数据库不能释放这些锁(如图 8-13中的阴影部分所示)。所以使用两阶段提交时,事务必须在整个存疑期间持锁。协调者若崩溃后要花 20 分钟重启,锁就会持有 20 分钟;协调者日志若因故彻底丢失,锁甚至会永远保留——至少要一直等到管理员手动解决问题。
持锁期间,其他事务无法修改这些行;视隔离级别而定,甚至连读取也可能被阻塞。因此,其他事务无法若无其事地继续运行——只要访问同一份数据,就会卡住。应用程序的大部分功能都可能因此不可用,直至存疑事务得到解决。
从协调者失效中恢复
理论上,协调者崩溃重启后,应该能从日志完整恢复状态,并解决所有存疑事务。但实践中确实会出现 孤立的 存疑事务83 84:协调者由于某种原因无法确定事务结果,例如软件缺陷导致事务日志丢失或损坏。这些事务无法自动解决,只能一直留在数据库中,持有锁并阻塞其他事务。
重启数据库服务器也解决不了问题。正确的 2PC 实现必须跨重启保留存疑事务的锁,否则就有破坏原子性保证的风险。这种局面十分棘手。
唯一的出路,是由管理员手动决定提交还是回滚。管理员必须检查每个存疑事务的所有参与者,确定是否已有参与者提交或中止,再把同样的结果应用到其余参与者。这项工作可能耗费大量人力,而且往往要在严重生产中断期间,承受巨大的精神与时间压力来完成——否则协调者也不会陷入如此糟糕的状态。
许多 XA 实现都留有一个称为 启发式决策(heuristic decision)的紧急出口:即使协调者没有给出明确决定,也允许参与者单方面中止或提交存疑事务73。需要直说的是,这里的“启发式”只是“很可能破坏原子性”的委婉说法,因为它违背了两阶段提交的承诺体系。因此,启发式决策只用于摆脱灾难性局面,绝不能作为常规手段。
XA 事务的问题
单节点协调者是整个系统的单点故障。把协调者放进应用服务器同样有问题,因为协调者本地磁盘上的日志会成为持久系统状态的关键部分,其重要性不亚于数据库本身。
原则上,XA 事务的协调者可以像其他重要数据库一样实现高可用和复制。遗憾的是,这仍解决不了 XA 的一个根本问题:它没有提供协调者与事务参与者直接通信的办法。二者只能通过发起事务的应用代码,以及应用用来调用参与者的数据库驱动进行通信。
因此,即使复制了协调者,应用代码依然是单点故障。要解决这个问题,必须彻底重构应用代码的运行方式,使其可复制或可重启,形式上可能类似持久化执行(参见“持久化执行与工作流”)。但实践中似乎没有工具真正采用这种方案。
另一个问题是,XA 必须兼容形形色色的数据系统,因而只能取它们的最低公分母。例如,它无法检测横跨不同系统的死锁,因为这需要一套标准协议,让系统交换每个事务正在等待哪些锁;它也无法配合 SSI 使用(参见“可串行化快照隔离(SSI)”),因为 SSI 需要一套跨系统识别冲突的协议。
这些问题在一定程度上是跨异构技术执行事务的固有困难。然而,让多个异构数据系统彼此保持一致仍是一个真实而重要的需求,所以必须另寻解决方案。办法的确存在,下一节和“衍生数据与分布式事务”将作介绍。
数据库内部的分布式事务
如前所述,横跨多种异构存储技术的分布式事务,与系统内部的分布式事务大不相同。在后者中,所有参与节点都是同一数据库的分片,运行相同软件。内部的分布式事务是 CockroachDB5、TiDB6、Spanner7、FoundationDB8 和 YugabyteDB 等“NewSQL”数据库的标志性特征。Kafka 等消息代理也支持内部的分布式事务85。
这些系统中有许多使用两阶段提交,来保证写入多个分片的事务具备原子性,却不会遇到 XA 事务的那些问题。因为其分布式事务无须对接其他技术,所以能够避开最低公分母陷阱;系统设计者可以自由采用更可靠、更快速的协议。
XA 最严重的几个问题可以这样解决:
- 复制协调者;主协调者崩溃时,自动故障切换到另一个协调者节点;
- 允许协调者和数据分片直接通信,不再经过应用代码;
- 复制参与事务的分片,降低因某个分片故障而不得不中止事务的风险;
- 将原子提交协议与分布式并发控制协议结合起来,由后者支持跨分片死锁检测和一致读取。
协调者和数据库分片通常采用共识算法复制。第 10 章将介绍怎样用共识算法实现分布式事务的原子提交。这些算法无需人工干预,就能自动从发生故障的节点切换到另一个节点,在容忍故障的同时继续保证强一致性属性。
分布式事务提供哪种隔离级别,取决于具体系统;但跨分片实现快照隔离和可串行化快照隔离都是可行的。其工作原理详见本章末尾引用的论文。
再谈恰好一次消息处理
“恰好一次消息处理”介绍过,分布式事务的一个重要用途,是保证某项操作恰好生效一次,即使处理期间发生崩溃、不得不重试也不例外。如果能跨消息代理和数据库原子提交事务,就可以做到:当且仅当消息成功处理、处理产生的数据库写入也成功提交时,才向代理确认消息。
不过,要实现恰好一次语义,其实并不需要这样的分布式事务。下面的替代方案只要求数据库本身支持事务:
- 假设每条消息都有唯一 ID,数据库中另有一张表,记录已经处理过的消息 ID。从代理取得消息并开始处理时,先在数据库中启动新事务,再检查消息 ID。如果数据库中已有相同 ID,就知道该消息已经处理过,可以向代理确认并丢弃这条消息。
- 如果数据库中尚无该消息 ID,就将其加入表中,然后处理消息。处理过程可能在同一个事务中对数据库执行更多写入。消息处理完成后,提交数据库事务。
- 数据库事务成功提交后,便可向代理确认消息。
- 消息成功向代理确认后,就知道代理不会再次尝试处理同一条消息,因此可以另开一个事务,从数据库删除该消息 ID。
如果消息处理器在提交数据库事务前崩溃,事务会中止,消息代理随后重试。如果它在提交后、向代理确认前崩溃,代理同样会重试;但重试时能在数据库中看到消息 ID,于是直接丢弃该消息。如果它在确认后、从数据库删除消息 ID 前崩溃,数据库只会残留一条旧消息 ID,除了占用少量空间,不会造成其他危害。重试也可能发生在原数据库事务中止之前——例如消息处理器与数据库之间的通信中断——此时消息 ID 表上的唯一性约束应能防止两个并发事务插入相同 ID。
因此,实现恰好一次处理只需要数据库内部的事务;这个用例并不要求数据库与消息代理之间具备原子性。把消息 ID 记入数据库,可以让消息处理具备 幂等性(idempotence),因而能够安全重试而不重复产生副作用。Kafka Streams 等流处理框架也用类似办法实现恰好一次语义,详见“容错”。
不过,数据库内部的分布式事务仍有助于扩展这类模式。例如,消息 ID 可以存放在一个分片上,消息处理所更新的业务数据放在其他分片上,再由内部事务保证跨分片提交的原子性。
总结
事务是一层抽象,让应用程序可以假装某些并发问题,以及某些软硬件故障并不存在。种类繁多的错误都被简化成一次 事务中止,应用程序只需重试即可。
本章考察了许多事务有助于防范的问题。并非所有应用都会遇到其中每一种问题:访问模式非常简单的应用(例如只读写单条记录),没有事务或许也能应付。但面对更复杂的访问模式,事务可以大幅减少需要考虑的潜在错误场景。
没有事务,进程崩溃、网络中断、断电、磁盘空间耗尽、意外并发等各种错误场景,都可能以不同方式造成数据不一致。例如,反规范化数据很容易与源数据失去同步。缺少事务时,复杂而相互影响的访问究竟会给数据库带来什么后果,很难推理。
本章尤其深入地探讨了并发控制。我们介绍了几种广泛使用的隔离级别,特别是 读已提交、快照隔离(有时称为 可重复读)和 可串行化,并通过各种竞态条件来刻画它们。表 8-1汇总了这些内容:
| 隔离级别 | 脏读 | 读偏差 | 幻读 | 丢失更新 | 写偏差 |
|---|---|---|---|---|---|
| 读未提交 | ✗ 可能 | ✗ 可能 | ✗ 可能 | ✗ 可能 | ✗ 可能 |
| 读已提交 | ✓ 防止 | ✗ 可能 | ✗ 可能 | ✗ 可能 | ✗ 可能 |
| 快照隔离 | ✓ 防止 | ✓ 防止 | ✓ 防止 | ? 视情况 | ✗ 可能 |
| 可串行化 | ✓ 防止 | ✓ 防止 | ✓ 防止 | ✓ 防止 | ✓ 防止 |
- 脏读
- 一个客户端在另一个客户端的写入提交前就读到了这些数据。读已提交及更强的隔离级别可以防止脏读。
- 脏写
- 一个客户端覆盖另一个客户端已经写入、但尚未提交的数据。几乎所有事务实现都会防止脏写。
- 读偏差
- 客户端在不同时间点观察数据库的不同部分。有些读偏差也称为 不可重复读。防止这个问题最常用的办法是快照隔离,它允许事务读取与某个特定时刻对应的一致快照,通常以 多版本并发控制(MVCC)实现。
- 丢失更新
- 两个客户端并发执行读取—修改—写入循环,其中一个覆盖另一个的写入,却没有合并对方的修改,因而造成数据丢失。有些快照隔离实现会自动防止这种异常,另一些则需要手动加锁(
SELECT FOR UPDATE)。 - 写偏差
- 事务读取数据,根据看到的值作出决定,再把决定写入数据库。但真正写入时,作出决定所依据的前提已经不再成立。只有可串行化隔离能够防止这种异常。
- 幻读
- 事务读取符合某项搜索条件的对象,另一个客户端随后写入,改变了搜索结果。快照隔离可以防止直接的幻读,但写偏差场景中的幻读需要特殊处理,例如使用索引范围锁。
弱隔离级别能防止其中一部分异常,却把其他异常留给应用开发者手动处理(例如显式加锁)。只有可串行化隔离能防范所有这些问题。我们讨论了三种实现可串行化事务的办法:
- 严格按串行顺序执行事务
- 如果每个事务都能极快完成(通常借助存储过程),而且事务吞吐量足够低,能由单个 CPU 核处理,或者事务能够分片执行,那么这是一种简单有效的选择。
- 两阶段锁定
- 几十年来,这一直是实现可串行化的标准方法,但由于性能不佳,许多应用会避开它。
- 可串行化快照隔离(SSI)
- 一种相对较新的算法,避开了前两种方案的大部分缺点。它采用乐观方式,允许事务不受阻塞地继续运行;事务准备提交时再接受检查,若执行结果不可串行化,就会中止。
最后,我们研究了如何用两阶段提交,为跨多个节点的事务实现原子性。如果所有节点都运行相同的数据库软件,分布式事务往往能良好运转;但一旦横跨不同存储技术(使用 XA 事务),2PC 就会问题重重:它对协调者和驱动事务的应用代码中的故障非常敏感,与并发控制机制也难以配合。所幸,幂等性可以在不要求跨异构存储原子提交的情况下,保证恰好一次语义。后续章节还会进一步讨论这个主题。
本章的示例采用关系数据模型。不过,正如“多对象事务的需求”所说,无论采用哪一种数据模型,事务都是一项很有价值的数据库功能。
参考文献
Steven J. Murdoch. What went wrong with Horizon: learning from the Post Office Trial. benthamsgaze.org, July 2021. Archived at perma.cc/CNM4-553F ↩︎
Donald D. Chamberlin, Morton M. Astrahan, Michael W. Blasgen, James N. Gray, W. Frank King, Bruce G. Lindsay, Raymond Lorie, James W. Mehl, Thomas G. Price, Franco Putzolu, Patricia Griffiths Selinger, Mario Schkolnick, Donald R. Slutz, Irving L. Traiger, Bradford W. Wade, and Robert A. Yost. A History and Evaluation of System R. Communications of the ACM, volume 24, issue 10, pages 632–646, October 1981. doi:10.1145/358769.358784 ↩︎
Jim N. Gray, Raymond A. Lorie, Gianfranco R. Putzolu, and Irving L. Traiger. Granularity of Locks and Degrees of Consistency in a Shared Data Base. in Modelling in Data Base Management Systems: Proceedings of the IFIP Working Conference on Modelling in Data Base Management Systems, edited by G. M. Nijssen, pages 364–394, Elsevier/North Holland Publishing, 1976. Also in Readings in Database Systems, 4th edition, edited by Joseph M. Hellerstein and Michael Stonebraker, MIT Press, 2005. ISBN: 978-0-262-69314-1 ↩︎ ↩︎ ↩︎ ↩︎
Kapali P. Eswaran, Jim N. Gray, Raymond A. Lorie, and Irving L. Traiger. The Notions of Consistency and Predicate Locks in a Database System. Communications of the ACM, volume 19, issue 11, pages 624–633, November 1976. doi:10.1145/360363.360369 ↩︎ ↩︎ ↩︎
Rebecca Taft, Irfan Sharif, Andrei Matei, Nathan VanBenschoten, Jordan Lewis, Tobias Grieger, Kai Niemi, Andy Woods, Anne Birzin, Raphael Poss, Paul Bardea, Amruta Ranade, Ben Darnell, Bram Gruneir, Justin Jaffray, Lucy Zhang, and Peter Mattis. CockroachDB: The Resilient Geo-Distributed SQL Database. At ACM SIGMOD International Conference on Management of Data (SIGMOD), pages 1493–1509, June 2020. doi:10.1145/3318464.3386134 ↩︎ ↩︎ ↩︎
Dongxu Huang, Qi Liu, Qiu Cui, Zhuhe Fang, Xiaoyu Ma, Fei Xu, Li Shen, Liu Tang, Yuxing Zhou, Menglong Huang, Wan Wei, Cong Liu, Jian Zhang, Jianjun Li, Xuelian Wu, Lingyu Song, Ruoxi Sun, Shuaipeng Yu, Lei Zhao, Nicholas Cameron, Liquan Pei, and Xin Tang. TiDB: a Raft-based HTAP database. Proceedings of the VLDB Endowment, volume 13, issue 12, pages 3072–3084. doi:10.14778/3415478.3415535 ↩︎ ↩︎
James C. Corbett, Jeffrey Dean, Michael Epstein, Andrew Fikes, Christopher Frost, JJ Furman, Sanjay Ghemawat, Andrey Gubarev, Christopher Heiser, Peter Hochschild, Wilson Hsieh, Sebastian Kanthak, Eugene Kogan, Hongyi Li, Alexander Lloyd, Sergey Melnik, David Mwaura, David Nagle, Sean Quinlan, Rajesh Rao, Lindsay Rolig, Dale Woodford, Yasushi Saito, Christopher Taylor, Michal Szymaniak, and Ruth Wang. Spanner: Google’s Globally-Distributed Database. At 10th USENIX Symposium on Operating System Design and Implementation (OSDI), October 2012. ↩︎ ↩︎
Jingyu Zhou, Meng Xu, Alexander Shraer, Bala Namasivayam, Alex Miller, Evan Tschannen, Steve Atherton, Andrew J. Beamon, Rusty Sears, John Leach, Dave Rosenthal, Xin Dong, Will Wilson, Ben Collins, David Scherer, Alec Grieser, Young Liu, Alvin Moore, Bhaskar Muppana, Xiaoge Su, and Vishesh Yadav. FoundationDB: A Distributed Unbundled Transactional Key Value Store. At ACM International Conference on Management of Data (SIGMOD), June 2021. doi:10.1145/3448016.3457559 ↩︎ ↩︎ ↩︎ ↩︎
Theo Härder and Andreas Reuter. Principles of Transaction-Oriented Database Recovery. ACM Computing Surveys, volume 15, issue 4, pages 287–317, December 1983. doi:10.1145/289.291 ↩︎
Peter Bailis, Alan Fekete, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. HAT, not CAP: Towards Highly Available Transactions. At 14th USENIX Workshop on Hot Topics in Operating Systems (HotOS), May 2013. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Armando Fox, Steven D. Gribble, Yatin Chawathe, Eric A. Brewer, and Paul Gauthier. Cluster-Based Scalable Network Services. At 16th ACM Symposium on Operating Systems Principles (SOSP), October 1997. doi:10.1145/268998.266662 ↩︎
Tony Andrews. Enforcing Complex Constraints in Oracle. tonyandrews.blogspot.co.uk, October 2004. Archived at archive.org ↩︎ ↩︎
Philip A. Bernstein, Vassos Hadzilacos, and Nathan Goodman. Concurrency Control and Recovery in Database Systems. Addison-Wesley, 1987. ISBN: 978-0-201-10715-9, available online at microsoft.com. ↩︎ ↩︎ ↩︎
Alan Fekete, Dimitrios Liarokapis, Elizabeth O’Neil, Patrick O’Neil, and Dennis Shasha. Making Snapshot Isolation Serializable. ACM Transactions on Database Systems, volume 30, issue 2, pages 492–528, June 2005. doi:10.1145/1071610.1071615 ↩︎ ↩︎ ↩︎
Mai Zheng, Joseph Tucek, Feng Qin, and Mark Lillibridge. Understanding the Robustness of SSDs Under Power Fault. At 11th USENIX Conference on File and Storage Technologies (FAST), February 2013. ↩︎
Laurie Denness. SSDs: A Gift and a Curse. laur.ie, June 2015. Archived at perma.cc/6GLP-BX3T ↩︎
Adam Surak. When Solid State Drives Are Not That Solid. blog.algolia.com, June 2015. Archived at perma.cc/CBR9-QZEE ↩︎
Hewlett Packard Enterprise. Bulletin: (Revision) HPE SAS Solid State Drives - Critical Firmware Upgrade Required for Certain HPE SAS Solid State Drive Models to Prevent Drive Failure at 32,768 Hours of Operation. support.hpe.com, November 2019. Archived at perma.cc/CZR4-AQBS ↩︎
Craig Ringer et al. PostgreSQL’s handling of fsync() errors is unsafe and risks data loss at least on XFS. Email thread on pgsql-hackers mailing list, postgresql.org, March 2018. Archived at perma.cc/5RKU-57FL ↩︎
Anthony Rebello, Yuvraj Patel, Ramnatthan Alagappan, Andrea C. Arpaci-Dusseau, and Remzi H. Arpaci-Dusseau. Can Applications Recover from fsync Failures? At USENIX Annual Technical Conference (ATC), July 2020. ↩︎
Thanumalayan Sankaranarayana Pillai, Vijay Chidambaram, Ramnatthan Alagappan, Samer Al-Kiswany, Andrea C. Arpaci-Dusseau, and Remzi H. Arpaci-Dusseau. Crash Consistency: Rethinking the Fundamental Abstractions of the File System. ACM Queue, volume 13, issue 7, pages 20–28, July 2015. doi:10.1145/2800695.2801719 ↩︎
Thanumalayan Sankaranarayana Pillai, Vijay Chidambaram, Ramnatthan Alagappan, Samer Al-Kiswany, Andrea C. Arpaci-Dusseau, and Remzi H. Arpaci-Dusseau. All File Systems Are Not Created Equal: On the Complexity of Crafting Crash-Consistent Applications. At 11th USENIX Symposium on Operating Systems Design and Implementation (OSDI), October 2014. ↩︎ ↩︎
Chris Siebenmann. Unix’s File Durability Problem. utcc.utoronto.ca, April 2016. Archived at perma.cc/VSS8-5MC4 ↩︎
Aishwarya Ganesan, Ramnatthan Alagappan, Andrea C. Arpaci-Dusseau, and Remzi H. Arpaci-Dusseau. Redundancy Does Not Imply Fault Tolerance: Analysis of Distributed Storage Reactions to Single Errors and Corruptions. At 15th USENIX Conference on File and Storage Technologies (FAST), February 2017. ↩︎
Lakshmi N. Bairavasundaram, Garth R. Goodson, Bianca Schroeder, Andrea C. Arpaci-Dusseau, and Remzi H. Arpaci-Dusseau. An Analysis of Data Corruption in the Storage Stack. At 6th USENIX Conference on File and Storage Technologies (FAST), February 2008. ↩︎
Bianca Schroeder, Raghav Lagisetty, and Arif Merchant. Flash Reliability in Production: The Expected and the Unexpected. At 14th USENIX Conference on File and Storage Technologies (FAST), February 2016. ↩︎
Don Allison. SSD Storage – Ignorance of Technology Is No Excuse. blog.korelogic.com, March 2015. Archived at perma.cc/9QN4-9SNJ ↩︎
Gordon Mah Ung. Debunked: Your SSD won’t lose data if left unplugged after all. pcworld.com, May 2015. Archived at perma.cc/S46H-JUDU ↩︎
Martin Kleppmann. Hermitage: Testing the ‘I’ in ACID. martin.kleppmann.com, November 2014. Archived at perma.cc/KP2Y-AQGK ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Todd Warszawski and Peter Bailis. ACIDRain: Concurrency-Related Attacks on Database-Backed Web Applications. At ACM International Conference on Management of Data (SIGMOD), May 2017. doi:10.1145/3035918.3064037 ↩︎ ↩︎
Tristan D’Agosta. BTC Stolen from Poloniex. bitcointalk.org, March 2014. Archived at perma.cc/YHA6-4C5D ↩︎
bitcointhief2. How I Stole Roughly 100 BTC from an Exchange and How I Could Have Stolen More! reddit.com, February 2014. Archived at archive.org ↩︎
Sudhir Jorwekar, Alan Fekete, Krithi Ramamritham, and S. Sudarshan. Automating the Detection of Snapshot Isolation Anomalies. At 33rd International Conference on Very Large Data Bases (VLDB), September 2007. ↩︎ ↩︎
Michael Melanson. Transactions: The Limits of Isolation. michaelmelanson.net, November 2014. Archived at perma.cc/RG5R-KMYZ ↩︎
Edward Kim. How ACH works: A developer perspective — Part 1. engineering.gusto.com, April 2014. Archived at perma.cc/7B2H-PU94 ↩︎
Hal Berenson, Philip A. Bernstein, Jim N. Gray, Jim Melton, Elizabeth O’Neil, and Patrick O’Neil. A Critique of ANSI SQL Isolation Levels. At ACM International Conference on Management of Data (SIGMOD), May 1995. doi:10.1145/568271.223785 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Atul Adya. Weak Consistency: A Generalized Theory and Optimistic Implementations for Distributed Transactions. PhD Thesis, Massachusetts Institute of Technology, March 1999. Archived at perma.cc/E97M-HW5Q ↩︎ ↩︎
Peter Bailis, Aaron Davidson, Alan Fekete, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. Highly Available Transactions: Virtues and Limitations. At 40th International Conference on Very Large Data Bases (VLDB), September 2014. ↩︎ ↩︎ ↩︎
Natacha Crooks, Youer Pu, Lorenzo Alvisi, and Allen Clement. Seeing is Believing: A Client-Centric Specification of Database Isolation. At ACM Symposium on Principles of Distributed Computing (PODC), pages 73–82, July 2017. doi:10.1145/3087801.3087802 ↩︎
Bruce Momjian. MVCC Unmasked. momjian.us, July 2014. Archived at perma.cc/KQ47-9GYB ↩︎ ↩︎ ↩︎
Peter Alvaro and Kyle Kingsbury. MySQL 8.0.34. jepsen.io, December 2023. Archived at perma.cc/HGE2-Z878 ↩︎ ↩︎ ↩︎
Egor Rogov. PostgreSQL 14 Internals. postgrespro.com, April 2023. Archived at perma.cc/FRK2-D7WB ↩︎
Hironobu Suzuki. The Internals of PostgreSQL. interdb.jp, 2017. ↩︎ ↩︎
Rohan Reddy Alleti. Internals of MVCC in Postgres: Hidden costs of Updates vs Inserts. medium.com, March 2025. Archived at perma.cc/3ACX-DFXT ↩︎
Andy Pavlo and Bohan Zhang. The Part of PostgreSQL We Hate the Most. cs.cmu.edu, April 2023. Archived at perma.cc/XSP6-3JBN ↩︎ ↩︎
Yingjun Wu, Joy Arulraj, Jiexi Lin, Ran Xian, and Andrew Pavlo. An empirical evaluation of in-memory multi-version concurrency control. Proceedings of the VLDB Endowment, volume 10, issue 7, pages 781–792, March 2017. doi:10.14778/3067421.3067427 ↩︎ ↩︎
Nikita Prokopov. Unofficial Guide to Datomic Internals. tonsky.me, May 2014. ↩︎
Daniil Svetlov. A Practical Guide to Taming Postgres Isolation Anomalies. dansvetlov.me, March 2025. Archived at perma.cc/L7LE-TDLS ↩︎
Nate Wiger. An Atomic Rant. nateware.com, February 2010. Archived at perma.cc/5ZYB-PE44 ↩︎
James Coglan. Reading and writing, part 3: web applications. blog.jcoglan.com, October 2020. Archived at perma.cc/A7EK-PJVS ↩︎ ↩︎
Peter Bailis, Alan Fekete, Michael J. Franklin, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. Feral Concurrency Control: An Empirical Investigation of Modern Application Integrity. At ACM International Conference on Management of Data (SIGMOD), June 2015. doi:10.1145/2723372.2737784 ↩︎ ↩︎
Jaana Dogan. Things I Wished More Developers Knew About Databases. rakyll.medium.com, April 2020. Archived at perma.cc/6EFK-P2TD ↩︎
Michael J. Cahill, Uwe Röhm, and Alan Fekete. Serializable Isolation for Snapshot Databases. At ACM International Conference on Management of Data (SIGMOD), June 2008. doi:10.1145/1376616.1376690 ↩︎ ↩︎
Dan R. K. Ports and Kevin Grittner. Serializable Snapshot Isolation in PostgreSQL. At 38th International Conference on Very Large Databases (VLDB), August 2012. ↩︎ ↩︎ ↩︎ ↩︎
Douglas B. Terry, Marvin M. Theimer, Karin Petersen, Alan J. Demers, Mike J. Spreitzer and Carl H. Hauser. Managing Update Conflicts in Bayou, a Weakly Connected Replicated Storage System. At 15th ACM Symposium on Operating Systems Principles (SOSP), December 1995. doi:10.1145/224056.224070 ↩︎
Hans-Jürgen Schönig. Constraints over multiple rows in PostgreSQL. cybertec-postgresql.com, June 2021. Archived at perma.cc/2TGH-XUPZ ↩︎
Michael Stonebraker, Samuel Madden, Daniel J. Abadi, Stavros Harizopoulos, Nabil Hachem, and Pat Helland. The End of an Architectural Era (It’s Time for a Complete Rewrite). At 33rd International Conference on Very Large Data Bases (VLDB), September 2007. ↩︎
John Hugg. H-Store/VoltDB Architecture vs. CEP Systems and Newer Streaming Architectures. At Data @Scale Boston, November 2014. ↩︎
Robert Kallman, Hideaki Kimura, Jonathan Natkins, Andrew Pavlo, Alexander Rasin, Stanley Zdonik, Evan P. C. Jones, Samuel Madden, Michael Stonebraker, Yang Zhang, John Hugg, and Daniel J. Abadi. H-Store: A High-Performance, Distributed Main Memory Transaction Processing System. Proceedings of the VLDB Endowment, volume 1, issue 2, pages 1496–1499, August 2008. ↩︎ ↩︎
Rich Hickey. The Architecture of Datomic. infoq.com, November 2012. Archived at perma.cc/5YWU-8XJK ↩︎
John Hugg. Debunking Myths About the VoltDB In-Memory Database. dzone.com, May 2014. Archived at perma.cc/2Z9N-HPKF ↩︎ ↩︎
Xinjing Zhou, Viktor Leis, Xiangyao Yu, and Michael Stonebraker. OLTP Through the Looking Glass 16 Years Later: Communication is the New Bottleneck. At 15th Annual Conference on Innovative Data Systems Research (CIDR), January 2025. ↩︎
Xinjing Zhou, Xiangyao Yu, Goetz Graefe, and Michael Stonebraker. Lotus: scalable multi-partition transactions on single-threaded partitioned databases. Proceedings of the VLDB Endowment (PVLDB), volume 15, issue 11, pages 2939–2952, July 2022. doi:10.14778/3551793.3551843 ↩︎
Joseph M. Hellerstein, Michael Stonebraker, and James Hamilton. Architecture of a Database System. Foundations and Trends in Databases, volume 1, issue 2, pages 141–259, November 2007. doi:10.1561/1900000002 ↩︎
Michael J. Cahill. Serializable Isolation for Snapshot Databases. PhD Thesis, University of Sydney, July 2009. Archived at perma.cc/727J-NTMP ↩︎
Cristian Diaconu, Craig Freedman, Erik Ismert, Per-Åke Larson, Pravin Mittal, Ryan Stonecipher, Nitin Verma, and Mike Zwilling. Hekaton: SQL Server’s Memory-Optimized OLTP Engine. At ACM SIGMOD International Conference on Management of Data (SIGMOD), pages 1243–1254, June 2013. doi:10.1145/2463676.2463710 ↩︎
Thomas Neumann, Tobias Mühlbauer, and Alfons Kemper. Fast Serializable Multi-Version Concurrency Control for Main-Memory Database Systems. At ACM SIGMOD International Conference on Management of Data (SIGMOD), pages 677–689, May 2015. doi:10.1145/2723372.2749436 ↩︎ ↩︎
D. Z. Badal. Correctness of Concurrency Control and Implications in Distributed Databases. At 3rd International IEEE Computer Software and Applications Conference (COMPSAC), November 1979. doi:10.1109/CMPSAC.1979.762563 ↩︎
Rakesh Agrawal, Michael J. Carey, and Miron Livny. Concurrency Control Performance Modeling: Alternatives and Implications. ACM Transactions on Database Systems (TODS), volume 12, issue 4, pages 609–654, December 1987. doi:10.1145/32204.32220 ↩︎
Marc Brooker. Snapshot Isolation vs Serializability. brooker.co.za, December 2024. Archived at perma.cc/5TRC-CR5G ↩︎
B. G. Lindsay, P. G. Selinger, C. Galtieri, J. N. Gray, R. A. Lorie, T. G. Price, F. Putzolu, I. L. Traiger, and B. W. Wade. Notes on Distributed Databases. IBM Research, Research Report RJ2571(33471), July 1979. Archived at perma.cc/EPZ3-MHDD ↩︎
C. Mohan, Bruce G. Lindsay, and Ron Obermarck. Transaction Management in the R* Distributed Database Management System. ACM Transactions on Database Systems, volume 11, issue 4, pages 378–396, December 1986. doi:10.1145/7239.7266 ↩︎
X/Open Company Ltd. Distributed Transaction Processing: The XA Specification. Technical Standard XO/CAE/91/300, December 1991. ISBN: 978-1-872-63024-3, archived at perma.cc/Z96H-29JB ↩︎ ↩︎ ↩︎
Ivan Silva Neto and Francisco Reverbel. Lessons Learned from Implementing WS-Coordination and WS-AtomicTransaction. At 7th IEEE/ACIS International Conference on Computer and Information Science (ICIS), May 2008. doi:10.1109/ICIS.2008.75 ↩︎
James E. Johnson, David E. Langworthy, Leslie Lamport, and Friedrich H. Vogt. Formal Specification of a Web Services Protocol. At 1st International Workshop on Web Services and Formal Methods (WS-FM), February 2004. doi:10.1016/j.entcs.2004.02.022 ↩︎
Jim Gray. The Transaction Concept: Virtues and Limitations. At 7th International Conference on Very Large Data Bases (VLDB), September 1981. ↩︎
Dale Skeen. Nonblocking Commit Protocols. At ACM International Conference on Management of Data (SIGMOD), April 1981. doi:10.1145/582318.582339 ↩︎
Gregor Hohpe. Your Coffee Shop Doesn’t Use Two-Phase Commit. IEEE Software, volume 22, issue 2, pages 64–66, March 2005. doi:10.1109/MS.2005.52 ↩︎
Pat Helland. Life Beyond Distributed Transactions: An Apostate’s Opinion. At 3rd Biennial Conference on Innovative Data Systems Research (CIDR), January 2007. ↩︎
Jonathan Oliver. My Beef with MSDTC and Two-Phase Commits. blog.jonathanoliver.com, April 2011. Archived at perma.cc/K8HF-Z4EN ↩︎
Oren Eini (Ahende Rahien). The Fallacy of Distributed Transactions. ayende.com, July 2014. Archived at perma.cc/VB87-2JEF ↩︎
Clemens Vasters. Transactions in Windows Azure (with Service Bus) – An Email Discussion. learn.microsoft.com, July 2012. Archived at perma.cc/4EZ9-5SKW ↩︎
Ajmer Dhariwal. Orphaned MSDTC Transactions (-2 spids). eraofdata.com, December 2008. Archived at perma.cc/YG6F-U34C ↩︎
Paul Randal. Real World Story of DBCC PAGE Saving the Day. sqlskills.com, June 2013. Archived at perma.cc/2MJN-A5QH ↩︎
Guozhang Wang, Lei Chen, Ayusman Dikshit, Jason Gustafson, Boyang Chen, Matthias J. Sax, John Roesler, Sophie Blee-Goldman, Bruno Cadonna, Apurva Mehta, Varun Madan, and Jun Rao. Consistency and Completeness: Rethinking Distributed Stream Processing in Apache Kafka. At ACM International Conference on Management of Data (SIGMOD), June 2021. doi:10.1145/3448016.3457556 ↩︎
9 分布式系统的麻烦

意外这东西挺有意思:你没碰上之前,它就从来不会发生。
A.A. 米尔恩,《小熊维尼和老灰驴的家》(1928)
正如 “可靠性与容错” 中所讨论的,要使一个系统可靠,就要确保即使出了问题(即发生故障),整个系统仍能继续工作。然而,要预见并处理所有可能的故障并非易事。开发者很容易把注意力主要放在正常路径上(毕竟大多数时候一切都运行良好!),而忽略会带来大量边界情况的故障。
如果希望系统在发生故障时依然可靠,就必须从根本上转变思维方式,把注意力放在各种可能出错的地方,即使出错的概率很低。某件事只有百万分之一的概率出错并不意味着可以不管:系统足够大时,百万分之一的事件每天都会发生。经验丰富的系统运维人员会告诉你,任何 可能 出错的事情,终究都会 出错。
而且,使用 分布式系统(distributed system)与在单台计算机上编写软件有着根本区别——最主要的区别,就是事情有了许多新奇而刺激的出错方式 1 2。本章将带你领略实践中会遇到的问题,并帮助你理解哪些东西可以依赖,哪些不可以。
为了理解我们面对的挑战,接下来让我们把悲观主义发挥到极致,考察分布式系统里可能出错的种种事情。我们将讨论网络问题(“不可靠的网络”),以及时钟和时序问题(“不可靠的时钟”)。这些问题造成的后果往往令人迷失方向,因此我们还要探讨如何认识分布式系统的状态,以及如何推断已经发生过的事情(“知识、真相和谎言”)。随后在 第 10 章 中,我们将通过一些例子看看,面对这些故障时如何实现容错。
故障与部分失效
当你在一台计算机上编写程序时,它通常会以相当可预测的方式运行:要么正常工作,要么彻底罢工。有缺陷的软件可能会让人觉得计算机偶尔也会“状态不好”(而重启往往能解决问题),但这通常只是软件写得糟糕所造成的表象。
从根本上说,单台计算机上的软件不应该时灵时不灵:只要硬件正常,同样的操作总会产生同样的结果(也就是 确定性的,deterministic)。如果硬件出了问题(例如内存损坏或连接器松动),后果通常是整个系统失效(例如内核恐慌、“蓝屏死机”或无法启动)。一台运行着良好软件的计算机,通常要么功能完好,要么完全失效,而不会停留在两者之间。
这是计算机设计中的有意选择:发生内部故障时,我们宁愿让计算机彻底崩溃,也不愿让它返回错误结果,因为后者既难处理又容易造成混乱。于是,计算机把其底层模糊而混乱的物理现实隐藏起来,呈现出一个以数学般的完美方式运行的理想化系统模型。CPU 指令每次都会做同样的事情;写入内存或磁盘的数据会原样保留,不会随机损坏。正如 “硬件与软件故障” 中所讨论的,事实并非真的如此——现实中,数据的确可能在没有任何警告的情况下损坏,CPU 偶尔也会悄无声息地给出错误结果——只不过这些情况足够罕见,通常可以忽略。
当软件运行在通过网络连接的多台计算机上时,情况就截然不同了。分布式系统中的故障要频繁得多,我们再也无法视而不见,只能直面物理世界混乱的现实。而在物理世界中,可能出错的事情多得惊人,下面这段轶事便是一个写照 3:
在我有限的从业经历中,我处理过单个数据中心(DC)内长期存在的网络分区、PDU(配电单元)故障、交换机故障、整个机架意外断电重启、整个数据中心骨干网故障、整个数据中心停电,以及一名低血糖司机开着福特皮卡撞进数据中心的 HVAC(供暖、通风与空调)系统。而我甚至还不是运维人员。
—— 柯达黑尔
在分布式系统中,即使其他部分工作正常,系统的某些部分也很可能以不可预知的方式发生故障。这叫作 部分失效(partial failure)。棘手之处在于,部分失效是 非确定性的(nondeterministic):任何涉及多个节点及其网络的操作,有时能够成功,有时却会莫名其妙地失败。正如我们稍后会看到的,你甚至可能根本 不知道 某件事究竟成功了没有!
正是这种非确定性和部分失效的可能性,让分布式系统如此难以驾驭 4。不过,如果分布式系统能够容忍部分失效,也会由此获得强大的能力。例如,你可以执行滚动升级:每次重启一个节点来安装软件更新,同时让整个系统始终不间断地工作。因此,借助容错,我们可以用不可靠的组件构建出比单节点系统更可靠的分布式系统。
不过,在实现容错之前,我们需要进一步了解究竟要容忍哪些故障。应当考虑尽可能广泛的故障——包括那些看来不太可能发生的故障——并在测试环境中人为制造这些情形,观察系统会怎样反应。在分布式系统中,多一些怀疑、悲观和偏执总会有所回报。
不可靠的网络
正如 “共享内存、共享磁盘与无共享架构” 中所讨论的,本书关注的分布式系统大多是 无共享系统,也就是一组通过网络连接的机器。网络是这些机器彼此通信的唯一途径——我们假定每台机器都有自己的内存和磁盘,一台机器无法直接访问另一台机器的内存或磁盘,只能通过网络向服务发送请求。即使存储本身是共享的(例如 Amazon S3),机器也仍然要通过网络与共享存储服务通信。
互联网和数据中心里的大多数内部网络(通常是以太网)都是 异步分组网络(asynchronous packet network)。在这种网络中,一个节点可以向另一个节点发送消息(即数据包),但网络既不保证消息何时到达,也不保证它一定能够到达。如果你发出请求并等待响应,可能会发生许多问题(其中一些如 图 9-1 所示):
- 请求可能已经丢失(或许有人拔掉了网线)。
- 请求可能还在队列中等待,稍后才会送达(或许网络或接收方过载了)。
- 远程节点可能已经失效(或许它崩溃了,或是被关闭了)。
- 远程节点可能只是暂时停止响应(或许它正经历一次漫长的垃圾回收暂停;参见 “进程暂停”),稍后又会恢复响应。
- 远程节点可能已经处理了请求,但响应在网络中丢失了(或许某台网络交换机配置有误)。
- 远程节点可能已经处理了请求,但响应被延迟,稍后才会送达(或许网络或你自己的机器过载了)。

发送方甚至无法判断数据包是否送达:唯一的办法是由接收方发回响应消息,而这个响应同样可能丢失或延迟。在异步网络中,这些情形无法区分:你掌握的唯一信息只是“尚未收到响应”。向另一个节点发送请求却没有收到响应时,不可能 判断原因究竟是什么。
处理这个问题的惯常办法是设置 超时(timeout):等待一段时间后便放弃,并假定响应不会再来。然而,即使发生超时,你仍然不知道远程节点是否收到了请求(如果请求仍在某处排队,那么即便发送方已经放弃,它仍可能在稍后送达接收方)。
TCP 的局限性
网络数据包有大小上限(通常只有几千字节),但许多应用程序需要发送无法装进单个数据包的消息,例如请求和响应。这类应用程序通常使用 TCP(传输控制协议)建立一条 连接(connection),把较大的数据流拆成一个个数据包,再在接收端重新组装起来。
下面关于 TCP 的大部分讨论,也适用于较新的替代方案 QUIC、WebRTC 使用的流控制传输协议(SCTP)、BitTorrent 的 uTP 协议,以及其他传输协议。关于它与 UDP 的比较,参见 “TCP 与 UDP”。
TCP 常被说成能提供“可靠”的传输,这里的“可靠”是指:它能检测并重传丢失的数据包,发现顺序错乱的数据包并将其恢复为正确顺序,还能用简单的校验和检测数据包损坏。TCP 也会判断应当以多快的速度发送数据,既尽可能快速传输,又不至于压垮网络或接收节点;这叫作 拥塞控制(congestion control)、流量控制(flow control)或 背压(backpressure)5。
当你把数据写入套接字来“发送”时,数据其实不会立即发出,只会先进入操作系统管理的缓冲区。拥塞控制算法判断目前有能力发送数据包后,才会从缓冲区取出一个数据包大小的数据,交给网络接口。数据包会经过若干交换机和路由器,最终由接收节点的操作系统把数据放进接收缓冲区,并向发送方发回确认包。直到这时,接收端操作系统才会通知应用程序又有数据到达 6。
既然 TCP 提供了“可靠性”,是不是就不必再操心网络不可靠了?遗憾的是,并非如此。如果在一定的超时时间内没有收到确认,TCP 会认定数据包必定已经丢失,但它同样无法判断丢掉的究竟是发出的数据包,还是返回的确认包。TCP 虽然可以重发,却不能保证重发的数据包一定能够到达。如果网线被拔了,TCP 可没法替你把它插回去。最终,经过可配置的超时时间后,TCP 会放弃重试,并向应用程序报告错误。
如果 TCP 连接因错误而关闭——或许是远程节点崩溃了,也可能是网络中断了——你无法知道远程节点究竟处理了多少数据 6。即使 TCP 已经确认某个数据包送达,也只说明远程节点的操作系统内核收到了它;应用程序仍可能在处理这份数据之前就崩溃。如果要确认请求成功,必须由应用程序本身明确返回成功响应 7。
尽管如此,TCP 依然非常有用,因为它让我们能够方便地收发无法装进单个数据包的消息。建立 TCP 连接后,还可以通过同一条连接发送多个请求和响应。通常的做法是先发送一个头部,注明紧随其后的消息有多少字节,再发送消息本身。HTTP 和许多 RPC 协议(参见 “流经服务的数据流:REST 与 RPC”)都是这样工作的。
实践中的网络故障
我们建设计算机网络已有几十年,按说早该找到让网络可靠的办法了。遗憾的是,我们至今仍未成功。系统性研究与大量轶事证据都表明,即使在由一家公司运营的数据中心这类受控环境中,网络问题也可能频繁得出人意料 8:
- 一项针对中型数据中心的研究发现,每月大约会发生 12 次网络故障,其中一半会断开一台机器,另一半则会断开整个机架 9。
- 另一项研究测量了架顶交换机、汇聚交换机和负载均衡器等组件的失效率 10。研究发现,增加冗余网络设备并不能像预想的那样大幅减少故障,因为它防不住人为错误(例如交换机配置错误),而人为错误正是停机的一大主因。
- 广域光纤链路的中断曾被归咎于奶牛 11、海狸 12 和鲨鱼 13(不过随着海底电缆的防护改善,鲨鱼咬坏电缆的事件已经越来越少 14)。当然,人类也难辞其咎:误配置 15、盗割电缆 16 和蓄意破坏 17 都曾造成事故。
- 在不同云区域之间的通信中,高百分位数的往返时间最长可达数 分钟 18。即使在同一个数据中心内,交换机软件升级出现问题并触发网络拓扑重配置时,数据包也可能延迟一分钟以上 19。因此,我们必须假定消息可能遭到任意长时间的延迟。
- 有时通信只会部分中断,能否连通取决于通信双方是谁。例如,A 与 B 可以通信,B 与 C 也可以通信,但 A 与 C 却无法通信 20 21。还有些故障更出人意料,比如某个网络接口有时会丢弃所有入站数据包,却仍能正常发出数据包 22:网络链路在一个方向上可用,并不保证反方向也可用。
- 即使网络中断只持续了很短时间,其后续影响也可能远远长于最初的问题 8 20 23。
当网络的一部分因网络故障而与其余部分隔绝时,这种情况有时称为 网络分区(network partition)或 网络分裂(netsplit),但它与其他类型的网络中断并没有本质区别。网络分区与存储系统的分片无关,后者有时也称为 分区(参见 第 7 章)。
即使你的环境很少遇到网络故障,故障 有可能 发生这一事实也意味着软件必须能够处理它。只要通过网络通信,就有可能失败——这一点无可回避。
如果没有明确定义并测试网络故障的处理方式,后果可能糟到没有下限。例如,即使网络已经恢复,集群仍可能陷入死锁,从此无法再处理请求 24;甚至还可能删掉你的全部数据 25。一旦软件落入设计者未曾预料的情形,它就可能做出任何出人意料的事情。
处理网络故障不一定意味着要 容忍 它。如果网络通常相当可靠,那么在发生网络问题时直接向用户显示错误消息,也可以是一种合理策略。不过,你必须知道软件会如何应对网络问题,并确保系统能够从中恢复。可以考虑有意触发网络问题,测试系统会如何反应(这叫作 故障注入,fault injection;参见 “故障注入”)。
故障检测
许多系统需要自动检测发生故障的节点。例如:
- 负载均衡器需要停止向已经宕机的节点发送请求(也就是把它 移出轮询池)。
- 在采用单主复制的分布式数据库中,如果领导者失效,就需要把某个追随者提升为新的领导者(参见 “处理节点故障”)。
遗憾的是,网络的不确定性让人很难判断节点是否仍在工作。在某些特定情况下,你也许能收到明确表明某处出了问题的反馈:
- 如果运行节点的机器可以访问,但目标端口没有进程监听(例如进程已经崩溃),操作系统会返回
RST或FIN数据包,从而关闭或拒绝 TCP 连接。 - 如果节点进程崩溃(或被管理员终止),但节点的操作系统仍在运行,可以由脚本把崩溃消息通知其他节点,让另一个节点不必等待超时便能迅速接管。例如,HBase 就采用这种方式 26。
- 如果你能访问数据中心里网络交换机的管理接口,就可以查询交换机,在硬件层面检测链路故障(例如远程机器是否已经断电)。但如果你通过互联网连接、身处无法访问交换机本身的共享数据中心,或是网络问题使管理接口也无法访问,这种办法就行不通了。
- 如果路由器确信你要连接的 IP 地址不可达,它可能会返回一个 ICMP“目标不可达”数据包。不过,路由器也没有什么神奇的故障检测能力——它同样受到网络中其他参与者所面对的那些限制。
能够迅速得知远程节点宕机固然有用,但不能指望总有这样的反馈。发生问题时,你或许会从协议栈的某一层收到错误响应,但通常必须假定自己什么响应也收不到。你可以重试几次,等待超时;如果超时时间内一直没有回复,最终便宣告该节点已经死亡。
超时和无界延迟
如果超时是检测故障的唯一可靠方法,那么超时时间应该设为多长?遗憾的是,这个问题没有简单答案。
较长的超时意味着要等很久才能宣告节点死亡(在此期间,用户可能只能等待,或不断看到错误消息)。较短的超时可以更快发现故障,却更容易把只是暂时变慢的节点(例如节点或网络出现负载峰值)误判为死亡。
过早宣告节点死亡会带来麻烦:如果节点其实仍然活着,并且正在执行某个操作(例如发送电子邮件),此时另一个节点又接管了它的工作,同一个操作最终可能执行两次。我们将在 “知识、真相和谎言”、第 10 章 以及 “数据库的端到端原则” 中更详细地讨论这个问题。
宣告节点死亡后,它承担的职责就要转移给其他节点,这会额外增加其他节点和网络的负担。如果系统本来就在高负载下勉力支撑,过早宣告节点死亡可能让局面进一步恶化。尤其可能出现这样的情况:节点其实没有死,只是过载导致响应缓慢;把它的负载转移给其他节点,又可能引发级联失效(极端情况下,所有节点互相宣告对方死亡,整个系统彻底停止工作——参见 “当过载系统无法恢复时”)。
设想一个虚构的系统,其网络保证数据包的最大延迟:每个数据包要么在时间 d 以内送达,要么丢失,绝不会在超过 d 之后才送达。再假定我们能够保证,任何尚未失效的节点总会在时间 r 以内处理完请求。在这种情况下,每个成功的请求都能保证在 2 d + r 以内收到响应;如果过了这么久仍未收到响应,就可以断定网络或远程节点没有正常工作。假如这些保证真的成立,那么 2 d + r 就是合理的超时时间。
遗憾的是,我们使用的大多数系统都不具备上述任何一项保证:异步网络具有 无界延迟(unbounded delay;也就是说,它会尽快尝试送达数据包,但数据包所需的传输时间没有上限),大多数服务器实现也不能保证一定在某个最长时间内处理完请求(参见 “响应时间保证”)。对故障检测而言,系统仅仅在大多数时候运行得很快还不够:如果超时时间设得很短,一次短暂的往返时间尖峰就足以打乱整个系统。
网络拥塞与排队
开车出行时,交通拥堵往往是造成行程时间波动的最大因素。同样,在计算机网络上,数据包延迟的变化通常也是排队造成的 27:
- 如果多个节点同时向同一个目的地发送数据包,网络交换机就必须让这些数据包排队,再逐一送入通往目的地的网络链路(如 图 9-2 所示)。网络链路繁忙时,数据包可能需要等待一段时间才能获得发送机会,这叫作 网络拥塞(network congestion)。如果流入的数据太多,交换机队列被塞满,数据包就会被丢弃,因而必须重发——即使网络本身仍在正常工作。
- 数据包抵达目标机器时,如果所有 CPU 核心都在忙,操作系统会把来自网络的请求放进队列,直到应用程序有能力处理为止。等待时间取决于机器的负载,可能任意之长 28。
- 在虚拟化环境中,当另一台虚拟机占用某个 CPU 核心时,正在运行的操作系统常常会暂停数十毫秒。在此期间,虚拟机无法消费任何网络数据,因此虚拟机监控器会将流入的数据排队(缓冲)29,进一步增大网络延迟的波动。
- 如前所述,为避免网络过载,TCP 会限制数据的发送速率。这意味着数据甚至还没进入网络,就已经在发送方额外排了一次队。

此外,当 TCP 检测到数据包丢失并自动重传时,应用程序虽然不会直接看到丢包,却会感受到由此造成的延迟:先等待超时,再等待重传的数据包得到确认。
一些对延迟敏感的应用程序(例如视频会议和 IP 语音,即 VoIP)使用 UDP 而非 TCP。这是在可靠性与延迟波动之间做出的权衡:UDP 不进行流量控制,也不重传丢失的数据包,因而避开了网络延迟发生波动的部分原因(不过,它仍会受到交换机排队和调度延迟的影响)。
如果数据一旦延迟就不再有价值,UDP 是很好的选择。例如在 VoIP 通话中,等到音频该从扬声器播放时,通常已经来不及重传丢失的数据包。这种情况下,重传毫无意义——应用程序只能用静音填补丢失数据包对应的时间片(听起来就是声音短暂中断),然后继续播放后面的音频。真正的重试发生在人这一层。(“能再说一遍吗?刚才声音断了一下。”)
上述因素都会造成网络延迟的波动。当系统接近最大容量时,排队延迟的变化范围尤其大:拥有充足余量的系统可以轻松排空队列,而利用率很高的系统则可能迅速积起长队。
在公共云和多租户数据中心中,许多客户共享同一批资源:网络链路和交换机是共享的,甚至每台机器的网络接口和 CPU(使用虚拟机时)也是共享的。处理大量数据时,可能耗尽网络链路的全部容量,使其达到 饱和(saturation)。你既无法控制,也无法了解其他客户如何使用共享资源;如果附近某个 吵闹的邻居(noisy neighbor)正在大量消耗资源,网络延迟就可能剧烈波动 30 31。
在这样的环境中,只能通过实验来选择超时时间:长期测量大量机器之间网络往返时间的分布,确定延迟通常会有多大波动。然后结合应用程序自身的特点,在故障检测的延迟与过早超时的风险之间做出适当权衡。
更好的办法是不用固定配置的超时时间,而让系统持续测量响应时间及其波动(抖动,jitter),再根据观测到的响应时间分布自动调整超时。Phi 累积故障检测器 32 就采用了这种方法,Akka 和 Cassandra 等系统都在使用它 33。TCP 的重传超时也以类似方式工作 5。
同步网络与异步网络
如果可以指望网络在某个固定的最长延迟内送达数据包,而且绝不丢包,分布式系统就会简单得多。为什么不能在硬件层面解决这个问题,让网络变得可靠,从而使软件不必再操心呢?
要回答这个问题,不妨把数据中心网络与传统的固定电话网络(非蜂窝网络,也非 VoIP)比较一下。传统电话网络极其可靠:音频帧延迟和通话中断都很罕见。电话通话需要持续保持较低的端到端延迟,并提供足够带宽来传输语音采样。如果计算机网络也能具备类似的可靠性与可预测性,岂不是很好?
通过电话网络拨号时,网络会建立一条 电路(circuit):从一名通话者到另一名通话者的整条路径上,都会为这次通话分配固定且有保证的带宽。这条电路会一直保留到通话结束 34。例如,ISDN 网络以每秒 4,000 帧的固定速率运行。建立通话时,每一帧都会在两个方向上各分配 16 位空间。因此在整个通话期间,双方都能保证每 250 微秒恰好发送 16 位音频数据 35。
这类网络是 同步的(synchronous):即使数据要经过多台路由器,也不会排队,因为每一跳都已经为这次通话预留了 16 位的空间。由于无需排队,网络的最大端到端延迟是固定的。我们称之为 有界延迟(bounded delay)。
我们不能简单地让网络延迟可预测吗?
注意,电话网络中的电路与 TCP 连接截然不同:电路会预留固定数量的带宽,只要电路存在,其他人就无法使用这部分带宽;TCP 连接的数据包则会伺机利用当时可用的任意网络带宽。你可以交给 TCP 一块大小不定的数据(例如电子邮件或网页),它会尽力在最短时间内传输完毕。TCP 连接空闲时不会占用带宽,偶尔发送的保活包除外。
如果数据中心网络和互联网采用电路交换,那么建立电路时就可以同时确定有保证的最大往返时间。但它们并非如此:以太网和 IP 都是分组交换协议,数据包会排队,因而网络延迟没有上界。这些协议中根本没有“电路”的概念。
为什么数据中心网络和互联网要使用分组交换?因为它们针对 突发流量(bursty traffic)做了优化。音频或视频通话在整个通话期间每秒传输的位数相当稳定,很适合使用电路。相比之下,请求网页、发送电子邮件或传输文件并没有特定的带宽要求——我们只希望它们尽快完成。
如果要通过电路传输文件,就必须先猜测应当分配多少带宽。猜得太低,传输速度会慢得毫无必要,同时还有网络容量闲置;猜得太高,电路又无法建立,因为网络不能为无法保证带宽分配的电路放行。因此,用电路传输突发数据既浪费网络容量,又使传输无谓地变慢。TCP 则不同,它会根据可用的网络容量动态调整数据传输速率。
人们也曾尝试构建兼具电路交换与分组交换的混合网络。异步传输模式(Asynchronous Transfer Mode,ATM)在 20 世纪 80 年代曾与以太网竞争,但除了电话网络的核心交换机外,并未得到广泛采用。InfiniBand 与之有些相似 36:它在链路层实现端到端流量控制,减少了网络排队的必要,不过链路拥塞仍可能带来延迟 37。如果谨慎运用 服务质量(quality of service,QoS,即数据包的优先级与调度)和 准入控制(admission control,即对发送方限速),就可以在分组网络上模拟电路交换,或提供统计意义上的有界延迟 27 34。低延迟、低损耗和可伸缩吞吐量(L4S)等新型网络算法,试图从客户端和路由器两端缓解部分排队与拥塞控制问题。Linux 的流量控制器(TC)也允许应用程序为实现 QoS 而重新安排数据包的优先级。
更一般地说,可以把延迟的波动看作动态划分资源的结果。
假设两台电话交换机之间有一条线路,最多可以承载 10,000 路并发通话。经这条线路交换的每条电路都会占用一个通话槽位。因此,可以把这条线路看作一项最多由 10,000 名并发用户共享的资源。资源以 静态 方式划分:即使现在整条线路上只有你这一通电话,另外 9,999 个槽位全部空闲,你的电路得到的仍然只是那份固定带宽,与线路满载时一模一样。
相比之下,互联网以 动态 方式共享网络带宽。发送方彼此争抢,都想尽快把自己的数据包送上线路;网络交换机则随时决定接下来发送哪个数据包,也就是如何分配带宽。这种方法的缺点是会造成排队,优点则是能最大限度地利用线路。线路的成本是固定的,利用率越高,经由它发送的每个字节就越便宜。
CPU 也有类似的情况:如果多个线程动态共享一个 CPU 核心,那么当另一个线程正在运行时,某个线程有时就必须在操作系统的运行队列中等待,因而可能暂停长短不一的时间 38。不过,与给每个线程静态分配固定数量的 CPU 周期相比,这样做能更充分地利用硬件(参见 “响应时间保证”)。为了提高硬件利用率,云平台也会在同一台物理机器上运行来自不同客户的多台虚拟机。
在某些环境中,只要静态划分资源(例如采用专用硬件并分配独占带宽),就能提供延迟保证。但代价是资源利用率降低——换句话说,也就是成本更高。动态划分资源的多租户模式利用率更好,因此更便宜,代价则是延迟会发生波动。
网络延迟会发生波动并非自然法则,只是成本与收益权衡的结果。
不过,多租户数据中心、公共云以及经由互联网的通信,目前都没有启用这样的服务质量机制。现有部署技术无法让我们对网络的延迟或可靠性作出任何保证:必须假定网络拥塞、排队和无界延迟都会发生。因此,超时时间没有所谓“正确”的取值,只能通过实验来确定。
互联网服务提供商之间的对等互联协议,以及通过边界网关协议(BGP)建立路由的方式,比 IP 本身更像电路交换。在这个层面上,确实可以买到专用带宽。不过,互联网路由工作在网络层面,而不是主机之间的单条连接层面,其时间尺度也长得多。
不可靠的时钟
时钟和时间都很重要。应用程序会以各种方式依赖时钟,回答下面这些问题:
- 这个请求已经超时了吗?
- 这项服务响应时间的第 99 百分位数是多少?
- 过去五分钟里,这项服务平均每秒处理多少次查询?
- 用户在我们的网站上停留了多长时间?
- 这篇文章是什么时候发布的?
- 提醒邮件应该在哪一天、什么时间发出?
- 这个缓存条目什么时候过期?
- 日志文件里这条错误消息的时间戳是什么?
问题 1~4 测量的是 持续时间(duration;例如从发送请求到收到响应之间的时间间隔),问题 5~8 描述的则是 时间点(point in time;在某个具体日期和时刻发生的事件)。
在分布式系统中,时间是个棘手的问题,因为通信并非瞬间完成:消息从一台机器经网络传到另一台机器需要时间。收到消息的时刻必然晚于发出消息的时刻,但由于网络延迟会发生变化,我们不知道究竟晚了多少。涉及多台机器时,这一事实有时会让事件的先后顺序难以确定。
此外,网络中的每台机器都有自己的时钟,而且它是实实在在的硬件设备,通常是石英晶体振荡器。这些设备并不十分精确,因此每台机器都各有一套时间观念,可能比其他机器走得稍快或稍慢。时钟可以在一定程度上同步:最常用的机制是网络时间协议(NTP),它根据一组服务器报告的时间来校准计算机时钟 39;这些服务器又从 GPS 接收器等更精确的时间源取得时间。
单调时钟与日历时钟
现代计算机至少配有两种不同的时钟:日历时钟(time-of-day clock)和 单调时钟(monotonic clock)。它们虽然都用来度量时间,却服务于不同目的,因此必须加以区分。
日历时钟
日历时钟所做的,正是人们直觉上认为时钟应该做的事:按照某种历法返回当前日期和时间(也称为 墙上时钟时间,wall-clock time)。例如,Linux 的 clock_gettime(CLOCK_REALTIME) 和 Java 的 System.currentTimeMillis() 返回从 纪元(epoch)至今经过的秒数(或毫秒数):这里的纪元是格里高利历中的 1970 年 1 月 1 日 UTC 零时,且不计闰秒。有些系统使用其他日期作为参考点。(Linux 虽然把这个时钟称为 实时 时钟,但它与实时操作系统毫无关系,参见 “响应时间保证”。)
日历时钟通常会与 NTP 同步,因此理想情况下,一台机器上的某个时间戳与另一台机器上的同一时间戳表示同一时刻。不过,日历时钟也有各种怪异之处,下一节将进一步说明。尤其是当本地时钟比 NTP 服务器快得太多时,它可能会被强制重置,看起来就像突然跳回了过去。这样的跳变,以及闰秒造成的类似跳变,使日历时钟不适合测量已经过去了多长时间 40。
夏令时(DST)开始或结束时,日历时钟也可能跳变;只要始终采用没有夏令时的 UTC 时区,就能避开这类跳变。历史上,日历时钟的分辨率也相当粗糙,例如旧版 Windows 系统的时钟每次会向前跳 10 毫秒 41。在较新的系统上,这已经不是什么大问题。
单调时钟
单调时钟适合测量持续时间(时间间隔),例如超时时间或服务响应时间。Linux 的 clock_gettime(CLOCK_MONOTONIC)、clock_gettime(CLOCK_BOOTTIME) 42 和 Java 的 System.nanoTime() 都属于单调时钟。之所以叫“单调”,是因为它保证只会向前走(日历时钟却可能突然跳回过去)。
你可以先读取一次单调时钟,做些事情,稍后再读一次。两次读数之 差 就是其间经过的时间——它更像秒表,而不是挂钟。不过,单调时钟的 绝对 读数没有任何意义:它可能表示计算机启动至今的纳秒数,也可能采用其他任意起点。尤其不能比较两台不同计算机的单调时钟读数,因为它们表示的并不是同一回事。
在有多个 CPU 插槽的服务器上,每颗 CPU 都可能有自己的计时器,而且未必与其他 CPU 同步 43。操作系统会补偿其中的差异,尽力让应用程序线程看到单调递增的时钟,即使线程在不同 CPU 之间调度也是如此。不过,对这样的单调性保证最好还是有所保留 44。
如果 NTP 发现计算机的本地石英钟比 NTP 服务器走得更快或更慢,可以调节单调时钟向前推进的速率,这叫作对时钟进行 渐进校准(slewing)。默认情况下,NTP 最多可以把时钟速率加快或减慢 0.05%,但不能让单调时钟突然向前或向后跳变。单调时钟通常有很好的分辨率:在大多数系统上,它能测量微秒级甚至更短的时间间隔。
在分布式系统中,用单调时钟测量经过的时间(例如超时)通常没有问题,因为这不要求不同节点的时钟彼此同步,而且测量中的轻微误差也不会造成太大影响。
时钟同步和准确性
单调时钟不需要同步,但日历时钟只有根据 NTP 服务器或其他外部时间源进行校准才有用。遗憾的是,让时钟显示正确时间的手段远没有想象中那么可靠和准确——硬件时钟与 NTP 都可能反复无常。下面只是其中几个例子:
- 计算机里的石英钟并不十分精确,它会发生 漂移(走得比应有速度更快或更慢),而漂移程度又会随机器温度变化。Google 假定其服务器的时钟漂移最高可达 200 ppm(百万分之二百)45。这相当于每隔 30 秒与服务器重新同步一次的时钟会漂移 6 毫秒,而每天才同步一次的时钟会漂移 17 秒。即使其他一切都正常,时钟漂移也会限制所能达到的最佳精度。
- 如果计算机时钟与 NTP 服务器相差太大,它可能拒绝同步,也可能强制重置本地时钟 39。在重置前后观察时间的应用程序,可能会看到时间向后倒退,或突然向前跳跃。
- 如果防火墙意外阻断了节点与 NTP 服务器的通信,这项错误配置可能很长时间都无人察觉;在此期间,漂移不断累积,不同节点的时钟最终可能相差甚远。轶事证据表明,实践中确实发生过这种情况。
- NTP 同步的准确性不可能优于网络延迟。因此,在数据包延迟波动不定的拥塞网络上,它的准确性必然有限。一项实验表明,经由互联网同步所能达到的最小误差为 35 毫秒 46,而网络延迟偶尔出现尖峰时,误差会达到一秒左右。具体取决于配置,过大的网络延迟甚至可能让 NTP 客户端彻底放弃同步。
- 有些 NTP 服务器本身不正确或配置有误,报告的时间能相差数小时 47 48。NTP 客户端会查询多台服务器并忽略离群值,以减轻这类错误的影响。即便如此,把系统的正确性押在某个互联网陌生人报给你的时间上,多少还是令人不安。
- 闰秒会让一分钟变成 59 秒或 61 秒,从而打乱那些设计时未考虑闰秒的系统对时序所作的假设 49。闰秒已经导致许多大型系统崩溃 40 50,足见关于时钟的错误假设有多么容易悄然混入系统。处理闰秒的最佳办法,或许是让 NTP 服务器“撒谎”:把闰秒调整分摊到一整天内逐渐完成,这称为 平滑处理(smearing)51 52;不过实践中各 NTP 服务器的实际行为并不一致 53。好在从 2035 年起将不再使用闰秒,这个问题也会随之消失。
- 在虚拟机中,硬件时钟也是虚拟化的,这给需要精确计时的应用程序带来了额外挑战 54。多个虚拟机共享 CPU 核心时,一台虚拟机运行,其他虚拟机就可能暂停数十毫秒。从应用程序的视角看,这种暂停表现为时钟突然向前跳跃 29。如果虚拟机暂停了几秒,其时钟随后可能比实际时间慢几秒,但 NTP 仍可能报告时钟几乎完全同步 55。
- 如果软件运行在你无法完全控制的设备上(例如移动设备或嵌入式设备),那么设备的硬件时钟可能根本不值得信任。有些用户会故意把硬件时钟设置成错误的日期和时间,例如借此在游戏中作弊 56。因此,时钟可能被设到离谱的过去或未来。
只要足够重视时钟精度,并愿意投入大量资源,的确可以做到非常精确。例如,欧洲针对金融机构的 MiFID II 法规要求所有高频交易基金把时钟与 UTC 的误差控制在 100 微秒以内,以便排查“闪崩”等市场异常,并帮助发现市场操纵 57。
借助专用硬件(GPS 接收器和/或原子钟)、精确时间协议(PTP),再辅以审慎的部署与监控,就能达到这样的精度 58 59。不过,只依赖 GPS 也有风险,因为 GPS 信号很容易受到干扰;某些地方(例如军事设施附近)甚至经常发生这种情况 60。一些云服务商已经开始为虚拟机提供高精度时钟同步 61。即便如此,时钟同步仍需格外小心。如果 NTP 守护进程配置有误,或防火墙阻断了 NTP 流量,漂移造成的时钟误差很快就会变得很大。
对同步时钟的依赖
时钟的问题在于,它看似简单易用,陷阱却多得惊人:一天未必恰好有 86,400 秒,日历时钟可能倒着走,一个节点所认为的时间也可能与另一个节点相差很大。
本章前面讨论过网络丢包和任意延迟数据包的问题。尽管网络在绝大多数时候表现良好,设计软件时仍必须假定网络偶尔会发生故障,并妥善处理这些故障。时钟也是如此:它们大多数时候都走得好好的,但健壮的软件必须做好应对错误时钟的准备。
部分问题在于,错误的时钟很容易无人察觉。如果机器的 CPU 有缺陷,或网络配置有误,它多半会彻底无法工作,因此问题很快就会暴露并得到修复。反之,如果石英钟有缺陷,或 NTP 客户端配置有误,那么即使时钟逐渐偏离现实越来越远,大多数事情看上去仍然运行正常。如果某段软件依赖精确同步的时钟,最终结果更可能是隐蔽而细微的数据丢失,而不是一场惊天动地的崩溃 62 63。
因此,如果使用的软件要求时钟同步,就必须仔细监控所有机器之间的时钟偏差。凡是时钟与其他节点偏离太远的节点,都应当被宣告死亡并移出集群。这样的监控可以确保在故障时钟造成太大破坏以前及时发现它。
用于事件排序的时间戳
下面来看一种很容易让人想依赖时钟、却十分危险的情形:为多个节点上的事件排序 64。例如,两个客户端都向分布式数据库写入时,谁先到达?哪次写入更新?
图 9-3 展示了在采用多主复制的数据库中,日历时钟的一种危险用法(这个例子与 图 6-8 类似)。客户端 A 在节点 1 上写入 x = 1;这次写入复制到节点 3;客户端 B 在节点 3 上将 x 递增(此时 x = 2);最后,两次写入都复制到节点 2。

在 图 9-3 中,写入复制到其他节点时,会按照写入起源节点的日历时钟附上时间戳。这个例子中的时钟同步已经非常好:节点 1 与节点 3 的偏差不到 3 毫秒,实践中恐怕很难达到这么好的水平。
递增操作建立在先前写入的 x = 1 之上,因此我们自然会认为 x = 2 这次写入应该具有更大的时间戳。遗憾的是,图 9-3 中并非如此:写入 x = 1 的时间戳是 42.004 秒,写入 x = 2 的时间戳却是 42.003 秒。
正如 “最后写入者胜(丢弃并发写入)” 所讨论的,解决不同节点并发写入值之间冲突的一种办法是 最后写入者胜(LWW):对于同一个键,只保留时间戳最大的写入,丢弃所有时间戳更早的写入。在 图 9-3 的例子中,节点 2 收到这两个事件后,会错误地断定 x = 1 才是更新的值,并丢弃对 x = 2 的写入,于是递增操作便丢失了。
要避免这个问题,可以确保每当覆盖一个值时,新值的时间戳一定高于被覆盖值,即使这个时间戳已经超前于写入者的本地时钟。不过,这样就要付出额外读取的代价,先找出当前最大的时间戳。Cassandra 和 ScyllaDB 等系统希望在一次往返中写入所有副本,因此它们直接使用客户端时钟生成的时间戳,并采用最后写入者胜策略 62。这种做法存在一些严重问题:
- 数据库写入可能莫名其妙地消失:在走得较慢的节点追上走得较快的节点之前,它无法覆盖后者先前写入的值 63 65。这样可能在不向应用程序报告任何错误的情况下,悄无声息地丢弃任意数量的数据。
- LWW 无法区分短时间内接连发生的顺序写入(在 图 9-3 中,客户端 B 的递增操作显然发生在客户端 A 的写入 之后)与真正的并发写入(两个写入者都不知道对方的写入)。为了避免违反因果关系,还需要版本向量等额外的因果关系追踪机制(参见 “检测并发写入”)。
- 两个节点可能各自独立生成具有相同时间戳的写入,特别是时钟分辨率只有毫秒时。解决这类冲突还需要一个额外的决胜值(简单地取一个很大的随机数即可),但这种做法同样可能违反因果关系 62。
因此,尽管保留最“新”的值并丢弃其他值,看上去是很诱人的冲突解决办法,但必须意识到,“新”的定义取决于本地日历时钟,而它很可能并不准确。即使时钟经过严密的 NTP 同步,也可能出现这样的情况:数据包在时间戳 100 毫秒时发出(按发送方的时钟),却在时间戳 99 毫秒时到达(按接收方的时钟)——看起来仿佛数据包还没发出就已经到达,这当然不可能。
能否把 NTP 同步做得足够精确,从而彻底避免这类错误排序?恐怕不能。除了石英钟漂移等其他误差源以外,NTP 的同步精度本身就受网络往返时间限制。若要保证顺序正确,时钟误差必须显著小于网络延迟,而这是不可能做到的。
所谓的 逻辑时钟(logical clock)66 以递增计数器为基础,而不是以振荡的石英晶体为基础,因此是为事件排序时更安全的选择(参见 “检测并发写入”)。逻辑时钟既不度量一天中的时刻,也不度量经过了多少秒,只记录事件之间的相对顺序(一个事件发生在另一个事件之前还是之后)。与之相对,日历时钟和单调时钟度量真实流逝的时间,因此也称为 物理时钟(physical clock)。我们将在 “ID 生成器和逻辑时钟” 中更详细地讨论逻辑时钟。
带置信区间的时钟读数
机器的日历时钟也许能以微秒甚至纳秒为分辨率提供读数,但测量得如此精细,并不表示读数真的精确到了这个程度。事实上,它大概率没有这么准。前面说过,即使每分钟都与局域网中的 NTP 服务器同步一次,不精确的石英钟也很容易漂移数毫秒。若使用公共互联网上的 NTP 服务器,最理想的精度大概也只有数十毫秒;遇到网络拥塞时,误差很容易飙升到 100 毫秒以上。
因此,不应把一次时钟读数理解为一个精确的时间点,它更像是落在某个置信区间内的一段时间范围。例如,系统也许有 95% 的把握认为当前时刻位于这一分钟的第 10.3 秒至第 10.5 秒之间,但无法知道得更精确 67。如果时间只能确定到 ±100 毫秒,那么时间戳中精确到微秒的那些数字基本毫无意义。
不确定性的边界可以根据时间源来计算。如果计算机直接连接着 GPS 接收器或原子钟,预期误差范围取决于设备本身;对 GPS 而言,还取决于卫星信号的质量。如果从服务器获取时间,不确定性大致等于:自上次与服务器同步以来石英钟的预期漂移,加上 NTP 服务器自身的不确定性,再加上与服务器之间的网络往返时间——这是第一步近似,并且假定服务器值得信任。
遗憾的是,大多数系统都不会暴露这种不确定性。例如,调用 clock_gettime() 时,返回值并不会告诉你时间戳的预期误差,因此你无从得知它的置信区间究竟是五毫秒,还是五年。
不过也有例外:Google Spanner 的 TrueTime API 45 和 Amazon 的 ClockBound 都会明确报告本地时钟的置信区间。查询当前时间时,得到的是两个值:[earliest, latest],分别表示 最早可能 与 最晚可能 的时间戳。根据对不确定性的计算,时钟能够断定真实的当前时间位于这个区间内。区间的宽度取决于多种因素,其中包括本地石英钟距离上次与更精确的时间源同步已经过去多久。
用于全局快照的同步时钟
在 “快照隔离与可重复读” 中,我们讨论了 多版本并发控制(MVCC)。对于既要支持短小快速的读写事务,又要支持大型、长时间运行的只读事务(例如备份或分析)的数据库来说,MVCC 是一项非常有用的功能。它让只读事务能够看到数据库在某个特定时间点的一致状态,也就是一个 快照,同时又不必锁住或干扰读写事务。
一般来说,MVCC 需要单调递增的事务 ID。如果某次写入发生在快照之后(也就是说,写入的事务 ID 大于快照的事务 ID),那么快照事务就看不到这次写入。在单节点数据库上,用一个简单的计数器就足以生成事务 ID。
可是,当数据库分布在许多机器上,甚至横跨多个数据中心时,生成全局单调递增的事务 ID(覆盖所有分片)就很困难,因为这需要协调。事务 ID 还必须反映因果关系:如果事务 B 读取或覆盖了事务 A 先前写入的值,B 的事务 ID 就必须大于 A,否则快照将不一致。面对大量短小快速的事务,在分布式系统中生成事务 ID 会成为难以承受的瓶颈。(我们将在 “ID 生成器和逻辑时钟” 中讨论这类 ID 生成器。)
能不能直接把同步日历时钟产生的时间戳当作事务 ID?如果时钟同步能做得足够好,时间戳的确具备所需属性:越晚的事务,时间戳越大。当然,问题依旧在于时钟精度的不确定性。
Spanner 正是以这种方式实现跨数据中心的快照隔离 68 69。它利用 TrueTime API 报告的时钟置信区间,依据的是下面这个观察:假设有两个置信区间,每个区间都由最早和最晚的可能时间戳组成(A = [A最早, A最晚],B = [B最早, B最晚]),如果两个区间不重叠(即 A最早 < A最晚 < B最早 < B最晚),那么 B 必定发生在 A 之后,不存在任何疑问。只有当两个区间发生重叠时,我们才无法确定 A 与 B 的先后顺序。
为了确保事务时间戳能够反映因果关系,Spanner 会在提交读写事务之前,刻意等待相当于置信区间长度的一段时间。这样一来,任何可能读到该数据的事务都会发生在足够晚的时刻,使它们的置信区间不再重叠。为了尽量缩短等待,Spanner 需要把时钟不确定性控制得尽可能小;为此,Google 在每个数据中心都部署了 GPS 接收器或原子钟,从而把时钟同步误差控制在大约 7 毫秒以内 45。
严格来说,Spanner 并非一定要使用原子钟和 GPS 接收器:真正重要的是获得置信区间,精确的时间源只是帮助缩小这个区间。其他系统也开始采用类似方法。例如,YugabyteDB 在 AWS 上运行时可以利用 ClockBound 70,还有若干系统也开始在不同程度上依赖时钟同步 71 72。
进程暂停
再来看一个在分布式系统中危险使用时钟的例子。假设某个数据库的每个分片都只有一个领导者,而且只有领导者可以接受写入。一个节点怎么知道自己仍是领导者(没有被其他节点宣告死亡),因而可以安全地接受写入呢?
一种办法是由领导者向其他节点取得一份 租约(lease),它类似于带有超时的锁 73。任何时刻只能有一个节点持有租约。因此,节点拿到租约后,就知道自己在租约到期以前的一段时间内仍是领导者。为保持领导者身份,节点必须在租约到期前定期续租。如果节点失效,就会停止续租;租约到期后,另一个节点便可接管。
可以想象,请求处理循环大致如下:
这段代码有什么问题?首先,它依赖同步时钟:租约到期时间由另一台机器设置(例如以当前时间加 30 秒来计算),却要与本地系统时钟比较。如果两台时钟的偏差超过几秒,这段代码的行为就会变得古怪。
其次,即使把协议改成只使用本地单调时钟,仍然存在另一个问题:代码假定读取时间(System.currentTimeMillis())与处理请求(process(request))之间只会经过极短时间。通常这段代码确实运行得很快,预留 10 秒足以确保租约不会在请求处理到一半时过期。
可是,如果程序执行时意外暂停了呢?例如,假设线程执行到 lease.isValid() 附近时停了 15 秒,随后才恢复。在处理请求时,租约很可能早已过期,另一个节点也已接任领导者。然而,没有任何东西会告诉这个线程它刚才停了那么久;直到循环进入下一轮,它才会发现租约已经过期——而在此之前,它可能已经处理了请求,做出了不安全的操作。
认为线程可能暂停这么久,是否合理?很遗憾,完全合理。造成长时间暂停的原因多种多样:
- 多个线程争用锁、队列等共享资源时,线程可能把大量时间花在等待上。换用 CPU 核心更多的机器甚至可能让这类问题进一步恶化,而且争用问题往往很难诊断 74。
- 许多编程语言运行时(例如 Java 虚拟机)都带有 垃圾回收器(GC),偶尔需要停止所有正在运行的线程。过去,这类 STW GC 暂停 有时会让程序停上几分钟 75!现代 GC 算法已经大大缓解了这个问题,但 GC 暂停仍可能相当明显(参见 “限制垃圾回收的影响”)。
- 在虚拟化环境中,虚拟机可以被 挂起(暂停所有进程并把内存内容保存到磁盘),随后再 恢复(还原内存内容并从原处继续执行)。这种暂停可能发生在进程执行的任何时刻,持续时间也没有上限。这个功能有时用于把虚拟机从一台宿主机 实时迁移 到另一台宿主机而无需重启;在这种情况下,暂停多久取决于进程写入内存的速率 76。
- 在笔记本电脑和手机等终端用户设备上,执行也可能随时挂起并恢复,例如用户合上笔记本电脑屏幕时。
- 当操作系统切换到另一个线程,或者虚拟机监控器切换到另一台虚拟机时,当前线程可能停在代码中的任意位置。对虚拟机而言,被其他虚拟机占用的 CPU 时间称为 窃取时间(steal time)。如果机器负载很高——也就是有很长的线程队列在等待运行——暂停的线程可能要过一阵子才能再次获得运行机会。
- 如果应用程序执行同步磁盘访问,线程可能暂停下来,等待缓慢的磁盘 I/O 操作完成 77。在许多语言中,即使代码没有明确读写文件,磁盘访问也可能出人意料地发生。例如,Java 类加载器会在类第一次使用时才加载类文件,而这可能出现在程序执行的任何时刻。I/O 暂停与 GC 暂停甚至可能相互叠加 78。如果所谓的磁盘其实是网络文件系统或网络块设备(例如 Amazon EBS),I/O 延迟还会受到网络延迟波动的影响 31。
- 如果操作系统允许 换页到磁盘(分页),一次简单的内存访问也可能触发缺页错误,必须从磁盘把某个页面载入内存。在这项缓慢的 I/O 操作完成以前,线程会一直暂停。如果内存压力很大,还可能需要先把另一个页面换出到磁盘。极端情况下,操作系统会把大部分时间耗在内存页面的换入换出上,几乎不做实际工作,这叫作 抖动(thrashing)。为了避免这种情况,服务器通常会禁用分页——与其冒着发生抖动的风险,不如终止一个进程来释放内存。
- 向 Unix 进程发送
SIGSTOP信号也会令其暂停,例如在 shell 中按 Ctrl-Z。这个信号会立即停止给进程分配 CPU 周期,直到SIGCONT令它恢复;随后,它会从先前停下的位置继续运行。即使你的环境通常不用SIGSTOP,运维人员也可能不小心发出这个信号。
上述任何事件都可能在任意位置 抢占 正在运行的线程,过一段时间再让它恢复,而线程对此毫无察觉。这个问题类似于保证单机多线程代码的线程安全:不能对时序作任何假定,因为上下文切换与并行执行随时都可能发生。
在单台机器上编写多线程代码时,我们有不少成熟工具来保证线程安全:互斥锁、信号量、原子计数器、无锁数据结构、阻塞队列等等。遗憾的是,这些工具不能直接套用到分布式系统,因为分布式系统没有共享内存,只有经由不可靠网络传递的消息。
分布式系统中的节点必须假定:自己的执行可能在任意时刻暂停很长时间,哪怕正处于函数执行途中。暂停期间,外部世界仍在继续运转,甚至可能因为这个节点迟迟没有响应而宣告它死亡。最终节点恢复运行时,甚至意识不到自己曾经“睡着”,直到稍后再次读取时钟。
响应时间保证
如上所述,在许多编程语言与操作系统中,线程和进程都可能暂停任意长的时间。不过,只要投入足够努力,这些暂停的原因 确实可以 消除。
有些软件运行在这样的环境中:如果不能在规定时间内响应,就可能造成严重损害。控制飞机、火箭、机器人、汽车及其他实体设备的计算机,必须快速而且可预测地响应传感器输入。在这些系统中,软件必须赶在明确规定的 截止时间(deadline)之前响应;错过截止时间,就可能导致整个系统失效。这样的系统称为 硬实时(hard real-time)系统。
在嵌入式系统中,实时 是指系统经过精心设计与测试,能够在任何情况下满足规定的时序保证。这与 Web 领域对 实时 一词较为宽泛的用法形成对比:后者通常只是指服务器向客户端推送数据或进行流处理,并没有严格的响应时间约束(参见 第 12 章)。
例如,汽车的车载传感器检测到碰撞正在发生时,你绝不会希望安全气囊因为控制系统恰好遭遇 GC 暂停而延迟弹出。
要在系统中提供实时保证,需要软件栈的每一层共同支持:需要 实时操作系统(RTOS),保证在规定的时间间隔内为进程分配 CPU 时间;库函数必须说明最坏情况下的执行时间;动态内存分配可能要受到限制,甚至完全禁止(虽然存在实时垃圾回收器,应用程序仍必须确保不会给 GC 安排太多工作);此外还要进行海量测试与测量,验证系统确实满足保证。
这些要求不仅带来大量额外工作,也严重限制了可用的编程语言、库和工具,因为大多数语言和工具都不提供实时保证。正因如此,实时系统开发极其昂贵,最常用于安全攸关的嵌入式设备。而且,“实时”并不等于“高性能”——事实上,实时系统的吞吐量可能更低,因为及时响应必须优先于一切(另见 “延迟与资源利用率”)。
对于大多数服务器端数据处理系统,实时保证既不经济,也不合适。因此,这些系统只能承受非实时环境带来的进程暂停与时钟不稳定。
限制垃圾回收的影响
垃圾回收曾是造成进程暂停的最大原因之一 79。好在 GC 算法已经有了长足进步:如今,经过适当调优的回收器通常只会暂停几毫秒。Java 运行时提供并发标记清除(CMS)、垃圾优先(G1)、Z 垃圾回收器(ZGC)、Epsilon 和 Shenandoah 等回收器,分别针对高频创建对象、大型堆等不同内存使用特征进行优化。相比之下,Go 提供的是一种更简单、尝试自我优化的并发标记清除垃圾回收器。
如果必须彻底避免 GC 暂停,可以选择完全没有垃圾回收器的语言。例如,Swift 使用自动引用计数来判断何时能够释放内存;Rust 和 Mojo 则通过类型系统追踪对象的生命周期,让编译器判断内存需要保留多久。
也可以继续使用带垃圾回收的语言,同时减轻暂停造成的影响。一种做法是把 GC 暂停看作节点短暂的计划内停机:某个节点进行垃圾回收时,由其他节点处理客户端请求。如果运行时能够提前告知应用程序节点即将进行 GC 暂停,应用程序就可以停止向该节点发送新请求,等待它处理完尚未完成的请求,然后趁没有请求进行时执行 GC。这种技巧能向客户端隐藏 GC 暂停,并降低响应时间的高百分位数 80 81。
这种思路还有一个变体:只让垃圾回收器处理容易快速回收的短命对象,并定期重启进程,赶在长期存活对象积累到需要执行一次完整 GC 之前 79 82。每次可以只重启一个节点,并在计划重启前先把流量从该节点迁走,就像滚动升级一样(参见 第 5 章)。
这些措施无法彻底杜绝垃圾回收暂停,却能切实减轻其对应用程序的影响。
知识、真相和谎言
到目前为止,本章已经考察了分布式系统与单机程序的不同之处:系统没有共享内存,只能通过延迟不定的不可靠网络来传递消息,还可能遭遇部分失效、不可靠的时钟和进程暂停。
如果还不熟悉分布式系统,这些问题带来的后果会让人极度迷失方向。网络中的一个节点不可能 确切知道 其他节点的任何事情,只能根据收到(或没有收到)的消息作出猜测。一个节点只有与另一个节点交换消息,才能得知对方处于什么状态,例如存储了哪些数据、是否正常运行等等。如果远程节点没有响应,就无从得知它的状态,因为网络问题与节点自身的问题无法可靠地区分。
关于这类系统的讨论已经近乎哲学:在系统中,我们究竟知道什么为真、什么为假?如果感知和测量的机制都不可靠,我们又能在多大程度上确信自己的认知 83?软件系统是否应当服从我们认为物理世界必然遵循的法则,例如因果律?
好在我们不必一路追问到生命的意义。在分布式系统中,可以明确写出对系统行为所作的假设(即 系统模型,system model),再把实际系统设计成符合这些假设。我们还可以证明某个算法在特定系统模型中能够正确运行。这意味着,即使底层系统模型只提供极少保证,也仍然可以实现可靠的行为。
不过,要让软件在不可靠的系统模型中表现良好,绝非轻而易举。本章余下部分将进一步探讨分布式系统中的知识与真相,帮助我们思考可以作出哪些假设,以及希望提供哪些保证。在 第 10 章 中,我们将继续考察一些分布式算法:它们在特定假设下提供特定保证。
多数派原则
设想一个存在非对称故障的网络:某个节点可以收到发给它的所有消息,但它发出的消息都会丢失或延迟 22。这个节点明明工作得完全正常,也在接收其他节点的请求,可其他节点就是听不见它的回应。等到超时后,其他节点由于一直收不到回复,便宣告它已经死亡。接下来的场面如同噩梦:这个半失联的节点被拖向墓地,一路挣扎高喊“我还没死!”——可惜谁也听不见它的呼喊,送葬队伍仍以坚忍不拔的决心继续前进。
在一个没那么噩梦般的场景中,半失联的节点也许会发现自己发出的消息得不到其他节点的确认,于是意识到网络必定出了故障。然而,其他节点仍会错误地宣告它死亡,而它对此无能为力。
第三种场景是,假设某个节点暂停执行一分钟。在此期间,它既不处理请求,也不发送响应。其他节点一边等待、一边重试,终于失去耐心,宣告它死亡并把它抬上灵车。最终暂停结束,节点的线程若无其事地继续执行。其他节点惊讶地看到,那个本应死去的节点突然精神抖擞地从棺材里探出头来,兴高采烈地与旁人聊天。刚恢复时,这个节点甚至不知道整整一分钟已经过去,也不知道自己已经被宣告死亡——在它看来,距离上次和其他节点交谈仿佛只过了一瞬间。
这些故事告诉我们,节点未必能相信自己对处境的判断。分布式系统不能只依赖某一个节点,因为节点随时可能失效,使系统陷入僵局而无法恢复。因此,许多分布式算法依赖 法定人数(quorum),也就是让多个节点投票(参见 “读写仲裁”):一项决策必须获得若干节点的最低票数,借此减少对任何单个节点的依赖。
宣告节点死亡的决定也是如此。如果达到法定人数的节点宣告另一个节点已经死亡,那么即使它觉得自己还活得好好的,也必须被视为死亡。单个节点必须服从法定人数作出的决定并下台。
最常见的法定人数,是超过节点总数一半的绝对多数,当然也可以采用其他形式。多数法定人数让系统能在少数节点发生故障时继续工作:三个节点可以容忍一个故障节点,五个节点则可以容忍两个。与此同时,它仍然是安全的,因为系统中只能形成一个多数派,不可能同时出现两个作出冲突决定的多数派。我们将在 第 10 章 讨论 共识算法 时,更详细地介绍法定人数的用法。
分布式锁和租约
分布式应用程序中的锁与租约很容易被误用,也是程序缺陷的常见来源 84。下面来看一种具体的出错方式。
在 “进程暂停” 中,我们看到租约是一种会超时的锁:如果原持有者停止响应(可能是因为它崩溃了、暂停太久,或与网络断开),租约就可以交给新的持有者。当系统要求某种东西只能有一个时,就可以使用租约。例如:
- 只允许一个节点担任数据库分片的领导者,以避免脑裂(参见 “处理节点故障”)。
- 只允许一个事务或客户端更新特定资源或对象,以免并发写入将其损坏。
- 一项大型处理作业中的每个输入文件只应由一个节点处理,避免多个节点重复执行同一份工作而白白浪费计算资源。
值得仔细想一想:如果多个节点同时相信自己持有租约——也许是进程暂停造成的——会发生什么?对第三个例子而言,后果不过是浪费一些计算资源,并不严重;但在前两个例子中,数据可能丢失或损坏,严重得多。
例如,图 9-4 展示了锁实现错误导致的数据损坏。(这并非纯粹的理论问题:HBase 曾经就有这个缺陷 85 86。)假设你想确保某个存储服务里的文件一次只能由一个客户端访问,因为多个客户端同时写入会损坏文件。于是,你要求客户端在访问文件之前,先向锁服务取得租约。这类锁服务通常用共识算法来实现,我们将在 第 10 章 中进一步讨论。

问题正是 “进程暂停” 所讨论的情形:持有租约的客户端如果暂停太久,租约就会过期。另一个客户端此时可以取得同一文件的租约,并开始写入。等暂停的客户端恢复后,它误以为自己的租约依然有效,也继续写入文件。于是便出现了脑裂:两个客户端的写入彼此冲突,最终损坏文件。
图 9-5 展示了另一个后果类似的问题。这个例子里没有进程暂停,只有客户端 1 崩溃。就在崩溃前,客户端 1 向存储服务发出了一项写请求,但请求在网络中延迟了很久。(回想 “实践中的网络故障”,数据包有时会延迟一分钟以上。)等写请求抵达存储服务时,租约早已超时,客户端 2 已经取得租约并发出了自己的写入。结果便是类似 图 9-4 的数据损坏。

用栅栏机制隔离僵尸与延迟请求
僵尸(zombie)一词有时用来形容这样的原租约持有者:它还不知道自己已经失去租约,仍把自己当作当前持有者行事。既然无法彻底杜绝僵尸,就必须确保它们不能以脑裂的形式造成任何破坏。这称为用 栅栏机制(fencing)隔离僵尸。
有些系统试图通过关停僵尸来隔离它,例如断开它的网络连接 9、通过云服务商的管理界面关闭虚拟机,甚至直接切断机器电源 87。这种做法称为 STONITH,即“击毙另一个节点”。遗憾的是,它有几个问题:无法防范 图 9-5 所示的超长网络延迟;所有节点可能彼此关停 19;而等到僵尸被发现并关闭时,也许早已为时过晚,数据已经损坏。
图 9-6 展示了一种更健壮的栅栏机制,既能防范僵尸,也能防范延迟请求。

假设锁服务每次授予锁或租约时,还会返回一个 栅栏令牌(fencing token)。这是一个每次授予锁都会增大的数字,例如由锁服务负责递增。随后可以要求客户端每次向存储服务发送写请求时,都必须带上自己当前的栅栏令牌。
在 图 9-6 中,客户端 1 取得租约及令牌 33,随后却长时间暂停,导致租约过期。客户端 2 接着取得租约及令牌 34(令牌值始终递增),并向存储服务发送带令牌 34 的写请求。稍后,客户端 1 恢复执行,也向存储服务发送写请求,其中带着自己的令牌 33。然而,存储服务记得自己已经处理过令牌值更高(34)的写入,因此会拒绝令牌 33 的请求。刚取得租约的客户端必须立刻向存储服务执行一次写入;一旦这次写入完成,所有僵尸都会被隔离在外。
如果使用 ZooKeeper 作为锁服务,可以把事务 ID zxid 或节点版本 cversion 用作栅栏令牌 85。在 etcd 中,修订号与租约 ID 共同发挥类似作用 89。Hazelcast 的 FencedLock API 则会显式生成栅栏令牌 90。
这种机制要求存储服务能够检查写入所携带的令牌是否已经过时。另一种办法是让服务支持类似原子比较并设置(CAS)的写入:只有从当前客户端上次读取对象以后,没有其他客户端写过该对象,写入才会成功。对象存储服务就支持这类检查:Amazon S3 称之为 条件写入(conditional write),Azure Blob Storage 称之为 条件标头(conditional header),Google Cloud Storage 则称之为 请求前置条件(request precondition)。
多副本隔离
如果客户端只需写入一个支持这类条件写入的存储服务,那么锁服务多少有些多余 91 92,因为完全可以直接依托该存储服务来分配租约 93。不过,有了栅栏令牌以后,也可以把它用于多个服务或副本,确保原租约持有者在所有这些服务上都被隔离。
例如,假设存储服务是一个采用最后写入者胜来解决冲突的无主复制键值存储(参见 “无主复制”)。在这样的系统中,客户端直接向每个副本发送写入,各副本根据客户端分配的时间戳,自行决定是否接受写入。
如 图 9-7 所示,可以把写入者的栅栏令牌放在时间戳最高有效的若干位或数字中。这样就能确保,新租约持有者生成的任何时间戳,都大于原租约持有者生成的所有时间戳,即使原持有者的写入实际发生得更晚。

在 图 9-7 中,客户端 2 的栅栏令牌为 34,因此它生成的所有以 34… 开头的时间戳,都大于客户端 1 生成的任何以 33… 开头的时间戳。客户端 2 成功写入达到法定人数的一组副本,但无法连接副本 3。因此,僵尸客户端 1 稍后尝试写入时,这次写入虽然会被副本 1 和 2 忽略,却可能在副本 3 上成功。这不成问题,因为后续的仲裁读会优先选择客户端 2 那个时间戳更大的写入,而读修复或反熵过程最终会覆盖客户端 1 写入的值。
从这些例子可以看出,假定任何时刻只有一个节点持有租约并不安全。所幸,只要稍加留意,就可以借助栅栏令牌防止僵尸与延迟请求造成任何破坏。
拜占庭故障
栅栏令牌能够发现并阻止 无意间 出错的节点,例如尚未发现租约已经过期的节点。但如果节点蓄意破坏系统保证,只需发送带有伪造栅栏令牌的消息,就能轻易绕过这种防护。
本书假定节点虽然不可靠,却是诚实的:它们可能因为故障而响应缓慢或永不响应,也可能因为 GC 暂停或网络延迟而持有过时状态;但我们假定,只要节点 确实 作出响应,它说的就是“真话”——至少据它自己所知,它是在遵守协议规则。
如果节点有可能“撒谎”,也就是发出任意错误或损坏的响应,分布式系统问题就会困难得多。例如,一个节点可能在同一轮选举中投出多张互相矛盾的票。这种行为叫作 拜占庭故障(Byzantine fault),而在这种互不信任的环境中达成共识的问题,则称为 拜占庭将军问题(Byzantine Generals Problem)94。
拜占庭将军问题是所谓 两将军问题(Two Generals Problem)95 的推广。两将军问题设想,两名军队将领必须就作战计划达成一致,但他们驻扎在不同地点,只能派信使互通消息,而信使有时会迟到或失踪(就像网络数据包一样)。我们将在 第 10 章 中讨论这个 共识(consensus)问题。
在拜占庭版本的问题中,需要达成一致的将军有 n 名,但其中混入了若干叛徒。大多数将军都忠诚可靠,会发送真实消息;叛徒却可能发送虚假消息,企图欺骗并迷惑其他人。而谁是叛徒,事先无从得知。
拜占庭原是古希腊的一座城市,后来成为君士坦丁堡,所在地就是今天土耳其的伊斯坦布尔。没有任何历史证据表明,拜占庭的将军比其他地方的将军更爱阴谋诡计。这个名称其实来自 拜占庭式 一词在政治语境中的含义:过度复杂、官僚而诡诈;这种用法远在计算机出现以前便已存在 96。Lamport 想选择一个不会冒犯读者的国籍,而别人劝他最好不要把问题叫作 阿尔巴尼亚将军问题 97。
如果某些节点发生故障、不遵守协议,或有恶意攻击者干扰网络时,系统仍能继续正确运行,就称这个系统具有 拜占庭容错(Byzantine fault tolerance,BFT)能力。这类问题在某些特定情形下确实很重要。例如:
- 在航空航天环境中,辐射可能破坏计算机内存或 CPU 寄存器里的数据,使节点以任意且不可预测的方式回应其他节点。系统失效的代价极其高昂——例如飞机坠毁导致机上人员全部遇难,或火箭撞上国际空间站——因此飞行控制系统必须能够容忍拜占庭故障 98 99。
- 在有多方参与的系统中,部分参与者可能企图欺骗或诈骗其他人。此时,节点不能轻信另一个节点发来的消息,因为消息可能带有恶意。比特币等加密货币及其他区块链,就可以看作一种无需依赖中央权威,让彼此不信任的各方就某笔交易是否发生达成一致的方式 100。
不过,对本书讨论的系统而言,通常可以放心假定不存在拜占庭故障。数据中心里的所有节点都受你的组织控制,因而有望值得信任;辐射水平也足够低,内存损坏并非主要问题——尽管人们已经在考虑把数据中心送入轨道 101。多租户系统中的租户彼此并不信任,但系统依靠防火墙、虚拟化和访问控制策略把租户相互隔离,而不是使用拜占庭容错。让系统实现拜占庭容错的协议代价很高 102,而具有容错能力的嵌入式系统又依赖硬件层面的支持 98。对大多数服务器端数据系统来说,部署拜占庭容错方案的成本高得并不现实。
Web 应用程序的确必须预料到,Web 浏览器等由最终用户控制的客户端可能作出任意乃至恶意的行为。这也正是输入验证、数据清理和输出转义如此重要的原因,例如它们可以防止 SQL 注入与跨站脚本攻击。不过,我们通常不会为此使用拜占庭容错协议,只需让服务器充当权威,决定哪些客户端行为可以接受、哪些不可以。在没有这种中央权威的点对点网络中,拜占庭容错才更为重要 103 104。
软件缺陷也可以看作拜占庭故障,但如果所有节点部署的都是同一套软件,拜占庭容错算法也救不了你。大多数拜占庭容错算法要求超过三分之二的节点正常运行(例如四个节点中最多只能有一个发生故障)。若想用这种办法防范软件缺陷,就得准备同一软件的四种独立实现,并寄希望于缺陷只出现在其中一种实现里。
同理,如果某种协议能保护我们免受漏洞、安全失陷和恶意攻击,当然很有吸引力。遗憾的是,这同样不现实:在大多数系统中,攻击者既然能够攻陷一个节点,多半也能攻陷所有节点,因为它们很可能运行相同的软件。因此,身份认证、访问控制、加密和防火墙等传统机制,仍然是抵御攻击者的主要手段。
弱形式的谎言
虽然我们通常假定节点是诚实的,但仍值得在软件中加入一些机制,防范较弱形式的“撒谎”,例如硬件问题、软件缺陷或配置错误产生的无效消息。这些机制算不上完整的拜占庭容错,因为它们挡不住意志坚定的攻击者;但作为提高可靠性的手段,它们既简单又务实。例如:
- 硬件问题,或操作系统、驱动程序、路由器等组件中的缺陷,确实可能损坏网络数据包。TCP 与 UDP 内置的校验和通常能够发现损坏的数据包,但偶尔也会漏检 105 106 107。一般只需一些简单措施就足以防范这类损坏,例如在应用层协议中加入校验和。TLS 加密连接也能抵御数据损坏。
- 可公开访问的应用程序必须仔细清理所有用户输入,例如检查数值是否落在合理范围内,并限制字符串长度,防止攻击者通过分配巨量内存来造成拒绝服务。防火墙后的内部服务也许可以放宽输入检查,但协议解析器仍然最好保留基本校验 105。
- NTP 客户端可以配置多个服务器地址。同步时,客户端会联系所有服务器,估算各自的误差,并检查大多数服务器是否就某个时间范围达成一致。只要大部分服务器正常,配置有误、报告错误时间的 NTP 服务器就会被识别为离群值,并排除在同步过程之外 39。与只依赖一台服务器相比,使用多台服务器能让 NTP 更加健壮。
系统模型与现实
人们已经设计了许多算法来解决分布式系统问题。例如,我们将在 第 10 章 中考察共识问题的解决方案。要真正有用,这些算法必须能够容忍本章讨论的分布式系统中的各种故障。
算法的编写方式不应过度依赖其运行环境中具体的硬件与软件配置。这又要求我们以某种方式,把系统中预期会发生的故障类型形式化。为此,我们定义 系统模型(system model):它是一种抽象,用来说明算法可以作出哪些假设。
关于时序假设,通常使用以下三种系统模型:
- 同步模型(synchronous model)
- 同步模型假定网络延迟、进程暂停和时钟误差都有上界。这并不表示时钟完全同步,也不表示网络延迟为零;它只是意味着,我们知道网络延迟、暂停和时钟漂移永远不会超过某个固定上限 108。对大多数实际系统而言,同步模型并不现实,因为正如本章所讨论的,无界延迟和暂停确实可能发生。
- 部分同步模型(partially synchronous model)
- 部分同步是指系统在 大多数时候 都像同步系统一样运行,但偶尔会突破网络延迟、进程暂停和时钟漂移的界限 108。对许多系统来说,这是一个现实的模型:绝大多数时候,网络与进程表现得相当规矩,否则我们什么事情也做不成;但我们也必须正视这样一个事实——任何时序假设都有可能偶尔失效。发生这种情况时,网络延迟、进程暂停和时钟误差都可能变得任意之大。
- 异步模型(asynchronous model)
- 在这种模型中,算法不能作出任何时序假设——事实上,它甚至没有时钟可用(因而也不能使用超时)。有些算法可以针对异步模型来设计,但这种模型限制极大。
除了时序问题,还必须考虑节点失效。常见的节点系统模型包括:
- 崩溃停止故障(crash-stop fault)
- 在 崩溃停止(crash-stop,或 故障停止,fail-stop)模型中,算法可以假定节点只有一种失效方式:崩溃 109。节点可能在任意时刻突然停止响应,此后便永远消失,再也不会回来。
- 崩溃恢复故障(crash-recovery fault)
- 我们假定节点可能在任意时刻崩溃,也可能在一段未知时间后重新开始响应。在崩溃恢复模型中,节点拥有能在崩溃后保留数据的稳定存储(即非易失性磁盘存储),但内存中的状态会丢失。
- 性能下降和功能不全
- 除了崩溃与重启,节点还可能变慢:它们也许仍能响应健康检查,却慢得无法完成任何实际工作。例如,千兆网络接口可能因为驱动程序缺陷,吞吐量突然跌到 1 Kb/s 110;面临内存压力的进程可能把大部分时间花在垃圾回收上 111;磨损的 SSD 可能表现得极不稳定;高温、连接器松动、机械振动、电源问题、固件缺陷等也会影响硬件 112。这类情形称为 跛行节点(limping node)、灰色失效(gray failure)或 慢失效(fail-slow)113,甚至可能比彻底失效的节点更难处理。还有一种相关问题:进程不再执行原本应做的某些工作,其他功能却仍在继续,例如后台线程崩溃或死锁时 114。
- 拜占庭(任意)故障
- 节点可能做出任何行为,包括像上一节所述那样欺骗其他节点。
对现实系统建模时,带崩溃恢复故障的部分同步模型通常最有用。它允许出现无界网络延迟、进程暂停和慢节点。那么,分布式算法该如何应对这种模型呢?
定义算法的正确性
要定义一个算法怎样才算 正确,可以描述它必须具备哪些 属性。例如,排序算法的输出具有这样一项属性:对输出列表中的任意两个不同元素,位于左侧的元素都小于位于右侧的元素。这不过是用形式化语言定义一份列表何谓“有序”。
同理,我们也可以列出分布式算法应具备的属性,以此定义它怎样才算正确。例如,如果算法要为锁生成栅栏令牌(参见 “用栅栏机制隔离僵尸与延迟请求”),我们可能要求它满足以下属性:
- 唯一性
- 任意两个栅栏令牌请求都不能返回相同的值。
- 单调序列
- 如果请求 x 返回令牌 t**x,请求 y 返回令牌 t**y,而且 x 在 y 开始以前已经完成,那么 t**x < t**y。
- 可用性
- 请求栅栏令牌且没有崩溃的节点,最终会收到响应。
如果算法在某个系统模型允许发生的所有情形下,始终满足这些属性,就可以说它在该系统模型中是正确的。然而,如果所有节点都崩溃,或所有网络延迟都突然变成无限长,那么任何算法都不可能完成工作。面对一个允许系统彻底失效的模型,我们怎样才能仍然给出有用的保证呢?
安全性与活性
为了说清这个问题,有必要区分两类不同的属性:安全性(safety)与 活性(liveness)。在刚才的例子中,唯一性 和 单调序列 属于安全属性,可用性 则属于活性属性。
两者究竟有何区别?一个明显线索是,活性属性的定义中往往含有“最终”二字。(没错,你已经猜到了:最终一致性 就是一项活性属性 115。)
安全性常被非正式地定义为 坏事不会发生,活性则是 好事最终会发生。不过,最好不要过度解读这种通俗说法,因为“好”与“坏”属于价值判断,并不太适合用来描述算法。安全性与活性的严格定义要精确得多 116:
- 如果安全属性遭到违反,我们可以指出它在哪一个具体时刻被破坏。例如,唯一性遭到破坏时,可以找到返回重复栅栏令牌的那次具体操作。安全属性一旦被违反,就无法撤销——损害已经造成。
- 活性属性正好相反:它在某个时刻可能尚未成立(例如节点已经发出请求,却还没收到响应),但未来始终还有满足它的希望(也就是最终收到响应)。
区分安全属性与活性属性的一个好处,是能帮助我们应对棘手的系统模型。对分布式算法,通常要求安全属性在系统模型允许的所有情形下都 始终 成立 108。也就是说,即使所有节点崩溃,或整个网络失效,算法仍必须保证绝不返回错误结果,因而安全属性依旧得到满足。
而对活性属性,我们可以附加条件。例如,可以规定只有在多数节点尚未崩溃、且网络最终能从中断中恢复时,请求才必须得到响应。部分同步模型的定义要求系统最终回到同步状态——也就是说,任何一次网络中断都只能持续有限时间,随后会得到修复。
将系统模型映射到现实世界
安全属性、活性属性和系统模型,对推理分布式算法的正确性非常有用。但当算法真正落地实现时,现实世界混乱的一面又会回来找麻烦;这时便清楚地看到,系统模型只是对现实的简化抽象。
例如,崩溃恢复模型中的算法通常假定稳定存储里的数据能挺过崩溃。但如果磁盘数据损坏了,或因硬件错误、配置错误而被清空,会发生什么 117?如果服务器存在固件缺陷,重启时明明硬盘连接无误,却无法识别它们,又会怎样 118?
法定人数算法(参见 “读写仲裁”)依赖节点记住自己声称已经存储的数据。如果节点会患上“失忆症”,忘掉先前保存的数据,就会破坏法定人数条件,进而破坏算法的正确性。或许还需要定义一种新系统模型:假定稳定存储在崩溃后通常得以保留,但偶尔也会丢失。可这样的模型又会变得更加难以推理。
算法的理论描述可以直接声明,假定某些事情绝不会发生——在非拜占庭系统中,我们确实必须对哪些故障可能发生、哪些不可能发生作出假设。然而,真实实现也许仍要包含代码,处理那些理论上“不可能”发生的事情;哪怕处理方式归结为 printf("Sucks to be you") 和 exit(666),也就是把残局留给人类运维人员收拾 119。(这正是计算机科学与软件工程之间的一项区别。)
这并不是说理论化、抽象化的系统模型毫无价值——恰恰相反。它们极其有助于把真实系统的复杂性提炼成一组可管理、可推理的故障,使我们能够理解问题,并尝试用系统化的方法加以解决。
形式化方法和随机测试
怎样知道一个算法确实满足所需属性?并发、部分失效与网络延迟会产生海量潜在状态。我们需要保证这些属性在每一种可能状态下都成立,还要确保没有遗漏任何边界情况。
一种办法是对算法进行形式化验证:用数学语言描述算法,再运用证明技术,证明它在系统模型允许的所有情形下都满足所需属性。证明算法正确,并不表示它在真实系统中的 实现 必然始终行为正确。不过,这是非常好的一步,因为理论分析能够发现算法中的隐患;这些问题在真实系统中可能潜伏很久,直到某些异常情况打破了你的假设(例如时序假设)才突然发作。
把理论分析与经验性测试结合起来,验证实现的行为是否符合预期,是一种稳妥做法。基于属性的测试(property-based testing)、模糊测试(fuzz testing)和确定性模拟测试(deterministic simulation testing,DST)等技术都利用随机化,在各种不同情形下测试系统。Amazon Web Services 等公司已经成功地把这些技术组合运用于许多产品 120 121。
模型检查与规范语言
模型检查器(model checker)是帮助验证算法或系统行为是否符合预期的工具。算法规范要用 TLA+、Gallina 或 FizzBee 等专门设计的语言来编写。借助这类语言,我们可以专注于算法行为,不必纠缠于代码实现细节。模型检查器随后会系统地尝试各种可能发生的情况,利用模型来验证不变量是否在算法的所有状态中都成立。
严格来说,模型检查无法证明算法的不变量在每一种可能状态下都成立,因为大多数现实算法的状态空间是无限的。要真正验证所有状态,需要给出形式化证明;这虽然可行,但通常比运行模型检查器困难得多。因此,使用模型检查器时,通常要把算法模型缩减成一个可以完全验证的近似版本,或是给执行设置某种上限(例如限制最多可以发送多少条消息)。这样一来,只会在更长执行过程中出现的缺陷就无法被发现。
即便如此,模型检查器仍然在易用性与发现隐蔽缺陷的能力之间取得了很好的平衡。CockroachDB、TiDB、Kafka 和许多其他分布式系统,都使用模型规范来发现并修复缺陷 122 123 124。例如,研究人员借助 TLA+ 证明,视图戳复制(VR)的文字描述存在歧义,可能导致数据丢失 125。
按照设计,模型检查器运行的并非实际代码,而是一个只描述协议核心思想的简化模型。这样更容易系统地探索状态空间,但也带来规范与实现逐渐偏离的风险 126。可以检查模型与真实实现的行为是否等价,不过这需要在真实实现中插桩 127。
故障注入
许多缺陷只有在机器或网络发生失效时才会触发。故障注入(fault injection)是一种有效(有时也相当吓人)的技术,用来验证系统实现遇到问题时是否仍会按预期工作。思路很简单:向正在运行的系统环境注入故障,再观察系统如何反应。注入的故障可以是网络失效、机器崩溃、磁盘损坏、进程暂停——凡是你能想到的计算机出错方式都可以尝试。
故障注入测试通常在与系统实际生产环境十分相似的环境中运行;有些团队甚至直接在生产环境中注入故障。Netflix 通过 Chaos Monkey 工具推广了这种做法 128。在生产环境中注入故障通常称为 混沌工程(chaos engineering),我们在 “可靠性与容错” 中已经讨论过。
运行故障注入测试时,首先要部署被测系统,以及故障注入协调者和脚本。协调者负责决定注入哪些故障、何时注入;本地或远程脚本则负责让单个节点或进程发生失效。注入脚本会利用许多不同工具来触发故障:Linux 进程可以用 kill 命令暂停或终止,磁盘可以用 umount 卸载,网络连接可以通过防火墙规则中断。检查故障注入期间以及之后的系统行为,就能确认系统是否一如预期。
触发不同失效所需的工具五花八门,因此故障注入测试写起来颇为繁琐。常见做法是采用 Jepsen 之类的故障注入框架来简化流程。这类框架集成了多种操作系统,并预置了大量故障注入器 129。Jepsen 在许多广泛使用的系统中都成功发现过关键缺陷,成效极为显著 130 131。
确定性模拟测试
确定性模拟测试(DST)也已成为模型检查与故障注入的一种流行补充。它探索状态空间的方式与模型检查器相似,但测试的是真实代码,而不是模型。
在 DST 中,模拟器会自动运行大量随机化的系统执行。模拟期间的网络通信、I/O 和时钟计时都由模拟组件取代,让模拟器能够精确控制各种时序与失效场景下,所有事情发生的先后顺序。这样一来,模拟器所能探索的情形远多于手写测试或故障注入。如果测试失败,还可以重新运行,因为模拟器知道触发失败的准确操作序列;故障注入则无法对系统实施如此细粒度的控制。
DST 要求模拟器能够控制网络延迟等一切非确定性来源。要让代码变得确定,通常采用以下三种策略之一:
- 应用程序层
- 有些系统从一开始就以便于确定性执行代码为目标进行构建。例如,FoundationDB 是 DST 领域的先驱之一,它基于名为 Flow 的异步通信库构建。Flow 为开发者提供了一个接入点,可以把确定性网络模拟注入系统 132。类似地,TigerBeetle 是一款原生支持 DST 的在线事务处理(OLTP)数据库。它把系统状态建模为状态机,所有状态变更都在单一事件循环内发生。再配合时钟等确定性模拟原语,这种架构便能以确定性方式运行 133。
- 运行时层
- 带异步运行时与常用库的编程语言,为引入确定性提供了接入点。可以用单线程运行时,强制所有异步代码顺序执行。例如,FrostDB 修改 Go 运行时,让 goroutine 依次执行 134。Rust 的 madsim 库也采用类似方式。Madsim 为 Tokio 异步运行时 API、AWS S3 库、Kafka 的 Rust 库以及许多其他组件提供确定性实现。应用程序只需换用确定性的库与运行时,无需修改自身代码,就能获得确定性的测试执行。
- 机器层
- 除了在运行时修改代码,也可以让整台机器变得确定。这个过程十分精细:机器必须对所有通常带有非确定性的调用给出确定性响应。Antithesis 等工具通过构建定制的虚拟机监控器来实现这一点,由它把通常非确定性的操作替换成确定性操作。从时钟到网络再到存储,一切都必须纳入考虑。完成后,开发者就能在虚拟机监控器内的一组容器中运行整个分布式系统,得到一个完全确定的分布式系统。
DST 的优势不止是能够重放。Antithesis 等工具发现较为罕见的行为时,会把一次测试执行分叉成多个子执行,借此尝试探索应用程序中的更多代码路径。确定性测试通常使用模拟时钟与网络调用,因此运行速度可以快于现实中的时间流逝。例如,TigerBeetle 的时间抽象可以模拟网络延迟和超时,而无需真的等待足够长时间让超时触发。这类技术让模拟器能够以更快速度探索更多代码路径。
非确定性正是本章所讨论的所有分布式系统难题的核心:并发、网络延迟、进程暂停、时钟跳变和崩溃都会以不可预测的方式发生,而且系统每次运行时都可能不同。反过来说,如果能让系统变得确定,许多事情都会大为简化。
事实上,让事物具有确定性是个简单而强大的思想,在分布式系统设计中反复出现。除了确定性模拟测试,前面几章还介绍过多种利用确定性的方式:
- 事件溯源的一项关键优势(参见 “事件溯源与 CQRS”),是可以确定性地重放事件日志,重新构建派生的物化视图。
- 工作流引擎(参见 “持久化执行与工作流”)依赖确定性的工作流定义,借此提供持久化执行语义。
- 我们将在 “使用共享日志” 中讨论的 状态机复制,会在每个副本上独立执行相同的确定性事务序列,从而复制数据。我们已经见过这种思想的两个变体:基于语句的复制(参见 “复制日志的实现”),以及通过存储过程串行执行事务(参见 “存储过程的利弊”)。
不过,要让代码具有彻底的确定性,仍须十分小心。即使已经消除了所有并发,并用确定性模拟替换 I/O、网络通信、时钟和随机数生成器,系统里仍可能残留非确定性。例如,在某些编程语言中,遍历哈希表元素的顺序可能不确定;是否会触及资源上限(内存分配失败、栈溢出)同样具有非确定性。
总结
本章讨论了分布式系统中可能发生的各种问题,其中包括:
- 每当试图通过网络发送数据包时,它都可能丢失或遭到任意延迟。响应同样可能丢失或延迟,因此只要没有收到响应,你就无从知道消息是否送达。
- 即使已经尽力配置 NTP,一个节点的时钟仍可能与其他节点严重不同步,也可能突然向前或向后跳变。依赖这样的时钟非常危险,因为你多半无法可靠估计其置信区间。
- 进程可能在执行到任意位置时暂停很长时间,被其他节点宣告死亡;随后它又恢复执行,却完全没有意识到自己曾经暂停。
可能出现这类 部分失效,正是分布式系统的决定性特征。只要软件试图完成任何涉及其他节点的事情,就可能偶尔失败、莫名其妙地变慢,或彻底不作响应(最终超时)。在分布式系统中,我们会把容忍部分失效的能力构建到软件里,使整个系统即使有部分组件损坏,也能继续工作。
要容忍故障,第一步是 检测 故障,可就连这一步也很困难。大多数系统都没有准确判断节点是否已经失效的机制,因此多数分布式算法只能依靠超时来判断远程节点是否仍然可用。然而,超时无法区分网络失效与节点失效,而网络延迟的波动有时又会让系统错误地怀疑某个节点已经崩溃。跛行节点更加难以处理:它们仍在响应,却慢得根本做不了任何有用的工作。
即便检测出了故障,要让系统容忍它也并不容易:机器之间既没有全局变量,没有共享内存,没有公共知识,也没有其他形式的共享状态 83。节点甚至无法就“现在几点”达成一致,更不用说更深刻的问题了。信息从一个节点流向另一个节点的唯一途径,就是经由不可靠网络发送。重大决策不能安全地交给单个节点,因此我们需要协议来召集其他节点参与,并争取让达到法定人数的节点达成一致。
如果你习惯于在单台计算机那种数学般完美的理想环境中编写软件——同一个操作总会确定性地返回相同结果——那么转向分布式系统混乱的物理现实,难免会感到震惊。反过来,分布式系统工程师常常认为,只要能在单台计算机上解决,问题就微不足道 4。事实上,如今单台计算机确实能做很多事情。如果能够避免打开潘多拉魔盒,把工作简单地留在一台机器上,例如使用嵌入式存储引擎(参见 “嵌入式存储引擎”),通常就值得这样做。
不过,正如 “分布式与单节点系统” 所讨论的,可伸缩性并不是采用分布式系统的唯一理由。容错与低延迟(把数据放在地理位置更靠近用户的地方)同样重要,而这些目标无法靠单个节点实现。分布式系统的力量在于,原则上它可以在服务层面永不停机,因为所有故障和维护都能在节点层面处理。(当然在实践中,如果把一项错误配置发布到所有节点,分布式系统照样会被彻底击垮。)
本章还稍稍岔开话题,探讨网络、时钟和进程的不可靠性是否属于无可避免的自然法则。答案是否定的:网络可以提供硬实时响应保证与有界延迟,只不过代价极其高昂,硬件资源的利用率也会随之降低。大多数非安全攸关系统都会在便宜而不可靠与昂贵而可靠之间选择前者。
本章始终在讨论问题,呈现出一幅颇为黯淡的图景。下一章将转向解决方案,讨论一些专为应对分布式系统问题而设计的算法。
参考文献
Mark Cavage. There’s Just No Getting Around It: You’re Building a Distributed System. ACM Queue, volume 11, issue 4, pages 80-89, April 2013. doi:10.1145/2466486.2482856 ↩︎
Jay Kreps. Getting Real About Distributed System Reliability. blog.empathybox.com, March 2012. Archived at perma.cc/9B5Q-AEBW ↩︎
Coda Hale. You Can’t Sacrifice Partition Tolerance. codahale.com, October 2010. https://perma.cc/6GJU-X4G5 ↩︎
Jeff Hodges. Notes on Distributed Systems for Young Bloods. somethingsimilar.com, January 2013. Archived at perma.cc/B636-62CE ↩︎ ↩︎
Van Jacobson. Congestion Avoidance and Control. At ACM Symposium on Communications Architectures and Protocols (SIGCOMM), August 1988. doi:10.1145/52324.52356 ↩︎ ↩︎
Bert Hubert. The Ultimate SO_LINGER Page, or: Why Is My TCP Not Reliable. blog.netherlabs.nl, January 2009. Archived at perma.cc/6HDX-L2RR ↩︎ ↩︎
Jerome H. Saltzer, David P. Reed, and David D. Clark. End-To-End Arguments in System Design. ACM Transactions on Computer Systems, volume 2, issue 4, pages 277–288, November 1984. doi:10.1145/357401.357402 ↩︎
Peter Bailis and Kyle Kingsbury. The Network Is Reliable. ACM Queue, volume 12, issue 7, pages 48-55, July 2014. doi:10.1145/2639988.2655736 ↩︎ ↩︎
Joshua B. Leners, Trinabh Gupta, Marcos K. Aguilera, and Michael Walfish. Taming Uncertainty in Distributed Systems with Help from the Network. At 10th European Conference on Computer Systems (EuroSys), April 2015. doi:10.1145/2741948.2741976 ↩︎ ↩︎
Phillipa Gill, Navendu Jain, and Nachiappan Nagappan. Understanding Network Failures in Data Centers: Measurement, Analysis, and Implications. At ACM SIGCOMM Conference, August 2011. doi:10.1145/2018436.2018477 ↩︎
Urs Hölzle. But recently a farmer had started grazing a herd of cows nearby. And whenever they stepped on the fiber link, they bent it enough to cause a blip. x.com, May 2020. Archived at perma.cc/WX8X-ZZA5 ↩︎
CBC News. Hundreds lose internet service in northern B.C. after beaver chews through cable. cbc.ca, April 2021. Archived at perma.cc/UW8C-H2MY ↩︎
Will Oremus. The Global Internet Is Being Attacked by Sharks, Google Confirms. slate.com, August 2014. Archived at perma.cc/P6F3-C6YG ↩︎
Jess Auerbach Jahajeeah. Down to the wire: The ship fixing our internet. continent.substack.com, November 2023. Archived at perma.cc/DP7B-EQ7S ↩︎
Santosh Janardhan. More details about the October 4 outage. engineering.fb.com, October 2021. Archived at perma.cc/WW89-VSXH ↩︎
Tom Parfitt. Georgian woman cuts off web access to whole of Armenia. theguardian.com, April 2011. Archived at perma.cc/KMC3-N3NZ ↩︎
Antonio Voce, Tural Ahmedzade and Ashley Kirk. ‘Shadow fleets’ and subaquatic sabotage: are Europe’s undersea internet cables under attack? theguardian.com, March 2025. Archived at perma.cc/HA7S-ZDBV ↩︎
Shengyun Liu, Paolo Viotti, Christian Cachin, Vivien Quéma, and Marko Vukolić. XFT: Practical Fault Tolerance beyond Crashes. At 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI), November 2016. ↩︎
Mark Imbriaco. Downtime last Saturday. github.blog, December 2012. Archived at perma.cc/M7X5-E8SQ ↩︎ ↩︎
Tom Lianza and Chris Snook. A Byzantine failure in the real world. blog.cloudflare.com, November 2020. Archived at perma.cc/83EZ-ALCY ↩︎ ↩︎
Mohammed Alfatafta, Basil Alkhatib, Ahmed Alquraan, and Samer Al-Kiswany. Toward a Generic Fault Tolerance Technique for Partial Network Partitioning. At 14th USENIX Symposium on Operating Systems Design and Implementation (OSDI), November 2020. ↩︎
Marc A. Donges. Re: bnx2 cards Intermittantly Going Offline. Message to Linux netdev mailing list, spinics.net, September 2012. Archived at perma.cc/TXP6-H8R3 ↩︎ ↩︎
Troy Toman. Inside a CODE RED: Network Edition. signalvnoise.com, September 2020. Archived at perma.cc/BET6-FY25 ↩︎
Kyle Kingsbury. Call Me Maybe: Elasticsearch. aphyr.com, June 2014. perma.cc/JK47-S89J ↩︎
Salvatore Sanfilippo. A Few Arguments About Redis Sentinel Properties and Fail Scenarios. antirez.com, October 2014. perma.cc/8XEU-CLM8 ↩︎
Nicolas Liochon. CAP: If All You Have Is a Timeout, Everything Looks Like a Partition. blog.thislongrun.com, May 2015. Archived at perma.cc/FS57-V2PZ ↩︎
Matthew P. Grosvenor, Malte Schwarzkopf, Ionel Gog, Robert N. M. Watson, Andrew W. Moore, Steven Hand, and Jon Crowcroft. Queues Don’t Matter When You Can JUMP Them! At 12th USENIX Symposium on Networked Systems Design and Implementation (NSDI), May 2015. ↩︎ ↩︎
Theo Julienne. Debugging network stalls on Kubernetes. github.blog, November 2019. Archived at perma.cc/K9M8-XVGL ↩︎
Guohui Wang and T. S. Eugene Ng. The Impact of Virtualization on Network Performance of Amazon EC2 Data Center. At 29th IEEE International Conference on Computer Communications (INFOCOM), March 2010. doi:10.1109/INFCOM.2010.5461931 ↩︎ ↩︎
Brandon Philips. etcd: Distributed Locking and Service Discovery. At Strange Loop, September 2014. ↩︎
Steve Newman. A Systematic Look at EC2 I/O. blog.scalyr.com, October 2012. Archived at perma.cc/FL4R-H2VE ↩︎ ↩︎
Naohiro Hayashibara, Xavier Défago, Rami Yared, and Takuya Katayama. The ϕ Accrual Failure Detector. Japan Advanced Institute of Science and Technology, School of Information Science, Technical Report IS-RR-2004-010, May 2004. Archived at perma.cc/NSM2-TRYA ↩︎
Jeffrey Wang. Phi Accrual Failure Detector. ternarysearch.blogspot.co.uk, August 2013. perma.cc/L452-AMLV ↩︎
Srinivasan Keshav. An Engineering Approach to Computer Networking: ATM Networks, the Internet, and the Telephone Network. Addison-Wesley Professional, May 1997. ISBN: 978-0-201-63442-6 ↩︎ ↩︎
Othmar Kyas. ATM Networks. International Thomson Publishing, 1995. ISBN: 978-1-850-32128-6 ↩︎
Mellanox Technologies. InfiniBand FAQ, Rev 1.3. network.nvidia.com, December 2014. Archived at perma.cc/LQJ4-QZVK ↩︎
Jose Renato Santos, Yoshio Turner, and G. (John) Janakiraman. End-to-End Congestion Control for InfiniBand. At 22nd Annual Joint Conference of the IEEE Computer and Communications Societies (INFOCOM), April 2003. Also published by HP Laboratories Palo Alto, Tech Report HPL-2002-359. doi:10.1109/INFCOM.2003.1208949 ↩︎
Jialin Li, Naveen Kr. Sharma, Dan R. K. Ports, and Steven D. Gribble. Tales of the Tail: Hardware, OS, and Application-level Sources of Tail Latency. At ACM Symposium on Cloud Computing (SOCC), November 2014. doi:10.1145/2670979.2670988 ↩︎
Ulrich Windl, David Dalton, Marc Martinec, and Dale R. Worley. The NTP FAQ and HOWTO. ntp.org, November 2006. ↩︎ ↩︎ ↩︎
John Graham-Cumming. How and why the leap second affected Cloudflare DNS. blog.cloudflare.com, January 2017. Archived at archive.org ↩︎ ↩︎
David Holmes. Inside the Hotspot VM: Clocks, Timers and Scheduling Events – Part I – Windows. blogs.oracle.com, October 2006. Archived at archive.org ↩︎
Joran Dirk Greef. Three Clocks are Better than One. tigerbeetle.com, August 2021. Archived at perma.cc/5RXG-EU6B ↩︎
Oliver Yang. Pitfalls of TSC usage. oliveryang.net, September 2015. Archived at perma.cc/Z2QY-5FRA ↩︎
Steve Loughran. Time on Multi-Core, Multi-Socket Servers. steveloughran.blogspot.co.uk, September 2015. Archived at perma.cc/7M4S-D4U6 ↩︎
James C. Corbett, Jeffrey Dean, Michael Epstein, Andrew Fikes, Christopher Frost, JJ Furman, Sanjay Ghemawat, Andrey Gubarev, Christopher Heiser, Peter Hochschild, Wilson Hsieh, Sebastian Kanthak, Eugene Kogan, Hongyi Li, Alexander Lloyd, Sergey Melnik, David Mwaura, David Nagle, Sean Quinlan, Rajesh Rao, Lindsay Rolig, Dale Woodford, Yasushi Saito, Christopher Taylor, Michal Szymaniak, and Ruth Wang. Spanner: Google’s Globally-Distributed Database. At 10th USENIX Symposium on Operating System Design and Implementation (OSDI), October 2012. ↩︎ ↩︎ ↩︎
M. Caporaloni and R. Ambrosini. How Closely Can a Personal Computer Clock Track the UTC Timescale Via the Internet? European Journal of Physics, volume 23, issue 4, pages L17–L21, June 2012. doi:10.1088/0143-0807/23/4/103 ↩︎
Nelson Minar. A Survey of the NTP Network. alumni.media.mit.edu, December 1999. Archived at perma.cc/EV76-7ZV3 ↩︎
Viliam Holub. Synchronizing Clocks in a Cassandra Cluster Pt. 1 – The Problem. blog.rapid7.com, March 2014. Archived at perma.cc/N3RV-5LNL ↩︎
Poul-Henning Kamp. The One-Second War (What Time Will You Die?) ACM Queue, volume 9, issue 4, pages 44–48, April 2011. doi:10.1145/1966989.1967009 ↩︎
Nelson Minar. Leap Second Crashes Half the Internet. somebits.com, July 2012. Archived at perma.cc/2WB8-D6EU ↩︎
Christopher Pascoe. Time, Technology and Leaping Seconds. googleblog.blogspot.co.uk, September 2011. Archived at perma.cc/U2JL-7E74 ↩︎
Mingxue Zhao and Jeff Barr. Look Before You Leap – The Coming Leap Second and AWS. aws.amazon.com, May 2015. Archived at perma.cc/KPE9-XMFM ↩︎
Darryl Veitch and Kanthaiah Vijayalayan. Network Timing and the 2015 Leap Second. At 17th International Conference on Passive and Active Measurement (PAM), April 2016. doi:10.1007/978-3-319-30505-9_29 ↩︎
VMware, Inc. Timekeeping in VMware Virtual Machines. vmware.com, October 2008. Archived at perma.cc/HM5R-T5NF ↩︎
Victor Yodaiken. Clock Synchronization in Finance and Beyond. yodaiken.com, November 2017. Archived at perma.cc/9XZD-8ZZN ↩︎
Mustafa Emre Acer, Emily Stark, Adrienne Porter Felt, Sascha Fahl, Radhika Bhargava, Bhanu Dev, Matt Braithwaite, Ryan Sleevi, and Parisa Tabriz. Where the Wild Warnings Are: Root Causes of Chrome HTTPS Certificate Errors. At ACM SIGSAC Conference on Computer and Communications Security (CCS), pages 1407–1420, October 2017. doi:10.1145/3133956.3134007 ↩︎
European Securities and Markets Authority. MiFID II / MiFIR: Regulatory Technical and Implementing Standards – Annex I. esma.europa.eu, Report ESMA/2015/1464, September 2015. Archived at perma.cc/ZLX9-FGQ3 ↩︎
Luke Bigum. Solving MiFID II Clock Synchronisation With Minimum Spend (Part 1). catach.blogspot.com, November 2015. Archived at perma.cc/4J5W-FNM4 ↩︎
Oleg Obleukhov and Ahmad Byagowi. How Precision Time Protocol is being deployed at Meta. engineering.fb.com, November 2022. Archived at perma.cc/29G6-UJNW ↩︎
John Wiseman. gpsjam.org, July 2022. ↩︎
Josh Levinson, Julien Ridoux, and Chris Munns. It’s About Time: Microsecond-Accurate Clocks on Amazon EC2 Instances. aws.amazon.com, November 2023. Archived at perma.cc/56M6-5VMZ ↩︎
Kyle Kingsbury. Call Me Maybe: Cassandra. aphyr.com, September 2013. Archived at perma.cc/4MBR-J96V ↩︎ ↩︎ ↩︎
John Daily. Clocks Are Bad, or, Welcome to the Wonderful World of Distributed Systems. riak.com, November 2013. Archived at perma.cc/4XB5-UCXY ↩︎ ↩︎
Marc Brooker. It’s About Time! brooker.co.za, November 2023. Archived at perma.cc/N6YK-DRPA ↩︎
Kyle Kingsbury. The Trouble with Timestamps. aphyr.com, October 2013. Archived at perma.cc/W3AM-5VAV ↩︎
Leslie Lamport. Time, Clocks, and the Ordering of Events in a Distributed System. Communications of the ACM, volume 21, issue 7, pages 558–565, July 1978. doi:10.1145/359545.359563 ↩︎
Justin Sheehy. There Is No Now: Problems With Simultaneity in Distributed Systems. ACM Queue, volume 13, issue 3, pages 36–41, March 2015. doi:10.1145/2733108 ↩︎
Murat Demirbas. Spanner: Google’s Globally-Distributed Database. muratbuffalo.blogspot.co.uk, July 2013. Archived at perma.cc/6VWR-C9WB ↩︎
Dahlia Malkhi and Jean-Philippe Martin. Spanner’s Concurrency Control. ACM SIGACT News, volume 44, issue 3, pages 73–77, September 2013. doi:10.1145/2527748.2527767 ↩︎
Franck Pachot. Achieving Precise Clock Synchronization on AWS. yugabyte.com, December 2024. Archived at perma.cc/UYM6-RNBS ↩︎
Spencer Kimball. Living Without Atomic Clocks: Where CockroachDB and Spanner diverge. cockroachlabs.com, January 2022. Archived at perma.cc/AWZ7-RXFT ↩︎
Murat Demirbas. Use of Time in Distributed Databases (part 4): Synchronized clocks in production databases. muratbuffalo.blogspot.com, January 2025. Archived at perma.cc/9WNX-Q9U3 ↩︎
Cary G. Gray and David R. Cheriton. Leases: An Efficient Fault-Tolerant Mechanism for Distributed File Cache Consistency. At 12th ACM Symposium on Operating Systems Principles (SOSP), December 1989. doi:10.1145/74850.74870 ↩︎
Daniel Sturman, Scott Delap, Max Ross, et al. Roblox Return to Service. corp.roblox.com, January 2022. Archived at perma.cc/8ALT-WAS4 ↩︎
Todd Lipcon. Avoiding Full GCs with MemStore-Local Allocation Buffers. slideshare.net, February 2011. Archived at https://perma.cc/CH62-2EWJ ↩︎
Christopher Clark, Keir Fraser, Steven Hand, Jacob Gorm Hansen, Eric Jul, Christian Limpach, Ian Pratt, and Andrew Warfield. Live Migration of Virtual Machines. At 2nd USENIX Symposium on Symposium on Networked Systems Design & Implementation (NSDI), May 2005. ↩︎
Mike Shaver. fsyncers and Curveballs. shaver.off.net, May 2008. Archived at archive.org ↩︎
Zhenyun Zhuang and Cuong Tran. Eliminating Large JVM GC Pauses Caused by Background IO Traffic. engineering.linkedin.com, February 2016. Archived at perma.cc/ML2M-X9XT ↩︎
Martin Thompson. Java Garbage Collection Distilled. mechanical-sympathy.blogspot.co.uk, July 2013. Archived at perma.cc/DJT3-NQLQ ↩︎ ↩︎
David Terei and Amit Levy. Blade: A Data Center Garbage Collector. arXiv:1504.02578, April 2015. ↩︎
Martin Maas, Tim Harris, Krste Asanović, and John Kubiatowicz. Trash Day: Coordinating Garbage Collection in Distributed Systems. At 15th USENIX Workshop on Hot Topics in Operating Systems (HotOS), May 2015. ↩︎
Martin Fowler. The LMAX Architecture. martinfowler.com, July 2011. Archived at perma.cc/5AV4-N6RJ ↩︎
Joseph Y. Halpern and Yoram Moses. Knowledge and common knowledge in a distributed environment. Journal of the ACM (JACM), volume 37, issue 3, pages 549–587, July 1990. doi:10.1145/79147.79161 ↩︎ ↩︎
Chuzhe Tang, Zhaoguo Wang, Xiaodong Zhang, Qianmian Yu, Binyu Zang, Haibing Guan, and Haibo Chen. Ad Hoc Transactions in Web Applications: The Good, the Bad, and the Ugly. At ACM International Conference on Management of Data (SIGMOD), June 2022. doi:10.1145/3514221.3526120 ↩︎
Flavio P. Junqueira and Benjamin Reed. ZooKeeper: Distributed Process Coordination. O’Reilly Media, 2013. ISBN: 978-1-449-36130-3 ↩︎ ↩︎
Enis Söztutar. HBase and HDFS: Understanding Filesystem Usage in HBase. At HBaseCon, June 2013. Archived at perma.cc/4DXR-9P88 ↩︎
SUSE LLC. SUSE Linux Enterprise High Availability 15 SP6 Administration Guide, Section 12: Fencing and STONITH. documentation.suse.com, March 2025. Archived at perma.cc/8LAR-EL9D ↩︎
Mike Burrows. The Chubby Lock Service for Loosely-Coupled Distributed Systems. At 7th USENIX Symposium on Operating System Design and Implementation (OSDI), November 2006. ↩︎
Kyle Kingsbury. etcd 3.4.3. jepsen.io, January 2020. Archived at perma.cc/2P3Y-MPWU ↩︎
Ensar Basri Kahveci. Distributed Locks are Dead; Long Live Distributed Locks! hazelcast.com, April 2019. Archived at perma.cc/7FS5-LDXE ↩︎
Martin Kleppmann. How to do distributed locking. martin.kleppmann.com, February 2016. Archived at perma.cc/Y24W-YQ5L ↩︎
Salvatore Sanfilippo. Is Redlock safe? antirez.com, February 2016. Archived at perma.cc/B6GA-9Q6A ↩︎
Gunnar Morling. Leader Election With S3 Conditional Writes. www.morling.dev, August 2024. Archived at perma.cc/7V2N-J78Y ↩︎
Leslie Lamport, Robert Shostak, and Marshall Pease. The Byzantine Generals Problem. ACM Transactions on Programming Languages and Systems (TOPLAS), volume 4, issue 3, pages 382–401, July 1982. doi:10.1145/357172.357176 ↩︎
Jim N. Gray. Notes on Data Base Operating Systems. in Operating Systems: An Advanced Course, Lecture Notes in Computer Science, volume 60, edited by R. Bayer, R. M. Graham, and G. Seegmüller, pages 393–481, Springer-Verlag, 1978. ISBN: 978-3-540-08755-7. Archived at perma.cc/7S9M-2LZU ↩︎
Brian Palmer. How Complicated Was the Byzantine Empire? slate.com, October 2011. Archived at perma.cc/AN7X-FL3N ↩︎
Leslie Lamport. My Writings. lamport.azurewebsites.net, December 2014. Archived at perma.cc/5NNM-SQGR ↩︎
John Rushby. Bus Architectures for Safety-Critical Embedded Systems. At 1st International Workshop on Embedded Software (EMSOFT), October 2001. doi:10.1007/3-540-45449-7_22 ↩︎ ↩︎
Jake Edge. ELC: SpaceX Lessons Learned. lwn.net, March 2013. Archived at perma.cc/AYX8-QP5X ↩︎
Shehar Bano, Alberto Sonnino, Mustafa Al-Bassam, Sarah Azouvi, Patrick McCorry, Sarah Meiklejohn, and George Danezis. SoK: Consensus in the Age of Blockchains. At 1st ACM Conference on Advances in Financial Technologies (AFT), October 2019. doi:10.1145/3318041.3355458 ↩︎
Ezra Feilden, Adi Oltean, and Philip Johnston. Why we should train AI in space. White Paper, starcloud.com, September 2024. Archived at perma.cc/7Y3S-8UB6 ↩︎
James Mickens. The Saddest Moment. USENIX ;login, May 2013. Archived at perma.cc/T7BZ-XCFR ↩︎
Martin Kleppmann and Heidi Howard. Byzantine Eventual Consistency and the Fundamental Limits of Peer-to-Peer Databases. arxiv.org, December 2020. doi:10.48550/arXiv.2012.00472 ↩︎
Martin Kleppmann. Making CRDTs Byzantine Fault Tolerant. At 9th Workshop on Principles and Practice of Consistency for Distributed Data (PaPoC), April 2022. doi:10.1145/3517209.3524042 ↩︎
Evan Gilman. The Discovery of Apache ZooKeeper’s Poison Packet. pagerduty.com, May 2015. Archived at perma.cc/RV6L-Y5CQ ↩︎ ↩︎
Jonathan Stone and Craig Partridge. When the CRC and TCP Checksum Disagree. At ACM Conference on Applications, Technologies, Architectures, and Protocols for Computer Communication (SIGCOMM), August 2000. doi:10.1145/347059.347561 ↩︎
Evan Jones. How Both TCP and Ethernet Checksums Fail. evanjones.ca, October 2015. Archived at perma.cc/9T5V-B8X5 ↩︎
Cynthia Dwork, Nancy Lynch, and Larry Stockmeyer. Consensus in the Presence of Partial Synchrony. Journal of the ACM, volume 35, issue 2, pages 288–323, April 1988. doi:10.1145/42282.42283 ↩︎ ↩︎ ↩︎
Richard D. Schlichting and Fred B. Schneider. Fail-stop processors: an approach to designing fault-tolerant computing systems. ACM Transactions on Computer Systems (TOCS), volume 1, issue 3, pages 222–238, August 1983. doi:10.1145/357369.357371 ↩︎
Thanh Do, Mingzhe Hao, Tanakorn Leesatapornwongsa, Tiratat Patana-anake, and Haryadi S. Gunawi. Limplock: Understanding the Impact of Limpware on Scale-out Cloud Systems. At 4th ACM Symposium on Cloud Computing (SoCC), October 2013. doi:10.1145/2523616.2523627 ↩︎
Josh Snyder and Joseph Lynch. Garbage collecting unhealthy JVMs, a proactive approach. Netflix Technology Blog, netflixtechblog.medium.com, November 2019. Archived at perma.cc/8BTA-N3YB ↩︎
Haryadi S. Gunawi, Riza O. Suminto, Russell Sears, Casey Golliher, Swaminathan Sundararaman, Xing Lin, Tim Emami, Weiguang Sheng, Nematollah Bidokhti, Caitie McCaffrey, Gary Grider, Parks M. Fields, Kevin Harms, Robert B. Ross, Andree Jacobson, Robert Ricci, Kirk Webb, Peter Alvaro, H. Birali Runesha, Mingzhe Hao, and Huaicheng Li. Fail-Slow at Scale: Evidence of Hardware Performance Faults in Large Production Systems. At 16th USENIX Conference on File and Storage Technologies, February 2018. ↩︎
Peng Huang, Chuanxiong Guo, Lidong Zhou, Jacob R. Lorch, Yingnong Dang, Murali Chintalapati, and Randolph Yao. Gray Failure: The Achilles’ Heel of Cloud-Scale Systems. At 16th Workshop on Hot Topics in Operating Systems (HotOS), May 2017. doi:10.1145/3102980.3103005 ↩︎
Chang Lou, Peng Huang, and Scott Smith. Understanding, Detecting and Localizing Partial Failures in Large System Software. At 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI), February 2020. ↩︎
Peter Bailis and Ali Ghodsi. Eventual Consistency Today: Limitations, Extensions, and Beyond. ACM Queue, volume 11, issue 3, pages 55-63, March 2013. doi:10.1145/2460276.2462076 ↩︎
Bowen Alpern and Fred B. Schneider. Defining Liveness. Information Processing Letters, volume 21, issue 4, pages 181–185, October 1985. doi:10.1016/0020-0190(85)90056-0 ↩︎
Flavio P. Junqueira. Dude, Where’s My Metadata? fpj.me, May 2015. Archived at perma.cc/D2EU-Y9S5 ↩︎
Scott Sanders. January 28th Incident Report. github.com, February 2016. Archived at perma.cc/5GZR-88TV ↩︎
Jay Kreps. A Few Notes on Kafka and Jepsen. blog.empathybox.com, September 2013. perma.cc/XJ5C-F583 ↩︎
Marc Brooker and Ankush Desai. Systems Correctness Practices at AWS. Queue, Volume 22, Issue 6, November/December 2024. doi:10.1145/3712057 ↩︎
Andrey Satarin. Testing Distributed Systems: Curated list of resources on testing distributed systems. asatarin.github.io. Archived at perma.cc/U5V8-XP24 ↩︎
Jack Vanlightly. Verifying Kafka transactions - Diary entry 2 - Writing an initial TLA+ spec. jack-vanlightly.com, December 2024. Archived at perma.cc/NSQ8-MQ5N ↩︎
Siddon Tang. From Chaos to Order — Tools and Techniques for Testing TiDB, A Distributed NewSQL Database. pingcap.com, April 2018. Archived at perma.cc/5EJB-R29F ↩︎
Nathan VanBenschoten. Parallel Commits: An atomic commit protocol for globally distributed transactions. cockroachlabs.com, November 2019. Archived at perma.cc/5FZ7-QK6J ↩︎
Jack Vanlightly. Paper: VR Revisited - State Transfer (part 3). jack-vanlightly.com, December 2022. Archived at perma.cc/KNK3-K6WS ↩︎
Hillel Wayne. What if the spec doesn’t match the code? buttondown.com, March 2024. Archived at perma.cc/8HEZ-KHER ↩︎
Lingzhi Ouyang, Xudong Sun, Ruize Tang, Yu Huang, Madhav Jivrajani, Xiaoxing Ma, Tianyin Xu. Multi-Grained Specifications for Distributed System Model Checking and Verification. At 20th European Conference on Computer Systems (EuroSys), March 2025. doi:10.1145/3689031.3696069 ↩︎
Yury Izrailevsky and Ariel Tseitlin. The Netflix Simian Army. netflixtechblog.com, July, 2011. Archived at perma.cc/M3NY-FJW6 ↩︎
Kyle Kingsbury. Jepsen: On the perils of network partitions. aphyr.com, May, 2013. Archived at perma.cc/W98G-6HQP ↩︎
Kyle Kingsbury. Jepsen Analyses. jepsen.io, 2024. Archived at perma.cc/8LDN-D2T8 ↩︎
Rupak Majumdar and Filip Niksic. Why is random testing effective for partition tolerance bugs? Proceedings of the ACM on Programming Languages (PACMPL), volume 2, issue POPL, article no. 46, December 2017. doi:10.1145/3158134 ↩︎
FoundationDB project authors. Simulation and Testing. apple.github.io. Archived at perma.cc/NQ3L-PM4C ↩︎
Alex Kladov. Simulation Testing For Liveness. tigerbeetle.com, July 2023. Archived at perma.cc/RKD4-HGCR ↩︎
Alfonso Subiotto Marqués. (Mostly) Deterministic Simulation Testing in Go. polarsignals.com, May 2024. Archived at perma.cc/ULD6-TSA4 ↩︎
10 一致性与共识

古谚有云:“出海切勿带两只航海钟;要么带一只,要么带三只。”
弗雷德里克・P・布鲁克斯,《人月神话:软件工程随笔》(1995)
正如第 9 章所述,分布式系统里可能出错的事情很多。要让服务在这些故障发生时仍能正确运行,就必须设法容忍故障。
复制(replication)是实现容错最有力的工具之一。然而,正如第 6 章所示,把同一份数据复制到多个副本,也带来了不一致的风险。读请求可能由尚未追上进度的副本处理,返回陈旧结果;如果多个副本都能接受写入,还必须解决不同副本上并发写入的值之间的冲突。从总体上看,处理这类问题有两种彼此竞争的思路:
- 最终一致性(eventual consistency)
- 这种思路把系统采用复制这一事实暴露给应用,由应用开发者处理随之而来的不一致与冲突。采用“多主复制”和“无主复制”的系统常常使用这种方式。
- 强一致性(strong consistency)
- 这种思路认为,应用不应操心复制的内部细节,系统应当表现得仿佛只有一个节点。它让应用开发者的工作简单得多,代价则是更强的一致性会损害性能,而且有些故障在最终一致系统中尚可容忍,却会令强一致系统停摆。
一如既往,哪种方式更好取决于具体应用。如果应用允许用户离线修改数据,那么正如“同步引擎与本地优先软件”所述,最终一致性不可避免。然而,应用要正确处理最终一致性也很困难。如果各副本位于通信快速而可靠的数据中心,强一致性的成本通常可以接受,因而往往更合适。
本章将深入讨论强一致性,重点考察三个方面:
- “强一致性”这个说法相当含糊,因此我们先给出一个更精确的目标:线性一致性(linearizability)。
- 接着讨论 ID 和时间戳的生成。这个问题看似与一致性无关,实际上二者关系密切。
- 最后探讨分布式系统如何既实现线性一致性,又保持容错能力;答案在于 共识(consensus)算法。
在此过程中,我们会看到,分布式系统中什么可以做到、什么无法做到,受到一些根本限制。
本章讨论的内容素以难以正确实现而著称。一个系统在没有故障时运行良好并不难,难的是它可能在某种设计者未曾考虑的不利故障组合下彻底崩溃。为帮助我们推理这些边界情况,研究者发展出了大量理论;借助这些理论,我们才能构建真正稳健的容错系统。
本章只能浅尝辄止:我们会采用非形式化的直观解释,避开算法的繁琐细节、形式化模型和证明。如果你打算认真从事共识系统或类似基础设施的工作,就必须深入掌握相关理论,否则很难让系统真正可靠。与往常一样,本章参考文献可以作为进一步学习的起点。
线性一致性
要让复制数据库尽可能简单易用,最好让它表现得仿佛根本没有复制。这样,用户就不必操心复制延迟、冲突和其他不一致问题:既能获得容错的好处,又不必承担思考多个副本所带来的复杂性。
这就是 线性一致性(linearizability)1(也称为 原子一致性,atomic consistency 2,强一致性,strong consistency,即时一致性,immediate consistency,或 外部一致性,external consistency 3)背后的思想。线性一致性的精确定义相当微妙,本节余下部分会逐步展开;其基本思想,是让系统看起来仿佛只有一份数据,所有操作都原子地作用于这份数据。有了这种保证,即使实际上存在多个副本,应用也无需关心它们。
在线性一致的系统中,只要一个客户端成功完成写入,此后所有客户端从数据库读取时,都必须能看到刚写入的值。要维持“只有一份数据”的假象,就必须保证读到的是最近写入的最新值,而不是来自陈旧缓存或副本的旧值。换句话说,线性一致性是一种 新鲜度保证(recency guarantee)。下面用一个不满足线性一致性的系统来说明这一点。

图 10-1展示了一个不满足线性一致性的体育网站 4。Aaliyah 和 Bryce 坐在同一个房间里,都在用手机关注自己喜爱球队的比赛结果。终场比分刚刚公布,Aaliyah 刷新页面,看到了获胜方,便兴奋地告诉 Bryce。Bryce 将信将疑地按下自己手机上的 刷新,但请求被路由到一个落后的数据库副本,于是页面仍显示比赛正在进行。
如果两人同时刷新,得到不同结果倒不那么令人意外,因为谁也不知道服务器究竟在什么时刻处理了各自的请求。然而 Bryce 知道,自己是在听见 Aaliyah 喊出终场比分 之后 才按下刷新按钮、发起查询的,因此他有理由期待查询结果至少不比 Aaliyah 看到的更旧。结果却返回了陈旧数据,这就违反了线性一致性。
什么使系统具有线性一致性?
为了更好地理解线性一致性,我们再看几个例子。图 10-2展示了三个客户端如何并发读写线性一致数据库中的同一个对象 x。在分布式系统理论中,x 称为 寄存器(register);在实际系统里,它可以是键值存储中的一个键、关系数据库中的一行,或文档数据库中的一个文档。

为简单起见,图 10-2只展示客户端看到的请求,不涉及数据库内部。每根横条代表客户端发出的一次请求:左端是请求发出的时刻,右端是客户端收到响应的时刻。由于网络延迟变化不定,客户端不知道数据库究竟何时处理了请求,只知道处理一定发生在请求发出与响应到达之间。
在这个例子中,寄存器有两种类型的操作:
- read(x) ⇒ v 表示客户端请求读取寄存器 x,数据库返回值 v。
- write(x, v) ⇒ r 表示客户端请求把寄存器 x 设为 v,数据库返回响应 r(可以是 ok 或 error)。
在图 10-2中,x 的初始值为 0,客户端 C 发出写请求,要把它改为 1。在此期间,客户端 A 和 B 不断轮询数据库,读取最新值。它们可能得到哪些响应?
- 客户端 A 的第一次读取在写入开始前就已完成,因此必然返回旧值 0。
- 客户端 A 的最后一次读取在写入完成后才开始,因此在线性一致的数据库中必然返回新值 1,因为该读取一定是在写入之后处理的。
- 凡是时间上与写操作重叠的读取,都可能返回 0 或 1,因为我们不知道数据库处理读取时,写入究竟是否已经生效。这些读取与写入是 并发 的。
但这还不足以完整描述线性一致性。如果与写入并发的读取可以任意返回旧值或新值,那么在写入期间,读者可能看到值在新旧之间来回跳变。这不符合我们对“只有一份数据”的系统的预期。
要使系统满足线性一致性,还需要增加一条约束,如图 10-3所示。

在线性一致的系统中,可以设想在写操作起止之间存在某个时刻,x 的值在那一刻原子地从 0 变为 1。因此,只要某个客户端已经读到新值 1,此后所有读取也都必须返回 1,即使写操作本身尚未结束。
图 10-3用箭头标出了这种时序依赖。客户端 A 最先读到新值 1;A 的读取刚一返回,B 就开始了新的读取。由于 B 的读取严格晚于 A 的读取,它也必须返回 1,哪怕 C 的写入仍在进行。(这与图 10-1中 Aaliyah 和 Bryce 的情形相同:Aaliyah 已经读到新值之后,Bryce 也理应读到新值。)
还可以进一步细化时序图,把每个操作视为在某个时刻原子生效 5,如图 10-4这个更复杂的例子所示。除了 read 和 write,图中又加入了第三种操作:
- cas(x, v old, v new) ⇒ r 表示客户端请求执行原子 比较并设置(compare-and-set)操作(参见“条件写入(比较并设置)”)。如果寄存器 x 的当前值等于 v old,就原子地把它改为 v new;否则保持不变并返回错误。r 是数据库的响应(ok 或 error)。
图 10-4在每次操作的横条内画了一根竖线,表示我们认为该操作实际生效的时刻。把这些标记依次连起来,必须得到寄存器的一条合法读写序列——每次读取都应返回最近一次写入所设置的值。
线性一致性要求,连接这些操作标记的线只能沿时间向前移动(从左向右),绝不能倒退。这项要求保证了前面所说的新鲜度:一旦新值已经被写入或读到,此后的读取就都必须看到这个值,直至它再次被覆盖。

图 10-4中有几个细节值得注意:
- 客户端 B 先发出读取 x 的请求,随后 D 请求把 x 设为 0,A 又请求把 x 设为 1;但 B 最终读到了 1,也就是 A 写入的值。这没有问题:它说明数据库先处理 D 的写入,再处理 A 的写入,最后才处理 B 的读取。这个顺序虽然不同于请求发出的顺序,却仍然合法,因为三次请求彼此并发。也许 B 的读请求在网络中耽搁了一会儿,直到两次写入之后才抵达数据库。
- 客户端 B 在 A 收到数据库确认“写入 1 成功”的响应之前,就已经读到了 1。这也没有问题,只说明数据库发给 A 的 ok 响应在网络中有所延迟。
- 这个模型不作任何事务隔离假设,其他客户端随时都可能修改值。例如,C 先读到 1,随后又读到 2,是因为两次读取之间 B 修改了该值。原子的比较并设置(cas)操作可以检查某个值是否已被其他客户端并发修改:B 和 C 的 cas 请求成功,而 D 的 cas 请求失败,因为数据库处理该请求时,x 已经不再等于 0。
- 客户端 B 最后一次读取(阴影横条)不满足线性一致性。该读取与 C 的 cas 写入并发,后者把 x 从 2 改为 4。若没有其他请求,B 返回 2 原本是允许的;但在 B 开始读取之前,客户端 A 已经读到了新值 4,因此 B 不能再读到比 A 更旧的值。这仍然是图 10-1中 Aaliyah 与 Bryce 的同一种情形。
以上就是线性一致性的直观含义,形式化定义 1 对此有更精确的描述。可以记录所有请求与响应的时序,再检查它们能否排成一条合法的顺序序列,以此检验系统行为是否满足线性一致性;只是这种检验的计算成本很高 6 7。
正如事务除了可串行化之外还有各种“弱隔离级别”,复制系统除了线性一致性之外,也有许多较弱的一致性模型 8。我们在“复制延迟的问题”中见过的 写后读、单调读 和 一致前缀读,就是这类较弱保证。线性一致性不仅包含所有这些保证,还提供得更多。本章将集中讨论线性一致性——实际系统中常用的最强一致性模型。
线性一致性很容易与“可串行化”混淆,因为两个名称看起来都像是在说“可以排成某种顺序”。但二者是完全不同的保证,必须加以区分:
- 可串行化
- 可串行化是事务的一项隔离属性;每个事务可以读写 多个对象(行、文档或记录)。它保证事务的行为等同于按 某种 串行顺序执行:先完整执行一个事务,再完整执行下一个事务,彼此不交错。这个串行顺序可以不同于事务实际运行的顺序 9。
- 线性一致性
- 线性一致性是对寄存器(即 单个对象)读写的保证。它不会把操作组合成事务,因此无法防止“写偏差与幻读”这类涉及多个对象的问题。但线性一致性是一项 新鲜度 保证:如果一个操作在另一个操作开始前已经结束,那么后一个操作必须观察到至少与前一个操作同样新的状态。可串行化没有这项要求,例如它允许陈旧读取 10。
(顺序一致性 又是另外一回事 8,但我们不会在这里讨论它。)
数据库可以同时提供可串行化与线性一致性,这种组合称为 严格可串行化(strict serializability)或 强单副本可串行化(strong one-copy serializability,strong-1SR)11 12。单节点数据库通常满足线性一致性。对于采用“可串行化快照隔离(SSI)”等乐观方法的分布式数据库,情况要复杂一些。例如,CockroachDB 提供可串行化以及一定的读取新鲜度保证,却不提供严格可串行化 13,因为后者要求事务之间进行代价高昂的协调 14。
也可以把较弱的隔离级别与线性一致性组合,或把较弱的一致性模型与可串行化组合。事实上,一致性模型与隔离级别在很大程度上可以独立选择 15 16。
依赖线性一致性
线性一致性在什么情况下有用?查看体育比赛的终场比分也许只是个无关紧要的例子:结果陈旧几秒,通常不会造成实际损失。然而在少数领域,线性一致性却是系统正确工作的必要条件。
锁定与领导者选举
采用单主复制的系统必须确保领导者确实只有一个,而不是同时出现多个领导者(脑裂)。一种选举办法是使用租约:每个启动的节点都尝试获取租约,成功者成为领导者 17。无论底层机制如何实现,都必须满足线性一致性,绝不能让两个不同节点同时获得同一份租约。
Apache ZooKeeper 18、etcd 等协调服务经常用于实现分布式租约和领导者选举。它们借助共识算法,以容错方式提供线性一致的操作(本章稍后会讨论这些算法)。要正确实现租约和领导者选举,还有许多微妙细节,例如“分布式锁和租约”所述的栅栏问题。Apache Curator 等库在 ZooKeeper 之上封装了更高层的惯用方案,可以减轻这项工作;而所有这些协调任务的根基,仍是线性一致的存储服务。
严格来说,ZooKeeper 的写入满足线性一致性,但读取可能陈旧,因为它不保证读请求一定由当前领导者处理 18。从版本 3 开始,etcd 默认提供线性一致的读取。
一些分布式数据库还会在细得多的粒度上使用分布式锁,例如 Oracle Real Application Clusters(RAC)19。RAC 为每个磁盘页设置一把锁,多个节点共享同一套磁盘存储。由于这些线性一致的锁位于事务执行的关键路径上,RAC 部署通常会使用专用的集群互连网络,让数据库节点彼此通信。
约束与唯一性保证
唯一性约束在数据库中十分常见。例如,用户名或电子邮件地址必须唯一标识一位用户;文件存储服务也不能同时存在路径和文件名完全相同的两个文件。如果要在写入时强制执行这种约束——也就是说,两个人并发创建同名用户或文件时,必须让其中一人收到错误——就需要线性一致性。
这种情形其实与锁很相似:用户注册服务时,可以看作在获取所选用户名的“锁”。这个操作也很像原子的比较并设置:只要用户名尚未被占用,就把它设为认领该名称的用户 ID。
类似的问题还有很多:确保银行账户余额永不为负,商品销量不超过仓库库存,或不让两个人同时订到同一航班、同一剧场的同一个座位。这些约束都要求存在一个由所有节点共同认可的最新值,例如账户余额、库存数量或座位占用状态。
实际应用有时可以宽松处理此类约束。例如航班超售后,可以把旅客转到另一趟航班,并为造成的不便提供补偿。在这种情况下,线性一致性未必必要;“及时性与完整性”会进一步讨论这种宽松解释的约束。
不过,关系数据库里常见的硬性唯一约束确实需要线性一致性。外键约束、属性约束等其他约束则可以不依赖线性一致性来实现 20。
跨通道时序依赖
请注意图 10-1中的一个细节:如果 Aaliyah 没有喊出比分,Bryce 就不会知道自己的查询结果已经陈旧。他只会在几秒后再次刷新,并最终看到终场比分。之所以能察觉违反线性一致性的现象,只是因为系统里还有一条额外的通信通道——Aaliyah 的声音传到了 Bryce 耳中。
计算机系统中也会出现类似情形。假设某网站允许用户上传视频,后台进程会把视频转码为画质较低的版本,以便通过慢速网络流式播放。系统架构和数据流如图 10-5所示。
视频转码器必须收到明确指令才会执行转码作业,这条指令由 Web 服务器通过消息队列发送(参见“消息传递系统”)。Web 服务器不会把整段视频塞进队列,因为大多数消息代理是为短消息设计的,而视频可能有数十兆字节甚至更大。它会先把视频写入文件存储服务,确认写入完成后,再将转码指令放入队列。

如果文件存储服务满足线性一致性,这套系统就能正常工作;否则便可能出现竞态条件:消息队列(图 10-5中的步骤 3 和 4)也许比存储服务内部的复制传播得更快。这样一来,转码器获取原始视频时(步骤 5),可能读到文件的旧版本,甚至什么也读不到。如果它转码了旧版本,文件存储中的原始视频与转码版本就会永久不一致。
问题的根源在于,Web 服务器与转码器之间存在两条不同的通信通道:文件存储和消息队列。没有线性一致性提供的新鲜度保证,两条通道之间就可能发生竞态。这与图 10-1完全类似:一条通道是数据库复制,另一条则是从 Aaliyah 嘴里到 Bryce 耳中的现实声音。
能接收推送通知的移动应用也可能遇到类似竞态:应用收到通知后会向服务器获取相关数据;如果读请求可能落到滞后的副本上,推送通知也许很快就到了,紧随其后的数据读取却看不到通知所指的更新。
线性一致性不是避免这类竞态的唯一办法,却是最容易理解的一种。如果额外的通信通道由你控制——消息队列属于这种情况,Aaliyah 和 Bryce 之间的交流则不属于——也可以采用与“读己之写”类似的替代方案,只是系统会更加复杂。
实现线性一致性系统
看过线性一致性的几个用途后,接下来思考如何实现一个提供线性一致语义的系统。
线性一致性本质上要求系统“表现得仿佛只有一份数据,而且所有操作都原子地作用于它”,因此最简单的实现就是真的只保存一份数据。可惜这种方式无法容错:保存这份数据的节点一旦失效,数据就会丢失,至少也会在节点恢复前无法访问。
让我们重新审视第 6 章介绍的复制方法,看看它们能否实现线性一致性:
- 单主复制(可能线性一致)
- 在单主复制系统中,领导者保存用于写入的主副本,其他节点上的追随者则维护备份。只要所有读写都由领导者处理,通常就有可能满足线性一致性。但这依赖一个前提:你必须确切知道谁是领导者。正如“分布式锁和租约”所述,节点完全可能误以为自己仍是领导者;如果这个自以为是的领导者继续处理请求,就很可能破坏线性一致性 21。采用异步复制时,故障切换甚至可能丢失已经提交的写入,同时违反持久性与线性一致性。
对单主数据库进行分片、让每个分片拥有各自的领导者,不会影响线性一致性,因为它只保证单个对象。跨分片事务则是另一个问题(参见“分布式事务”)。
- 共识算法(很可能线性一致)
- 有些共识算法本质上是增加了自动领导者选举和故障切换的单主复制。它们经过精心设计以避免脑裂,因而能够安全实现线性一致的存储。例如,ZooKeeper 使用 Zab 共识算法 22,etcd 使用 Raft 23。不过,系统采用了共识,并不等于它的所有操作都满足线性一致性:如果某个节点处理读取前没有确认自己仍是领导者,那么在刚刚选出新领导者时,它就可能返回陈旧结果。
- 多主复制(非线性一致)
- 多主复制系统通常不满足线性一致性,因为多个节点会并发处理写入,再把结果异步复制到其他节点。因此,它们可能产生需要“处理写入冲突”的并发写入。
- 无主复制(很可能不满足线性一致性)
- 对于采用无主复制的系统(Dynamo 风格,参见“无主复制”),有人声称,只要要求仲裁读写满足 w + r > n,就能得到“强一致性”。这取决于具体算法以及“强一致性”的定义,但通常并不准确。
Cassandra 和 ScyllaDB 等系统采用基于日历时钟的“最后写入者胜”来解决冲突,这几乎肯定不满足线性一致性,因为时钟偏差使时间戳无法保证与事件的实际顺序一致(参见“对同步时钟的依赖”)。即使采用仲裁读写,仍然可能出现违反线性一致性的行为,下一节会给出例子。
线性一致性与仲裁
直觉上,Dynamo 风格模型中的仲裁读写似乎应当满足线性一致性。但当网络延迟变化不定时,仍然可能出现竞态,如图 10-6所示。

在图 10-6中,x 的初始值为 0。一个写入客户端把请求发往全部三个副本(n = 3,w = 3),要将 x 更新为 1。与此同时,客户端 A 从两个节点读取,达到读法定人数(r = 2),并在其中一个节点上看到了新值 1;同样与写入并发的客户端 B,则从另外两个节点读取,两个节点都返回旧值 0。
尽管满足法定人数条件 w + r > n,这次执行仍不满足线性一致性:B 的请求开始于 A 的请求完成之后,却返回了旧值,而 A 已经读到新值。(这又是图 10-1中 Aaliyah 和 Bryce 的情形。)
可以让 Dynamo 风格的法定人数读写满足线性一致性,但要牺牲性能:读取方必须先同步完成“追赶错过的写入”所述的读修复,再把结果返回应用 24;写入方则必须在写入前先读取达到法定人数的节点的最新状态,取得此前所有写入中的最大时间戳,并确保新写入使用更大的时间戳 25 26。Riak 因为性能代价而不执行同步读修复。Cassandra 的仲裁读确实会等待读修复完成 27,但它使用日历时钟生成时间戳,因而仍然不满足线性一致性。
而且,这种方式只能实现线性一致的读写;无法实现线性一致的比较并设置,因为后者需要共识算法 28。
总之,最稳妥的假设是:采用 Dynamo 风格复制的无主系统即使使用仲裁读写,也不提供线性一致性。
线性一致性的代价
既然有些复制方式能够提供线性一致性,有些不能,我们就有必要更仔细地考察它的利弊。
第 6 章已经讨论过不同复制方式的适用场景。例如,对多地区复制而言,多主复制往往是不错的选择(参见“跨地域运行”)。图 10-7展示了这样一种部署。

考虑两个地区之间网络中断时会发生什么。假设各地区内部的网络仍然正常,客户端也能访问本地区域,但两个地区彼此无法通信。这种情况称为 网络分区(network partition)。
在多主数据库中,每个地区都可以继续正常工作:一地的写入原本就异步复制到另一地,因此网络中断期间只需暂存排队,连接恢复后再相互交换。
若采用单主复制,领导者必然位于其中一个地区。所有写入和线性一致读取都必须发给领导者;因此,连接到追随者所在地区的客户端,必须跨地区同步地把读写请求发送到领导者所在地区。
单主配置下,一旦地区间网络中断,追随者所在地区的客户端便无法联系领导者,因而既不能写入数据库,也不能执行线性一致读取。它们仍可从追随者读取,但结果可能陈旧,不满足线性一致性。如果应用要求线性一致的读写,那么所有无法联系领导者的地区都会在网络中断期间变得不可用。
能直接连接领导者所在地区的客户端不受影响,应用在那里仍可正常工作;但只能访问追随者所在地区的客户端会一直停摆,直到网络链路修复。
CAP 定理
这个问题并非单主复制与多主复制特有:任何线性一致的数据库,无论怎样实现,都会面对同样的困境。它也不限于多地区部署;任何不可靠的网络都可能发生这种情况,即使是在同一地区内。具体权衡如下:
- 如果应用 要求 线性一致性,而网络故障使一部分副本与其他副本失去联系,那么断开的副本就不能继续处理请求:它们只能等待网络恢复,或立即返回错误;无论哪种方式,都变得 不可用。这种选择有时称为 CP(网络分区时保持一致)。
- 如果应用 不要求 线性一致性,就可以让各副本在彼此断开时仍独立处理请求,例如采用多主复制。这样,应用在网络故障期间仍然 可用,但行为不满足线性一致性。这种选择称为 AP(网络分区时保持可用)。
因此,不要求线性一致性的应用可以更好地容忍网络问题。这一认识通常称为 CAP 定理 29 30 31 32,由 Eric Brewer 于 2000 年命名,不过早在 20 世纪 70 年代,分布式数据库设计者就已了解这种权衡 33 34 35。
CAP 最初只是一个没有精确定义的经验法则,目的是引发对数据库权衡的讨论。当时许多分布式数据库都专注于在共享存储的机器集群上提供线性一致语义 19;CAP 则鼓励数据库工程师探索更广阔的分布式无共享系统设计空间,而后者更适合承载大规模 Web 服务 36。CAP 推动了这种观念转变,也帮助催生了 NoSQL 运动以及 21 世纪头十年中期涌现的大批新型数据库技术。
CAP 有时被概括成 一致性、可用性、分区容错性,三者择二。遗憾的是,这种说法会误导人 32:网络分区是一类故障,并不是可以自由取舍的选项——不管你愿不愿意,它都会发生。
网络正常时,系统完全可以同时提供一致性(线性一致性)与全面可用性;发生网络故障时,才必须在线性一致性和全面可用性之间取舍。因此,更准确的说法是:发生分区时,要么一致,要么可用 37。网络越可靠,面临这种选择的次数就越少,但它终究无法彻底避免。
CP/AP 分类还有几个缺陷 4。其中的 一致性 被严格定义为线性一致性,定理对较弱的一致性模型只字未提;可用性 的形式化定义 30 也不符合这个词的通常含义 38。许多通常认为高度可用、具备容错能力的系统,其实并不满足 CAP 那套特殊的可用性定义。还有些系统设计者出于充分理由,既不提供线性一致性,也不提供 CAP 所假设的那种可用性,因此既不能归为 CP,也不能归为 AP 39 40。
总而言之,围绕 CAP 的误解与混淆太多,它无助于我们更好地理解系统,因此最好避免使用 CAP 这一框架。
形式化的 CAP 定理 30 适用范围极窄:它只考察一种一致性模型(线性一致性)和一种故障(网络分区;Google 的数据表明,网络分区造成的事故不到 8% 41),对网络延迟、节点失效以及其他权衡都没有说明。因此,CAP 虽然在历史上影响深远,对实际系统设计却几乎没有指导价值 4 38。
有人尝试把 CAP 推广到更一般的情形。例如,PACELC 原则 指出,即便网络正常,系统设计者也可能为了降低延迟而削弱一致性 39 40 42:发生网络分区(P)时,需要在可用性(A)与一致性(C)之间选择;否则(E),没有分区时,则可能在低延迟(L)与一致性(C)之间选择。不过,这个定义继承了 CAP 的若干问题,例如对一致性和可用性的定义仍然有违直觉。
分布式系统领域还有许多更有意义的不可能性结论 43,CAP 也早已被更精确的结果取代 44 45。如今,它主要只剩下历史意义。
线性一致性与网络延迟
线性一致性虽然很有用,实际满足它的系统却少得出人意料。甚至现代多核 CPU 上的 RAM 也不满足线性一致性 46:一个 CPU 核上的线程写入某个内存地址后,另一个核上的线程稍晚读取同一地址,也不保证能看见前一个线程写入的值,除非使用 内存屏障 或 栅栏 47。
原因在于,每个 CPU 核都有自己的缓存和存储缓冲区。默认情况下,内存访问会先经过缓存,修改再异步写回主存。访问缓存远快于访问主存 48,因此这种机制对现代 CPU 的性能不可或缺。但系统里也因此出现了多份数据——主存中一份,各级缓存里可能还有几份——而且它们异步更新,于是失去了线性一致性。
为什么要作这种取舍?用 CAP 定理解释多核处理器的内存一致性模型毫无意义:在同一台计算机内,我们通常假定通信可靠,也不指望某个 CPU 核与计算机其他部分断开后还能正常工作。这里牺牲线性一致性是为了 性能,而不是容错 39。
许多不提供线性一致性保证的分布式数据库也是如此:主要目的是提高性能,而非增强容错 42。线性一致性很慢,而且始终如此,并非只在网络故障时才慢。
有没有更高效的线性一致存储实现?答案似乎是否定的。Attiya 和 Welch 49 证明:要获得线性一致性,读写请求的响应时间至少与网络延迟的不确定程度成正比。在大多数计算机网络这种延迟高度不稳定的环境里(参见“超时和无界延迟”),线性一致读写的响应时间必然很高。不存在更快的线性一致性算法,而较弱的一致性模型却可以快得多,因此这种取舍对延迟敏感型系统十分重要。“及时性与完整性”将讨论如何在不牺牲正确性的前提下绕开线性一致性。
ID 生成器和逻辑时钟
许多应用在创建数据库记录时,都要为其分配某种唯一 ID,作为以后引用该记录的主键。单节点数据库通常使用自增整数,它的优点是只需 64 位即可存储;如果能确定记录数永远不会超过 40 亿,甚至可以只用 32 位,不过这样做颇有风险。
自增 ID 还有一个好处:ID 顺序可以反映记录的创建顺序。例如,图 10-8中的聊天应用会在消息发出时为其分配自增 ID。按 ID 递增顺序展示消息,对话就能保持合理的先后关系:Aaliyah 的问题得到 ID 1,而 Bryce 随后的回答得到更大的 ID 3。

这种单节点 ID 生成器也是一个线性一致系统。每次取 ID 都会原子地递增计数器并返回递增前的值,这称为 获取并增加(fetch-and-add)操作。线性一致性保证:如果 Aaliyah 的消息在 Bryce 开始发消息之前已经发布完成,那么 Bryce 的 ID 必须更大。图 10-8中 Aaliyah 与 Caleb 的消息彼此并发,因此线性一致性不规定二者的 ID 顺序,只要求它们互不相同。
内存中的单节点 ID 生成器很容易实现:直接使用 CPU 提供的原子递增指令,就能让多个线程安全地更新同一个计数器。要把计数器做成持久的稍微麻烦一些,否则节点崩溃重启后计数器会复位,产生重复 ID。但更棘手的问题是:
- 单节点 ID 生成器不具备容错能力,因为这个节点本身就是单点故障。
- 如果要在另一个地区创建记录,仅仅为了取得 ID,可能就得跨越半个地球往返一次,速度很慢。
- 写入吞吐量很高时,这个节点可能成为瓶颈。
ID 生成器还有几种替代方案:
- 分片 ID 分配
- 可以让多个节点分别分配 ID,例如一个只生成偶数,另一个只生成奇数。更一般地,可以在 ID 中预留若干位来保存分片编号。这种 ID 仍然紧凑,却失去了顺序含义:看到 ID 为 16 和 17 的两条聊天消息,并不能断定消息 16 先发出,因为两个 ID 来自不同节点,而其中一个节点的进度可能领先于另一个。
- 预分配 ID 块
- 单节点生成器不必逐个发放 ID,也可以一次分配一整块。例如,节点 A 取得 1 到 1,000,节点 B 取得 1,001 到 2,000;此后各节点可在自己的区间内独立发号,快用完时再申请下一块。但这种方案同样无法保证正确顺序:一条消息可能先从 1,001 到 2,000 的区间取得 ID,而稍后另一节点发出的消息却从 1 到 1,000 的区间取得了更小的 ID。
- 随机 UUID
- 可以采用 通用唯一标识符(UUID),也称 全局唯一标识符(GUID)。它最大的好处是,任意节点都能在本地生成,无需通信;代价是占用更多空间(128 位)。UUID 有多个版本,最简单的第 4 版本质上是一个足够长的随机数,两个节点碰巧选中同一值的概率微乎其微。可惜这类 ID 的顺序也是随机的,比较两个 ID 无法判断哪个更新。
- 为日历时钟时间戳补充唯一性信息
- 如果各节点通过 NTP 让日历时钟大致准确,可以把时间戳放在 ID 的高位,再用额外信息填充其余位,保证即使时间戳相同,完整 ID 仍然唯一。例如,可以加入分片编号和分片内自增序列号,或一段足够长的随机值。第 7 版 UUID 50、Twitter Snowflake 51、ULID 52、Hazelcast Flake ID 生成器、MongoDB ObjectID 等许多方案都采用这种思路 50。这类 ID 生成器既可以在应用代码中实现,也可以放在数据库内部 53。
这些方案都能生成唯一 ID——至少碰撞概率低到几乎可以忽略——但它们提供的顺序保证远弱于单节点自增方案。
正如“用于事件排序的时间戳”所述,日历时钟时间戳至多只能给出近似顺序:如果较早的写入读取了略快的时钟,较晚的写入读取了略慢的时钟,时间戳顺序就可能与事件实际顺序相反。非单调时钟还可能突然跳变,甚至让同一节点生成的时间戳顺序出错。因此,基于日历时钟的 ID 生成器通常不满足线性一致性。
使用原子钟或 GPS 接收器进行高精度时钟同步,可以减少这种顺序错乱。但如果无需特殊硬件,也能生成唯一且顺序正确的 ID,当然更好。这正是 逻辑时钟(logical clock)要解决的问题。
逻辑时钟
在“不可靠的时钟”中,我们讨论了日历时钟和单调时钟。二者都属于 物理时钟,度量的是经过了多少秒(或毫秒、微秒等)。
分布式系统还经常使用另一类时钟,称为 逻辑时钟(logical clock)。物理时钟是计算流逝秒数的硬件设备;逻辑时钟则是一种计算已发生事件数量的算法。因此,逻辑时间戳不能告诉你现在是几点,却 可以 相互比较,判断哪个较早、哪个较晚。
逻辑时钟的要求通常是:
- 时间戳紧凑(只有几个字节)且唯一;
- 任意两个时间戳都可以比较,也就是构成 全序;
- 时间戳顺序与因果关系 一致:如果操作 A 先于 B 发生,那么 A 的时间戳小于 B 的时间戳。(我们在“‘先发生’关系与并发”中讨论过因果关系。)
单节点 ID 生成器满足这些要求,而前面几种分布式 ID 生成器不满足因果顺序要求。
Lamport 时间戳
幸运的是,有一种简单方法可以生成与因果关系 一致 的逻辑时间戳,并将其用作分布式 ID。这就是 Leslie Lamport 于 1978 年提出的 Lamport 时钟 54;介绍它的论文如今已成为分布式系统领域引用次数最多的论文之一。
图 10-9展示了 Lamport 时钟如何用于图 10-8中的聊天示例。每个节点都有唯一标识符;图 10-9使用“Aaliyah”“Bryce”和“Caleb”作为标识,实际系统则可以使用随机 UUID 等值。此外,每个节点维护一个计数器,记录自己处理过多少次操作。Lamport 时间戳就是一个二元组(计数器,节点 ID)。不同节点的计数器值有时相同,但加入节点 ID 后,每个时间戳仍然唯一。

节点每生成一次时间戳,都会先递增本地计数器并使用新值。节点每次看到其他节点生成的时间戳时,如果其中的计数器值大于自己的本地值,就把本地计数器向前推进到同一个值。
在图 10-9中,Aaliyah 发出自己的消息时尚未看见 Caleb 的消息,Caleb 也一样。假设两人的计数器初始值都是 0,他们各自将其递增为 1,并把新值附在消息上。Bryce 收到这两条消息后,把自己的计数器推进到 1;随后他回复 Aaliyah 的消息,再把本地计数器递增为 2,并将 2 附在回复上。
比较两个 Lamport 时间戳时,先比较计数器值。例如,(2, “Bryce”) 大于 (1, “Aaliyah”),也大于 (1, “Caleb”)。若计数器相同,再按通常的字符串字典序比较节点 ID。因此,本例中的时间戳顺序为 (1, “Aaliyah”) < (1, “Caleb”) < (2, “Bryce”)。
混合逻辑时钟
Lamport 时间戳很适合表示事件发生顺序,但也有一些局限:
- 它与物理时间没有直接关系,所以无法据此查找某个具体日期发布的所有消息;物理时间必须另行保存。
- 如果两个节点从不通信,一个节点的计数器增长就永远不会反映到另一个节点上。因此,不同节点在大致同一时刻生成的事件,计数器值可能相差悬殊。
混合逻辑时钟(hybrid logical clock,HLC)兼具物理日历时钟的优点与 Lamport 时钟的顺序保证 55。它像物理时钟一样以秒或微秒计数;又像 Lamport 时钟一样,在看到其他节点更大的时间戳时,把自己的本地值向前推进到对方的时间戳。因此,如果某个节点的时钟偏快,其他节点与它通信后也会相应地把时钟向前推进。
混合逻辑时钟每次生成时间戳时也会递增,从而保证始终单调向前,即使底层物理时钟因 NTP 校正而向后跳变也不例外。因此,混合逻辑时钟可能略微领先于底层物理时钟;算法会尽量把这项误差控制在最小范围内。
因此,混合逻辑时间戳几乎可以像普通日历时间戳一样使用,同时还多了一项性质:其顺序与先发生关系一致。它不依赖特殊硬件,只要求各时钟大致同步。CockroachDB 就使用了混合逻辑时钟。
Lamport/混合逻辑时钟 vs. 向量时钟
在“多版本并发控制(MVCC)”中,我们讨论过快照隔离的一种常见实现:为每个事务分配事务 ID,让它看见 ID 较小的事务所做的写入,同时隐藏 ID 较大的事务所做的写入。Lamport 时钟和混合逻辑时钟很适合生成这些事务 ID,因为它们可以保证快照与因果关系一致 56。
多个时间戳并发生成时,这些算法会任意规定它们之间的顺序。因此,只看两个时间戳,通常无法判断二者是并发生成,还是一个先于另一个发生。(在图 10-9中,因为 Aaliyah 与 Caleb 的消息具有相同计数器值,可以断定它们彼此并发;但计数器值不同时,就无法作出这种判断。)
如果需要判断记录是否并发创建,就得采用另一种算法,例如 向量时钟(vector clock)。它的缺点是时间戳大得多,可能需要为系统中的每个节点保存一个整数。有关并发检测的更多细节,参见“检测并发写入”。
线性一致的 ID 生成器
Lamport 时钟与混合逻辑时钟虽然提供了实用的顺序保证,却仍弱于前面那种线性一致的单节点 ID 生成器。回想一下,线性一致性要求:只要请求 A 在请求 B 开始前已经完成,B 的 ID 就必须更大,即使二者从未彼此通信。Lamport 时钟只能保证节点新生成的时间戳大于它此前 见过 的所有时间戳,对未曾见过的时间戳则无法作出任何保证。
图 10-10展示了不满足线性一致性的 ID 生成器会造成什么问题。假设某个社交网站的用户 A 想把一张难为情的照片只分享给朋友。A 的账户原本公开;A 先在笔记本电脑上把账户设为私密,随后又用手机上传照片。这些操作由 A 依次完成,因此 A 有理由认为,上传的照片会受新的私密账户权限保护。

账户权限与照片保存在两个独立数据库中(也可能是同一数据库的不同分片),并假设二者都用 Lamport 时钟或混合逻辑时钟为写入分配时间戳。照片数据库没有读取账户数据库,因此它的本地计数器可能稍微落后,导致照片上传得到的时间戳反而小于账户设置更新的时间戳。
接着,假设一位并非 A 好友的访客正在浏览 A 的个人资料,而这次读取由实现快照隔离的 MVCC 处理。访客读取的时间戳可能大于照片上传,却小于账户权限更新。系统于是认定,在这个快照中账户仍是公开的,并把本不该让访客看到的照片显示出来。
这个问题有几种可能的修复方式。也许照片数据库应在写入前读取用户账户状态,但开发者很容易漏掉这项检查。如果 A 的所有操作都来自同一台设备,设备上的应用或许能跟踪该用户最近一次写入的时间戳;可本例中用户同时使用笔记本电脑和手机,事情就没那么简单。
这里最简单的解决方案,是使用线性一致的 ID 生成器,保证照片上传取得的 ID 一定大于账户权限变更的 ID。
实现线性一致的 ID 生成器
确保 ID 分配满足线性一致性的最简单办法,确实是使用单个节点。这个节点只需在收到请求时原子递增计数器并返回结果,同时持久化计数器值,以免崩溃重启后产生重复 ID,再用单主复制实现容错。实际系统也采用这种方案:受 Google Percolator 57 启发,TiDB/TiKV 将其称为 时间戳预言机(timestamp oracle)。
可以通过批量预留来避免每次请求都写盘和复制。ID 生成器先写入一条记录,声明某一批 ID;这条记录持久化并完成复制后,节点便可按顺序把其中的 ID 发给客户端。在这一批快要用完前,再提前持久化并复制下一批。这样,节点崩溃重启或故障切换到追随者时,可能会跳过一些 ID,却绝不会发出重复或顺序错误的 ID。
ID 生成器很难分片:多个分片独立发号后,就无法再保证整体顺序满足线性一致性。它也很难分布到多个地区,因此地理分布式数据库中的所有 ID 请求,都得发往某个固定地区的节点。好在 ID 生成器的工作十分简单,单个节点就能承担很高的请求吞吐量。
如果不想采用单节点 ID 生成器,还有 Google Spanner 的做法,参见“用于全局快照的同步时钟”。它依赖一种物理时钟:返回的不是单个时间戳,而是一个时间戳区间,表示时钟读数的不确定性;系统会等待这个不确定区间完全过去之后再返回结果。
只要不确定区间确实可靠——真实物理时间始终落在区间内——这个过程同样能保证:若一个请求在另一个请求开始前完成,后一个请求就取得更大的时间戳。它无需节点间通信就能实现线性一致的 ID 分配;即使请求来自不同地区,也能正确排序,不必等待跨地区往返。代价是必须有相应的软硬件支持,既要让时钟高度同步,又要计算必要的不确定区间。
使用逻辑时钟强制约束
在“约束与唯一性保证”中,我们看到,线性一致的比较并设置可以用来实现分布式锁、唯一性约束等构造。于是自然会问:逻辑时钟或线性一致的 ID 生成器,是否也足以实现这些功能?
答案是:还不够。若多个节点都在争抢同一把锁或注册同一个用户名,可以用逻辑时钟为请求分配时间戳,并选出时间戳最小者。如果时钟满足线性一致性,那么此后所有请求生成的时间戳都更大,也就不可能再出现比当前胜者更小的时间戳。
可惜问题还有一半没有解决:节点怎样知道自己的时间戳就是最小的?要做到确定无疑,它必须收到 每一个 可能生成时间戳的其他节点的消息 54。只要其中一个节点失效,或因网络问题无法联系,整个系统就会停滞,因为谁也无法排除那个节点拥有更小时间戳的可能。这显然不是我们想要的容错系统。
要以容错方式实现锁、租约等构造,需要比逻辑时钟或 ID 生成器更强的工具:我们需要共识。
共识
本章已经见过好几个例子:只用单个节点时,事情十分简单;一旦还要求容错,就会困难得多:
- 只设一个领导者,并让所有读写都由它处理,数据库便可以具有线性一致性。可是,如果这个领导者失效,怎样才能在避免脑裂的同时完成故障切换?怎样确保某个自认为仍是领导者的节点,其实没有在此期间被投票罢免?
- 单节点上的线性一致 ID 生成器,不过是一个带有原子“获取并增加”指令的计数器;但如果这个节点崩溃了呢?
- 原子比较并设置(CAS)操作用途广泛:例如,多个进程争抢锁或租约时决定谁能获得它,或者确保给定名称的文件或用户具有唯一性。在单个节点上,CAS 可能只需一条 CPU 指令;但怎样才能让它容错?
事实证明,这些都是同一个分布式系统基本问题的不同实例:共识(consensus)。共识是分布式计算中最重要、最基本的问题之一;同时,它也出了名地难以正确实现 58 59,许多系统都曾在这里栽过跟头。至此,我们已经讨论过复制(第 6 章)、事务(第 8 章)、系统模型(第 9 章)以及线性一致性(本章),终于可以正面处理共识问题了。
最著名的共识算法包括视图戳复制(Viewstamped Replication,VSR)60 61、Paxos 58 62 63 64、Raft 23 65 66 和 Zab 18 22 67。这些算法有不少相似之处,但并不完全相同 68 69。它们采用非拜占庭系统模型:网络通信可以被任意延迟或丢弃,节点可以崩溃、重启或断开连接;但除此之外,算法假定节点都会正确遵守协议,不会采取恶意行为。
另一些共识算法可以容忍一部分拜占庭节点,也就是不正确遵守协议的节点(例如,它们会向不同节点发送相互矛盾的消息)。这类算法通常假定,出现拜占庭故障的节点少于三分之一 26 70。这样的 拜占庭容错(BFT)共识算法会用于区块链 71。不过,正如 “拜占庭故障” 所述,BFT 算法不在本书的讨论范围之内。
你可能听说过 FLP 结果 72——这个名字取自三位作者 Fischer、Lynch 和 Paterson。它证明:只要存在节点崩溃的可能,就没有一种算法能保证 始终 达成共识。分布式系统必须假定节点可能崩溃,这岂不是意味着可靠的共识根本不可能?可我们现在又在讨论实现共识的算法,这究竟是怎么回事?
首先,FLP 并没有说共识永远无法达成,只是说我们无法保证共识算法 每次都能 终止。此外,FLP 的证明针对异步系统模型中的确定性算法(见 “系统模型与现实”),也就是说,算法不能使用任何时钟或超时。只要允许算法根据超时怀疑另一个节点可能已经崩溃——哪怕这种怀疑偶尔会出错——共识就变得可以解决 73。甚至只需允许算法使用随机数,也足以绕过这个不可能性结果 74。
因此,尽管 FLP 的共识不可能性结果在理论上极为重要,分布式系统在实践中通常仍能达成共识。
共识的多面性
共识可以用几种不同的方式表达:
- 单值共识(single-value consensus)与原子 比较并设置 操作非常相似,可以用来实现锁、租约和唯一性约束。
- 构建 仅追加日志(append-only log)同样需要共识;这个问题通常形式化为 全序广播(total order broadcast)。有了日志,就可以构建 状态机复制(state machine replication)、基于领导者的复制、事件溯源以及其他许多有用的机制。
- 多数据库或多分片事务的 原子提交(atomic commitment),要求所有参与者就是否提交或中止事务达成一致。
下面很快就会逐一探讨这些形式。事实上,这几个问题彼此等价:只要有一种算法能解决其中一个问题,就可以把它转换成其他任意一种问题的解法。这是一个相当深刻、甚至有些出人意料的洞见!也正因为如此,尽管它们表面上截然不同,我们仍可以把它们统统归入“共识”这一范畴。
单值共识
共识的标准表述涉及让多个节点就单个值达成一致。例如:
- 采用单主复制的数据库初次启动时,或现有领导者失效时,可能有多个节点同时试图成为领导者。同样,多个节点也可能竞相获取同一把锁或同一份租约。共识可以帮助它们决定由谁胜出。
- 如果几个人同时试图预订飞机上的最后一个座位、剧院里的同一个座位,或用相同的用户名注册账户,共识算法可以确定哪一个请求应当成功。
更一般地说,一个或多个节点可以 提议 某个值,而共识算法从中 决定 一个值。在上述例子中,每个节点都可以提议自己的 ID,算法则决定哪个节点 ID 应当成为新的领导者、租约持有者或机票/戏票的购买者。在这种形式化定义下,共识算法必须满足以下属性 26:
- 一致同意
- 任意两个节点都不会作出不同的决定。
- 完整性
- 节点一旦决定了某个值,就不能再决定另一个值来改变主意。
- 有效性
- 如果某个节点决定了值 v,那么 v 必须由某个节点提议过。
- 终止
- 每个未崩溃的节点最终都能决定某个值。
如果需要决定多个值,可以为每个值分别运行一个共识算法实例。例如,可以为剧院中每个可预订的座位分别运行一次共识,从而为每个座位作出一项决定(确定一位买家)。
一致同意与完整性定义了共识的核心思想:所有节点都决定相同的结果,而且一旦作出决定,就不能再改变主意。有效性排除了平凡的解法:例如,无论节点提议什么,算法都一律决定 null;这种算法满足一致同意与完整性,却不满足有效性。
如果不关心容错,满足前三个属性很容易:只需把一个节点硬编码为“独裁者”,由它作出所有决定即可。但这个节点一旦失效,系统便再也无法作出任何决定——这与没有故障切换的单主复制如出一辙。所有困难都源于容错这一要求。
终止属性形式化了容错的含义。它实质上要求共识算法不能永远无所作为——换句话说,算法必须取得进展。即使一部分节点失效,其余节点仍须作出决定。(终止是一种活性属性,另外三种则是安全属性,见 “安全性与活性”。)
如果崩溃的节点还有可能恢复,当然可以等它回来。然而,共识必须保证,即使某个节点突然消失而且永远不再回来,系统仍能作出决定。(不要只想象软件崩溃;想象一场地震引发山体滑坡,彻底摧毁了节点所在的数据中心。必须假定这个节点被埋在 30 英尺深的泥土下,再也不会重新上线。)
当然,如果 所有 节点都已崩溃,无一仍在运行,那么任何算法都不可能决定任何事情。算法能容忍的故障数量存在上限:事实上,可以证明,任何共识算法都要求至少多数节点正常运行,才能保证终止 73。这组多数节点可以安全地构成法定人数(见 “读写仲裁”)。
因此,终止属性以少于一半节点崩溃或不可达为前提。不过,即使多数节点失效,或网络出现严重问题,大多数共识算法仍能保证安全属性——一致同意、完整性与有效性——始终成立 75。所以,大规模中断可能令系统无法处理请求,却不能迫使共识系统作出彼此矛盾的决定,从而破坏其正确性。
比较并设置作为共识
比较并设置(CAS)操作会检查某个对象的当前值是否等于预期值。如果相等,它就以原子方式把对象更新为新值;否则保持对象不变并返回错误。
有了容错且线性一致的 CAS 操作,就很容易解决共识问题:先把对象设为空值;每个想提议某个值的节点都调用 CAS,把预期值设为空,把新值设为自己要提议的值(假定该值非空)。对象最终被设成什么值,共识决定的就是什么值。
反过来,有了共识的解法,也可以实现 CAS:每当一个或多个节点想以相同的预期值执行 CAS 时,就通过共识协议提议各次 CAS 调用中的新值,再把对象设为共识所决定的值。新值未获选中的 CAS 调用返回错误。预期值不同的 CAS 调用,则分别运行共识协议。
由此可见,CAS 与共识彼此等价 28 73。两者在单个节点上都很简单,难点都在于如何实现容错。我们曾在 “以对象存储为后端的数据库” 中见过分布式环境下的 CAS:对象存储的条件写入操作只有在当前客户端上次读取之后,同名对象没有被其他客户端创建或修改时,才允许写入发生。
不过,线性一致的读写寄存器不足以解决共识。FLP 结果表明,在异步崩溃停止模型中,确定性算法无法解决共识 72;但我们在 “线性一致性与仲裁” 中看到,线性一致的寄存器可以在这一模型下通过法定人数读写来实现 24 25 26。由此可以推知,线性一致的寄存器无法解决共识。
共享日志作为共识
我们已经见过多种日志,例如复制日志、事务日志和预写日志。日志存储一系列 日志条目(log entry),任何读取者都会以相同顺序看到相同的条目。有时,只有一个写入者有权向日志追加新条目;而在 共享日志(shared log)中,多个节点都可以请求追加条目。单主复制就是一个例子:任何客户端都可以请求领导者执行写入,领导者把写入追加到复制日志,随后所有追随者都按照与领导者相同的顺序应用这些写入。
更形式化地说,共享日志支持两种操作:请求把一个值加入日志,以及读取日志条目。它必须满足以下属性:
- 最终追加
- 如果某个节点请求把一个值加入日志,而且该节点没有崩溃,那么它最终必须能在某条日志条目中读到这个值。
- 可靠交付
- 日志条目不会丢失:如果某个节点读到了某条日志条目,那么每个未崩溃的节点最终也必须读到它。
- 仅追加
- 节点一旦读到某条日志条目,该条目便不可再改变;新条目只能追加在它之后,不能插入它之前。节点重新读取日志时,必须以初次读取时的相同顺序看到相同条目,即使它曾经崩溃并重启也不例外。
- 一致性
- 如果两个节点都读到了某条日志条目 e,那么在 e 之前,它们必须以相同顺序读到完全相同的日志条目序列。
- 有效性
- 如果某个节点读到了一条包含某值的日志条目,那么此前必有某个节点请求把这个值加入日志。
有了共享日志的实现,就很容易解决共识问题:每个想提议某个值的节点都请求把它加入日志,而第一条日志条目中读出的值就是决定值。由于所有节点都按相同顺序读取日志条目,它们必然会就哪个值最先交付达成一致 28。
反过来,有了共识的解法,也可以实现共享日志。具体细节稍显复杂,但基本思路如下 73:
- 为日志中每个未来的条目预留一个槽位,并为每个槽位分别运行一个共识算法实例,以决定该条目应当包含什么值。
- 节点想向日志加入某个值时,就为一个尚未决定的槽位提议这个值。
- 共识算法为某个槽位作出决定,而且此前所有槽位也都已有决定后,就把决定值追加为新的日志条目;其后所有已经连续作出决定的槽位,其决定值也一并追加到日志。
- 如果提议值没有被某个槽位选中,想加入这个值的节点就改为向后面的槽位重新提议。
这说明,共识等价于全序广播,也等价于共享日志。没有故障切换的单主复制不满足活性要求,因为领导者一旦崩溃,系统就会停止交付消息。一如既往,真正的挑战在于如何安全、自动地完成故障切换。
获取并增加作为共识
我们在 “线性一致的 ID 生成器” 中看到,线性一致的 ID 生成器距离解决共识只差一步,却终究还差一点。这样的 ID 生成器可以用“获取并增加”操作实现:它以原子方式递增计数器,并返回计数器的旧值。
有了 CAS 操作,实现获取并增加很容易:先读取计数器的值,再执行一次 CAS,把预期值设为刚才读到的值,把新值设为旧值加一。如果 CAS 失败,就从头重试,直到成功为止。存在争用时,这种实现不如原生的获取并增加操作高效,但两者在功能上等价。既然共识可以实现 CAS,自然也可以实现获取并增加。
反过来,如果有了容错的获取并增加操作,能否解决共识?假设计数器初值为零,每个想提议某个值的节点都调用获取并增加来递增计数器。由于这项操作具有原子性,其中一个节点会读到初始值零,其他节点读到的值则都至少已经递增过一次。
现在规定,读到零的节点胜出,其提议值成为决定值。这对读到零的节点当然没问题,其他节点却陷入了困境:它们知道自己没有胜出,却不知道其他节点中究竟谁赢了。胜者可以发消息告知其他节点,但如果它还没来得及发送消息就崩溃了呢?其余节点将一直悬而未决,无法决定任何值,共识也就不能终止。它们也不能改选另一个节点,因为读到零的节点日后仍可能恢复,并有充分理由决定自己提议的值。
有一个例外:我们能够确定提议值的节点不超过两个。此时,两个节点可以先互相发送各自的提议值,再分别执行获取并增加。读到零的节点决定自己的值,读到一的节点则决定另一个节点的值。这样就解决了两个节点之间的共识问题,因此我们说获取并增加的 共识数(consensus number)为二 28。相比之下,CAS 和共享日志可以在任意数量的节点提议值时解决共识,所以它们的共识数为 ∞(无穷大)。
原子提交作为共识
在 “分布式事务” 中,我们见过 原子提交(atomic commitment)问题:参与分布式事务的所有数据库或分片,要么全都提交事务,要么全都中止。我们还见过 两阶段提交(two-phase commit,2PC)算法,它依赖一个构成单点故障的协调者。
共识与原子提交是什么关系?乍看之下,两者十分相似——都要求节点达成某种一致。不过,它们之间存在一项重要区别:共识可以决定任意一个被提议的值;原子提交则要求,只要 任何 参与者投票中止,算法就 必须 中止。更准确地说,原子提交必须满足以下属性 78:
- 一致同意
- 任意两个节点都不会决定不同的结果。
- 完整性
- 节点一旦决定了某个结果,就不能再决定另一个结果来改变主意。
- 有效性
- 如果某个节点决定提交,那么此前所有节点都必须投票提交;只要任何节点投票中止,所有节点都必须中止。
- 非平凡性
- 如果所有节点都投票提交,而且没有发生通信超时,那么所有节点都必须决定提交。
- 终止
- 每个未崩溃的节点最终都能决定提交或中止。
有效性确保事务只有在所有节点都同意时才能提交;非平凡性则确保算法不能简单地一律中止(但只要节点间发生任何通信超时,它就允许中止)。另外三项属性与共识基本相同。
有了共识的解法,可以用多种方式解决原子提交 78 79。其中一种做法如下:准备提交事务时,每个节点把自己的提交或中止票发送给其他所有节点。某个节点如果收到自己以及所有其他节点的提交票,就通过共识算法提议“提交”;如果收到中止票或遇到超时,就通过共识算法提议“中止”。节点得知共识算法的决定后,再据此提交或中止事务。
在这种算法中,只有所有节点都投票提交,才可能有人提议“提交”。只要有任何节点投票中止,共识算法收到的所有提议都会是“中止”。如果所有节点都投票提交,但部分通信发生超时,就可能有些节点提议“中止”,另一些节点提议“提交”;这时最终提交还是中止并不重要,只要所有节点采取相同的决定即可。
反过来,有了容错的原子提交协议,也可以解决共识。每个想提议某个值的节点都在一组法定人数节点上发起事务,并在每个节点上执行一次单节点 CAS:如果寄存器尚未被另一个事务设值,就将其设为本节点的提议值。CAS 成功时节点投票提交,否则投票中止。如果原子提交协议决定提交这个事务,其值就成为共识的决定值;如果原子提交中止,提议节点就用一个新事务重试。
由此可见,原子提交与共识也彼此等价。
共识的实践
前面已经看到,单值共识、CAS、共享日志与原子提交彼此等价:其中任意一个问题的解法,都可以转换为其他问题的解法。这个理论洞见很有价值,却没有回答一个实际问题:共识有这么多种表述,实践中究竟哪一种最有用?
答案是:大多数共识系统都提供共享日志,也就是全序广播。Raft、视图戳复制和 Zab 直接提供共享日志;Paxos 提供的是单值共识,但实践中,采用 Paxos 的系统大多使用名为 Multi-Paxos 的扩展,它同样提供共享日志。
使用共享日志
共享日志与数据库复制十分契合:如果每条日志条目都代表一次数据库写入,而每个副本都以相同顺序、使用确定性逻辑处理相同的写入,那么所有副本最终都会处于一致状态。这个思想称为 状态机复制(state machine replication)80,也是我们在 “事件溯源与 CQRS” 中见过的事件溯源原理。共享日志对流处理也很有用,我们将在 第 12 章 看到这一点。
类似地,共享日志还可以实现可串行化事务。正如 “实际串行执行” 所述,如果每条日志条目都代表一个将以存储过程形式执行的确定性事务,而且每个节点都以相同顺序执行这些事务,那么事务就是可串行化的 81 82。
采用强一致性模型的分片数据库,通常会为每个分片分别维护一份日志。这样做提高了可伸缩性,却也限制了数据库能跨分片提供的一致性保证(例如一致快照与外键引用)。跨分片的可串行化事务并非不能实现,但需要额外协调 83。
共享日志的另一个强大之处在于,它很容易改造成其他形式的共识:
- 前面已经说明怎样用它实现单值共识和 CAS:只需决定日志中最先出现的值。
- 如果需要许多个单值共识实例(例如,剧院里每个被多人争订的座位各一个实例),可以在日志条目中写入座位号,并以包含该座位号的第一条日志条目作为决定。
- 如果需要原子的获取并增加操作,可以把要加到计数器上的数字写进日志条目;计数器的当前值就是截至目前所有日志条目中数字的总和。还可以对日志条目简单计数,以此生成栅栏令牌(见 “用栅栏机制隔离僵尸与延迟请求”)。例如,在 ZooKeeper 中,这个序列号称为
zxid18。
从单主复制到共识
前面已经看到,如果由一个“独裁者”节点作出决定,单值共识就很容易;类似地,如果只有一个领导者有权向共享日志追加条目,共享日志也很容易实现。问题在于:这个节点失效时,怎样才能实现容错?
传统的单主复制数据库并没有解决这个问题,而是把领导者故障切换留给管理员手工操作。人类的反应速度终究有限,这种方式难免造成相当长的停机时间,也不满足共识的终止属性。共识要求算法能够自动选出新的领导者。(并非所有共识算法都有领导者,但常用算法通常都有 84。)
然而,这里有一个难题。前面讨论脑裂时说过,所有节点必须就谁是领导者达成一致,否则两个不同节点可能都自认为是领导者,进而作出彼此矛盾的决定。如此看来,选举领导者需要共识,解决共识又需要领导者。怎样才能跳出这个先有鸡还是先有蛋的困局?
事实上,共识算法并不要求任何时刻都只有一个领导者。它们提供的是稍弱一些的保证:协议定义一个 纪元编号(epoch number;Paxos 称为 投票编号,ballot number,视图戳复制称为 视图编号,view number,Raft 称为 任期编号,term number),并保证每个纪元内的领导者是唯一的。
如果一个节点在指定的超时时间内始终没有收到现任领导者的消息,因而认为它已经失效,这个节点就可能发起投票,选举新的领导者。这次选举会取得一个大于以往所有纪元的新纪元编号。如果两个不同纪元的领导者发生冲突——也许前任领导者其实并未失效——纪元编号较高的领导者说了算。
领导者要向共享日志追加下一条记录,必须先确认不存在纪元编号更高的其他领导者,否则后者可能会追加不同的条目。它可以向一组法定人数节点收集选票,这组节点通常是多数,但并非总是如此 85。只有在不知道任何更高纪元领导者的情况下,节点才会投赞成票。
因此,这里需要两轮投票:第一轮选举领导者;第二轮对领导者提议追加的下一条日志条目进行表决。两轮投票的法定人数必须相互重叠:如果某项提议表决通过,投赞成票的节点中,至少要有一个参加过最近一次成功的领导者选举 85。所以,如果提议表决通过,而且投票过程没有发现编号更高的纪元,现任领导者便可以断定,没有纪元编号更高的领导者当选,因而可以安全地把提议条目追加到日志 26 86。
这两轮投票表面上很像两阶段提交,实际上却是两种截然不同的协议。在共识算法中,任何节点都可以发起选举,而且只需一组法定人数节点响应;在 2PC 中,只有协调者能请求投票,并且必须从 每个 参与者那里得到“同意”票,事务才能提交。
共识的微妙之处
Raft、Multi-Paxos、Zab 和视图戳复制都采用这一基本结构:先由一组法定人数节点投票选举领导者;此后,领导者想追加的每一条日志条目,还要经过另一组法定人数节点投票 68 69。每条新日志条目都要同步复制到一组法定人数节点,才会向发起写入的客户端确认成功。这样即使现任领导者失效,日志条目也不会丢失。
不过,魔鬼藏在细节里,而这些算法的差异也恰恰体现在细节中。例如,旧领导者失效并选出新领导者后,算法必须保证,新领导者会保留旧领导者在失效前已经追加的所有日志条目。Raft 的做法是:只有日志至少与多数追随者一样新鲜的节点,才有资格成为新领导者 69。Paxos 则允许任何节点成为新领导者,但要求它先从其他节点补齐日志,才能开始追加自己的新条目。
如果希望共识算法严格保证 “共享日志作为共识” 中列出的属性,那么新领导者在处理任何写入或线性一致读取之前,必须掌握所有已经确认的日志条目。这是保证上述属性的必要条件。如果一个数据陈旧的节点成为新领导者,它可能会改写旧领导者已经写入的日志条目,从而违反共享日志的仅追加属性。
有些系统会选择削弱共识属性,以便更快地从领导者失效中恢复。例如,Kafka 可以启用 非同步副本选举(unclean leader election),允许任何副本成为领导者,即使它没有追上最新进度。另外,在采用异步复制的数据库中,领导者失效时,根本无法保证任何追随者已经赶上最新进度。
放弃“新领导者必须掌握最新数据”这一要求,或许能提高性能与可用性,却也如同在薄冰上行走,因为共识理论已经不再适用。没有故障时,系统固然可以正常工作;但一旦遇到 第 9 章 讨论的种种问题,就很容易造成大量数据丢失或损坏。
另一个微妙之处是:旧领导者在失效前已经提议了某条日志条目,但追加该条目的投票尚未结束,算法应当如何处理。关于这些细节,可以参阅本章末尾的参考文献 23 69 86。
对于用共识算法做复制的数据库,不仅写入要转成日志条目并复制到一组法定人数节点。如果还要保证线性一致读取,读取也必须像写入一样经过法定人数投票,以确认那个自认为是领导者的节点确实仍掌握最新数据。etcd 的线性一致读取就是这样实现的。
大多数共识算法的标准形式都假定节点集合固定不变:节点可以下线后重新上线,但哪些节点有权投票,在集群创建时便已确定。实践中,却经常需要在系统配置中添加新节点或移除旧节点。共识算法因此扩展出了 重新配置 功能。向系统增加新地区,或把系统从一个位置迁往另一个位置时,这项功能尤其有用:可以先加入新节点,再移除旧节点。
共识的利弊
共识算法虽然复杂而微妙,却是分布式系统领域的一项重大突破。共识本质上就是“正确实现的单主复制”:领导者失效时自动进行故障切换;即使面对 第 9 章 讨论的所有问题,也能保证已提交的数据不会丢失,系统绝不会发生脑裂。
既然带自动故障切换的单主复制本质上就是共识的一种定义,那么,任何提供自动故障切换、却没有采用经过验证的共识算法的系统,都很可能不安全 87。当然,采用经过验证的共识算法,并不能保证整个系统一定正确——错误仍可能潜伏在许多其他角落——但至少是一个良好的开端。
尽管如此,共识并未无处不在,因为它的好处也有代价。共识系统总要有严格多数节点才能运行:要容忍一个节点故障,至少需要三个节点;要容忍两个节点故障,至少需要五个。每项操作都必须与一组法定人数节点通信,因此不能靠增加节点来提高吞吐量(实际上,每增加一个节点,算法反而会变慢)。如果网络分区把一部分节点同其余节点隔开,只有多数派所在的一侧能够取得进展,另一侧则会阻塞。
共识系统通常依靠超时来检测失效节点。在网络延迟变化很大的环境中,尤其是跨多个地理区域部署的系统,超时时间很难调好:设得太长,故障恢复会耗时很久;设得太短,又会触发大量不必要的领导者选举,导致性能极差——系统花在选举领导者上的时间,可能比花在有用工作上的还多。
有些共识算法对网络问题格外敏感。例如,Raft 已被发现存在一些棘手的边界情况 88 89:即使整个网络都运行正常,只要有一条特定链路始终不可靠,领导权就可能在两个节点之间来回跳转,或者现任领导者不断被迫辞职,导致系统实际上永远无法取得进展。怎样设计对不可靠网络更稳健的算法,至今仍是一个开放的研究问题。
如果系统既希望高可用,又不愿承担共识的成本,真正可行的选择只有改用较弱的一致性模型,例如 第 6 章 讨论的无主复制或多主复制。这些方法通常不提供线性一致性;不过,对于并不需要线性一致性的应用,这已经足够。
协调服务
任何想提供线性一致操作的分布式数据库,都能从共识算法中受益;许多现代分布式数据库确实也用共识算法做复制。不过,有一类系统尤其倚重共识:ZooKeeper、etcd、Consul 等 协调服务(coordination service)。它们表面上与普通键值存储相似,却不像大多数数据库那样以通用数据存储为目标。
协调服务的用途,是协调另一个分布式系统中的多个节点。例如,Kubernetes 依赖 etcd;Spark 和 Flink 在高可用模式下,则依赖后台运行的 ZooKeeper。协调服务只保存少量足以全部放入内存的数据(同时仍会写入磁盘以保证持久性),再用容错共识算法把这些数据复制到多个节点。
协调服务以 Google 的 Chubby 锁服务为蓝本 17 58,把共识算法与几项对构建分布式系统格外有用的功能结合在一起:
- 锁与租约
- 前面已经看到,共识系统可以实现具备容错能力的原子比较并设置(CAS)操作。协调服务以此实现锁和租约:多个节点并发争抢同一份租约时,只有一个能够成功。
- 栅栏机制
- 正如 “分布式锁和租约” 所述,以租约保护某项资源时,需要用 栅栏机制 防止客户端在进程暂停或网络严重延迟时相互干扰。共识系统可以为每条日志条目分配单调递增的 ID,以此生成栅栏令牌(ZooKeeper 使用
zxid和cversion,etcd 使用修订号)。 - 故障检测
- 客户端与协调服务维持一个长期会话,并定期交换心跳,确认对方是否仍然存活。即使连接暂时中断或某台服务器失效,客户端持有的租约仍然有效;但如果心跳中断的时间超过租约超时,协调服务就会认定客户端已经失效,并释放其租约。(ZooKeeper 把这种随会话到期自动消失的条目称为 临时节点,ephemeral node。)
- 变更通知
- 客户端可以要求协调服务在某些键发生变化时主动发送通知。这样一来,客户端便能得知另一个客户端何时加入集群(根据它写入协调服务的值),或何时失效(它的会话超时,临时节点随之消失),无须再频繁轮询服务来发现变化。
故障检测与变更通知本身并不需要共识;但把它们同确实需要共识的原子操作、栅栏机制组合起来,对分布式协调就格外有用。
应用与基础设施通常都有超时时间、线程池大小等配置参数。有时,人们会把这类配置数据以键值对形式存入协调服务。进程启动时加载最新配置,并订阅此后的变更通知。配置变化后,进程可以立即采用新设置,也可以通过重启来加载最新设置。
配置管理本身并不需要协调服务的共识能力;不过,如果系统本来就在运行协调服务,顺便利用它的通知功能会很方便。另一种办法是让进程定期从文件或 URL 轮询配置更新,从而不必依赖专门的协调服务。
将工作分配给节点
如果某个进程或服务有多个实例,需要从中选出一个领导者或主实例,协调服务就很有用。领导者失效时,应当由其他某个节点接管。这对单主数据库必不可少,也适用于作业调度器等有状态系统。
另一种场景是分配分片资源(数据库、消息流、文件存储、分布式 Actor 系统等):系统需要决定每个分片交给哪个节点。新节点加入集群时,需要把一部分分片从现有节点移到新节点,以重新平衡负载;节点被移除或失效时,则要由其他节点接手它的工作。
审慎组合协调服务中的原子操作、临时节点与通知机制,就可以完成这类任务。实现得当时,应用能在无需人工干预的情况下自动从故障中恢复。即使已经有 Apache Curator 之类基于 ZooKeeper 客户端 API 提供高层工具的库,这仍然不是一件容易的事;但无论如何,都远胜于从头实现所需的共识算法——后者极易埋下错误。
专用协调服务还有一个优点:无论依赖它协调的分布式系统有多少节点,协调服务本身都可以只运行在一组固定节点上,通常是三个或五个。例如,一个存储系统拥有数千个分片;若让数千个节点共同运行共识算法,效率会低得惊人。把共识“外包”给少量运行协调服务的节点,要合理得多。
协调服务管理的数据通常变化缓慢,例如“IP 地址为 10.1.1.23 的节点是分片 7 的领导者”这类分配关系,往往几分钟或几小时才会变一次。协调服务并非用来存储每秒可能变化数千次的数据;这类数据更适合交给常规数据库。或者,也可以用 Apache BookKeeper 90 91 之类的工具,复制服务内部快速变化的状态。
服务发现
ZooKeeper、etcd 和 Consul 也经常用于 服务发现(service discovery),即找出应当连接哪个 IP 地址才能访问特定服务(见 “负载均衡器、服务发现和服务网格”)。云环境中的虚拟机不断创建和销毁,通常无法预先知道服务的 IP 地址。常见做法是让服务在启动时把自己的网络端点注册到服务注册表,供其他服务查找。
用协调服务做服务发现很方便:故障检测与变更通知功能,让客户端很容易跟踪服务实例的增减。如果系统已经用协调服务管理租约、锁或领导者选举,继续用它做服务发现也顺理成章,因为它本来就知道哪个节点应当接收服务请求。
不过,服务发现使用共识往往有些杀鸡用牛刀。这个场景通常不要求线性一致性;高可用与低延迟反而更加重要,因为一旦服务发现不可用,整个系统都会停摆。因此,更常见的做法是缓存服务发现信息,并接受结果可能略有陈旧。例如,基于 DNS 的服务发现就通过多层缓存获得良好的性能与可用性。
为支持这类用途,ZooKeeper 提供了 观察者(observer)节点。这些副本会接收日志、维护一份 ZooKeeper 数据副本,却不参与共识算法的投票。观察者上的读取可能陈旧,因而不具备线性一致性;但即使网络中断,读取仍可继续,而且缓存还能提高系统所能支持的读取吞吐量。
总结
本章探讨了容错系统中的强一致性:它是什么,又该怎样实现。我们深入研究了强一致性的一种常用形式化定义——线性一致性。它要求复制数据表现得仿佛只有一个副本,而且所有操作都以原子方式作用于这个副本。当某些数据在读取时必须是最新的,或需要解决竞态条件时(例如多个节点并发创建同名文件),线性一致性就很有用。
线性一致性很有吸引力,因为它易于理解:数据库的行为就像单线程程序中的一个变量。但它的缺点是速度慢,网络延迟较大时尤其如此。许多复制算法都无法保证线性一致性,哪怕乍看之下似乎能够提供强一致性。
接着,我们把线性一致性的概念应用到 ID 生成器。单节点自增计数器具有线性一致性,却不能容错。许多分布式 ID 生成方案也无法保证,ID 的顺序与事件实际发生的顺序一致。Lamport 时钟、混合逻辑时钟等逻辑时钟,可以给出与因果关系一致的顺序,却不具备线性一致性。
由此,我们引出了共识:达成共识,就是以一种所有节点都认同结果、而且事后不能改变主意的方式作出决定。许多问题实际上都可以归约为共识,而且彼此等价——换句话说,只要有一个问题的解法,就能把它转换成其他所有问题的解法。这些等价问题包括:
- 线性一致的比较并设置操作
- 寄存器必须根据当前值是否等于操作给出的参数,以原子方式 决定 是否设置新值。
- 锁和租约
- 多个客户端并发争抢锁或租约时,锁会 决定 由哪一个成功获取。
- 唯一性约束
- 多个事务并发创建键相同、彼此冲突的记录时,约束必须 决定 允许哪一个,又让哪一个因违反约束而失败。
- 共享日志
- 多个节点并发请求向日志追加条目时,日志会 决定 条目的追加顺序。全序广播也与之等价。
- 原子事务提交
- 参与分布式事务的所有数据库节点,必须作出相同的 决定:提交事务,或是中止事务。
- 线性一致的获取并增加操作
- 这项操作可以实现 ID 生成器。多个节点可以并发调用它,而它会 决定 各节点递增计数器的顺序。这种方法实际上只能解决两个节点之间的共识,前面几种则适用于任意数量的节点。
如果只有一个节点,或者愿意把决策权交给一个节点,所有这些问题都很简单。单主数据库正是如此:全部决策权都归领导者所有,这也是此类数据库能够提供线性一致操作、唯一性约束、复制日志等功能的原因。
可是,一旦这个领导者失效,或网络中断令它不可达,系统便无法继续取得进展,只能等待人工完成故障切换。Raft、Paxos 等广泛使用的共识算法,本质上就是内置了自动领导者选举与故障切换的单主复制。
共识算法经过精心设计,能保证故障切换期间不会丢失任何已经提交的写入,也不会让系统陷入多个节点同时接受写入的脑裂状态。为此,每次写入和每次线性一致读取都必须得到一组法定人数节点(通常是多数节点)的确认。这个过程代价不菲,跨地理区域时尤其如此;但若想获得共识所提供的强一致性与容错能力,这项代价无法避免。
ZooKeeper、etcd 等协调服务同样建立在共识算法之上。它们提供锁、租约、故障检测和变更通知等功能,有助于管理分布式应用的状态。如果要做的事情可以归约为共识,而且还必须容错,最好使用协调服务。它不能保证实现一定正确,却很可能帮上忙。
共识算法复杂而微妙,但背后有一套自 20 世纪 80 年代以来不断发展的丰富理论体系。这套理论让我们能够构建出这样的系统:既容忍 第 9 章 讨论的各种故障,又保证数据不被破坏。这是分布式系统工程的一项非凡成就;本章末尾的参考文献列出了其中若干重要工作。
不过,共识并不总是正确的工具。有些系统并不需要它所提供的强一致性,以较弱的一致性换取更高可用性和更好性能,反而更加合适。在这些场景中,人们通常采用 第 6 章 讨论过的无主复制或多主复制;本章介绍的逻辑时钟,对这类系统也很有帮助。
参考文献
Maurice P. Herlihy and Jeannette M. Wing. Linearizability: A Correctness Condition for Concurrent Objects. ACM Transactions on Programming Languages and Systems (TOPLAS), volume 12, issue 3, pages 463–492, July 1990. doi:10.1145/78969.78972 ↩︎ ↩︎
Leslie Lamport. On interprocess communication. Distributed Computing, volume 1, issue 2, pages 77–101, June 1986. doi:10.1007/BF01786228 ↩︎
David K. Gifford. Information Storage in a Decentralized Computer System. Xerox Palo Alto Research Centers, CSL-81-8, June 1981. Archived at perma.cc/2XXP-3JPB ↩︎
Martin Kleppmann. Please Stop Calling Databases CP or AP. martin.kleppmann.com, May 2015. Archived at perma.cc/MJ5G-75GL ↩︎ ↩︎ ↩︎
Kyle Kingsbury. Call Me Maybe: MongoDB Stale Reads. aphyr.com, April 2015. Archived at perma.cc/DXB4-J4JC ↩︎
Kyle Kingsbury. Computational Techniques in Knossos. aphyr.com, May 2014. Archived at perma.cc/2X5M-EHTU ↩︎
Kyle Kingsbury and Peter Alvaro. Elle: Inferring Isolation Anomalies from Experimental Observations. Proceedings of the VLDB Endowment, volume 14, issue 3, pages 268–280, November 2020. doi:10.14778/3430915.3430918 ↩︎
Paolo Viotti and Marko Vukolić. Consistency in Non-Transactional Distributed Storage Systems. ACM Computing Surveys (CSUR), volume 49, issue 1, article no. 19, June 2016. doi:10.1145/2926965 ↩︎ ↩︎
Peter Bailis. Linearizability Versus Serializability. bailis.org, September 2014. Archived at perma.cc/386B-KAC3 ↩︎
Daniel Abadi. Correctness Anomalies Under Serializable Isolation. dbmsmusings.blogspot.com, June 2019. Archived at perma.cc/JGS7-BZFY ↩︎
Peter Bailis, Aaron Davidson, Alan Fekete, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. Highly Available Transactions: Virtues and Limitations. Proceedings of the VLDB Endowment, volume 7, issue 3, pages 181–192, November 2013. doi:10.14778/2732232.2732237, extended version published as arXiv:1302.0309 ↩︎
Philip A. Bernstein, Vassos Hadzilacos, and Nathan Goodman. Concurrency Control and Recovery in Database Systems. Addison-Wesley, 1987. ISBN: 978-0-201-10715-9, available online at microsoft.com. ↩︎
Andrei Matei. CockroachDB’s consistency model. cockroachlabs.com, February 2021. Archived at perma.cc/MR38-883B ↩︎
Murat Demirbas. Strict-serializability, but at what cost, for what purpose? muratbuffalo.blogspot.com, August 2022. Archived at perma.cc/T8AY-N3U9 ↩︎
Ben Darnell. How to talk about consistency and isolation in distributed DBs. cockroachlabs.com, February 2022. Archived at perma.cc/53SV-JBGK ↩︎
Daniel Abadi. An explanation of the difference between Isolation levels vs. Consistency levels. dbmsmusings.blogspot.com, August 2019. Archived at perma.cc/QSF2-CD4P ↩︎
Mike Burrows. The Chubby Lock Service for Loosely-Coupled Distributed Systems. At 7th USENIX Symposium on Operating System Design and Implementation (OSDI), November 2006. ↩︎ ↩︎
Flavio P. Junqueira and Benjamin Reed. ZooKeeper: Distributed Process Coordination. O’Reilly Media, 2013. ISBN: 978-1-449-36130-3 ↩︎ ↩︎ ↩︎ ↩︎
Murali Vallath. Oracle 10g RAC Grid, Services & Clustering. Elsevier Digital Press, 2006. ISBN: 978-1-555-58321-7 ↩︎ ↩︎
Peter Bailis, Alan Fekete, Michael J. Franklin, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. Coordination Avoidance in Database Systems. Proceedings of the VLDB Endowment, volume 8, issue 3, pages 185–196, November 2014. doi:10.14778/2735508.2735509 ↩︎
Kyle Kingsbury. Call Me Maybe: etcd and Consul. aphyr.com, June 2014. Archived at perma.cc/XL7U-378K ↩︎
Flavio P. Junqueira, Benjamin C. Reed, and Marco Serafini. Zab: High-Performance Broadcast for Primary-Backup Systems. At 41st IEEE International Conference on Dependable Systems and Networks (DSN), June 2011. doi:10.1109/DSN.2011.5958223 ↩︎ ↩︎
Diego Ongaro and John K. Ousterhout. In Search of an Understandable Consensus Algorithm. At USENIX Annual Technical Conference (ATC), June 2014. ↩︎ ↩︎ ↩︎
Hagit Attiya, Amotz Bar-Noy, and Danny Dolev. Sharing Memory Robustly in Message-Passing Systems. Journal of the ACM, volume 42, issue 1, pages 124–142, January 1995. doi:10.1145/200836.200869 ↩︎ ↩︎
Nancy Lynch and Alex Shvartsman. Robust Emulation of Shared Memory Using Dynamic Quorum-Acknowledged Broadcasts. At 27th Annual International Symposium on Fault-Tolerant Computing (FTCS), June 1997. doi:10.1109/FTCS.1997.614100 ↩︎ ↩︎
Christian Cachin, Rachid Guerraoui, and Luís Rodrigues. Introduction to Reliable and Secure Distributed Programming, 2nd edition. Springer, 2011. ISBN: 978-3-642-15259-7, doi:10.1007/978-3-642-15260-3 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Niklas Ekström, Mikhail Panchenko, and Jonathan Ellis. Possible Issue with Read Repair? Email thread on cassandra-dev mailing list, October 2012. ↩︎
Maurice P. Herlihy. Wait-Free Synchronization. ACM Transactions on Programming Languages and Systems (TOPLAS), volume 13, issue 1, pages 124–149, January 1991. doi:10.1145/114005.102808 ↩︎ ↩︎ ↩︎ ↩︎
Armando Fox and Eric A. Brewer. Harvest, Yield, and Scalable Tolerant Systems. At 7th Workshop on Hot Topics in Operating Systems (HotOS), March 1999. doi:10.1109/HOTOS.1999.798396 ↩︎
Seth Gilbert and Nancy Lynch. Brewer’s Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services. ACM SIGACT News, volume 33, issue 2, pages 51–59, June 2002. doi:10.1145/564585.564601 ↩︎ ↩︎ ↩︎
Seth Gilbert and Nancy Lynch. Perspectives on the CAP Theorem. IEEE Computer Magazine, volume 45, issue 2, pages 30–36, February 2012. doi:10.1109/MC.2011.389 ↩︎
Eric A. Brewer. CAP Twelve Years Later: How the ‘Rules’ Have Changed. IEEE Computer Magazine, volume 45, issue 2, pages 23–29, February 2012. doi:10.1109/MC.2012.37 ↩︎ ↩︎
Susan B. Davidson, Hector Garcia-Molina, and Dale Skeen. Consistency in Partitioned Networks. ACM Computing Surveys, volume 17, issue 3, pages 341–370, September 1985. doi:10.1145/5505.5508 ↩︎
Paul R. Johnson and Robert H. Thomas. RFC 677: The Maintenance of Duplicate Databases. Network Working Group, January 1975. ↩︎
Michael J. Fischer and Alan Michael. Sacrificing Serializability to Attain High Availability of Data in an Unreliable Network. At 1st ACM Symposium on Principles of Database Systems (PODS), March 1982. doi:10.1145/588111.588124 ↩︎
Eric A. Brewer. NoSQL: Past, Present, Future. At QCon San Francisco, November 2012. ↩︎
Adrian Cockcroft. Migrating to Microservices. At QCon London, March 2014. ↩︎
Martin Kleppmann. A Critique of the CAP Theorem. arXiv:1509.05393, September 2015. ↩︎ ↩︎
Daniel Abadi. Problems with CAP, and Yahoo’s little known NoSQL system. dbmsmusings.blogspot.com, April 2010. Archived at perma.cc/4NTZ-CLM9 ↩︎ ↩︎ ↩︎
Daniel Abadi. Hazelcast and the Mythical PA/EC System. dbmsmusings.blogspot.com, October 2017. Archived at perma.cc/J5XM-U5C2 ↩︎ ↩︎
Eric Brewer. Spanner, TrueTime & The CAP Theorem. research.google.com, February 2017. Archived at perma.cc/59UW-RH7N ↩︎
Daniel J. Abadi. Consistency Tradeoffs in Modern Distributed Database System Design. IEEE Computer Magazine, volume 45, issue 2, pages 37–42, February 2012. doi:10.1109/MC.2012.33 ↩︎ ↩︎
Nancy A. Lynch. A Hundred Impossibility Proofs for Distributed Computing. At 8th ACM Symposium on Principles of Distributed Computing (PODC), August 1989. doi:10.1145/72981.72982 ↩︎
Prince Mahajan, Lorenzo Alvisi, and Mike Dahlin. Consistency, Availability, and Convergence. University of Texas at Austin, Department of Computer Science, Tech Report UTCS TR-11-22, May 2011. Archived at perma.cc/SAV8-9JAJ ↩︎
Hagit Attiya, Faith Ellen, and Adam Morrison. Limitations of Highly-Available Eventually-Consistent Data Stores. At ACM Symposium on Principles of Distributed Computing (PODC), July 2015. doi:10.1145/2767386.2767419 ↩︎
Peter Sewell, Susmit Sarkar, Scott Owens, Francesco Zappa Nardelli, and Magnus O. Myreen. x86-TSO: A Rigorous and Usable Programmer’s Model for x86 Multiprocessors. Communications of the ACM, volume 53, issue 7, pages 89–97, July 2010. doi:10.1145/1785414.1785443 ↩︎
Martin Thompson. Memory Barriers/Fences. mechanical-sympathy.blogspot.co.uk, July 2011. Archived at perma.cc/7NXM-GC5U ↩︎
Ulrich Drepper. What Every Programmer Should Know About Memory. akkadia.org, November 2007. Archived at perma.cc/NU6Q-DRXZ ↩︎
Hagit Attiya and Jennifer L. Welch. Sequential Consistency Versus Linearizability. ACM Transactions on Computer Systems (TOCS), volume 12, issue 2, pages 91–122, May 1994. doi:10.1145/176575.176576 ↩︎
Kyzer R. Davis, Brad G. Peabody, and Paul J. Leach. Universally Unique IDentifiers (UUIDs). RFC 9562, IETF, May 2024. ↩︎ ↩︎
Ryan King. Announcing Snowflake. blog.x.com, June 2010. Archived at archive.org ↩︎
Alizain Feerasta. Universally Unique Lexicographically Sortable Identifier. github.com, 2016. Archived at perma.cc/NV2Y-ZP8U ↩︎
Rob Conery. A Better ID Generator for PostgreSQL. bigmachine.io, May 2014. Archived at perma.cc/K7QV-3KFC ↩︎
Leslie Lamport. Time, Clocks, and the Ordering of Events in a Distributed System. Communications of the ACM, volume 21, issue 7, pages 558–565, July 1978. doi:10.1145/359545.359563 ↩︎ ↩︎
Sandeep S. Kulkarni, Murat Demirbas, Deepak Madeppa, Bharadwaj Avva, and Marcelo Leone. Logical Physical Clocks. 18th International Conference on Principles of Distributed Systems (OPODIS), December 2014. doi:10.1007/978-3-319-14472-6_2 ↩︎
Manuel Bravo, Nuno Diegues, Jingna Zeng, Paolo Romano, and Luís Rodrigues. On the use of Clocks to Enforce Consistency in the Cloud. IEEE Data Engineering Bulletin, volume 38, issue 1, pages 18–31, March 2015. Archived at perma.cc/68ZU-45SH ↩︎
Daniel Peng and Frank Dabek. Large-Scale Incremental Processing Using Distributed Transactions and Notifications. At 9th USENIX Conference on Operating Systems Design and Implementation (OSDI), October 2010. ↩︎
Tushar Deepak Chandra, Robert Griesemer, and Joshua Redstone. Paxos Made Live – An Engineering Perspective. At 26th ACM Symposium on Principles of Distributed Computing (PODC), June 2007. doi:10.1145/1281100.1281103 ↩︎ ↩︎ ↩︎
Will Portnoy. Lessons Learned from Implementing Paxos. blog.willportnoy.com, June 2012. Archived at perma.cc/QHD9-FDD2 ↩︎
Brian M. Oki and Barbara H. Liskov. Viewstamped Replication: A New Primary Copy Method to Support Highly-Available Distributed Systems. At 7th ACM Symposium on Principles of Distributed Computing (PODC), August 1988. doi:10.1145/62546.62549 ↩︎
Barbara H. Liskov and James Cowling. Viewstamped Replication Revisited. Massachusetts Institute of Technology, Tech Report MIT-CSAIL-TR-2012-021, July 2012. Archived at perma.cc/56SJ-WENQ ↩︎
Leslie Lamport. The Part-Time Parliament. ACM Transactions on Computer Systems, volume 16, issue 2, pages 133–169, May 1998. doi:10.1145/279227.279229 ↩︎
Leslie Lamport. Paxos Made Simple. ACM SIGACT News, volume 32, issue 4, pages 51–58, December 2001. Archived at perma.cc/82HP-MNKE ↩︎
Robbert van Renesse and Deniz Altinbuken. Paxos Made Moderately Complex. ACM Computing Surveys (CSUR), volume 47, issue 3, article no. 42, February 2015. doi:10.1145/2673577 ↩︎
Diego Ongaro. Consensus: Bridging Theory and Practice. PhD Thesis, Stanford University, August 2014. Archived at perma.cc/5VTZ-2ADH ↩︎
Heidi Howard, Malte Schwarzkopf, Anil Madhavapeddy, and Jon Crowcroft. Raft Refloated: Do We Have Consensus? ACM SIGOPS Operating Systems Review, volume 49, issue 1, pages 12–21, January 2015. doi:10.1145/2723872.2723876 ↩︎
André Medeiros. ZooKeeper’s Atomic Broadcast Protocol: Theory and Practice. Aalto University School of Science, March 2012. Archived at perma.cc/FVL4-JMVA ↩︎
Robbert van Renesse, Nicolas Schiper, and Fred B. Schneider. Vive La Différence: Paxos vs. Viewstamped Replication vs. Zab. IEEE Transactions on Dependable and Secure Computing, volume 12, issue 4, pages 472–484, September 2014. doi:10.1109/TDSC.2014.2355848 ↩︎ ↩︎
Heidi Howard and Richard Mortier. Paxos vs Raft: Have we reached consensus on distributed consensus?. At 7th Workshop on Principles and Practice of Consistency for Distributed Data (PaPoC), April 2020. doi:10.1145/3380787.3393681 ↩︎ ↩︎ ↩︎ ↩︎
Miguel Castro and Barbara H. Liskov. Practical Byzantine Fault Tolerance and Proactive Recovery. ACM Transactions on Computer Systems, volume 20, issue 4, pages 396–461, November 2002. doi:10.1145/571637.571640 ↩︎
Shehar Bano, Alberto Sonnino, Mustafa Al-Bassam, Sarah Azouvi, Patrick McCorry, Sarah Meiklejohn, and George Danezis. SoK: Consensus in the Age of Blockchains. At 1st ACM Conference on Advances in Financial Technologies (AFT), October 2019. doi:10.1145/3318041.3355458 ↩︎
Michael J. Fischer, Nancy Lynch, and Michael S. Paterson. Impossibility of Distributed Consensus with One Faulty Process. Journal of the ACM, volume 32, issue 2, pages 374–382, April 1985. doi:10.1145/3149.214121 ↩︎ ↩︎
Tushar Deepak Chandra and Sam Toueg. Unreliable Failure Detectors for Reliable Distributed Systems. Journal of the ACM, volume 43, issue 2, pages 225–267, March 1996. doi:10.1145/226643.226647 ↩︎ ↩︎ ↩︎ ↩︎
Michael Ben-Or. Another Advantage of Free Choice: Completely Asynchronous Agreement Protocols. At 2nd ACM Symposium on Principles of Distributed Computing (PODC), August 1983. doi:10.1145/800221.806707 ↩︎
Cynthia Dwork, Nancy Lynch, and Larry Stockmeyer. Consensus in the Presence of Partial Synchrony. Journal of the ACM, volume 35, issue 2, pages 288–323, April 1988. doi:10.1145/42282.42283 ↩︎
Xavier Défago, André Schiper, and Péter Urbán. Total Order Broadcast and Multicast Algorithms: Taxonomy and Survey. ACM Computing Surveys, volume 36, issue 4, pages 372–421, December 2004. doi:10.1145/1041680.1041682 ↩︎
Hagit Attiya and Jennifer Welch. Distributed Computing: Fundamentals, Simulations and Advanced Topics, 2nd edition. John Wiley & Sons, 2004. ISBN: 978-0-471-45324-6, doi:10.1002/0471478210 ↩︎
Rachid Guerraoui. Revisiting the Relationship Between Non-Blocking Atomic Commitment and Consensus. At 9th International Workshop on Distributed Algorithms (WDAG), September 1995. doi:10.1007/BFb0022140 ↩︎ ↩︎
Jim N. Gray and Leslie Lamport. Consensus on Transaction Commit. ACM Transactions on Database Systems (TODS), volume 31, issue 1, pages 133–160, March 2006. doi:10.1145/1132863.1132867 ↩︎
Fred B. Schneider. Implementing Fault-Tolerant Services Using the State Machine Approach: A Tutorial. ACM Computing Surveys, volume 22, issue 4, pages 299–319, December 1990. doi:10.1145/98163.98167 ↩︎
Alexander Thomson, Thaddeus Diamond, Shu-Chun Weng, Kun Ren, Philip Shao, and Daniel J. Abadi. Calvin: Fast Distributed Transactions for Partitioned Database Systems. At ACM International Conference on Management of Data (SIGMOD), May 2012. doi:10.1145/2213836.2213838 ↩︎
Mahesh Balakrishnan, Dahlia Malkhi, Ted Wobber, Ming Wu, Vijayan Prabhakaran, Michael Wei, John D. Davis, Sriram Rao, Tao Zou, and Aviad Zuck. Tango: Distributed Data Structures over a Shared Log. At 24th ACM Symposium on Operating Systems Principles (SOSP), November 2013. doi:10.1145/2517349.2522732 ↩︎
Mahesh Balakrishnan, Dahlia Malkhi, Vijayan Prabhakaran, Ted Wobber, Michael Wei, and John D. Davis. CORFU: A Shared Log Design for Flash Clusters. At 9th USENIX Symposium on Networked Systems Design and Implementation (NSDI), April 2012. ↩︎
Vasilis Gavrielatos, Antonios Katsarakis, and Vijay Nagarajan. Odyssey: the impact of modern hardware on strongly-consistent replication protocols. At 16th European Conference on Computer Systems (EuroSys), April 2021. doi:10.1145/3447786.3456240 ↩︎
Heidi Howard, Dahlia Malkhi, and Alexander Spiegelman. Flexible Paxos: Quorum Intersection Revisited. At 20th International Conference on Principles of Distributed Systems (OPODIS), December 2016. doi:10.4230/LIPIcs.OPODIS.2016.25 ↩︎ ↩︎
Martin Kleppmann. Distributed Systems lecture notes. University of Cambridge, October 2024. Archived at perma.cc/SS3Q-FNS5 ↩︎ ↩︎
Kyle Kingsbury. Call Me Maybe: Elasticsearch 1.5.0. aphyr.com, April 2015. Archived at perma.cc/37MZ-JT7H ↩︎
Heidi Howard and Jon Crowcroft. Coracle: Evaluating Consensus at the Internet Edge. At Annual Conference of the ACM Special Interest Group on Data Communication (SIGCOMM), August 2015. doi:10.1145/2829988.2790010 ↩︎
Tom Lianza and Chris Snook. A Byzantine failure in the real world. blog.cloudflare.com, November 2020. Archived at perma.cc/83EZ-ALCY ↩︎
Ivan Kelly. BookKeeper Tutorial. github.com, October 2014. Archived at perma.cc/37Y6-VZWU ↩︎
Jack Vanlightly. Apache BookKeeper Insights Part 1 — External Consensus and Dynamic Membership. medium.com, November 2021. Archived at perma.cc/3MDB-8GFB ↩︎
III 派生数据
在本书的 第一部分 和 第二部分 中,我们自底向上地把所有关于分布式数据库的主要考量都过了一遍。从数据在磁盘上的布局,一直到出现故障时分布式系统一致性的局限。但所有的讨论都假定了应用中只用了一种数据库。
现实世界中的数据系统往往更为复杂。大型应用程序经常需要以多种方式访问和处理数据,没有一个数据库可以同时满足所有这些不同的需求。因此应用程序通常组合使用多种组件:数据存储、索引、缓存、分析系统等等,并实现在这些组件中移动数据的机制。
本书的最后一部分,会研究将多个不同数据系统(可能有着不同数据模型,并针对不同的访问模式进行优化)集成为一个协调一致的应用架构时,会遇到的问题。软件供应商经常会忽略这一方面的生态建设,并声称他们的产品能够满足你的所有需求。在现实世界中,集成不同的系统是实际应用中最重要的事情之一。
记录系统和派生数据系统
从高层次上看,存储和处理数据的系统可以分为两大类:
- 权威记录系统(System of record)
- 记录系统,也被称为 真相源(source of truth),持有数据的权威版本。当新的数据进入时(例如,用户输入)首先会记录在这里。 每个事实正正好好表示一次(表示通常是 正规化的,即 normalized)。如果其他系统和 记录系统 之间存在任何差异,那么记录系统中的值是正确的(根据定义)。
- 派生数据系统(Derived data systems)
- 派生系统 中的数据,通常是另一个系统中的现有数据以某种方式进行转换或处理的结果。如果丢失派生数据,可以从原始来源重新创建。 典型的例子是 缓存(cache):如果数据在缓存中,就可以由缓存提供服务;如果缓存不包含所需数据,则降级由底层数据库提供。非规范化的值,索引和物化视图亦属此类。在推荐系统中,预测汇总数据通常派生自用户日志。
从技术上讲,派生数据是 冗余的(redundant),因为它重复了已有的信息。但是派生数据对于获得良好的只读查询性能通常是至关重要的。它通常是非规范化的。可以从单个源头派生出多个不同的数据集,使你能从不同的 “视角” 洞察数据。
并不是所有的系统都在其架构中明确区分 记录系统 和 派生数据系统,但是这是一种有用的区分方式,因为它明确了系统中的数据流:系统的哪一部分具有哪些输入和哪些输出,以及它们如何相互依赖。
大多数数据库,存储引擎和查询语言,本质上既不是记录系统也不是派生系统。数据库只是一个工具:如何使用它取决于你自己。记录系统和派生数据系统之间的区别不在于工具,而在于应用程序中的使用方式。
通过梳理数据的派生关系,可以清楚地理解一个令人困惑的系统架构。这将贯穿本书的这一部分。
章节概述
我们将从 第十一章 开始,研究例如 MapReduce 这样 面向批处理(batch-oriented) 的数据流系统。对于建设大规模数据系统,我们将看到,它们提供了优秀的工具和思想。 第十二章 将把这些思想应用到 流式数据(data streams) 中,使我们能用更低的延迟完成同样的任务。第十三章 将探讨如何使用这些工具来构建可靠、可伸缩和可维护的应用。第十四章 将以伦理、隐私与社会影响为主题,为全书收束。
索引
11. 批处理
12. 流处理
13. 流式系统的哲学
14. 做正确的事情
11 批处理

带有太强个人色彩的系统无法成功。当最初的设计完成并且相对稳健时,不同的人开始以自己的方式进行试验,真正的考验才开始。
高德纳
到目前为止,本书的大部分内容都在讨论 请求(request)和 查询(query),以及相应的 响应(response)或 结果(result)。许多现代数据系统都默认采用这种处理方式:你请求某样东西,或者发出一条指令,系统便尽量快速地给出答案。
浏览器请求网页、服务调用远程 API,以及数据库、缓存、搜索索引等许多系统,都是这样工作的。我们称它们为 在线系统(online system)。这类系统通常以响应时间作为主要性能指标,而且往往需要具备容错能力,才能保证高可用性。
然而,有些计算规模太大,或者需要处理的数据太多,无法放在一次交互式请求中完成。例如,你可能需要训练 AI 模型,把大量数据从一种形式转换成另一种形式,或者在非常大的数据集上进行分析。我们把这类任务称为 批处理(batch processing)作业,相应的系统有时也称为 离线系统(offline system)。
批处理作业读取一组输入数据(只读),并产生一组输出数据(每次运行都从头生成)。它通常不会像读写事务那样修改现有数据。因此,输出是由输入 衍生(derived)而来的(参见“权威记录系统与衍生数据”):如果对输出不满意,只需把它删除,调整作业逻辑,再运行一次。把输入视为不可变数据,并避免产生副作用(例如写入外部数据库),不仅能让批处理作业获得良好的性能,还会带来其他好处:
如果代码中引入了错误,导致输出有误或遭到破坏,只要回滚到先前版本的代码并重新运行作业,输出便能恢复正确。更简单的办法是把旧输出保存在另一个目录中,需要时直接切换回去。大多数对象存储和开放表格式(参见“云数据仓库”)都支持这种称为 时间旅行(time travel)的功能。大多数支持读写事务的数据库却不具备这种性质:如果错误代码把坏数据写进数据库,回滚代码并不能修复已经写入的数据。这种从错误代码中恢复的能力称为 容忍人为失误(human fault tolerance)1。
由于回滚很容易,功能开发可以比“犯错就会造成不可逆损害”的环境推进得更快。这种 尽量减少不可逆操作 的原则有利于敏捷软件开发 2。
同一组文件可以作为许多不同作业的输入,其中也包括监控作业:它们计算指标,并检查某项作业的输出是否具备预期特征,例如将其与上一次运行的输出比较,衡量两者之间的差异。
批处理框架能够高效利用计算资源。虽然 OLTP 数据库和应用服务器等在线数据系统也能成批处理数据,但完成同样工作所需的资源可能昂贵得多。
批处理也会带来一些挑战。在大多数框架中,只有整个作业运行完毕,其他作业才能继续处理它的输出。批处理还可能效率不高:输入数据发生任何变化——哪怕只有一个字节——都意味着批处理作业必须重新处理整个输入数据集。尽管存在这些局限,批处理仍在许多场景中证明了自己的价值,我们将在“批处理用例”中再次讨论这些场景。
一项批处理作业可能要运行很长时间:几分钟、几小时,甚至几天。作业也可能按固定周期调度运行,例如每天一次。其主要性能指标通常是吞吐量,即单位时间内能够处理多少数据。有些批处理系统遇到故障时只会中止并重新启动整个作业;另一些则具备容错能力,即使某些节点崩溃,作业也能顺利完成。
批处理之外还有一种选择,即 流处理。流处理作业不会在处理完当前输入后结束,而是继续监视输入,并在输入发生变化后不久加以处理。我们将在第 12 章讨论流处理。
在线系统与批处理系统之间的界限并不总是分明:一条长时间运行的数据库查询看起来就很像批处理过程。不过,批处理有一些独特的性质,使其成为构建可靠、可伸缩且可维护应用的重要构件。例如,它经常用于 数据集成,也就是把多个数据系统组合起来,完成单个系统无法独自完成的工作。“数据仓库”中讨论的 ETL 就是一例。
现代批处理深受 MapReduce 影响。Google 于 2004 年发表了这种批处理算法 3,随后 Hadoop、CouchDB 和 MongoDB 等多个开源数据系统都实现了它。MapReduce 是一种相当底层的编程模型,没有数据仓库中的并行查询执行引擎那么精巧 4 5。刚问世时,MapReduce 让普通商用硬件能够达到的处理规模迈上了一个新台阶;如今它已经基本过时,Google 也不再使用 6 7。
如今,批处理更多由 Spark、Flink 之类的框架或数据仓库查询引擎完成。与 MapReduce 一样,这些系统高度依赖分片(参见第 7 章)和并行执行,但它们的缓存和执行策略精巧得多。随着系统逐渐成熟,运维方面的问题基本得到解决,关注点也转向了易用性。数据流 API、查询语言和数据框 API 如今都得到了广泛支持,作业与工作流编排同样日趋成熟。Oozie、Azkaban 等以 Hadoop 为中心的工作流调度器,已经被 Airflow、Dagster 和 Prefect 等更通用的方案所取代;后者支持各种批处理框架和云数据仓库。
云计算已经十分普及,批处理的存储层也正从 HDFS、GlusterFS 和 CephFS 等分布式文件系统(DFS)转向 S3 之类的对象存储。BigQuery、Snowflake 等可伸缩的云数据仓库,则进一步模糊了数据仓库与批处理系统之间的界限。
为了直观地理解批处理,本章先从单台机器上的标准 Unix 工具入手,再研究如何把数据处理扩展到分布式系统中的多台机器。我们将看到,分布式批处理框架与操作系统很相似,同样拥有调度器和文件系统。随后,我们会考察编写批处理作业时使用的几种处理模型,最后讨论常见的批处理用例。
使用 Unix 工具的批处理
假设有一台 Web 服务器,每处理一个请求,它都会在日志文件末尾追加一行。以 nginx 默认的访问日志格式为例,其中一行可能如下所示:
216.58.210.78 - - [27/Jun/2025:17:55:11 +0000] "GET /css/typography.css HTTP/1.1"
200 3377 "https://martin.kleppmann.com/" "Mozilla/5.0 (Macintosh; Intel Mac OS X
10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/137.0.0.0 Safari/537.36"
(这其实是一行,只是为了便于阅读才在这里折成了多行。)这一行包含许多信息。要解释它,需要先查看日志格式的定义:
$remote_addr - $remote_user [$time_local] "$request"
$status $body_bytes_sent "$http_referer" "$http_user_agent"
这行日志表示:在 UTC 时间 2025 年 6 月 27 日 17:55:11,服务器收到了来自客户端 IP 地址 216.58.210.78、请求文件 /css/typography.css 的请求。用户没有经过身份认证,因此 $remote_user 被设为连字符(-)。响应状态码为 200(即请求成功),响应大小为 3,377 字节。浏览器是 Chrome 137;它之所以加载这个文件,是因为网址 * https://martin.kleppmann.com/* 的页面引用了该文件。
解析日志听起来或许像是一个刻意编造的例子,实际上却是许多现代科技公司的关键工作,从广告数据管道到支付处理无所不包。事实上,日志处理正是 MapReduce 得以迅速普及、并推动“大数据”浪潮的重要原因之一。
简单日志分析
许多工具都能读取这些日志文件,生成漂亮的网站流量报告。不过为了练习,我们来用基本的 Unix 工具自行构建一个。假设你想找出网站上最受欢迎的五个页面,可以在 Unix shell 中执行下面的命令:
读取日志文件。(严格来说,这里的
cat并非必需,因为可以把输入文件直接作为参数传给awk。不过这样写能让线性管道显得更清楚。)按空白字符把每一行拆成字段,只输出第七个字段,而它恰好就是请求的 URL。在前面的示例中,这个 URL 是 /css/typography.css。
按字母顺序
sort请求 URL 列表。如果某个 URL 被请求了 n 次,那么排序后的文件中就会连续出现 n 个相同的 URL。uniq命令通过检查相邻两行是否相同,滤掉输入中重复的行。-c选项让它同时输出计数器:对于每个不同的 URL,它会报告该 URL 在输入中出现了多少次。第二个
sort按每行开头的数字(-n)排序,也就是按 URL 的请求次数排序;然后以逆序(-r)返回结果,让最大的数字排在最前面。最后,
head只输出输入的前五行(-n 5),并丢弃其余内容。
这一系列命令的输出大致如下:
4189 /favicon.ico
3631 /2016/02/08/how-to-do-distributed-locking.html
2124 /2020/11/18/distributed-systems-and-elliptic-curves.html
1369 /
 915 /css/typography.css
如果你不熟悉 Unix 工具,前面的命令行可能显得有些晦涩,但它的能力非常强大。它能在几秒钟内处理数 GB 的日志,而且可以轻松修改分析方式来满足需要。例如,如果不希望报告中包含 CSS 文件,只需把 awk 参数改为 '$7 !~ /\.css$/ {print $7}';如果想统计最常出现的客户端 IP 地址,而不是最常访问的页面,则把参数改为 '{print $1}',以此类推。
本书没有足够篇幅详细介绍 Unix 工具,但它们非常值得学习。令人惊讶的是,仅用 awk、sed、grep、sort、uniq 和 xargs 的某种组合,几分钟内就能完成许多数据分析,而且性能也出奇地好 8。
命令链与自定义程序
除了使用 Unix 命令链,你也可以写一个简单的程序来完成同样的工作。例如,Python 程序可能如下所示:
counts是一个散列表,保存每个 URL 出现次数的计数器;计数器的默认值为 0。从每一行日志中取出按空白字符分隔的第七个字段,作为 URL(因为 Python 数组从 0 开始计数,所以数组下标是 6)。
把当前日志行中 URL 对应的计数器加一。
按计数器的值对散列表内容降序排列,并取出前五项。
输出这五项。
这个程序没有 Unix 管道那么简洁,但也相当容易读懂;喜欢哪一种,部分取决于个人偏好。不过,除了表面的语法差异,两者的执行流程也大不相同。如果在大文件上运行这项分析,区别就会显现出来。
排序与内存聚合
Python 脚本在内存中维护一个 URL 散列表,把每个 URL 映射到它出现的次数。Unix 管道没有这样的散列表,而是依靠排序 URL 列表;同一个 URL 出现多次时,它只是在列表中重复多次。
哪种方法更好?这取决于不同 URL 的数量。对于大多数中小型网站,你大概可以把所有不同的 URL 及其计数器放进 1 GB 左右的内存。这个作业的 工作集(working set;即作业需要随机访问的内存量)只取决于不同 URL 的数量:即使日志中同一个 URL 出现了一百万次,散列表所需的空间仍然只是一个 URL 加一个计数器。只要工作集足够小,内存散列表就能很好地工作——即便在笔记本电脑上也是如此。
另一方面,如果作业的工作集大于可用内存,排序方法就有一个优势:它可以高效利用磁盘。这与“日志结构存储”中讨论的原理相同:先在内存中对数据块排序,并把它们作为段文件写入磁盘,再将多个有序段合并成一个更大的有序文件。归并排序采用顺序访问模式,在磁盘上表现很好(参见“顺序与随机写入”)。
GNU Coreutils(Linux)中的 sort 工具会把无法装入内存的数据自动溢写到磁盘,还会自动利用多个 CPU 核并行排序 9。这意味着前面的简单 Unix 命令链可以轻松扩展到大型数据集,而不会耗尽内存。此时的瓶颈很可能是从磁盘读取输入文件的速度。
Unix 工具的局限在于,它们只能在单台机器上运行。如果数据集大到无法装入单机内存或本地磁盘,就会遇到问题——这正是分布式批处理框架的用武之地。
分布式系统中的批处理
运行前面 Unix 工具示例的机器,需要由几个组件协同处理日志数据:
通过操作系统的文件系统接口访问的存储设备。
决定进程何时运行、如何为其分配 CPU 资源的调度器。
一系列 Unix 程序,其
stdin和stdout通过管道连接在一起。
分布式数据处理框架中也存在同样的组件。事实上,你可以把 分布式处理框架(distributed processing framework)看作一种分布式操作系统:它们拥有文件系统和作业调度器,程序则通过文件系统或其他通信通道相互发送数据。
分布式文件系统
操作系统提供的文件系统由若干层组成:
最底层的块设备驱动程序直接与磁盘通信,让上层能够读写原始数据块。
块设备层之上是页缓存,它把最近访问的数据块保存在内存中,以加快再次访问的速度。
文件系统层封装了块 API,把大文件拆分成块,并维护 inode、目录和文件等元数据。例如,ext4 和 XFS 是 Linux 上常用的两种实现。
最后,操作系统通过名为虚拟文件系统(VFS)的统一 API,把不同文件系统暴露给应用。无论底层采用哪一种文件系统,应用都可以用同样的方式读写数据。
分布式文件系统(distributed filesystem)的工作方式与此非常相似。文件同样被拆分成块,只不过这些块分布在许多机器上。分布式文件系统的块通常比本地文件系统大得多:HDFS(Hadoop 分布式文件系统)的默认块大小为 128 MB,JuiceFS 和许多对象存储使用 4 MB 的块,而 ext4 的块只有 4,096 字节。块越大,需要跟踪的元数据就越少;对于 PB 级数据集,这种差异十分显著。相对于读取数据块所需的时间,大块也能降低寻道开销所占的比例。
大多数物理存储设备无法写入不完整的数据块,因此即使数据没有填满一个块,操作系统也必须为写入使用整个块。分布式文件系统的块更大,而且通常构建在操作系统文件系统之上,所以没有这种要求。例如,一个 900 MB 的文件采用 128 MB 的分块时,会由 7 个占用 128 MB 的块和 1 个占用 4 MB 的块组成。
读取分布式文件系统中的块,需要向集群中存放该块的机器发出网络请求。每台机器都运行一个守护进程,并公开一套 API,让远程进程能够读写以文件形式存储在其本地文件系统中的数据块。HDFS 把这些守护进程称为 DataNode,GlusterFS 则称为 glusterfsd。本书统一把它们称为 数据节点(data node)。
分布式文件系统还实现了分布式版本的页缓存。由于数据块以文件形式存放在数据节点上,读写操作会经过每个数据节点的操作系统,其中就包含内存页缓存。因此,经常读取的数据块会被缓存在数据节点的内存中。有些分布式文件系统还实现了更多缓存层,例如 JuiceFS 提供的客户端缓存和本地磁盘缓存。
ext4 和 XFS 等文件系统会跟踪空闲空间、文件块位置、目录结构和权限设置等存储元数据。分布式文件系统同样需要记录文件分散在哪些机器上、具有什么权限等信息。Hadoop 通过 NameNode 服务维护集群元数据;DeepSeek 的 3FS 则使用元数据服务,并把数据持久化到 FoundationDB 之类的键值存储中。
文件系统层之上是 VFS;在批处理中,与之最接近的是分布式文件系统的协议。分布式文件系统必须公开某种协议或接口,让批处理系统能够读写文件。它充当一套可插拔接口:只要实现该协议,任何分布式文件系统都可以接入。例如,MinIO、Cloudflare R2、Tigris 和 Backblaze B2 等许多存储系统都采用了 Amazon S3 API。支持 S3 的批处理系统,也就能够使用其中任何一种存储。
有些分布式文件系统提供与 POSIX 兼容的接口,在操作系统的 VFS 看来,它们与其他文件系统并无不同。这类系统通常通过用户空间文件系统(FUSE)或网络文件系统(NFS)协议接入 VFS。NFS 或许是最著名的分布式文件系统协议。它最初的用途,是让多个客户端读写单台服务器上的数据。近来,AWS Elastic File System(EFS)和 Archil 等文件系统提供了可伸缩得多、但仍与 NFS 兼容的分布式实现。NFS 客户端依旧只连接一个端点,不过这些系统会在内部与分布式元数据服务和数据节点通信,完成数据读写。
分布式文件系统以 无共享 原则为基础(参见“共享内存、共享磁盘与无共享架构”),不同于网络附加存储(NAS)和存储区域网络(SAN)架构采用的 共享磁盘 方法。共享磁盘存储由集中式存储设备实现,往往需要定制硬件和光纤通道等专用网络基础设施。相比之下,无共享方法不需要特殊硬件,只需用普通的数据中心网络连接计算机即可。
许多分布式文件系统构建在普通商用硬件上。这种硬件比较便宜,但故障率也高于企业级硬件。为了容忍机器和磁盘故障,文件块会复制到多台机器上。这样也便于调度器更均匀地分配工作负载,因为任务可以在任何存有其输入数据副本的节点上运行。这里的复制可以像第 6 章所述,在多台机器上保存若干份完整副本;也可以采用 Reed–Solomon 码等 纠删码(erasure coding),以低于完整复制的存储开销恢复丢失的数据 10 11 12。这些技术与 RAID 很相似,后者在连接到同一台机器的多个磁盘之间提供冗余;区别在于,分布式文件系统通过普通的数据中心网络访问和复制文件,不需要特殊硬件。
对象存储
Amazon S3、Google Cloud Storage、Azure Blob Storage 和 OpenStack Swift 等 对象存储(object storage)服务,已经成为批处理作业中分布式文件系统的常用替代方案。事实上,两者的界限有些模糊。正如上一节和“以对象存储为后端的数据库”中所述,用户空间文件系统(FUSE)驱动程序可以让用户把 S3 之类的对象存储当作文件系统使用。JuiceFS 和 Ceph 等分布式文件系统实现也同时提供对象存储与文件系统 API。不过,两类系统的 API、性能和一致性保证可能大相径庭。即使某个系统看似实现了所需的 API,采用之前也必须仔细确认它的实际行为符合预期。
对象存储中的每个对象都有一个 URL,例如 s3://my-photo-bucket/2025/04/01/birthday.png。URL 的主机部分(my-photo-bucket)表示存放对象的存储桶(bucket),后面的部分则是对象的 键(本例中为 /2025/04/01/birthday.png)。存储桶的名称在全局范围内唯一,而每个对象的键在所属存储桶内必须唯一。
对象通过 get 调用读取,通过 put 调用写入。与文件系统中的文件不同,对象写入后是不可变的;若要更新,只能像键值存储一样,通过 put 完整重写整个对象。Azure Blob Storage 和 S3 Express One Zone 支持追加写入,但大多数对象存储都不支持。对象存储也没有 fopen、fseek 之类的文件句柄 API。
对象看起来似乎按目录组织,但这有些误导,因为对象存储根本没有目录的概念。路径结构只是一种约定,斜杠本身也是对象键的一部分。这种约定允许你按特定前缀请求对象列表,实现类似目录列表的效果。不过,按前缀列出对象与文件系统列出目录有两点区别:
前缀
list操作类似于 Unix 系统上的递归ls -R:它会返回所有以该前缀开头的对象,其中也包括子路径下的对象。对象存储中不可能存在空目录。假如删除
s3://my-photo-bucket/2025/04/01下的所有对象,那么对s3://my-photo-bucket/2025/04调用list时,01就不会再出现。常见的做法是用一个零字节对象来表示空目录,例如创建空对象s3://my-photo-bucket/2025/04/01,这样即使所有子对象都已删除,它仍会保留下来。
分布式文件系统通常支持硬链接、符号链接、文件锁和原子重命名等常见文件操作,对象存储则没有这些功能。它们一般不支持链接和锁,重命名也不是原子的,而是先把对象复制到新键,再删除旧对象。如果想重命名一个“目录”,就必须逐一重命名其中的每个对象,因为目录名本身是对象键的一部分。
第 4 章讨论的键值存储针对小值(通常只有几 KB)以及频繁、低延迟的读写进行了优化。相比之下,分布式文件系统和对象存储通常针对大对象(数 MB 至数 GB)和频率较低、规模较大的读取进行了优化。不过最近,对象存储也开始支持更加频繁、规模更小的读写。例如,S3 Express One Zone 如今可以达到个位数毫秒延迟,其定价模型也更接近键值存储。
分布式文件系统与对象存储还有一个区别:HDFS 等分布式文件系统可以把计算任务安排在存有特定文件副本的机器上运行。任务就能直接读取本地文件,无需通过网络传输;如果任务的可执行代码远小于它要读取的文件,这样可以节省大量带宽。对象存储通常把存储与计算分开。这种做法可能消耗更多带宽,但现代数据中心网络的速度很快,因而往往可以接受。存储与计算解耦后,CPU、内存等计算资源还可以独立于存储容量进行伸缩。
分布式作业编排
操作系统的类比同样适用于作业编排。执行 Unix 批处理作业时,总要有某个组件真正运行 awk、sort、uniq 和 head 这些进程。它必须把一个进程的输出传到另一个进程的输入,为每个进程分配内存,在 CPU 上公平地调度并执行各进程的指令,实施内存和 I/O 边界,等等。在单台机器上,这些工作由操作系统内核负责;在分布式环境中,它们则由作业编排器承担。
批处理框架会向编排器的调度器发送运行作业的请求。启动作业的请求包含如下元数据:
要执行的任务数量;
每项任务所需的内存、CPU 和磁盘资源;
作业标识符;
访问凭据;
输入、输出数据等作业参数;
GPU 或磁盘类型等必要的硬件信息;
作业可执行代码所在的位置。
Kubernetes 和 Hadoop YARN(Yet Another Resource Negotiator)13 等编排器会结合这些信息与集群元数据,通过下列组件执行作业:
- 任务执行器(Task Executor)
集群中的每个节点都运行着执行器守护进程,例如 YARN 的 NodeManager 或 Kubernetes 的 kubelet。执行器负责运行作业任务,发送心跳来表明自己仍然存活,并跟踪节点上的任务状态与资源分配。执行器收到启动任务的请求后,会取得作业的可执行代码,并运行命令来启动任务。然后,它会监视进程,直到进程结束或失败,再相应更新任务状态元数据。
许多执行器还会与操作系统配合,同时提供安全隔离与性能隔离。例如,YARN 和 Kubernetes 都使用 Linux cgroups。这样既能防止任务访问无权访问的数据,也能防止任务过度使用资源、影响同一节点上其他任务的性能。
- 资源管理器(Resource Manager)
编排器的资源管理器保存每个节点的元数据,包括可用硬件(CPU、GPU、内存和磁盘等)、任务状态、网络位置、节点状态以及其他相关信息。因此,资源管理器能够提供集群当前状态的全局视图。资源管理器的中心化特性可能同时形成可伸缩性和可用性瓶颈。YARN 使用 ZooKeeper、Kubernetes 使用 etcd 来存储集群状态(参见“协调服务”)。
- 调度器(Scheduler)
编排器通常有一个中心化的调度子系统,负责接收启动、停止作业或查询作业状态的请求。例如,调度器可能收到一项请求:使用特定的 Docker 镜像,在配有某种 GPU 的节点上启动一项包含 10 个任务的作业。调度器根据请求中的信息和资源管理器保存的状态,决定把哪些任务放在哪些节点上运行。随后,它会把分配结果通知任务执行器,由执行器开始运行任务。
虽然各个编排器使用的术语不尽相同,但几乎所有编排系统中都能找到这些组件。
有些调度决策需要由应用专用的调度器来完成,以便考虑特定需求,例如在查询量达到某个阈值时自动扩展只读副本。中心调度器与应用专用调度器共同决定任务的最佳执行方式。YARN 把这种子调度器称为 ApplicationMaster,Kubernetes 则称为 operator。
资源分配
调度器在作业编排中扮演着格外棘手的角色:面对需求相互竞争的作业,它必须找出分配集群有限资源的最佳方式。从根本上说,调度决策需要在公平与效率之间取得平衡。
设想一个由五个节点组成的小型集群,总共有 160 个 CPU 核可用。集群调度器收到了两项作业请求,每项都希望使用 100 个核来完成工作。怎样调度才最好?
调度器可以同时为每项作业运行 80 个任务,等先前的任务完成后,再启动两项作业各自剩余的 20 个任务。
调度器也可以先运行一项作业的所有任务,等到有 100 个核可用时,再开始运行第二项作业。这种策略称为 成组调度(gang scheduling)。
一项作业请求会比另一项先到。调度器必须决定是把 100 个核全部分配给先到的作业,还是留下一些资源,为尚未到来的作业做准备。
这个例子非常简单,却已经暴露出许多艰难的权衡。以成组调度为例:如果调度器不断预留 CPU 核,直到 100 个核能够同时使用,那么一些节点就会闲置,集群的资源利用率也会下降;如果其他作业也试图预留 CPU 核,甚至还可能发生死锁。
另一方面,如果调度器只是等待 100 个核空闲,其他作业又可能在此期间抢走这些核。集群或许会在很长时间内都凑不出 100 个可用核,从而导致 饥饿(starvation)。调度器还可以 抢占(preempt)第一项作业的部分任务,终止它们来为第二项作业腾出空间。不过,抢占任务同样会降低集群效率,因为被终止的任务稍后需要重新启动、重新执行。
现在再设想一下,调度器必须为数百乃至数百万项这样的作业请求作出分配决策。要找到最优解似乎根本不可行。事实上,这个问题是 NP-hard 的;也就是说,除了规模最小的例子之外,计算最优解所需的时间长得令人无法接受 14 15。
因此,实际的调度器会采用启发式方法,作出虽非最优、但还算合理的决策。常见算法包括先进先出(FIFO)、主导资源公平(DRF)、优先级队列、基于容量或配额的调度,以及各种装箱算法。这些算法的细节超出了本书范围,但调度确实是一个十分有趣的研究领域。
工作流调度
本章开头的 Unix 工具示例由若干命令串联而成。分布式批处理也经常采用相同的模式:一项作业的输出需要成为另一项或多项作业的输入,而一项作业又可能有多个输入,分别由其他作业产生。这种作业结构称为 工作流(workflow),也称为作业的 有向无环图(directed acyclic graph,DAG)。
在“持久化执行与工作流”中,我们见过能够持久执行一系列步骤的工作流引擎,这些步骤通常会发出 RPC。在批处理的语境中,“工作流”有不同含义:它是一系列批处理过程,每个过程都接收输入数据、产生输出数据,通常不会向外部服务发出 RPC。持久化执行引擎通常会比批处理系统在每个请求中处理更少的数据,不过两者之间的界限并不十分清晰。
采用多项作业组成的工作流可能有几个原因:
如果一项作业的输出需要成为多项其他作业的输入,而且这些下游作业由不同团队维护,最好先让第一项作业把输出写到一个所有下游作业都能读取的位置。每当数据更新时,消费它的作业就可以安排运行,也可以按照其他时间表运行。
你可能需要把数据从一种处理工具传给另一种。例如,一项 Spark 作业把数据输出到 HDFS,随后由 Python 脚本触发 Trino SQL 查询(参见“云数据仓库”),继续处理 HDFS 文件,并把结果输出到 S3。
有些数据管道本身就需要多个处理阶段。例如,某个阶段需要按一个键分片数据,而下一阶段需要按另一个键分片,那么第一个阶段就可以按照第二阶段需要的方式对输出数据分片。
在 Unix 工具示例中,连接一项命令输出与另一项命令输入的管道只使用一个很小的内存缓冲区,并不会把数据写入文件。如果缓冲区已满,生产数据的进程就必须等待,直到消费进程从缓冲区中读走一部分数据,才能继续输出——这是一种 背压。Spark、Flink 等批处理执行引擎支持类似的模型,可以把一项任务的输出直接传给另一项任务;如果两项任务运行在不同机器上,数据就通过网络传输。
不过在工作流中,更常见的做法是让一项作业把输出写入分布式文件系统或对象存储,再由下一项作业从那里读取。这样可以使作业彼此解耦,在不同时间运行。如果一项作业有多个输入,工作流调度器通常要等到产生这些输入的所有作业都成功完成,才会运行消费这些输入的作业。
YARN ResourceManager 等编排框架中的调度器,以及 Spark 的内置调度器,都不会管理完整的工作流;它们只按单项作业进行调度。为了处理多次作业执行之间的依赖,人们开发了 Airflow、Dagster 和 Prefect 等工作流调度器。维护大量批处理作业时,这些调度器提供了非常有用的管理功能。许多数据管道的工作流通常包含 50 至 100 项作业;在大型组织中,还可能有许多团队运行不同的作业或工作流,跨越多个系统读取彼此的输出。管理这样复杂的数据流,离不开相应的工具支持。
故障处理
批处理作业往往会运行很长时间。一项包含许多并行任务、长时间运行的作业,很可能会在途中遇到至少一次任务失败。正如“硬件与软件故障”和“不可靠的网络”中所讨论的,这可能由许多原因造成,其中包括硬件故障(普通商用硬件上尤其常见)和网络中断。
任务无法完成的另一个原因,是调度器可能有意抢占(终止)它。当系统设置多个优先级时,抢占尤其有用:低优先级任务运行成本较低,高优先级任务则要付出更高成本。只要还有空闲计算容量,就可以运行低优先级任务;但如果一项高优先级任务到来,低优先级任务随时可能遭到抢占。这类价格较低的低优先级虚拟机,在 Amazon EC2 中称为 竞价实例(spot instance),在 Azure 中称为 竞价虚拟机(spot virtual machine),在 Google Cloud 中则称为 可抢占实例(preemptible instance)16。
批处理通常用于时效性要求不高的作业,因此很适合使用低优先级任务和竞价实例,以降低运行成本。实质上,这些作业利用了原本会被闲置的计算资源,从而提高集群利用率。不过,这也意味着调度器更可能终止这些任务:抢占发生的频率要高于硬件故障 17。
由于批处理作业每次运行都从头生成输出,任务失败要比在线系统中的故障容易处理:系统可以删除失败执行留下的不完整输出,再把任务安排到另一台机器上重新运行。不过,只因一项任务失败就重跑整个作业会非常浪费。因此,MapReduce 及其后继系统让并行任务彼此独立,从而可以按单项任务的粒度重试工作 3。
如果一项任务的输出要在工作流中成为另一项任务的输入,容错就会更加棘手。MapReduce 的办法是始终把这类中间数据写回分布式文件系统,并等待写入任务顺利完成,之后才允许其他任务读取数据。即使在抢占频繁的环境中,这种做法也能正常工作,但它要向分布式文件系统写入大量数据,效率可能很低。
Spark 把中间数据保存在内存中,必要时“溢写”到本地磁盘,只把最终结果写入分布式文件系统。它还会跟踪中间数据的计算过程,以便在数据丢失时重新计算 18。Flink 采用另一种方法,定期为任务状态的快照建立检查点 19。我们将在“数据流引擎”中再次讨论这个话题。
批处理模型
我们已经了解了分布式环境如何调度批处理作业。现在把注意力转向批处理框架实际处理数据的方式。最常见的两种模型是 MapReduce 和数据流引擎。虽然在实践中,数据流引擎已经基本取代 MapReduce,但理解 MapReduce 的工作原理仍然很有用,因为许多现代批处理框架都深受它的影响。
MapReduce 和数据流引擎已经逐渐支持多种编程模型,其中包括底层编程 API、关系查询语言和数据框 API。丰富的选择使应用工程师、分析工程师、业务分析师,甚至不具备技术背景的员工,都能够出于各种用途处理企业数据。我们将在“批处理用例”中讨论这些用途。
MapReduce
MapReduce 的数据处理模式与“简单日志分析”中的 Web 服务器日志示例非常相似:
读取一组输入文件,并把它们拆分成 记录。在 Web 服务器日志示例中,每条记录就是日志的一行(也就是说,
\n是记录分隔符)。在 Hadoop MapReduce 中,输入文件存储在 HDFS 之类的分布式文件系统,或 S3 之类的对象存储中。系统可以使用多种文件格式,例如 Apache Parquet(列式格式,参见“列式存储”)或 Apache Avro(行式格式,参见“Avro”)。对每条输入记录调用 mapper 函数,从中提取键和值。在 Unix 工具示例中,mapper 函数就是
awk '{print $7}':它提取 URL($7)作为键,并把值留空。按键对所有键值对排序。在日志示例中,这一步由第一个
sort命令完成。调用 reducer 函数,遍历排序后的键值对。如果同一个键出现多次,排序会让这些记录在列表中彼此相邻,因此不必在内存中保存大量状态,就能轻松合并这些值。在 Unix 工具示例中,reducer 由
uniq -c命令实现,它负责统计具有相同键的相邻记录数。
这四个步骤可以由一项 MapReduce 作业完成。第 2 步(map)与第 4 步(reduce)需要编写定制的数据处理代码。第 1 步(把文件拆成记录)由输入格式解析器负责。第 3 步的 sort 在 MapReduce 中是隐式的——mapper 的输出总会在传给 reducer 之前排序,所以不需要自行实现。排序是批处理中的基础算法,我们将在“混洗数据”中再次讨论。
要创建一项 MapReduce 作业,需要实现 mapper 和 reducer 两个回调函数,其行为如下:
- Mapper
每条输入记录都会调用一次 mapper,其任务是从输入记录中提取键和值。对于每条输入,它可以生成任意数量的键值对(也可以一个都不生成)。mapper 不会把某条输入记录的状态保留到下一条,因此每条记录都能独立处理。
- Reducer
MapReduce 框架接收 mapper 产生的键值对,收集属于同一个键的所有值,再用一个遍历该值集合的迭代器调用 reducer。reducer 可以生成输出记录,例如同一 URL 的出现次数。
在 Web 服务器日志示例中,第 5 步还有第二个 sort 命令,用于按请求次数排列 URL。在 MapReduce 中,如果需要第二个排序阶段,可以再编写一项 MapReduce 作业,把第一项作业的输出作为第二项的输入。从这个角度看,mapper 的作用是准备数据,把它转换成适合排序的形式;reducer 的作用则是处理已经排好序的数据。
MapReduce 虽然用于批处理,其编程模型却来自函数式编程。Lisp 最早引入了 map 和 reduce(也称 fold),把它们作为列表上的高阶函数;后来,Python、Rust 和 Java 等主流语言也采用了这些函数。包括 SQL 提供的操作在内,许多常见的数据处理操作都可以建立在 MapReduce 之上。两个函数乃至函数式编程整体所具备的一些重要性质,恰好能为 MapReduce 所用。map 与 reduce 可以相互组合,这非常适合数据处理(正如 Unix 示例所示)。map 还天然易于并行,因为每项输入都独立处理;reduce 则可以并行处理不同的键。
实际上,使用原始 MapReduce API 实现复杂的处理作业非常困难而且费力——例如,作业使用的任何连接算法都必须从头实现 20。与较新的批处理器相比,MapReduce 的速度也很慢。其中一个原因是,基于文件的 I/O 无法形成作业流水线:上游作业完成之前,下游作业不能开始处理它的输出。
数据流引擎
为了解决 MapReduce 的一些问题,人们开发了几种新的分布式批处理执行引擎,其中最著名的是 Spark 18 21 和 Flink 19。它们的设计方式各有不同,却有一个共同点:把整个工作流作为一项作业处理,而不是拆成彼此独立的子作业。
这些系统显式建模了数据流经多个处理阶段的过程,因此称为 数据流引擎(dataflow engine)。与 MapReduce 一样,它们提供底层 API,通过反复调用用户定义的函数,每次处理一条记录;同时也提供 连接(join)和 分组(grouping)等高层算子。它们通过对输入分片来并行执行工作,并把一项任务的输出复制到另一项任务,作为后者的输入;如果两项任务运行在不同机器上,复制就通过网络完成。与 MapReduce 不同,算子不必严格交替扮演 map 和 reduce 的角色,而可以以更加灵活的方式组合。
这些数据流 API 通常使用关系模型风格的构件来表达计算:按照某个字段的值连接数据集,按键对元组分组,根据某项条件过滤数据,以及通过计数、求和等函数聚合元组。这些操作在内部通过下一节讨论的混洗算法实现。
这类处理引擎建立在 Dryad 22 和 Nephele 23 等研究系统的基础之上。与 MapReduce 模型相比,它们有几个优点:
排序之类代价高昂的工作只需在确有必要之处执行,不必默认出现在每个 map 阶段与 reduce 阶段之间。
如果一连串算子都不改变数据集的分片方式(例如 map 或 filter),它们就可以合并成一项任务,从而减少复制数据的开销。
工作流中的所有连接和数据依赖都经过显式声明,因此调度器可以总览全局,了解各处需要哪些数据,并据此优化数据局部性。例如,它可以尝试把消费某项数据的任务放在产生该数据的任务所在机器上,这样便能通过共享内存缓冲区交换数据,无需通过网络复制。
算子之间的中间状态通常只需保存在内存中,或写入本地磁盘;这样所需的 I/O 少于写入分布式文件系统或对象存储,因为后者还要把数据复制到多台机器上,并在每个副本所在机器上写入磁盘。MapReduce 已经对 mapper 的输出采用了这种优化,数据流引擎则把这个思想推广到了所有中间状态。
算子可以在输入准备就绪后立即开始执行,无需等前一阶段全部结束,下一阶段才能开始。
现有进程可以重复用于运行新的算子,从而减少启动开销;相比之下,MapReduce 会为每项任务启动一个新的 JVM。
数据流引擎能够实现与 MapReduce 工作流相同的计算,而且得益于上述优化,执行速度通常快得多。
混洗数据
我们已经看到,本章开头的 Unix 工具示例和 MapReduce 都以排序为基础。批处理器必须能够对 PB 级的数据集排序,而这些数据不可能装入一台机器。因此,它们需要一种输入和输出都经过分片的分布式排序算法,这种算法称为 混洗(shuffle)。
“shuffle” 这个词容易引起误解:把一副扑克牌洗牌,会得到随机顺序;这里所说的混洗却会产生排好序的结果,其中不含任何随机性。
混洗是批处理器的一项基础算法,连接与聚合都要使用它。MapReduce、Spark、Flink、Daft、Dataflow 和 BigQuery 24 都实现了可伸缩的高性能混洗算法,以处理大型数据集。下面以 Hadoop MapReduce 中的混洗为例 25,不过本节的概念也适用于其他系统。
图 11-1 展示了一项 MapReduce 作业中的数据流。假设作业的输入已经分片,三个分片分别标为 m 1、m 2 和 m 3。例如,每个分片可以是 HDFS 中的单独文件,也可以是对象存储中的单独对象。同一数据集的全部分片,可以集中放在同一个 HDFS 目录中;在对象存储的存储桶里,它们也可以使用相同的键前缀。

框架会为每个输入分片启动一项单独的 map 任务。任务读取分配给它的文件,每次把一条记录传给 mapper 回调函数。计算的 reduce 端同样经过分片。map 任务的数量由输入分片数决定,而 reduce 任务的数量则由作业作者配置,两者可以不同。
mapper 的输出由键值对组成。框架必须保证:如果两个不同的 mapper 输出了相同的键,这些键值对最终会由同一个 reducer 任务处理。为此,每个 mapper 都会在本地磁盘上为每个 reducer 分别创建一个输出文件。例如,图 11-1中的文件 m 1, r 2 由 mapper 1 创建,包含发往 reducer 2 的数据。mapper 输出一个键值对时,通常会对键进行哈希,据此决定把它写入哪个 reducer 文件,这与“按键的哈希分片”相似。
mapper 在写入这些文件的同时,还会在每个文件中按键排列键值对。这里可以采用“日志结构存储”中见过的技术:先在内存的有序数据结构中收集一批键值对,再把它们写成有序段文件,然后逐步将较小的段合并成较大的段。
每个 mapper 完成后,reducer 会连接到它,并把属于自己的有序键值对文件复制到本地磁盘。reduce 任务取得所有 mapper 输出中属于自己的那一份后,会像归并排序一样合并这些文件,同时保持排序顺序。这样一来,即使具有相同键的键值对来自不同的 mapper,最终也会彼此相邻。随后,每个键都会调用一次 reducer 函数,并向它传入一个迭代器,用于返回该键对应的所有值。
reducer 函数产生的记录会顺序写入文件,每项 reduce 任务对应一个文件。图 11-1中的 r 1、r 2 和 r 3 就构成了作业输出数据集的三个分片,它们会被写回分布式文件系统或对象存储。
MapReduce 在 map 与 reduce 阶段之间执行混洗,而现代数据流引擎和云数据仓库则要精巧得多。BigQuery 等系统优化了混洗算法,尽量把数据保存在内存中,或把数据写入外部排序服务 24。这类服务既能加快混洗,又能通过复制混洗数据来提高容错能力。
JOIN 与 GROUP BY
下面来看有序数据如何简化分布式连接与聚合。为便于说明,我们仍以 MapReduce 为例,不过这些概念适用于大多数批处理系统。
图 11-2 展示了批处理作业中一个典型的连接示例。左侧是一份事件日志,记录已登录用户在网站上的操作,这些记录称为 活动事件(activity event),也叫 点击流数据(clickstream data);右侧则是用户数据库。这个例子可以看作星型模式的一部分(参见“星型与雪花型:分析模式”):事件日志是事实表,用户数据库则是其中一张维度表。

如果想结合用户数据库中的信息来分析活动事件——例如利用用户资料中的出生日期,了解某些页面更受年轻用户还是年长用户欢迎——就需要连接这两张表。假设两张表都大到必须分片,该如何计算这种连接?
可以利用 MapReduce 的一个性质:无论键值对最初位于哪个分片,混洗都会把具有相同键的键值对集中到同一个 reducer。这里可以把用户 ID 作为键。因此,我们可以编写一个 mapper 遍历用户活动事件,以用户 ID 为键,输出页面浏览的 URL,如图 11-3所示。另一个 mapper 逐行遍历用户数据库,提取用户 ID 作为键、用户出生日期作为值。

混洗随后确保 reducer 函数能够同时访问某位用户的出生日期,以及该用户的所有页面浏览事件。MapReduce 甚至可以安排记录的顺序,让 reducer 总是先看到用户数据库中的记录,接着再按时间戳顺序看到活动事件;这种技术称为 二次排序(secondary sort)25。
这样,reducer 就能轻松完成实际的连接逻辑。第一个值应当是出生日期,reducer 先把它保存在局部变量中,再遍历具有相同用户 ID 的活动事件,输出每个浏览过的 URL 以及浏览者的出生日期。reducer 会一次处理某个用户 ID 的全部记录,所以任何时刻只需在内存中保存一条用户记录,也完全不必发出网络请求。这种算法称为 排序合并连接(sort-merge join),因为 mapper 的输出按键排序,而 reducer 随后会合并连接两侧的有序记录列表。
工作流中的下一项 MapReduce 作业可以继续计算每个 URL 的浏览者年龄分布。它首先用 URL 作为键混洗数据;排序完成后,reducer 会遍历同一个 URL 的所有页面浏览记录(其中包含浏览者的出生日期),为各个年龄段维护浏览次数计数器,并为每条页面浏览记录递增相应的计数器。这样就实现了 分组(group by)操作和聚合。
查询语言
多年来,分布式批处理的执行引擎日趋成熟。如今,基础设施已经足够稳健,可以在超过 10,000 台机器的集群上存储和处理数 PB 数据。既然如此规模的批处理系统如何实际运行已经大体得到解决,人们就把注意力转向了编程模型的改进。
MapReduce、数据流引擎和云数据仓库都采用 SQL 作为批处理的通用语言。这是很自然的选择:传统数据仓库本来就使用 SQL,数据分析和 ETL 工具也已经支持 SQL,而且开发者和分析师无不熟悉 SQL。
与手写 MapReduce 作业相比,查询语言接口除了所需代码更少,还有一个明显的优点:它们可以交互使用。你可以编写分析查询,再从终端或图形界面运行。这种交互查询方式很高效也很自然,业务分析师、产品经理、销售和财务团队等人员都可以借此在批处理环境中探索数据。尽管它不是经典形式的批处理,SQL 支持仍然使探索性查询成为分布式批处理系统的一项适用场景。
高级查询语言不仅提高了使用系统的人所能达到的生产率,也能从机器层面提高作业执行效率。正如“云数据仓库”所述,查询引擎负责把 SQL 查询转换成在集群中执行的批处理作业。从查询转换到语法树、再转换成物理算子的过程,让引擎有机会优化查询。Hive、Trino、Spark 和 Flink 等查询引擎都提供基于代价的查询优化器,可以分析连接输入的特征,自动决定哪一种算法最适合眼前的任务。优化器甚至可以改变连接的顺序,以尽量减少中间状态 19 26 27 28。
SQL 是最流行的通用批处理查询语言,不过其他语言仍用于一些专门场景。Apache Pig 是一种以关系算子为基础的语言,允许用户逐步描述数据管道,而不是把所有逻辑写成一个庞大的 SQL 查询。数据框(见下一节)具有类似特征,Morel 则是受 Pig 影响的一种较新语言。还有一些用户采用 jq、JMESPath 或 JsonPath 等 JSON 查询语言。
在“图数据模型”中,我们讨论了如何用图来建模数据,以及如何用图查询语言遍历图中的边和顶点。许多图处理框架也支持通过查询语言进行批计算,例如 Apache TinkerPop 的 Gremlin。我们将在“批处理用例”中进一步讨论图处理的用例。
过去,数据仓库运行在专用硬件设备上,为关系数据提供 SQL 分析查询。相比之下,MapReduce 等批处理框架的目标是提供更强的可伸缩性与灵活性:它们支持使用通用编程语言编写处理逻辑,并允许读写任意数据格式。
随着时间推移,两者变得越来越相似。现代批处理框架如今支持用 SQL 编写批处理作业,并通过 Parquet 等列式存储格式和经过优化的查询执行引擎,在关系查询上取得了良好性能(参见“查询执行:编译与向量化”)。与此同时,数据仓库迁移到云端后,变得更加可伸缩(参见“云数据仓库”),并实现了许多与分布式批处理框架相同的调度、容错和混洗技术。其中许多系统也使用分布式文件系统。
正如批处理系统采用 SQL 作为处理模型一样,云数据仓库也采用了数据框等其他处理模型(见下一节)。例如,Google Cloud BigQuery 提供 BigQuery DataFrames 库,Snowflake 的 Snowpark 则与 pandas 集成。Airflow、Prefect 和 Dagster 等批处理工作流编排器同样能够集成云数据仓库。
当然,并非所有批处理作业都容易用 SQL 表达。PageRank 等迭代图算法、复杂的机器学习以及许多其他任务,都很难用 SQL 编写。AI 数据处理包含图像、视频和音频等非关系型多模态数据,同样很难用 SQL 完成。
此外,云数据仓库不擅长某些工作负载。使用列式存储格式时,逐行计算的效率较低;在这种情况下,最好使用数据仓库的其他 API,或者改用批处理系统。云数据仓库也往往比其他批处理系统昂贵。大型作业改在 Spark 或 Flink 等批处理系统上运行,可能更加经济。
归根结底,应该用批处理系统还是数据仓库来处理数据,取决于成本、便利性、实现难度、可用性等因素。大多数大型企业都拥有多套数据处理系统,因而可以灵活作出选择;小型公司则往往只靠一套系统就已足够。
数据框
随着数据科学家和统计学家开始使用分布式批处理框架进行机器学习,他们发现现有的处理模型用起来很麻烦,因为他们习惯的是 R 和 pandas 中的数据框模型(参见“数据框、矩阵与数组”)。数据框与关系数据库中的表相似:它由许多行组成,同一列中的所有值都具有相同类型。用户不必编写一条庞大的 SQL 查询,而是调用与关系算子对应的函数,执行过滤、连接、排序、分组等操作。
最初,数据框操作一般在本机内存中执行,因而只能处理单台机器能够容纳的数据集。数据科学家希望继续使用熟悉的数据框 API,与批处理环境中的大型数据集交互。Spark、Flink 和 Daft 等分布式数据处理框架为满足这种需求,也采用了数据框 API。不过,本地数据框通常带有索引并且有序,分布式数据框一般却不具备这些性质 29。因此,把程序迁移到批处理框架后,其性能可能出人意料。
数据框 API 看起来与数据流 API 相似,但具体实现各不相同。pandas 会在数据框方法被调用时立即执行操作;Apache Spark 则会先把所有数据框 API 调用转换成查询计划,经过查询优化,再在分布式数据流引擎上执行工作流。这样便能改善性能。
Daft 等框架甚至同时支持客户端与服务端计算:规模较小的内存操作在客户端执行,规模较大的数据集和计算则在服务端执行。Apache Arrow 等列式存储格式提供了统一的数据模型,可由客户端与服务端的执行引擎共享。
批处理用例
了解批处理如何工作之后,我们来看看它在各种应用中怎样发挥作用。批处理作业非常适合成批处理大型数据集,却不适合低延迟场景。因此,只要数据量很大、数据新鲜度又不重要,通常就能看到批处理作业。听起来这似乎是一个很大的局限,但事实证明,相当多的数据处理都符合这一模型:
会计与库存核对通常成批进行,企业借此检查交易是否与银行账户和库存相符 30。
制造业的需求预测由周期运行的批处理作业计算 31。
许多金融系统同样以批处理为基础。例如,美国的银行网络几乎完全依靠批处理作业运行 34。
下面几节将讨论几乎每个行业都能见到的一些批处理用例。
提取—转换—加载(ETL)
“数据仓库”介绍了 ETL 和 ELT:数据处理管道从生产数据库抽取数据,对其进行转换,再把结果加载到下游系统。本节用“ETL”同时指代 ETL 与 ELT 工作负载。这类工作负载经常由批处理作业完成,尤其是在下游系统为数据仓库时。
批处理作业天然具有并行性,因而非常适合数据转换。许多数据转换工作负载都易于并行:过滤数据、投影字段,以及其他许多常见的数据仓库转换,都可以并行完成。
批处理环境还配有稳健的工作流调度器,能够轻松安排、编排和调试 ETL 数据管道作业。发生故障时,调度器通常会重试作业,以消除可能出现的暂时性问题。作业若反复失败,就会被标记为失败,开发者可以很容易地看到数据管道中的哪项作业停止了工作。Airflow 等调度器甚至内置了 MySQL、PostgreSQL、Snowflake、Spark 和 Flink 等数十种流行系统的数据源、数据接收端及查询算子。调度器与数据处理系统的紧密集成简化了数据集成。
我们还看到,批处理作业出了问题之后很容易排查和修复;这一点在调试数据管道时尤其有用。可以直接检查有问题的文件,找出错误所在;修复 ETL 批处理作业后,再重新运行即可。例如,输入文件可能不再包含转换作业所要使用的某个字段。数据工程师发现字段缺失后,可以更新转换逻辑,或者修改产生该输入的作业。
过去,数据管道通常由一支数据工程团队统一管理,因为要求开发产品功能的其他团队编写和管理复杂的批处理数据管道并不公平。近来,批处理模型和元数据管理的改进,使组织中的工程师更容易参与和管理自己的数据管道。数据网格(data mesh)35 36、数据契约(data contract)37 和 数据编织(data fabric)38 等实践提供了标准与工具,帮助团队安全地发布数据,供组织中的任何人使用。
如今,数据管道与分析查询不仅开始共享处理模型,也开始共享执行引擎。许多批处理 ETL 作业与读取其输出的分析查询,会运行在同一套系统上。数据管道转换和分析查询都以 SparkSQL、Trino 或 DuckDB 查询来执行,已经十分常见。这样的架构进一步模糊了应用工程、数据工程、分析工程和业务分析之间的界限。
分析
在“分析型与事务型系统”中,我们看到分析查询(OLAP)经常扫描大量记录,并执行分组与聚合。这样的工作负载可以与其他批处理工作负载一起,在批处理系统中运行。分析师编写 SQL 查询,由查询引擎执行,并读写分布式文件系统或对象存储。表与文件之间的映射、名称和类型等表元数据,则通过 Apache Iceberg 等表格式和 Unity 等目录服务管理(参见“云数据仓库”)。这种架构称为 数据湖仓(data lakehouse)39。
与 ETL 一样,SQL 查询接口的改进使许多组织如今也使用 Spark 等批处理框架进行分析。这类查询模式分为两种:
预聚合查询(pre-aggregated query):把数据汇总成 OLAP 多维数据集或数据集市,以加快查询(参见“物化视图与多维数据集”)。预聚合数据可以在数据仓库中查询,也可以推送到 Apache Druid 或 Apache Pinot 等专用的实时 OLAP 系统。预聚合通常按固定周期进行,这类工作负载由“工作流调度”中讨论的工作流调度器管理。
即席查询(ad hoc query):用户运行查询来回答特定业务问题、调查用户行为、调试运行故障,以及完成其他许多工作。在这种场景中,响应时间很重要。分析师会反复运行查询,在得到响应、进一步了解正在研究的数据后,继续调整查询。能够快速执行查询的批处理框架,可以减少分析师的等待时间。
SQL 支持还让批处理框架能够与电子表格和 Tableau、Power BI、Looker、Apache Superset 等数据可视化工具集成。例如,Tableau 提供 SparkSQL 和 Presto 连接器;Apache Superset 则支持 Trino、Hive、Spark SQL、Presto 等许多最终会执行批处理作业来查询数据的系统。
机器学习
机器学习(ML)经常用到批处理。数据科学家、机器学习工程师和 AI 工程师使用批处理框架来探索数据规律、转换数据并训练机器学习模型。常见用途包括:
- 特征工程:对原始数据进行过滤和转换,使其能够用于训练模型。预测模型通常要求输入数值数据,因此工程师必须把文本或离散值等其他形式的数据转换成所需格式。
- 模型训练:训练数据是批处理过程的输入,训练所得的模型权重则是输出。
- 批量推理:训练好的模型可以对大量数据成批进行预测,适用于数据集很大而又不要求实时返回结果的情况,其中也包括在测试数据集上评估模型的预测效果。
批处理框架为这些场景提供了专门的工具。例如,Apache Spark 的 MLlib 和 Apache Flink 的 FlinkML 都内置了丰富的特征工程工具、统计函数和分类器。
推荐引擎、排序系统等机器学习应用也大量使用图处理(参见“图数据模型”)。许多图算法可以表述为:每次沿一条边遍历,将一个顶点与相邻顶点连接起来以传播某些信息,并不断重复,直到满足某项条件——例如没有更多的边可以继续遍历,或者某项指标已经收敛。
批量同步并行(bulk synchronous parallel,BSP)计算模型 40 已经成为批量处理图数据时的常用模型。Apache Giraph 20、Spark 的 GraphX API 和 Flink 的 Gelly API 41 等系统都实现了这一模型。它也称为 Pregel 模型,因为 Google 的 Pregel 论文推广了这种图处理方法 42。
批处理也是 大语言模型(LLM)数据准备与训练的重要组成部分。网站等原始文本输入通常存放在分布式文件系统或对象存储中,必须先经过预处理才能用于训练。适合交给批处理框架完成的预处理步骤包括:
- 从 HTML 中提取纯文本,并修复格式损坏的文本;
- 检测并删除质量低劣、内容无关或重复的文档;
- 对文本进行分词(拆分成单词),再将其转换成嵌入向量,也就是每个单词的数值表示。
Kubeflow、Flyte 和 Ray 等批处理框架就是为这类工作负载设计的。例如,OpenAI 在 ChatGPT 的训练过程中就使用了 Ray 43。这些框架内置了与 PyTorch、TensorFlow、XGBoost 等大语言模型和 AI 库的集成,并直接支持特征工程、模型训练、批量推理和微调(针对特定用例调整基础模型)等操作。
最后,数据科学家还经常在 Jupyter 或 Hex 等交互式笔记本中对数据进行实验。笔记本由若干 单元格(cell)组成,每个单元格都是一小段 Markdown、Python 或 SQL。按顺序执行这些单元格,可以生成电子表格、图表或数据。许多笔记本通过数据框 API 使用批处理系统,或者用 SQL 查询这类系统。
对外提供衍生数据
批处理作业经常用于构建预计算或衍生数据集,例如商品推荐、面向用户的报表,以及机器学习模型所需的特征。这些数据集通常由生产数据库、键值存储或搜索引擎对外提供。不论使用哪种系统,预计算数据最终都必须从批处理系统的分布式文件系统或对象存储,回到承载线上流量的数据库中。
最直观的选择或许是直接在批处理作业中调用数据库客户端库,逐条写入数据库服务器。这种方法确实能用——前提是防火墙规则允许批处理环境直接访问生产数据库——但基于以下几个原因,它并不是个好主意:
- 每条记录都发起一次网络请求,要比批处理任务的正常吞吐量慢几个数量级。即使客户端库支持批量写入,性能也很可能不理想。
- 批处理框架通常会并行运行许多任务。如果所有任务都以批处理应有的速率同时写入同一个输出数据库,数据库很容易不堪重负,查询性能也可能随之下降,继而给系统其他部分带来运行故障 44。
- 批处理作业通常会对作业输出提供干净利落的“全有或全无”保证:如果作业成功,那么即使途中有些任务失败并经过重试,结果也等同于每个任务都恰好一次执行所产生的输出;如果整个作业失败,则不会产生任何输出。然而,从作业内部写入外部系统会产生无法用这种方式隐藏的外部可见副作用。这样一来,就不得不考虑尚未完整的作业结果被其他系统看到的问题;任务失败并重新启动时,也可能重复写入失败执行已经产生的输出。
更好的方案是让批处理作业把预计算数据集推送到 Kafka 主题之类的流中,我们将在第 12 章中进一步讨论这种做法。Elasticsearch 等搜索引擎、Apache Pinot 和 Apache Druid 等实时 OLAP 系统、Venice 等衍生数据存储 45,以及 ClickHouse 等云数据仓库,都内置了从 Kafka 摄取数据的能力。让数据经过流系统,可以缓解上述问题中的一部分:
- 流系统针对顺序写入进行了优化,因此更适合批处理作业的大批量写入负载;
- 流系统还可以在批处理作业与生产数据库之间充当缓冲区。下游系统可以限制自己的读取速率,确保仍有足够能力承载线上流量;
- 同一个批处理作业的输出可以由多个下游系统消费;
- 流系统可以充当批处理环境与生产网络之间的安全边界:它可以部署在所谓的 DMZ(隔离区)网络中,位于批处理网络与生产网络之间。
不过,让数据经过流并不会自动解决前面提到的“全有或全无”保证问题。为此,批处理作业必须在完成时通知下游系统:作业已经完成,数据现在可以对外提供。流消费者则必须能够在收到完成通知之前,让接收到的数据对查询保持不可见,就像采用 读已提交(read committed)隔离级别时未提交的事务一样(参见“读已提交”)。
另一种模式在数据库初始化时更为常见:直接在批处理作业 内部 构建一个全新的数据库,再把分布式文件系统、对象存储或本地文件系统中的文件批量加载到该数据库中。许多数据系统都提供了相应的批量导入工具,例如 TiDB 的 Lightning 工具,以及 Apache Pinot 和 Apache Druid 的 Hadoop 导入作业。RocksDB 也提供了从批处理作业批量导入 SST 的 API。
通过批处理构建数据库并批量导入数据,速度非常快,也更便于系统在不同数据集版本之间进行原子切换。另一方面,由批处理作业构建全新数据库时,要增量更新数据集会比较困难。如果同时需要初始化和增量加载,通常会采用混合方案。例如,Venice 支持混合存储,既可以进行基于行的批量更新,也可以切换整个数据集。
本章小结
本章探讨了批处理系统的设计与实现。我们先从经典的 Unix 工具链(awk、sort、uniq 等)入手,以此说明排序、计数等基本的批处理原语。
接着,我们把规模扩大到分布式批处理系统。我们看到,批处理式 I/O 以不可变、有界的输入数据集为处理对象并生成输出数据,因而可以在不产生副作用的情况下重跑和调试。为了处理文件,批处理框架主要由三部分组成:决定作业在何时何地运行的编排层,持久化数据的存储层,以及实际处理数据的计算层。
我们了解了分布式文件系统与对象存储如何通过按块复制、缓存和元数据服务来管理大文件,以及现代批处理框架如何通过可插拔 API 与这些系统交互。我们还讨论了编排器如何在大型集群中调度任务、分配资源和处理故障,并比较了调度单个作业的作业编排器,与管理一组依赖图作业整个生命周期的工作流编排器。
我们考察了几种批处理模型,首先是 MapReduce 及其经典的 map 和 reduce 函数,随后转向 Spark、Flink 等数据流引擎;它们的数据流 API 更易使用,性能也更好。为了理解批处理作业如何扩展,我们还介绍了混洗(shuffle)算法——这项基础操作使分组、连接和聚合成为可能。
随着批处理系统逐渐成熟,关注点也转向了易用性。SQL 等高级查询语言和数据框 API 降低了批处理作业的使用门槛,也让它们更容易优化。查询优化器会把声明式查询转换成高效的执行计划。
最后我们回顾了批处理常见用例:
- ETL 数据管道:通过定时工作流在不同系统之间提取、转换和加载数据;
- 分析:批处理作业既支持预聚合的仪表板,也支持即席查询;
- 机器学习:批处理作业负责准备和处理大规模训练数据集;
- 用批处理输出填充面向生产流量的系统:通常经由流或批量加载工具,把衍生数据提供给用户。
下一章我们将转向流处理,其中的输入是 无界的(unbounded):作业依然存在,但它的输入是永无止境的数据流。由于任何时刻都可能有更多工作到来,作业永远不会完成。我们会看到,流处理与批处理在某些方面相似,但“流是无界的”这一假设也会在很大程度上改变系统的构建方式。
脚注
参考文献
Nathan Marz. How to Beat the CAP Theorem. nathanmarz.com, October 2011. Archived at perma.cc/4BS9-R9A4 ↩︎
Molly Bartlett Dishman and Martin Fowler. Agile Architecture. At O’Reilly Software Architecture Conference, March 2015. ↩︎
Jeffrey Dean and Sanjay Ghemawat. MapReduce: Simplified Data Processing on Large Clusters. At 6th USENIX Symposium on Operating System Design and Implementation (OSDI), December 2004. ↩︎ ↩︎
Shivnath Babu and Herodotos Herodotou. Massively Parallel Databases and MapReduce Systems. Foundations and Trends in Databases, volume 5, issue 1, pages 1–104, November 2013. doi:10.1561/1900000036 ↩︎
David J. DeWitt and Michael Stonebraker. MapReduce: A Major Step Backwards. Originally published at databasecolumn.vertica.com, January 2008. Archived at perma.cc/U8PA-K48V ↩︎
Henry Robinson. The Elephant Was a Trojan Horse: On the Death of Map-Reduce at Google. the-paper-trail.org, June 2014. Archived at perma.cc/9FEM-X787 ↩︎
Urs Hölzle. R.I.P. MapReduce. After having served us well since 2003, today we removed the remaining internal codebase for good. twitter.com, September 2019. Archived at perma.cc/B34T-LLY7 ↩︎
Adam Drake. Command-Line Tools Can Be 235x Faster than Your Hadoop Cluster. aadrake.com, January 2014. Archived at perma.cc/87SP-ZMCY ↩︎
sort: Sort text files. GNU Coreutils 9.7 Documentation, Free Software Foundation, Inc., 2025. ↩︎Michael Ovsiannikov, Silvius Rus, Damian Reeves, Paul Sutter, Sriram Rao, and Jim Kelly. The Quantcast File System. Proceedings of the VLDB Endowment, volume 6, issue 11, pages 1092–1101, August 2013. doi:10.14778/2536222.2536234 ↩︎
Andrew Wang, Zhe Zhang, Kai Zheng, Uma Maheswara G., and Vinayakumar B. Introduction to HDFS Erasure Coding in Apache Hadoop. blog.cloudera.com, September 2015. Archived at archive.org ↩︎
Andy Warfield. Building and operating a pretty big storage system called S3. allthingsdistributed.com, July 2023. Archived at perma.cc/7LPK-TP7V ↩︎
Vinod Kumar Vavilapalli, Arun C. Murthy, Chris Douglas, Sharad Agarwal, Mahadev Konar, Robert Evans, Thomas Graves, Jason Lowe, Hitesh Shah, Siddharth Seth, Bikas Saha, Carlo Curino, Owen O’Malley, Sanjay Radia, Benjamin Reed, and Eric Baldeschwieler. Apache Hadoop YARN: Yet Another Resource Negotiator. At 4th Annual Symposium on Cloud Computing (SoCC), October 2013. doi:10.1145/2523616.2523633 ↩︎
Richard M. Karp. Reducibility Among Combinatorial Problems. Complexity of Computer Computations. The IBM Research Symposia Series. Springer, 1972. doi:10.1007/978-1-4684-2001-2_9 ↩︎
J. D. Ullman. NP-Complete Scheduling Problems. Journal of Computer and System Sciences, volume 10, issue 3, June 1975. doi:10.1016/S0022-0000(75)80008-0 ↩︎
Gilad David Maayan. The complete guide to spot instances on AWS, Azure and GCP. datacenterdynamics.com, March 2021. Archived at archive.org ↩︎
Abhishek Verma, Luis Pedrosa, Madhukar Korupolu, David Oppenheimer, Eric Tune, and John Wilkes. Large-Scale Cluster Management at Google with Borg. At 10th European Conference on Computer Systems (EuroSys), April 2015. doi:10.1145/2741948.2741964 ↩︎
Matei Zaharia, Mosharaf Chowdhury, Tathagata Das, Ankur Dave, Justin Ma, Murphy McCauley, Michael J. Franklin, Scott Shenker, and Ion Stoica. Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing. At 9th USENIX Symposium on Networked Systems Design and Implementation (NSDI), April 2012. ↩︎ ↩︎
Paris Carbone, Stephan Ewen, Seif Haridi, Asterios Katsifodimos, Volker Markl, and Kostas Tzoumas. Apache Flink™: Stream and Batch Processing in a Single Engine. Bulletin of the IEEE Computer Society Technical Committee on Data Engineering, volume 38, issue 4, December 2015. Archived at perma.cc/G3N3-BKX5 ↩︎ ↩︎ ↩︎
Mark Grover, Ted Malaska, Jonathan Seidman, and Gwen Shapira. Hadoop Application Architectures. O’Reilly Media, 2015. ISBN: 978-1-491-90004-8 ↩︎ ↩︎
Jules S. Damji, Brooke Wenig, Tathagata Das, and Denny Lee. Learning Spark, 2nd Edition. O’Reilly Media, 2020. ISBN: 978-1492050049 ↩︎
Michael Isard, Mihai Budiu, Yuan Yu, Andrew Birrell, and Dennis Fetterly. Dryad: Distributed Data-Parallel Programs from Sequential Building Blocks. At 2nd European Conference on Computer Systems (EuroSys), March 2007. doi:10.1145/1272996.1273005 ↩︎
Daniel Warneke and Odej Kao. Nephele: Efficient Parallel Data Processing in the Cloud. At 2nd Workshop on Many-Task Computing on Grids and Supercomputers (MTAGS), November 2009. doi:10.1145/1646468.1646476 ↩︎
Hossein Ahmadi. In-memory query execution in Google BigQuery. cloud.google.com, August 2016. Archived at perma.cc/DGG2-FL9W ↩︎ ↩︎
Tom White. Hadoop: The Definitive Guide, 4th edition. O’Reilly Media, 2015. ISBN: 978-1-491-90163-2 ↩︎ ↩︎
Fabian Hüske. Peeking into Apache Flink’s Engine Room. flink.apache.org, March 2015. Archived at perma.cc/44BW-ALJX ↩︎
Mostafa Mokhtar. Hive 0.14 Cost Based Optimizer (CBO) Technical Overview. hortonworks.com, March 2015. Archived on archive.org ↩︎
Michael Armbrust, Reynold S. Xin, Cheng Lian, Yin Huai, Davies Liu, Joseph K. Bradley, Xiangrui Meng, Tomer Kaftan, Michael J. Franklin, Ali Ghodsi, and Matei Zaharia. Spark SQL: Relational Data Processing in Spark. At ACM International Conference on Management of Data (SIGMOD), June 2015. doi:10.1145/2723372.2742797 ↩︎
Kaya Kupferschmidt. Spark vs Pandas, part 2 – Spark. towardsdatascience.com, October 2020. Archived at perma.cc/5BRK-G4N5 ↩︎
Ammar Chalifah. Tracking payments at scale. bolt.eu.com, June 2025. Archived at perma.cc/Q4KX-8K3J ↩︎
Nafi Ahmet Turgut, Hamza Akyıldız, Hasan Burak Yel, Mehmet İkbal Özmen, Mutlu Polatcan, Pinar Baki, and Esra Kayabali. Demand forecasting at Getir built with Amazon Forecast. aws.amazon.com.com, May 2023. Archived at perma.cc/H3H6-GNL7 ↩︎
Jason (Siyu) Zhu. Enhancing homepage feed relevance by harnessing the power of large corpus sparse ID embeddings. linkedin.com, August 2023. Archived at archive.org ↩︎
Avery Ching, Sital Kedia, and Shuojie Wang. Apache Spark @Scale: A 60 TB+ production use case. engineering.fb.com, August 2016. Archived at perma.cc/F7R5-YFAV ↩︎
Edward Kim. How ACH works: A developer perspective — Part 1. engineering.gusto.com, April 2014. Archived at perma.cc/F67P-VBLK ↩︎
Zhamak Dehghani. How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh. martinfowler.com, May 2019. Archived at perma.cc/LN2L-L4VC ↩︎
Chris Riccomini. What the Heck is a Data Mesh?! cnr.sh, June 2021. Archived at perma.cc/NEJ2-BAX3 ↩︎
Chad Sanderson, Mark Freeman, B. E. Schmidt. Data Contracts. O’Reilly Media, 2025. ISBN: 9781098157623 ↩︎
Daniel Abadi. Data Fabric vs. Data Mesh: What’s the Difference? starburst.io, November 2021. Archived at perma.cc/RSK3-HXDK ↩︎
Michael Armbrust, Ali Ghodsi, Reynold Xin, and Matei Zaharia. Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics. At 11th Annual Conference on Innovative Data Systems Research (CIDR), January 2021. ↩︎
Leslie G. Valiant. A Bridging Model for Parallel Computation. Communications of the ACM, volume 33, issue 8, pages 103–111, August 1990. doi:10.1145/79173.79181 ↩︎
Stephan Ewen, Kostas Tzoumas, Moritz Kaufmann, and Volker Markl. Spinning Fast Iterative Data Flows. Proceedings of the VLDB Endowment, volume 5, issue 11, pages 1268-1279, July 2012. doi:10.14778/2350229.2350245 ↩︎
Grzegorz Malewicz, Matthew H. Austern, Aart J. C. Bik, James C. Dehnert, Ilan Horn, Naty Leiser, and Grzegorz Czajkowski. Pregel: A System for Large-Scale Graph Processing. At ACM International Conference on Management of Data (SIGMOD), June 2010. doi:10.1145/1807167.1807184 ↩︎
Richard MacManus. OpenAI Chats about Scaling LLMs at Anyscale’s Ray Summit. thenewstack.io, September 2023. Archived at perma.cc/YJD6-KUXU ↩︎
Jay Kreps. Why Local State is a Fundamental Primitive in Stream Processing. oreilly.com, July 2014. Archived at perma.cc/P8HU-R5LA ↩︎
Félix GV. Open Sourcing Venice – LinkedIn’s Derived Data Platform. linkedin.com, September 2022. Archived at archive.org ↩︎
12 流处理

有效的复杂系统总是从简单的系统演化而来。反之亦然:从零设计的复杂系统没一个能有效工作的。
—— 约翰・加尔,Systemantics(1975)
在 第 11 章 中,我们讨论了批处理技术:它以一组文件作为输入,并生成一组新的输出文件。输出是 衍生数据(derived data) 的一种形式;也就是说,如有必要,可以再次运行批处理来重新创建这份数据集。我们看到,这个简单而强大的思想可以用来构建搜索索引、推荐系统和分析系统,等等。
然而,第 11 章 始终建立在一个重要假设之上:输入是 有界的(bounded),也就是大小已知且有限,因此批处理知道何时已经读完输入。例如,作为 MapReduce 核心环节的排序操作必须先读完全部输入,才能开始生成输出。因为最后一条输入记录可能恰好拥有最小的键,因而需要成为第一条输出记录,所以不能提前开始输出。
实际上,许多数据都是 无界的(unbounded),因为它们会随时间推移陆续到达:用户昨天和今天产生了数据,明天还会继续产生更多数据。只要你的企业还在经营,这个过程就不会结束,因此从任何有意义的角度来看,数据集都永远不会“完整”1。所以,批处理程序不得不人为地按固定时长切分数据,例如每天结束时处理当天的数据,或每小时结束时处理这一小时的数据。
每日批处理的问题在于,输入中的变化要到一天后才会反映到输出中,对许多没有耐心的用户来说实在太慢。为了缩短延迟,可以更频繁地运行处理——比如每秒结束时处理这一秒的数据——也可以完全抛开固定的时间切片,改为连续处理,每个事件一发生就立即处理。这就是 流处理(stream processing) 的基本思想。
一般来说,“流”是指随时间推移逐渐可用的数据。这个概念出现在许多地方:Unix 的 stdin 和 stdout、编程语言中的惰性列表2、文件系统 API(例如 Java 的 FileInputStream)、TCP 连接、通过互联网传输的音频和视频,等等。
本章将把 事件流(event stream) 作为一种数据管理机制来考察:它是上一章批量数据的无界、增量处理版本。我们首先讨论如何表示、存储流,以及如何通过网络传输流;接着在“数据库与流”中研究流与数据库的关系;最后在“流处理”中探讨持续处理这些流的方法和工具,以及如何用它们构建应用。
传递事件流
在批处理领域,作业的输入和输出都是文件(可能位于分布式文件系统上)。那么,流处理领域中的对应物是什么?
当输入是文件(即字节序列)时,第一个处理步骤通常是把它解析成一系列记录。在流处理的语境中,记录更常被称为 事件(event),但两者本质上是同一种东西:一个小巧、自包含、不可变的对象,记录某个时刻发生的某件事。事件通常带有时间戳,表示按照日历时钟来看它发生在何时(参见“单调时钟与日历时钟”)。
例如,事件可能来自用户的某个操作,如浏览页面或完成购买;也可能来自机器,如温度传感器的定期测量值或 CPU 利用率指标。在“使用 Unix 工具的批处理”示例中,Web 服务器日志的每一行就是一个事件。
事件可以编码成文本字符串、JSON,或 第 5 章 讨论的某种二进制格式。编码后,你就可以存储事件,例如把它追加到文件、插入关系表,或写入文档数据库;也可以通过网络把事件发送到另一个节点进行处理。
在批处理中,文件写入一次,之后可能由多个作业读取。与之类似,在流处理术语中,事件由 生产者(producer)(也称为 发布者(publisher) 或 发送者(sender))生成一次,之后可能由多个 消费者(consumer)(也称为 订阅者(subscriber) 或 接收者(recipient))处理3。在文件系统中,文件名标识一组相关记录;在流式系统中,相关事件通常被归入同一个 主题(topic) 或 流(stream)。
原则上,文件或数据库足以把生产者和消费者连接起来:生产者将生成的每个事件写入数据存储,而各个消费者定期轮询数据存储,检查自上次运行以来出现了哪些新事件。这实质上就是每日结束时处理当天数据的批处理程序所做的事情。
然而,当我们转向低延迟的持续处理时,如果数据存储并非为这种用法而设计,轮询的代价就会很高。轮询越频繁,返回新事件的请求比例越低,额外开销也就越大。更好的做法是在出现新事件时通知消费者。
传统数据库对这种通知机制的支持并不好。关系数据库通常提供 触发器(trigger),可以对变更作出响应(例如向表中插入一行),但触发器能做的事情非常有限,在数据库设计中多少有些事后补充的意味4。因此,人们开发了专门用于传递事件通知的工具。
消息传递系统
向消费者通知新事件的一种常见方法是使用 消息传递系统(messaging system):生产者发送包含事件的消息,再由系统将消息推送给消费者。我们之前在“事件驱动的架构”中提到过这类系统,现在来进一步了解其细节。
在生产者与消费者之间建立 Unix 管道或 TCP 连接等直接通信信道,是实现消息传递系统的一种简单方法。不过,大多数消息传递系统都扩展了这个基本模型。Unix 管道和 TCP 恰好连接一个发送者与一个接收者,而消息传递系统允许多个生产者节点向同一主题发送消息,也允许多个消费者节点接收一个主题中的消息。
在这种 发布/订阅 模型中,不同系统采取了五花八门的方法,没有一种答案适合所有用途。要区分这些系统,下面两个问题尤其有用:
如果生产者发送消息的速度超过消费者的处理速度,会发生什么? 大体上有三种选择:系统可以丢弃消息、把消息缓存在队列中,或施加 背压(backpressure)(也称为 流量控制(flow control),即阻塞生产者,令其暂停发送更多消息)。例如,Unix 管道和 TCP 都采用背压:它们有一个固定大小的小缓冲区;如果缓冲区已满,发送者就会被阻塞,直到接收者从中取走数据(参见“网络拥塞与排队”)。
如果消息被缓存在队列中,就必须弄清楚队列不断增长会有什么后果:队列大到内存容纳不下时,系统会崩溃,还是会把消息写入磁盘?如果写入磁盘,磁盘访问会怎样影响消息传递系统的性能5?磁盘写满时又会发生什么6?
如果节点崩溃或暂时离线,会发生什么——是否会丢失消息? 和数据库一样,要实现持久性,可能需要以某种方式组合使用磁盘写入与复制(参见侧栏“复制与持久性”),而这会付出代价。如果能够容忍偶尔丢失消息,那么在同样的硬件上,通常可以获得更高的吞吐量和更低的延迟。
能否容忍消息丢失,很大程度上取决于应用。例如,对于定期发送的传感器读数和指标,偶尔缺失一个数据点或许并不重要,因为不久后还会发来更新值。不过要小心:如果大量消息被丢弃,你可能无法立即察觉指标已经失真7。如果你要对事件计数,可靠传递就重要得多,因为每丢失一条消息,计数器就会出现一份误差。
我们在 第 11 章 探讨的批处理系统有一个很好的特性:它们提供了很强的可靠性保证。失败的任务会自动重试,失败任务产生的部分输出会自动丢弃。因此,最终输出与从未发生故障时相同,这简化了编程模型。本章后面将考察如何在流处理环境中提供类似的保证。
直接从生产者传递给消费者
许多消息传递系统让生产者与消费者直接通过网络通信,不经过任何中间节点:
UDP 组播广泛用于金融行业中的股票行情等数据流,因为这些场景十分看重低延迟8。尽管 UDP 本身并不可靠,但应用层协议可以恢复丢失的数据包(生产者必须记住已发送的数据包,以便按需重传)。
ZeroMQ 和 nanomsg 等无代理消息库采用类似的方法,通过 TCP 或 IP 组播实现发布/订阅消息传递。
StatsD 等指标收集代理9使用不可靠的 UDP 消息,从网络中的所有机器收集指标并进行监控。(在 StatsD 协议中,只有收到全部消息,计数器指标才是准确的;使用 UDP 意味着这些指标至多只能是近似值10。另见“TCP 与 UDP”。)
如果消费者在网络上公开了一项服务,生产者可以直接发起 HTTP 或 RPC 请求(参见“流经服务的数据流:REST 与 RPC”),把消息推送给消费者。Webhook11就建立在这一思想之上:把一个服务的回调 URL 注册到另一个服务中,后者每逢事件发生便向该 URL 发出请求。
尽管这些直接消息传递系统在各自的目标场景中表现良好,但应用代码通常必须自行考虑消息丢失的可能性。它们能容忍的故障十分有限:即使协议可以检测并重传网络中丢失的数据包,通常仍会假设生产者和消费者始终在线。
消费者离线时,可能会错过其不可达期间发送的消息。有些协议允许生产者重试失败的消息传递,但如果生产者崩溃,丢失了本应重试的消息缓冲区,这种办法就可能失效。
消息代理
一种广泛使用的替代方案是通过 消息代理(message broker)(也称为 消息队列(message queue))发送消息。消息代理实质上是一类针对消息流优化的数据库12。它作为服务器运行,生产者和消费者则作为客户端连接到它。生产者把消息写入代理,消费者通过读取代理来接收消息。
数据集中到代理之后,系统更容易容忍客户端时而连接、时而断开乃至崩溃,持久性问题也转移给了代理。有些消息代理只把消息保存在内存中,另一些则会根据配置把消息写入磁盘,以免代理崩溃时丢失消息。面对缓慢的消费者,它们通常允许队列无限增长,而不是丢弃消息或施加背压,不过具体行为也可能取决于配置。
排队还有一个后果:消费者通常是 异步的。生产者发送消息时,一般只等待代理确认消息已被缓存,并不等待消费者完成处理。消息会在未来某个无法确定的时间点传递给消费者——往往不到一秒,但如果队列中积压了大量消息,也可能晚得多。
消息代理与数据库的对比
有些消息代理甚至可以通过 XA 或 JTA 参与两阶段提交协议(参见“跨不同系统的分布式事务”)。这一功能使它们在性质上与数据库十分相似,不过消息代理与数据库之间仍有一些重要的实际差异:
数据库通常会一直保存数据,直到有人显式删除;而有些消息代理会在消息成功传递给消费者后自动将其删除。这类消息代理不适合长期存储数据。
正因为消息会很快删除,大多数消息代理假定工作集相当小,也就是队列很短。如果消费者缓慢,导致代理必须缓冲大量消息(内存容纳不下时还可能溢写到磁盘),每条消息的处理时间就会延长,总体吞吐量也可能下降5。
数据库通常支持二级索引,并能通过查询语言以多种方式搜索数据;消息代理通常只支持订阅与某种模式匹配的一组主题。两者本质上都让客户端选择自己关心的数据子集,但数据库提供的查询功能通常强大得多。
查询数据库时,结果通常以某一时刻的数据快照为依据;如果另一个客户端随后写入数据库并改变了查询结果,第一个客户端不会知道先前的结果已经过时,除非再次执行查询或轮询变更。相比之下,消息代理不支持任意查询,也不允许修改已经发出的消息,但会在数据发生变化时(即有新消息可用时)通知客户端。
这是消息代理的传统形态,JMS13、AMQP14 等标准对它作出了规范,RabbitMQ、ActiveMQ、HornetQ、Qpid、TIBCO Enterprise Message Service、IBM MQ、Azure Service Bus 和 Google Cloud Pub/Sub 等软件则实现了这种形态15。尽管也可以把数据库用作队列,但要把性能调到理想水平并不容易16。
多个消费者
多个消费者读取同一主题中的消息时,主要有两种消息传递模式,如 图 12-1 所示:
- 负载均衡
每条消息只传递给 一个 消费者,因此多个消费者可以分担处理该主题消息的工作。代理可以任意把消息分配给消费者。如果消息处理成本很高,而你希望通过增加消费者来并行处理,便适合采用这种模式。(在 AMQP 中,可以让多个客户端消费同一个队列来实现负载均衡;在 JMS 中,这称为 共享订阅(shared subscription)。)
- 扇出
每条消息都传递给 所有 消费者。扇出让几个相互独立的消费者都能“收听”同一份消息广播,彼此互不影响——相当于流处理版本的“几个不同批处理作业读取同一个输入文件”。(JMS 的主题订阅和 AMQP 的交换器绑定提供了这一功能。)

这两种模式可以结合使用,例如 Kafka 的 消费者组(consumer group) 功能。消费者组订阅某个主题后,该主题中的每条消息都会发送给组内的一个消费者(在组内消费者之间进行负载均衡)。如果两个不同的消费者组订阅同一主题,那么每条消息都会发送给各组中的一个消费者(在消费者组之间实现扇出)。
确认应答与重新传递
消费者随时可能崩溃,因此代理可能已经把消息传递给消费者,但消费者尚未处理,或只处理了一部分便发生崩溃。为了确保消息不会丢失,消息代理采用 确认应答(acknowledgment):客户端处理完消息后,必须明确告知代理,代理才能将消息从队列中移除。
如果客户端连接关闭或超时,而代理尚未收到确认应答,代理便假定消息没有得到处理,并把它重新传递给另一个消费者。(请注意,消息可能 实际上已经 处理完毕,只是确认应答在网络中丢失了。除非该操作具有幂等性,或不要求恰好一次语义,否则必须使用原子提交协议来处理这种情况,详见“恰好一次消息处理”。)
重新传递与负载均衡结合后,会对消息顺序产生一个有趣的影响。在 图 12-2 中,消费者通常按照生产者发送消息的顺序进行处理。但是,消费者 2 在处理消息 m3 时崩溃,与此同时消费者 1 正在处理消息 m4。尚未确认的消息 m3 随后被重新传递给消费者 1,于是消费者 1 按照 m4、m3、m5 的顺序处理消息。因此,m3 和 m4 的传递顺序与生产者 1 的发送顺序不同。

即使消息代理试图保持消息顺序(JMS 和 AMQP 标准都作此要求),负载均衡与重新传递的结合仍不可避免地会使消息发生重排。要避免这个问题,可以为每个消费者使用单独的队列,也就是不使用负载均衡。如果消息彼此完全独立,重排并无大碍;但如果消息之间存在因果依赖,顺序就可能十分重要,本章后面将看到这一点。
重新传递还可能浪费资源、造成资源饥饿,甚至永久阻塞一条流。常见情形是生产者没有正确序列化消息,例如编码成 JSON 的对象缺少必填键。任何读到这条消息的消费者都会期待该键存在,并在发现缺失时失败。由于没有发出确认应答,代理会再次发送消息,使另一个消费者也随之失败,如此无限循环。如果代理提供严格的顺序保证,后续处理将完全无法推进。允许消息重排的代理仍能继续处理其他消息,却会把资源浪费在永远得不到确认的消息上。
死信队列(dead letter queue,DLQ) 用来处理这类问题。系统不再把消息留在当前队列中无限重试,而是将其移到另一条队列,让消费者能够继续前进17、18。通常会对死信队列设置监控——队列中出现任何消息都意味着发生了错误。检测到新消息后,操作员可以决定永久丢弃它、手动修改后重新生产这条消息,或修复消费者代码,使其能够正确处理消息。大多数队列系统都提供 DLQ;如今,Apache Pulsar 等基于日志的消息系统以及 Kafka Streams 等流处理系统也开始支持它19。
基于日志的消息代理
通过网络发送数据包或向网络服务发出请求,通常都是转瞬即逝的操作,不会留下永久痕迹。尽管可以通过抓包和日志记录把这些操作永久保存下来,但我们通常不会这样看待它们。AMQP/JMS 风格的消息代理继承了这种临时消息传递的思路:即使把消息写入磁盘,也会在消息传递给消费者后很快将其删除。
数据库和文件系统的思路恰恰相反:凡是写入数据库或文件的内容,通常都应该永久保存,至少要保存到有人明确决定再次删除它为止。
这种思路上的差异会极大地影响衍生数据的创建方式。正如 第 11 章 所说,批处理的一项关键特性是可以反复运行,试验不同的处理步骤,又不用担心损坏输入,因为输入是只读的。AMQP/JMS 风格的消息传递却并非如此:如果确认应答会让代理删除消息,那么接收消息就是一种破坏性操作。你无法重新运行同一个消费者,并期望得到同样的结果。
向消息传递系统加入新消费者时,它通常只能接收注册之后发出的消息;先前的消息早已消失,无法恢复。相比之下,文件和数据库可以随时加入新客户端,并读取任意久远的数据,只要应用没有明确覆盖或删除这些数据。
为什么不能把两者结合起来,既采用数据库的持久存储方式,又具备消息传递的低延迟通知能力?这就是 基于日志的消息代理(log-based message broker) 的思想。近年来,这类系统已经十分流行。
使用日志进行消息存储
日志就是磁盘上一系列仅追加的记录。我们此前在 第 4 章 讨论日志结构存储引擎和预写日志时、在 第 6 章 讨论复制时,以及在 第 10 章 把日志作为一种共识形式来讨论时,都见过这种结构。
同一种结构也可以用来实现消息代理:生产者把消息追加到日志末尾,以此发送消息;消费者顺序读取日志,以此接收消息。消费者读到日志末尾后,便等待新消息追加的通知。用于监视文件新增内容的 Unix 工具 tail -f,实质上的工作方式与此相同。
为了把吞吐量扩展到单块磁盘的能力之上,可以对日志进行 分片(即 第 7 章 所说的分片)。不同分片可以托管在不同机器上,每个分片都是一份独立于其他分片读写的日志。一个主题可以定义为一组承载相同类型消息的分片。图 12-3 展示了这种方法。
在每个分片中——Kafka 把它称为 分区(partition)——代理会为每条消息分配一个单调递增的序列号,也就是 偏移量(offset)(图 12-3 方框中的数字就是消息偏移量)。分区是仅追加的,因此这样的序列号有明确含义:分区内的消息具有全序,而不同分区之间没有顺序保证。

Apache Kafka20 和 Amazon Kinesis Streams 都是以这种方式工作的基于日志的消息代理。Google Cloud Pub/Sub 的架构与之相似,但公开的是 JMS 风格的 API,而不是日志抽象15。尽管这些消息代理会把所有消息写入磁盘,但通过跨多台机器分片,仍能达到每秒数百万条消息的吞吐量,并通过复制消息实现容错21、22。
日志与传统消息传递的比较
基于日志的方法自然支持扇出式消息传递,因为多个消费者可以各自读取日志而互不影响——读取消息不会把它从日志中删除。要在一组消费者之间实现负载均衡,代理可以把整个分片分配给消费者组中的节点,而不是把一条条消息分别分配给各个消费者客户端。
随后,每个客户端会消费所分配分片中的 全部 消息。消费者得到一个日志分片后,通常会采用直截了当的单线程方式,顺序读取其中的消息。这种粗粒度负载均衡有一些缺点:
分担主题消费工作的节点数,最多只能等于该主题的日志分片数,因为同一分片内的消息都传递给同一个节点。(也可以设计一种让两个消费者共同处理一个分片的负载均衡方案:两者都读取完整消息集,但一个只处理偏移量为偶数的消息,另一个只处理偏移量为奇数的消息。另一种办法是把消息处理分派给线程池,但这会使消费者偏移量的管理更加复杂。一般来说,最好还是用单线程处理一个分片,并通过增加分片来提高并行度。)
如果某一条消息处理得很慢,就会阻塞该分片中后续消息的处理,这是一种队头阻塞(参见“描述性能”)。
因此,如果消息处理成本很高,你希望以消息为单位并行处理,而且消息顺序并不十分重要,那么 JMS/AMQP 风格的消息代理更合适。反之,如果消息吞吐量很高,每条消息都能迅速处理,而且顺序非常重要,基于日志的方法就表现出色23、24。不过,两种架构之间的界线正在变得模糊:Kafka 等基于日志的消息系统如今也支持 JMS/AMQP 风格的消费者组,让多个消费者能够接收同一分区中的消息25、26。
由于分片日志通常只能保持单个分片内部的消息顺序,所有必须以一致顺序处理的消息都需要路由到同一个分片。例如,应用可能要求与某个特定用户有关的事件始终以固定顺序出现。可以根据事件的用户 ID 选择分片来实现这一点;换句话说,把用户 ID 作为 分区键(partition key)。
消费者偏移量
顺序消费一个分片,很容易判断哪些消息已经处理:偏移量小于消费者当前偏移量的消息都已处理,偏移量更大的消息则尚未读到。因此,代理无需跟踪每条消息的确认应答,只需定期记录消费者偏移量。这样既减少了簿记开销,也带来了批量处理和流水线化的机会,有助于提高基于日志系统的吞吐量。不过,如果消费者发生故障,它会从上次记录的偏移量恢复,而不是从自己实际读到的最新位置恢复,因此可能会再次读到一些消息。
这种偏移量其实与单主数据库复制中常见的 日志序列号 非常相似,我们曾在“设置新的副本”中讨论过它。在数据库复制中,日志序列号允许追随者断开连接后重新连接到领导者,并且不跳过任何写入就恢复复制。这里采用的原理完全相同:消息代理扮演领导者数据库的角色,消费者则像追随者。
如果消费者节点发生故障,消费者组会把它的分片分配给另一个节点,后者从最后记录的偏移量开始消费。如果原消费者已经处理了后续消息,却尚未记录相应的偏移量,那么重启后这些消息会被再次处理。本章后面将讨论如何应对这一问题。
磁盘空间使用
如果永远只向日志追加内容,磁盘空间终有耗尽之时。为了回收空间,日志实际上会被切成若干段,旧段会不时被删除或移入归档存储。(我们将在“日志压实”中讨论一种更复杂的空间回收方法。)
这意味着,如果缓慢的消费者跟不上消息产生的速度,落后到其偏移量指向已经删除的日志段,就会错过一些消息。实际上,日志实现了一个大小有限的缓冲区,填满后便丢弃旧消息,也就是 循环缓冲区(circular buffer) 或 环形缓冲区(ring buffer)。不过,由于这个缓冲区位于磁盘上,它可以相当大。
让我们粗略估算一下。在本书写作时,典型的大容量硬盘为 20 TB,顺序写入吞吐量为 250 MB/s。如果始终以最高速度写入消息,大约 22 小时后磁盘就会写满,必须开始删除最旧的消息。这意味着,即使有许多机器和许多磁盘,磁盘日志也总能缓冲至少 22 小时的消息,因为增加磁盘会同时增加可用空间和总写入带宽。实际部署很少用满磁盘的全部写入带宽,所以日志通常可以保存数天乃至数周的消息。
许多基于日志的消息代理如今会把消息存入对象存储,以扩大存储容量,这与“以对象存储为后端的数据库”中讨论的做法相似。Apache Kafka 和 Redpanda 等消息代理通过分层存储从对象存储提供较旧的消息;WarpStream、Confluent Freight 和 Bufstream 等系统则把全部数据都存入对象存储。除了成本效益,这种架构也简化了数据集成:对象存储中的消息以 Iceberg 表保存,批处理作业和数据仓库作业可以直接在这些数据上运行,无需先把数据复制到另一个系统。
当消费者跟不上生产者时
在“消息传递系统”开头,我们讨论了消费者跟不上生产者发送消息的速度时可采取的三种办法:丢弃消息、缓冲消息或施加背压。按照这种分类,基于日志的方法属于缓冲,它提供了一个很大但大小固定的缓冲区,其上限由可用磁盘空间决定。
如果消费者远远落后,需要的消息已经早于磁盘保留范围,它就无法再读取这些消息——也就是说,代理实际上会丢弃超出缓冲容量的旧消息。你可以监控消费者落后日志头部多远,并在落后过多时发出告警。由于缓冲区很大,通常有足够时间让运维人员修复缓慢的消费者,并在它开始漏掉消息前追上进度。
即使某个消费者确实落后太多并开始漏掉消息,也只有它自己受到影响,不会干扰其他消费者的服务。这是一项很大的运维优势:你可以出于开发、测试或调试目的,试验性地消费生产日志,不必太担心干扰生产服务。消费者关闭或崩溃后便不再消耗资源,唯一留下的只是它的偏移量。
这种行为也与传统消息代理形成鲜明对比。在传统代理中,必须小心删除消费者已经关闭的队列,否则这些队列会继续积累不再需要的消息,挤占仍在活动的消费者可用的内存。
重播旧消息
前面提到,对于 AMQP/JMS 风格的消息代理,处理并确认消息是一种破坏性操作,因为这会使代理删除消息。而在基于日志的消息代理中,消费消息更像读取文件:它是一种不会改变日志的只读操作。
除了消费者本身产生的输出,处理消息唯一的副作用就是消费者偏移量向前移动。但偏移量由消费者控制,所以必要时很容易调整。例如,可以用昨天的偏移量启动一份消费者副本,把输出写到另一个位置,从而重新处理过去一天的消息。你可以任意重复这个过程,每次换用不同的处理代码。
这一特性让基于日志的消息传递更像上一章的批处理:通过可重复执行的转换过程,把衍生数据与输入数据明确分开。它为试验提供了更多空间,也更容易从错误和程序缺陷中恢复,因此很适合用来集成组织内部的数据流27。
数据库与流
前面我们对消息代理与数据库做过一些比较。传统上,它们被视为两类不同的工具,但基于日志的消息代理已经成功地把数据库中的思想用于消息传递。反过来也一样:我们可以把消息传递和流中的思想用于数据库。
一种做法是用 事件流充当存储数据的权威记录系统(参阅 “权威记录系统与衍生数据”)。这正是我们在 “事件溯源与 CQRS” 中讨论过的 事件溯源(event sourcing):不再用更新和删除来改变数据模型,而是把每次状态变化建模成不可变事件,写入仅追加日志;所有为读取优化的物化视图都从这些事件中衍生出来。基于日志的消息代理采用仅追加存储,还能以低延迟通知消费者有新事件到来,因此很适合事件溯源——只要将其配置为永不删除旧事件。
不过,你不必走到采用事件溯源这一步;即便数据模型是可变的,事件流对数据库仍然很有用。事实上,每次数据库写入都是一个可以捕获、存储和处理的事件。数据库与流的联系不只是日志在磁盘上的物理存储形式,而是更为根本。
例如,复制日志(参阅 “复制日志的实现”)就是数据库写入事件组成的流,由领导者在处理事务时生成。追随者把这股写入流应用到自己的数据库副本上,最终得到同一份数据的准确副本。复制日志中的事件描述的正是已经发生的数据变化。
我们还在 “使用共享日志” 中遇到过 状态机复制(state machine replication)原理:如果每个事件都代表一次数据库写入,并且每个副本都以相同顺序处理相同事件,那么所有副本最终都会达到相同状态(这里假定事件处理是确定性的操作)。这又是事件流的一个例子!
本节先考察异构数据系统中会出现的一个问题,再探讨如何把事件流的思想引入数据库来解决它。
保持系统同步
正如全书反复说明的,没有一个系统能够满足所有数据存储、查询和处理需求。实践中,大多数稍具规模的应用都要组合多种技术才能满足要求:例如用 OLTP 数据库处理用户请求,用缓存加速常见请求,用全文索引处理搜索查询,再用数据仓库进行分析。每个系统都有自己的数据副本,并采用为自身用途优化的表示形式。
相同或相关的数据分散在不同位置,就必须彼此保持同步:数据库中的某个项目更新后,缓存、搜索索引和数据仓库也要随之更新。数据仓库通常通过 ETL 流程完成同步(参阅 “数据仓库”):先取得数据库的完整副本,转换数据,再批量加载进数据仓库——换言之,这是一个批处理过程。同样,我们在 “批处理用例” 中看到,搜索索引、推荐系统以及其他衍生数据系统也可以通过批处理来创建。
如果定期转储完整数据库太慢,有时会改用 双写(dual write):数据发生变化时,应用代码显式写入每个系统,例如先写数据库,再更新搜索索引,最后使相应的缓存项失效(也可能并发执行这些写入)。
然而,双写存在一些严重问题,其中之一就是 图 12-4 所示的竞态条件。在这个例子中,两个客户端并发更新项目 X:客户端 1 想把值设为 A,客户端 2 想把值设为 B。两个客户端都先把新值写入数据库,再写入搜索索引。由于时序不巧,请求交错执行:数据库先收到客户端 1 将值设为 A 的写入,再收到客户端 2 将值设为 B 的写入,因此数据库中的最终值为 B;搜索索引却先收到客户端 2 的写入,再收到客户端 1 的写入,因此最终值为 A。虽然没有发生任何错误,两个系统却永久地不一致了。

除非另外采用并发检测机制,例如我们在 “检测并发写入” 中讨论的版本向量,否则你甚至不会察觉发生过并发写入——一个值只会悄无声息地覆盖另一个值。
双写的另一个问题是,其中一次写入可能失败,另一次却成功。这属于容错问题而不是并发问题,但同样会使两个系统彼此不一致。要保证两次写入要么都成功,要么都失败,就要解决代价高昂的原子提交问题(参阅 “两阶段提交(2PC)”)。
如果只有一个采用单主复制的数据库,那么领导者会决定写入顺序,状态机复制就能在数据库的各个副本之间正常工作。然而,图 12-4 中并不存在唯一的领导者:数据库可能有自己的领导者,搜索索引也可能有自己的领导者,但两者谁也不追随谁,因而可能发生冲突(参阅 “多主复制”)。
如果真能只有一个领导者——例如数据库——并让搜索索引成为数据库的追随者,情况就会好得多。但实践中能做到吗?
变更数据捕获
大多数数据库的复制日志长期以来都被视为内部实现细节,而不是公共 API。客户端理应通过数据库的数据模型和查询语言进行查询,而不是解析复制日志,尝试从中提取数据。
几十年来,许多数据库根本没有提供文档化的方式来获取写入其中的变更日志。因此,要取得数据库中发生的所有变化,再将其复制到搜索索引、缓存或数据仓库等其他存储技术中,一直非常困难。
近年来,变更数据捕获(change data capture,CDC)越来越受关注。它是这样一个过程:观察写入数据库的所有数据变化,将其提取成可以复制到其他系统的形式28。如果变化一经写入就立即以流的形式提供出来,CDC 尤其有用。
例如,你可以捕获数据库中的变化,并持续把相同变化应用到搜索索引。只要按同一顺序应用变更日志,搜索索引中的数据就有望与数据库保持一致。搜索索引以及其他衍生数据系统,都只是变更流的消费者。
图 12-5 展示了 CDC 如何解决 图 12-4 中的并发问题。将 X 分别设为 A 和 B 的两个请求虽然并发到达数据库,但数据库会决定某种执行顺序,并按该顺序把它们写入复制日志。搜索索引再按相同顺序取得并应用这些变化。如果还需要把数据送往数据仓库等其他系统,只须再为 CDC 事件流添加一个消费者。

变更数据捕获的实现
按照 “权威记录系统与衍生数据” 中的说法,我们可以把日志消费者称为 衍生数据系统(derived data system):搜索索引和数据仓库中存储的数据,不过是权威记录系统中数据的另一种视图。变更数据捕获机制确保权威记录系统中的所有变化也会反映到衍生数据系统中,使衍生系统持有准确的数据副本。
实质上,变更数据捕获让一个数据库成为领导者(即从中捕获变化的数据库),让其他系统成为追随者。基于日志的消息代理能够保持消息顺序,避免 图 12-2 中的乱序问题,因此很适合把变更事件从源数据库传送到衍生系统。
逻辑复制日志可以用来实现变更数据捕获(参阅 “逻辑(基于行)的日志复制”),不过需要应对模式变更、恰当建模更新等挑战。开源项目 Debezium 正是为解决这些问题而生。它为 MySQL、PostgreSQL、Oracle、SQL Server、Db2、Cassandra 以及其他许多数据库提供了 源连接器(source connector)。这些连接器接入数据库复制日志,以标准事件模式呈现其中的变化;随后便可转换消息并将其写入下游数据库。Kafka Connect 框架也为各种数据库提供了更多 CDC 连接器。Maxwell 通过解析 binlog 为 MySQL 提供类似功能29;GoldenGate 为 Oracle 提供类似功能;pgcapture 则面向 PostgreSQL。
与消息代理一样,变更数据捕获通常也是异步的:权威记录数据库提交变化之前,并不会等待消费者应用该变化。这种设计在运维上的好处是,增加一个缓慢的消费者不会对权威记录系统造成太大影响;缺点则是复制延迟的所有问题同样存在(参阅 “复制延迟的问题”)。
初始快照
如果拥有数据库有史以来的全部变更日志,就可以通过重播日志来重建数据库的完整状态。然而,永久保留所有变化往往会占用太多磁盘空间,重播也会耗时过久,因此日志通常需要截断。
例如,构建新的全文索引需要整个数据库的完整副本——只应用最近的变更日志还不够,因为其中缺少最近没有更新过的项目。因此,如果没有完整的历史日志,就需要从一个一致的快照开始,正如 “设置新的副本” 中所讨论的那样。
数据库快照必须与变更日志中的某个已知位置或偏移量对应,这样才能知道快照处理完毕后应从何处开始应用变化。有些 CDC 工具集成了快照功能,有些则需要手工完成。Debezium 使用 Netflix 的 DBLog 水位线算法提供增量快照30、31。
日志压实
如果只能保留有限的日志历史,那么每增加一个新的衍生数据系统,都要重新执行一遍快照流程。不过,日志压实(log compaction)提供了一个很好的替代方案。
我们在 “日志结构存储” 中讨论日志结构存储引擎时介绍过日志压实(示例见 图 4-3)。原理很简单:存储引擎定期查找日志中键相同的记录,丢弃重复项,只保留每个键的最新更新。这可能会显著缩小日志段,因此在压实过程中也可以合并日志段,如 图 12-6 所示。整个过程在后台运行。

在日志结构存储引擎中,带有特殊空值的更新(称为 墓碑,tombstone)表示某个键已被删除,并使该键在日志压实时被移除。但只要一个键没有被覆盖或删除,它就会永久留在日志中。压实后的日志所需磁盘空间只取决于数据库当前的内容,而与数据库有史以来发生过多少次写入无关。如果同一个键经常被覆盖,旧值最终会被垃圾回收,只留下最新值。
同样的思路也适用于基于日志的消息代理和变更数据捕获。如果 CDC 系统保证每次变化都有主键,而且对某个键的每次更新都会取代该键的旧值,那么只保留这个键最近一次写入就足够了。
这样一来,每当需要重建搜索索引等衍生数据系统时,都可以让新消费者从经过日志压实的主题的偏移量 0 开始,依次扫描日志中的所有消息。日志保证包含数据库中每个键的最新值(也可能包含一些旧值)——换言之,无须再次对 CDC 源数据库创建快照,便可由此取得数据库内容的完整副本。
Apache Kafka 支持日志压实。正如本章后面将会看到的,它使消息代理不仅可以传送临时消息,还能用作持久存储。
变更流的 API 支持
如今,大多数主流数据库都把变更流作为一等接口公开出来,而不再依赖过去那种事后加装、逆向工程得到的 CDC。MySQL、PostgreSQL 等关系数据库通常通过自身副本所使用的同一份复制日志发送变化。大多数云厂商也为自家产品提供 CDC 方案:例如,Datastream 可以流式访问 Google Cloud 的关系数据库和数据仓库。
即便 Cassandra 这类最终一致、基于法定人数的数据库,如今也支持变更数据捕获。正如 “线性一致性与仲裁” 中所述,客户端必须把写入持久化到多数节点,该写入才被视为可见。法定人数写入很难支持 CDC,因为没有唯一的权威数据源可供订阅;数据是否可见,取决于每个读取者选择的一致性级别。Cassandra 绕开了这个问题:它不提供统一的变更流,而是公开每个节点的原始日志段。消费数据的系统必须读取每个节点的原始日志段,再自行决定如何将其合并成一股流,做法很像法定人数读取者32。
Kafka Connect33 把许多数据库系统的变更数据捕获工具与 Kafka 集成起来。变更事件进入 Kafka 之后,既可以用来更新搜索索引等衍生数据系统,也可以送入本章后面讨论的流处理系统。
变更数据捕获与事件溯源
我们来比较一下变更数据捕获与事件溯源。与变更数据捕获相似,事件溯源也把应用状态的所有变化存成变更事件日志。两者最大的区别在于抽象层次不同:
在变更数据捕获中,应用以可变方式使用数据库,可以随意更新和删除记录。变更日志从数据库底层提取(例如解析复制日志),从而确保提取出的写入顺序与实际写入顺序一致,避免 图 12-4 中的竞态条件。
在事件溯源中,应用逻辑显式构建在写入事件日志的不可变事件之上。事件存储只允许追加,通常不鼓励或禁止更新、删除事件。事件旨在反映应用层发生的事情,而不是底层的状态变化。
哪一种更好取决于具体情况。对于原本没有采用事件溯源的应用,改用事件溯源是一项重大变化,也会带来 “事件溯源与 CQRS” 中讨论的各种利弊。相比之下,CDC 可以用很少的改动接入现有数据库——写入数据库的应用甚至可能根本不知道 CDC 正在运行。
变更数据捕获看起来比事件溯源更容易采用,但它也有自己的一系列挑战。
在微服务架构中,一个数据库通常只由一个服务访问。其他服务通过该服务的公共 API 与之交互,一般不会直接访问数据库。这样,数据库就成为该服务的内部实现细节,开发者可以改变数据库模式而不影响公共 API。
然而,CDC 系统复制数据时通常会沿用上游数据库的模式,这会让这些模式变成公共 API,必须像服务的公共 API 一样加以管理。如果开发者删除数据库表中的一列,依赖该字段的下游消费者就会崩溃。这类挑战一直存在于数据流水线中,但过去通常只影响数据仓库 ETL。CDC 往往以数据流实现,其他生产服务也可能是消费者,因此破坏这些消费者可能导致面向客户的故障34。人们通常用数据契约来防止这类破坏。
将内部模式与外部模式解耦的一种常见方法是采用 发件箱模式(outbox pattern)。发件箱是具有独立模式的表;CDC 系统对外公开这些表,而不是数据库中的内部领域模型35、36。这样,开发者便可按需修改内部模式,而保持发件箱表不变。这看起来像双写——它确实就是双写。不过,两次写入都留在同一个系统(数据库)中,可以出现在同一个事务里,因此发件箱避开了 “保持系统同步” 中讨论的问题。
不过,发件箱也有一些权衡。开发者仍须维护内部模式与发件箱模式之间的转换,这可能并不容易。发件箱还会增加数据库写入底层存储的数据量,可能引发性能问题。
与变更数据捕获一样,重播事件日志可以重建系统当前状态。不过,两者处理日志压实的方式不同:
记录更新的 CDC 事件通常包含记录的完整新版本,因此一个主键的当前值完全由该主键的最新事件决定,日志压实可以丢弃同一主键的旧事件。
事件溯源的建模层次更高:事件通常表达用户操作的意图,而不是该操作引发状态更新的具体机制。后续事件通常不会覆盖先前事件,因此需要完整的事件历史才能重建最终状态,不能用同样的方式压实日志。
使用事件溯源的应用通常会保存由事件日志衍生出的当前状态快照,以免反复处理完整日志。不过,这只是一种性能优化,用来加快读取和崩溃恢复;系统的设计意图仍是永久保存所有原始事件,并能在需要时重新处理完整的事件日志。我们将在 “不变性的局限” 中讨论这一假设。
状态、流和不变性
我们在 第 11 章 中看到,批处理受益于输入文件的不变性:你可以在现有输入文件上运行实验性的处理作业,而不必担心损坏这些文件。正是不变性原则赋予了事件溯源和变更数据捕获如此强大的能力。
我们通常认为数据库存储着应用的当前状态——这种表示针对读取进行了优化,一般也最便于处理查询。状态的本质就在于它会变化,所以数据库除了插入数据,还支持更新和删除。这与不变性又如何相容?
只要状态会变化,它就是一段时间内各种事件改变它的结果。例如,当前可用座位列表取决于已经处理过的预订;当前账户余额取决于账户的贷记与借记;Web 服务器的响应时间图,则是所有已发生 Web 请求各自响应时间的聚合。
无论状态如何变化,总有一系列事件导致这些变化。事情可以做了再撤销,但那些事件确实发生过这一事实不会改变。关键在于,可变状态与不可变事件的仅追加日志并不矛盾,而是一枚硬币的两面。所有变化构成的日志——即 变更日志(changelog)——表示了状态如何随时间演化。
如果你偏爱数学,可以说应用状态是事件流对时间的积分,而变更流是状态对时间的微分,如 图 12-7 所示37、38。这个类比有其局限(例如,状态的二阶导数似乎没有什么意义),但它是思考数据的一个实用起点。

只要持久存储变更日志,状态便可以重现。如果把事件日志视为权威记录系统,把所有可变状态都看作由它衍生而来,系统中的数据流就更容易推理。正如 Jim Gray 和 Andreas Reuter 在 1992 年所说39:
从根本上说,根本没有必要保留数据库;日志已经包含了全部信息。之所以要存储数据库(即日志末尾所对应的当前状态),只是为了提升检索操作的性能。
日志压实是衔接日志与数据库状态的一种方式:它只保留每条记录的最新版本,丢弃已经被覆盖的版本。
不可变事件的优点
数据库中的不变性是一个古老的观念。例如,会计师几个世纪以来一直在财务记账中运用不变性。一笔交易发生后,会被记入仅追加的 分类账(ledger);分类账本质上就是事件日志,描述货币、商品或服务的转手。损益表、资产负债表等账目,则是汇总分类账中的交易而衍生出来的40。
如果出了差错,会计师不会删除或修改分类账中的错误交易,而是另加一笔交易来抵消错误,例如退还一笔误收的费用。错误交易会永远保留在分类账中,因为它对审计可能十分重要。如果根据错误分类账得出的错误数字已经公布,下一个会计期间的数字就会包含相应的更正。这在会计工作中再正常不过41。
这种可审计性对金融系统尤其重要,但许多不受严格监管的系统也能从中受益。如果你不慎部署了一段有缺陷的代码,把错误数据写进数据库,而这段代码还能以破坏性的方式覆盖数据,恢复起来会困难得多。有了不可变事件的仅追加日志,诊断事情经过并从问题中恢复就容易得多。同样,客服人员也可以利用审计日志诊断客户的请求和投诉。
不可变事件所包含的信息也比当前状态更加丰富。例如在购物网站上,顾客可能先把一件商品加入购物车,随后又将其移除。从履行订单的角度看,第二个事件抵消了第一个事件;但从分析角度看,知道顾客曾考虑购买某件商品、后来又放弃,也许很有用。或许他们日后会购买,或许他们找到了替代品。这些信息会留在事件日志中;如果数据库在商品移出购物车时就删除相应记录,信息也会随之丢失。
从同一事件日志中派生多个视图
此外,把可变状态与不可变事件日志分离之后,还可以从同一份事件日志衍生出几种面向不同读取方式的表示。这就像一股流有多个消费者一样(图 12-5):例如,分析数据库 Druid 会以这种方式直接从 Kafka 摄取数据,Kafka Connect 的汇聚连接器则可以把 Kafka 中的数据导出到各种数据库和索引33。
在事件日志与数据库之间加入显式的转换步骤,应用也更容易随时间演进。如果要引入一项新功能,用新的方式呈现现有数据,可以利用事件日志为新功能构建一个独立的、针对读取优化的视图,与现有系统并行运行,而不必修改现有系统。在许多情况下,新旧系统并行运行比在现有系统中执行复杂的模式迁移更加容易。等读取方全部切换到新系统、不再需要旧系统之后,只须关闭旧系统并回收资源即可42、43。
把数据写成一种针对写入优化的形式,再按需转换成多种针对读取优化的表示,这正是我们在 “事件溯源与 CQRS” 中见过的 命令查询职责分离(command query responsibility segregation,CQRS)模式。它不一定要求采用事件溯源:同样可以从 CDC 事件流构建多个物化视图44。
传统的数据库与模式设计方法建立在一个谬误之上:数据必须按将来查询它时所采用的形式写入。如果能把针对写入优化的事件日志转换成针对读取优化的应用状态,规范化与反规范化之争(参阅 “规范化、反规范化与连接”)就基本失去了意义。完全可以在读取优化视图中对数据做反规范化,因为转换过程提供了让视图与事件日志保持一致的机制。
在 “案例研究:社交网络首页时间线” 中,我们讨论过社交网络的主页时间线:它缓存着某位用户关注的人最近发布的帖子,就像邮箱一样。这也是针对读取优化的状态:主页时间线高度反规范化,因为你的帖子会复制到每位关注者的时间线中。不过,扇出服务会让这些重复状态与新帖子、新的关注关系保持同步,使这种重复仍然可控。
并发控制
CQRS 最大的缺点是事件日志的消费者通常以异步方式运行。因此,用户可能刚刚向日志写入数据,随即读取某个衍生视图,却发现该写入还没有反映到视图中。我们曾在 “读己之写” 中讨论过这个问题及其可能的解决办法。
一种解决办法是在把事件追加到日志时,同步更新读取视图。这要么需要在事件日志与衍生视图之间执行分布式事务,要么需要某种机制,等待事件反映到视图中。这两种方法通常都不切实际,因此视图一般还是异步更新。
另一方面,从事件日志衍生当前状态也简化了并发控制的某些方面。之所以经常需要多对象事务(参阅 “单对象与多对象操作”),是因为一次用户操作往往要修改多个不同位置的数据。采用事件溯源后,可以把一个事件设计成对用户操作的自包含描述。这样,用户操作只需在一个位置完成一次写入——把事件追加到日志——很容易保证其原子性。
如果事件日志和应用状态采用相同的分片方式(例如,处理分片 3 中某位客户的事件时,只需更新应用状态的分片 3),那么简单的单线程日志消费者无须对写入做任何并发控制——从设计上看,它一次只会处理一个事件(另见 “实际串行执行”)。日志在每个分片中定义了事件的串行顺序,从而消除了并发带来的不确定性27。如果一个事件涉及多个状态分片,就需要多做一些工作,我们将在 第 13 章 中讨论。
许多并未采用事件溯源模型的系统,同样依靠不变性来控制并发:各种数据库在内部使用不可变数据结构或多版本数据来支持时间点快照(参阅 “索引与快照隔离”)。Git、Mercurial、Fossil 等版本控制系统也依靠不可变数据保存文件的版本历史。
不变性的局限
永久保存所有变化的不可变历史,究竟在多大程度上可行?答案取决于数据集的变动量。有些工作负载以新增数据为主,很少更新或删除,很容易做成不可变的。另一些工作负载则在相对较小的数据集上频繁更新和删除;这时,不可变历史可能膨胀到难以承受,碎片化也可能成为问题,而压实和垃圾回收的性能会直接影响系统能否稳健运行45、46。
除了性能原因,有时还必须出于行政或法律原因删除数据,哪怕这有悖于不变性。例如,欧盟《通用数据保护条例》(GDPR)等隐私法规要求应用户请求删除其个人信息和错误信息;意外泄露敏感信息后,也可能需要控制影响范围。
在这些情况下,只在日志末尾追加一个事件,表示先前的数据应视为已删除,并不足够——你真正想做的是改写历史,假装那些数据从未写入。Datomic 把这种功能称为 切除(excision)47,Fossil 版本控制系统中也有一个类似概念,称为 排斥(shunning)48。
真正删除数据出乎意料地困难49,因为副本可能存在于许多地方。例如,存储引擎、文件系统和 SSD 往往把数据写到新位置,而不是在原地覆盖41;备份通常还会被刻意设计成不可变,以防意外删除或损坏。
一种允许删除不可变数据的方法是 密码学粉碎(crypto-shredding)50:把将来可能需要删除的数据加密存储;需要清除时,忘掉加密密钥。加密后的数据仍然存在,但已经无人能够使用。从某种意义上说,这只是转移了问题:实际数据现在不可变了,存储密钥的地方却是可变的。
此外,还必须事先决定哪些数据共用一把密钥,何时要改用不同密钥。这项决定非常重要,因为以后只能选择粉碎某把密钥加密的全部数据,或者一项也不粉碎,不能只删除其中一部分。如果为每个数据项分别保存一把密钥,密钥存储会变得与主数据存储一样庞大,难以管理。可穿刺加密(puncturable encryption)等更复杂的方案51可以选择性撤销一把密钥的部分解密能力,但尚未得到广泛应用。
总体而言,删除更像是“让数据更难取回”,而不是真正“让数据无法取回”。尽管如此,有时仍必须尝试,我们将在 “立法与自律” 中看到这一点。
流处理
到目前为止,本章已经讨论了流从何而来(用户活动事件、传感器和数据库写入),以及如何传输流(直接传递消息、通过消息代理传递,以及使用事件日志)。
接下来要讨论的是,拿到一股流之后能用它做什么——也就是如何处理它。大体上有三种选择:
取出事件中的数据,写入数据库、缓存、搜索索引或类似的存储系统,再供其他客户端查询。如 图 12-5 所示,这是一种让数据库与系统其他部分的变化保持同步的好办法,尤其是在流消费者是唯一写入数据库的客户端时。写入存储系统,相当于以流式方式完成 “批处理用例” 中讨论的工作。
以某种方式把事件推送给用户,例如发送告警邮件或推送通知,或者把事件流式传送到实时仪表板上加以可视化。这种情况下,人是流的最终消费者。
处理一股或多股输入流,产生一股或多股输出流。一股流可能先后经过由多个处理阶段组成的流水线,最终才到达某个输出(即选项 1 或 2)。
本章余下部分将讨论第三种选择:处理流并产生其他衍生流。执行这种流处理的代码称为 算子(operator)或 作业(job)。它与 第 11 章 中讨论的 Unix 进程和 MapReduce 作业关系密切,数据流模式也很相似:流处理器以只读方式消费输入流,再以仅追加方式把输出写到另一个位置。
流处理器中的分片和并行化模式,也与 第 11 章 介绍的 MapReduce 和数据流引擎非常相似,因此这里不再赘述。转换、过滤记录等基本映射操作的工作方式也相同。
流与批处理作业有一个关键区别:流永远不会结束。这个区别会带来许多后果。正如本章开头所说,对无界数据集进行排序没有意义,因此不能使用排序合并连接(参阅 “JOIN 与 GROUP BY”)。容错机制也必须改变:一个只运行了几分钟的批处理作业发生任务故障时,大可从头重启该任务;但一个流作业已经运行了几年,崩溃后再从头开始,通常不可行。
流处理的应用
长期以来,流处理一直用于监控:组织希望在特定事情发生时收到警报。例如:
欺诈检测系统需要判断信用卡的使用模式是否出现意外变化,并在信用卡可能被盗时将其冻结。
交易系统需要观察金融市场的价格变化,并按照指定规则执行交易。
制造系统需要监控工厂内机器的状态,一旦发生故障便迅速查明问题。
军事与情报系统需要追踪潜在侵略者的活动,发现攻击迹象时发出警报。
这类应用需要相当复杂的模式匹配与关联分析。不过,流处理也逐渐出现了其他用途。本节将简要比较其中几种应用。
复合事件处理
复合事件处理(complex event processing,CEP)是一种在 20 世纪 90 年代发展起来的事件流分析方法,特别适合需要搜索特定事件模式的应用52。正如正则表达式可以在字符串中搜索特定的字符模式,CEP 允许你指定规则,在流中搜索特定的事件模式。
CEP 系统通常使用 SQL 等高级声明式查询语言或图形用户界面,描述应该检测哪些事件模式。这些查询会提交给处理引擎;引擎消费输入流,并在内部维护一个状态机来执行所需的匹配。一旦找到匹配,引擎便发出一个 复合事件(complex event,名称由此而来),其中包含检测到的事件模式详情53。
这类系统中,查询与数据的关系恰好和普通数据库相反。数据库通常持久存储数据,把查询视为临时对象:查询到来时,数据库搜索与之匹配的数据,查询完成后便将其忘掉。CEP 引擎却反过来长期存储查询;每个事件到来时,引擎都会检查迄今所见的事件是否形成了与某个常驻查询相匹配的模式54。
CEP 的实现包括 Esper、Apama 和 TIBCO StreamBase。Flink、Spark Streaming 等分布式流处理器也支持使用 SQL 对流执行声明式查询。
流分析
流处理的另一个用途是对流进行 分析。CEP 与流分析的边界并不清晰,但一般来说,分析不太关心寻找特定的事件序列,而更关注大量事件上的聚合与统计指标,例如:
测量某类事件的速率(每个时间间隔发生多少次);
计算某段时间内一个值的滚动平均数;
将当前统计值与先前时间段对比(例如检测趋势,或在某项指标与上周同一时间相比异常偏高或偏低时发出警报)。
这类统计值通常在固定时间区间内计算。例如,你可能想知道过去 5 分钟内某项服务平均每秒收到多少次查询,以及这段时间内响应时间的第 99 百分位点。在几分钟内取平均,可以抹平相邻秒之间无关紧要的波动,同时仍能及时反映流量模式的变化。用于聚合的时间区间称为 窗口(window),我们将在 “时间推理” 中详细讨论。
流分析系统有时会使用概率算法,例如用布隆过滤器(我们在 “布隆过滤器” 中见过)判断集合成员关系,用 HyperLogLog55 估计基数,以及用各种算法估计百分位点(参阅 “计算百分位点”)。概率算法给出近似结果,但与精确算法相比,流处理器所需内存少得多。近似算法的这种用途有时让人误以为流处理系统总是有损而不精确,其实不然:流处理本身并没有任何近似性,使用概率算法只是一项优化56。
许多开源分布式流处理框架都以分析为设计目标,例如 Apache Storm、Spark Streaming、Flink、Samza、Apache Beam 和 Kafka Streams57。托管服务则包括 Google Cloud Dataflow 和 Azure Stream Analytics。
维护物化视图
我们已经看到,数据库的变更流可以用来维护缓存、搜索索引和数据仓库等衍生数据系统,使它们与源数据库保持同步。这些都是维护物化视图的例子:从某个数据集衍生出另一种视图,以便高效查询,并在底层数据变化时更新视图37。
同样,在事件溯源中,应用状态通过应用事件日志来维护;这里的应用状态也是一种物化视图。与流分析不同,只考虑某个时间窗口内的事件通常不够:除了日志压实可能丢弃的过时事件,构建物化视图可能需要任意时间段内的 所有 事件。实际上,你需要一个一直延伸到时间开端的窗口。
原则上,任何流处理器都可以用于维护物化视图。不过,有些面向分析的框架假定自己主要处理持续时间有限的窗口,而永久维护事件与这种假设背道而驰。Kafka Streams 和 Confluent 的 ksqlDB 建立在 Kafka 的日志压实支持之上,能够支持这类用途58。
数据库似乎很适合维护物化视图——毕竟,它们本来就是用来保存数据集完整副本的,而且许多数据库也支持物化视图。我们在 “物化视图与多维数据集” 中看到,数据仓库常见的分析查询可以物化成 OLAP 多维数据集。
遗憾的是,数据库通常通过批处理作业,或 PostgreSQL 的 REFRESH MATERIALIZED VIEW 之类的按需请求来刷新物化视图表。视图会定期重新计算,而不是在源数据更新时随之更新。这种方式有两个重大缺点,因而不适合通过流处理维护视图:
效率低下:每次更新视图都要重新处理所有数据,尽管绝大多数数据很可能没有变化。
数据不够新鲜:只有等到下一次计划更新重新运行查询,源数据的变化才会反映到物化视图中。
如果数据很容易分区,而且计算天然适合增量执行,也可以编写数据库触发器来高效更新物化视图。例如,如果物化视图维护每日销售总收入,那么每发生一笔新销售,只需更新相应日期的那一行。在少数场景中可以定制这样的解决方案,但许多 SQL 查询很难高效地转换为增量计算,甚至根本无法转换。
增量视图维护(incremental view maintenance,IVM)是解决上述问题的一种更通用方法。IVM 技术把 SQL 等关系语言转换成能够执行增量计算的算子。IVM 算法不再处理整个数据集,而只重新计算和更新发生变化的数据38、59、60。这样,视图计算的效率大幅提升,更新也可以更频繁地运行,显著改善数据新鲜度。
Materialize61、RisingWave、ClickHouse 和 Feldera 等数据库都采用 IVM 技术,提供高效的增量物化视图。这些数据库摄取事件流,实时提供物化视图。最近的事件缓存在内存中,并定期用于更新磁盘上的物化视图。读取时则把最近事件与已经物化的数据合并起来,提供一个统一的实时视图。由于读取通常用 SQL 表达,而物化视图往往以 OLAP 风格的格式存储,这些系统也支持 第 11 章 所讨论的大规模数据仓库式查询。
在流上搜索
CEP 可以搜索由多个事件构成的模式;除此以外,有时还需要按照全文搜索查询等复杂条件来搜索单个事件。
例如,媒体监测服务可以订阅媒体机构发布的新闻文章和节目源,搜索任何提及目标公司、产品或话题的新闻。为此,需要预先制定搜索查询,再不断让新闻条目流与该查询进行匹配。一些网站也有类似功能:例如,房地产网站的用户可以要求网站在市场上出现符合其搜索条件的新房源时通知他们。Elasticsearch 的 percolator 功能62 就是实现这类流式搜索的一种选择。
传统搜索引擎先为文档建立索引,再在索引上运行查询。搜索数据流却把这个过程颠倒过来:查询被存储下来,文档像 CEP 中的事件一样逐一流过这些查询。最简单的做法是让每份文档测试每条查询,但查询数量很大时会变慢。为了优化这个过程,也可以像索引文档那样索引查询,从而缩小可能匹配的查询集合63。
事件驱动架构与 RPC
在 “事件驱动的架构” 中,我们讨论过用消息传递系统代替 RPC,也就是把它用作服务之间的通信机制,Actor 模型便是一例。这些系统同样以消息和事件为基础,但我们通常不会把它们视为流处理器:
Actor 框架主要用于管理相互通信的模块如何并发和分布式执行,而流处理主要是一种数据管理技术。
Actor 之间的通信往往是短暂的一对一通信,而事件日志持久存在,并有多个订阅者。
Actor 可以采用任意方式通信,包括循环的请求/响应模式;流处理器通常组成无环流水线,每股流都是某个特定作业的输出,并从一组明确定义的输入流衍生而来。
不过,类 RPC 系统与流处理之间也有一些交叉。例如,Apache Storm 有一项称为 分布式 RPC 的功能,可以把用户查询分派给一组同时处理事件流的节点。这些查询会与输入流中的事件交错处理,结果再汇总并返回给用户(另见 “多分片数据处理”)。
Actor 框架也可以用来处理流。不过,许多这类框架无法保证发生崩溃时消息仍能送达;除非另外实现重试逻辑,否则处理过程不具备容错能力。
时间推理
流处理器经常要应对时间问题,尤其是用于分析时,往往会使用“过去五分钟的平均值”这样的时间窗口。“过去五分钟”听起来似乎清楚明确,实际上却出人意料地棘手。
批处理任务会迅速处理大量历史事件。如果需要按时间划分结果,批处理就必须查看每个事件中嵌入的时间戳。查看运行批处理的机器系统时钟毫无意义,因为任务的运行时间与事件的实际发生时间没有关系。
一个批处理任务可能几分钟内就读完一整年的历史事件;大多数情况下,我们关心的是这一年的历史时间线,而不是几分钟的处理时间。此外,使用事件中的时间戳还可以让处理具有确定性:针对同一输入重新运行同一个过程,会得到相同的结果。
另一方面,许多流处理框架使用处理机器的本地系统时钟(即 处理时间,processing time)来划分窗口64。这种方法简单明了;如果事件创建与事件处理之间的延迟短到可以忽略,也很合理。但只要处理延迟比较显著——也就是事件实际发生后过了一段明显可感的时间才得到处理——这种方法就会失效。
事件时间与处理时间
很多原因都会导致处理延迟:排队、网络故障、性能问题使消息代理或处理器发生争用、流消费者重启,以及故障恢复或修复代码缺陷后重新处理过去的事件。
消息延迟还会使消息以不可预测的顺序到达。例如,假设用户先发出一个 Web 请求,由 Web 服务器 A 处理;随后发出第二个请求,由服务器 B 处理。A 和 B 各自发出事件,描述自己处理的请求,但 B 的事件先于 A 的事件到达消息代理。于是,流处理器先看到 B 的事件,再看到 A 的事件,而它们实际发生的顺序恰好相反。
不妨拿《星球大战》系列电影来类比:第四部于 1977 年上映,第五部于 1980 年上映,第六部于 1983 年上映;随后依次是 1999、2002 和 2005 年上映的第一、二、三部,以及 2015、2017 和 2019 年上映的第七、八、九部65。如果按上映顺序观看,你处理这些电影的顺序就与故事的叙事顺序不同(集数好比事件时间戳,观看日期则是处理时间)。人类能够应对这种不连续性,但流处理算法必须专门设计,才能处理这类时间与顺序问题。
混淆 事件时间(event time)与处理时间会产生错误数据。例如,假设有一个流处理器用来测量请求速率(统计每秒请求数)。重新部署流处理器时,它可能停机一分钟,恢复运行后再处理积压的事件。如果按处理时间计算速率,处理积压期间看起来会突然出现异常的请求尖峰,而真实的请求速率其实一直很稳定(图 12-8)。

处理滞留事件
按事件时间定义窗口时,有一个棘手的问题:你永远无法确定某个窗口的所有事件是否已经到齐,还是仍有一些事件尚未到达。
例如,假设把事件分成一分钟的窗口,以统计每分钟的请求数。你已经统计了一批时间戳落在本小时第 37 分钟的事件;随着时间推移,新到事件现在大多落在第 38 和第 39 分钟。究竟什么时候才能宣布第 37 分钟的窗口已经结束,并输出计数器的值?
如果一段时间内没有再看到属于某个窗口的新事件,可以让它超时并宣布窗口就绪。然而,某些事件可能仍缓存在另一台机器上,因网络中断而延迟。你必须能够处理这些在窗口宣布完成后才到达的 滞留事件(straggler event)。大体上有两种选择1:
忽略滞留事件,因为正常情况下,它们可能只占所有事件的很小一部分。可以把丢弃事件的数量作为指标跟踪;如果开始丢弃大量数据,就发出警报。
发布 更正(correction):为窗口发布一个包含滞留事件的更新值。可能还需要撤回先前的输出。
有时可以用一条特殊消息表示:“从现在起,不会再有时间戳早于 t 的消息。”消费者可以利用它触发窗口66。然而,如果多台机器上的多个生产者都在生成事件,各自拥有不同的最小时间戳阈值,消费者就必须分别跟踪每个生产者。这时,增加或移除生产者会更加棘手。
你用的是谁的时钟?
如果事件会在系统中的多个位置缓冲,为事件赋予时间戳就更加困难。例如,考虑一个向服务器上报使用指标的移动应用。用户可能在设备离线时使用该应用;此时应用会把事件缓存在设备本地,等下次连上互联网时再发送给服务器,而这可能已是几小时甚至几天之后。对于流的消费者来说,这些事件看起来就像延迟极久的滞留事件。
这种情况下,事件时间戳其实应该是用户交互发生的时间,以移动设备的本地时钟为准。然而,用户控制的设备时钟往往不可信,因为它可能被无意或有意地设成错误时间(参阅 “时钟同步和准确性”)。服务器收到事件的时间以服务器时钟为准;由于服务器在你的控制之下,这个时间更可能准确,却不能很好地描述用户交互。
为了校正不准确的设备时钟,一种方法是记录三个时间戳67:
根据设备时钟,事件发生的时间;
根据设备时钟,事件发往服务器的时间;
根据服务器时钟,服务器收到事件的时间。
用第三个时间戳减去第二个,可以估算设备时钟与服务器时钟之间的偏移量(假设相对于所需的时间戳精度,网络延迟可以忽略)。再把这一偏移量应用到事件时间戳上,就能估算事件真正发生的时间——这里还要假设,从事件发生到事件发往服务器期间,设备时钟的偏移量没有变化。
这个问题并非流处理独有,批处理在时间推理上面临一模一样的问题。只是在流式环境中,我们更能意识到时间正在流逝,所以问题也更显眼。
窗口的类型
明确了如何确定事件时间戳之后,下一步就是决定如何定义时间窗口。窗口可用于聚合,例如统计事件数量,或计算窗口内各个值的平均数。以下几类窗口比较常见64、68:
- 滚动窗口(tumbling window)
滚动窗口的长度固定,每个事件恰好属于一个窗口。例如,使用一分钟的滚动窗口时,时间戳介于
10:03:00和10:03:59的所有事件归入一个窗口,介于10:04:00和10:04:59的事件归入下一个窗口,依此类推。实现一分钟滚动窗口时,可以把每个事件的时间戳向下取整到最近的整分钟,以确定它属于哪个窗口。- 跳跃窗口(hopping window)
跳跃窗口的长度也固定,但允许窗口重叠,以起到一定的平滑作用。例如,一个长度为五分钟、跳跃步长为一分钟的窗口,先包含
10:03:00到10:07:59之间的事件;下一个窗口包含10:04:00到10:08:59之间的事件,依此类推。可以先计算一分钟的滚动窗口,再聚合相邻的多个窗口,从而实现这个跳跃窗口。- 滑动窗口(sliding window)
滑动窗口包含彼此间隔不超过某段时间的所有事件。例如,五分钟的滑动窗口会同时覆盖发生在
10:03:39和10:08:12的事件,因为两者相差不到五分钟。注意,五分钟的滚动窗口或跳跃窗口使用固定边界,不一定会把这两个事件放在同一个窗口中。实现滑动窗口时,可以维护一个按时间排序的事件缓冲区,并在旧事件过期、离开窗口时将其移除。- 会话窗口(session window)
会话窗口与其他窗口不同,没有固定的持续时间。它把同一用户在时间上彼此接近的事件归为一组,并在用户有一段时间没有活动后结束窗口(例如,30 分钟内没有任何事件)。网站分析经常需要划分会话。
窗口操作通常需要维护临时状态。有些情况下,无论窗口多大、发生多少事件,状态的大小都是固定的:例如,计数操作不论窗口大小和事件数量如何,都只需要一个计数器。另一方面,滑动窗口以及下一节讨论的流连接,都必须缓冲事件,直到窗口结束。因此,窗口很大或流吞吐量很高时,流处理器可能需要保存大量临时状态。无论这些状态保存在内存还是磁盘上,都必须确保运行流处理任务的机器有足够容量来容纳它们。
流连接
在 “JOIN 与 GROUP BY” 中,我们讨论过批处理作业如何按键连接数据集,以及这种连接为何是数据流水线的重要组成部分。流处理把数据流水线推广到对无界数据集的增量处理,因此也同样需要对流执行连接。
不过,流中随时可能出现新事件,使流连接比批处理作业中的连接更具挑战。为了看清这个问题,我们把连接分成三类:流—流连接(stream-stream join)、流—表连接(stream-table join)和 表—表连接(table-table join)。下面各用一个例子来说明。
流流连接(窗口连接)
假设网站提供搜索功能,而你想发现最近的 URL 搜索趋势。每当有人输入搜索查询,就记录一个包含查询及返回结果的事件;每当有人点击某项搜索结果,又记录一个点击事件。为了计算搜索结果中每个 URL 的点击率,必须把搜索行为与点击行为的事件结合起来;它们可以通过相同的会话 ID 关联。广告系统也需要类似的分析69。
如果用户放弃搜索,点击也许永远不会发生;即使发生,搜索与点击之间的间隔也可能相差悬殊:通常只有几秒,但也可能长达数天或数周——例如用户搜索之后忘记了这个浏览器标签页,过了很久才回来点击某个结果。网络延迟不一,甚至可能让点击事件先于搜索事件到达。你可以为连接选择适当的窗口,例如只连接相隔不超过一小时的搜索与点击。
请注意,把搜索详情嵌入点击事件并不等同于连接两类事件:这样只能了解用户点击搜索结果的情况,却无法了解用户没有点击任何结果的搜索。衡量搜索质量需要准确的点击率,因此搜索事件和点击事件缺一不可。
为了实现这类连接,流处理器需要维护 状态(state),例如按会话 ID 索引过去一小时内的所有事件。每当搜索事件或点击事件到来,就把它加入相应索引,同时检查另一个索引,看看相同会话 ID 的另一事件是否已经到达。找到匹配时,发出一个事件,说明哪项搜索结果被点击;如果搜索事件过期时仍未看到匹配的点击事件,则发出一个事件,说明哪些搜索结果没有被点击。
流表连接(流扩充)
在 “JOIN 与 GROUP BY”(图 11-2)中,我们见过批处理作业连接两个数据集的例子:一组用户活动事件和一个用户档案数据库。很自然地,可以把用户活动事件视为一股流,在流处理器中持续执行同样的连接:输入是包含用户 ID 的活动事件流,输出则是活动事件流,其中的用户 ID 已经补充了相应的用户档案信息。这个过程有时称为用数据库中的信息 扩充(enrich)活动事件。
执行这项连接时,流处理器要逐一查看活动事件,在数据库中查找事件里的用户 ID,再把档案信息加入活动事件。数据库查找可以通过查询远程数据库来实现;不过,正如 “JOIN 与 GROUP BY” 中所讨论的,这类远程查询很可能速度缓慢,还可能使数据库过载58。
另一种做法是把数据库副本载入流处理器,在本地查询,免去网络往返。由于数据库的本地副本可能是内存散列表(如果足够小),也可能是本地磁盘上的索引,因此这项技术称为 散列连接(hash join)。
它与批处理作业的区别在于:批处理作业把数据库某个时间点的快照用作输入;流处理器却长期运行,而数据库内容很可能随时间变化,所以流处理器中的本地副本必须持续更新。变更数据捕获可以解决这个问题:除了活动事件流,流处理器还可以订阅用户档案数据库的变更日志。每当创建或修改档案时,流处理器就更新本地副本。这样,我们实际上得到了两股流之间的连接:活动事件与档案更新。
流—表连接其实与流—流连接很相似。最大的区别在于,对表的变更日志流执行连接时,使用的是一个回溯至“时间开端”的窗口(概念上是无限窗口),其中记录的新版本会覆盖旧版本;对另一股输入流,连接可能根本不维护窗口。
表表连接(维护物化视图)
考虑 “案例研究:社交网络首页时间线” 中讨论的社交网络时间线。我们说过,用户查看主页时间线时,如果遍历他所关注的所有人,找出他们最近发布的帖子再合并,代价实在太高。
我们需要的是时间线缓存:为每位用户准备一个“收件箱”,帖子发布时便写入其中,这样读取时间线只需查找一次。物化并维护这个缓存,需要处理以下事件:
用户 u 发布新帖子时,把帖子加入所有关注 u 的用户的时间线。
用户删除一篇帖子或删除整个账户时,从所有用户的时间线中移除相应帖子。
用户 u
1开始关注用户 u2时,把 u2最近的帖子加入 u1的时间线。用户 u
1取消关注用户 u2时,从 u1的时间线中移除 u2的帖子。
要在流处理器中维护这项缓存,需要一股帖子事件流(发布和删除),以及一股关注关系事件流(关注和取消关注)。流处理器还要维护一个数据库,记录每位用户的关注者集合,以便新帖子到来时知道应该更新哪些时间线。
也可以换个角度来看:这项流处理维护着一个连接两张表(帖子和关注关系)的查询物化视图,大致如下:
流之间的连接直接对应查询中的表连接。时间线实际上就是查询结果的缓存,每当底层表发生变化时都会更新。
连接的时间依赖性
这里介绍的三类连接(流—流、流—表和表—表)有许多共同点:流处理器都要根据连接的一侧维护某种状态(搜索和点击事件、用户档案或关注者列表),再在连接另一侧的消息到来时查询该状态。
维护状态的事件顺序十分重要——先关注再取消关注,与顺序相反的结果不同。在 Kafka 这样的分片事件日志中,同一个分片(分区)内的事件顺序能够保持,但不同流或不同分片之间通常没有顺序保证。
这就带来一个问题:如果不同流上的事件发生时间相近,应该按什么顺序处理?在流—表连接的例子中,如果用户更新了档案,哪些活动事件应该与旧档案连接(在档案更新前处理),哪些应该与新档案连接(在档案更新后处理)?换句话说,如果状态随时间变化,而你要与这个状态连接,究竟应该使用哪个时间点的状态?
这种时间依赖会出现在许多地方。例如,销售商品时要为发票采用正确的税率;税率取决于国家或州、产品类型和销售日期,因为税率会不时变化。把销售记录与税率表连接时,通常需要采用销售发生时的税率;如果正在重新处理历史数据,它可能与当前税率不同。
如果不同流之间的事件顺序不确定,连接也会变得不确定70。这意味着,即使针对同一输入重新运行同一个作业,也不一定得到相同结果:再次运行时,各输入流上的事件可能以不同方式交错。
在数据仓库中,这个问题称为 缓慢变化维度(slowly changing dimension,SCD),通常为所连接记录的每个具体版本赋予唯一标识符来解决。例如,每次税率变化时,都给新税率分配一个新标识符;发票则包含销售时所用税率的标识符71、72。这样连接就具有确定性,但也无法再做日志压实,因为必须保留表中记录的所有版本。另一种方法是反规范化数据,把适用税率直接放入每个销售事件中。
容错
本章最后一节来看看流处理器如何容忍故障。我们在 第 11 章 中看到,批处理框架相当容易实现容错:一项任务失败后,只须在另一台机器上重新启动,并丢弃失败任务的输出。之所以能透明地重试,是因为输入文件不可变,每项任务都把输出写入独立文件,而且只有任务成功完成后,输出才会变得可见。
具体来说,批处理的容错方式可以确保:即使某些任务实际上失败过,批处理作业的输出也与没有发生过任何问题时相同。看起来每条输入记录都只处理了恰好一次——没有记录被跳过,也没有记录被处理两遍。重新启动任务意味着记录实际上可能处理了多次,但输出中可见的效果却像只处理了一次。这个原则称为 恰好一次语义(exactly-once semantics),不过 等效一次(effectively-once)或许是更贴切的叫法73。
流处理也面临同样的容错问题,却没那么容易解决:不能等任务完成后才让输出可见,因为流是无限的,永远也处理不完。
微批处理与检查点
一种解决办法是把流分成小块,把每一块当作一个微型批处理。这种方法称为 微批处理(microbatching),Spark Streaming 就采用了它74。批次通常约为一秒,这是性能权衡的结果:批次越小,调度与协调开销越大;批次越大,流处理器的结果变得可见之前,延迟就越长。
微批处理还隐式提供了一个大小等于批次大小的滚动窗口——它按处理时间而非事件时间戳划分。需要更大窗口的作业,必须显式地把状态从一个微批次传递到下一个微批次。
Apache Flink 采用一种变体:定期生成滚动的状态检查点,并将其写入持久存储75、76。如果流算子崩溃,可以从最近的检查点重新启动,并丢弃从上一个检查点到崩溃之间产生的所有输出。检查点由消息流中的屏障触发,类似于微批次之间的边界,但不会强制规定窗口大小。
在流处理框架内部,微批处理与检查点都能提供与批处理相同的恰好一次语义。然而,一旦输出离开流处理器——例如写入数据库、向外部消息代理发送消息或发送电子邮件——框架便无法丢弃失败微批次的输出。这时,重启失败任务会使外部副作用发生两次,仅靠微批处理或检查点不足以避免这个问题。
再谈原子提交
为了在发生故障时营造恰好一次处理的效果,必须确保处理事件产生的所有输出和副作用,当且仅当 处理成功时才生效。这些影响包括:发给下游算子或外部消息传递系统的消息(包括电子邮件或推送通知)、数据库写入、算子状态的变化,以及对输入消息的确认应答(包括推进基于日志的消息代理中的消费者偏移量)。
这些事情要么全部以原子方式发生,要么一件也不发生,不能彼此失去同步。这种做法听起来似曾相识,是因为我们曾在分布式事务和两阶段提交的语境下讨论过它(参阅 “恰好一次消息处理”)。
我们在 第 10 章 中讨论了 XA 等传统分布式事务实现的问题。不过,在限制更严格的环境中,可以高效实现这样的原子提交机制。Google Cloud Dataflow66、75、VoltDB77 和 Apache Kafka78、79 都采用了这种方法。与 XA 不同,这些实现不会试图跨异构技术提供事务,而是由流处理框架同时管理状态变化与消息传递,把事务留在框架内部。还可以在单个事务中处理多条输入消息,从而分摊事务协议的开销。
幂等性
我们的目标是丢弃所有失败任务的部分输出,以便能安全地重试,而不会生效两次。分布式事务是实现这个目标的一种方法;另一种方法是依靠 幂等性(idempotence),正如 “持久化执行与工作流” 中所见80。
幂等操作可以执行多次,效果与只执行一次相同。例如,删除键值存储中的一个键是幂等的(再次删除不会产生进一步影响);递增计数器却不是幂等的(再执行一次递增,值就增加了两次)。
即使操作本身并非天然幂等,通常也可以用一点额外元数据让它变得幂等。例如,消费 Kafka 消息时,每条消息都有一个持久、单调递增的偏移量。向外部数据库写入值时,可以把触发最近一次写入的消息偏移量与值一并写入。这样便能判断某项更新是否已经应用,避免再次执行同一更新。
Storm 的 Trident 也用类似思路处理状态。依靠幂等性包含几个假设:重启失败任务时,必须以相同顺序重播相同消息(基于日志的消息代理可以做到);处理过程必须具有确定性;而且不能有其他节点并发更新同一个值81、82。
从一个处理节点故障切换到另一个节点时,可能还需要采用栅栏机制(参阅 “分布式锁和租约”),以防某个被认为已经死亡、实际仍然存活的节点造成干扰。尽管有这么多限制,幂等操作仍是实现恰好一次语义的有效方式,而且开销很小。
失败后重建状态
任何需要状态的流处理过程——例如计数器、平均值、直方图等窗口聚合,以及连接所用的表和索引——都必须确保发生故障后能够恢复状态。
一种选择是把状态保存在远程数据存储中并进行复制,不过为每条消息查询一次远程数据库可能很慢。另一种选择是把状态保存在流处理器本地,再定期复制。这样,流处理器从故障中恢复时,新任务可以读取状态副本,继续处理而不丢失数据。
例如,Flink 定期捕获算子状态快照,将其写入分布式文件系统等持久存储75、76;Kafka Streams 则把状态变化发送到一个启用了日志压实的专用 Kafka 主题,以类似变更数据捕获的方式复制状态83。VoltDB 会在多个节点上冗余处理每条输入消息,以此复制状态(参阅 “实际串行执行”)。
有些情况下,甚至不必复制状态,因为可以根据输入流重建。例如,如果状态只是较短窗口上的聚合,重播该窗口对应的输入事件也许足够快。如果状态是由变更数据捕获维护的数据库本地副本,也可以从经过日志压实的变更流重建数据库。
不过,所有这些权衡都取决于底层基础设施的性能特征:有些系统的网络延迟可能低于磁盘访问延迟,网络带宽也可能与磁盘带宽相当。不存在适用于所有情况的理想权衡;随着存储和网络技术演进,本地状态与远程状态各自的优势也可能发生变化。
本章小结
本章讨论了事件流、它们的用途,以及如何处理它们。从某种意义上说,流处理与 第 11 章 讨论的批处理非常相似,只不过流处理持续作用于无界(永不终止)的流,而不是大小固定的输入84。从这个角度看,消息代理和事件日志就是文件系统的流式对应物。
我们花了一些篇幅比较两类消息代理:
- AMQP/JMS 风格的消息代理
代理把每条消息分别分配给消费者;消费者成功处理一条消息后,就对它进行确认应答。消息得到确认后,代理会将其删除。这种方法适合用作异步 RPC(另见 “事件驱动的架构”),例如用于任务队列:消息处理的确切顺序并不重要,处理完成后也无须返回重读旧消息。
- 基于日志的消息代理
代理把一个分片中的所有消息分配给同一个消费者节点,并始终按相同顺序传递消息。系统通过分片实现并行;消费者则为已处理的最后一条消息偏移量创建检查点,以此跟踪进度。代理把消息保留在磁盘上,因此必要时可以跳回去重新读取旧消息。
基于日志的方法与数据库的复制日志(参阅 第 6 章)和日志结构存储引擎(参阅 第 4 章)有相似之处。正如 第 10 章 所述,它也是共识的一种形式。我们看到,这种方法尤其适合那些消费输入流,并生成衍生状态或衍生输出流的流处理系统。
至于流从何而来,我们讨论了几种可能:用户活动事件、定期提供读数的传感器,以及数据源(例如金融市场数据),都天然适合表示成流。把数据库写入视为流同样很有用:可以通过变更数据捕获隐式取得变更日志——即数据库所有变化的历史——也可以通过事件溯源显式取得。日志压实让流可以保留数据库内容的完整副本。
把数据库表示成流,为系统集成带来了强大能力。消费变更日志并把变化应用到衍生系统,就能让搜索索引、缓存、分析系统等衍生数据系统持续保持最新。甚至可以从头开始消费变更日志,一直追到当前时刻,从而基于现有数据构建全新的视图。
以流的形式维护状态、重播消息的能力,也是各种流处理框架实现流连接和容错技术的基础。我们讨论了流处理的几种用途,包括搜索事件模式(复合事件处理)、计算窗口聚合(流分析),以及让衍生数据系统保持最新(物化视图)。
随后,我们讨论了流处理器进行时间推理时的困难,包括处理时间与事件时间戳的区别,以及如何处理那些在窗口本以为已经完成后才姗姗来迟的滞留事件。
我们区分了流处理过程中可能出现的三类连接:
- 流—流连接
两股输入流都由活动事件组成,连接算子会在某个时间窗口内寻找彼此相关的事件。例如,它可以匹配同一用户在 30 分钟内执行的两个操作。如果想寻找同一股流中的相关事件,连接的两侧实际上也可以是同一股流,这称为 自连接(self-join)。
- 流—表连接
一股输入流由活动事件组成,另一股则是数据库变更日志。变更日志用来让数据库的本地副本保持最新。对于每个活动事件,连接算子查询数据库,并输出经过扩充的活动事件。
- 表—表连接
两股输入流都是数据库变更日志。这种情况下,任意一侧的每次变化都与另一侧的最新状态连接。结果是两张表连接所得物化视图的变更流。
最后,我们讨论了流处理器实现容错和恰好一次语义的技术。与批处理一样,必须丢弃失败任务产生的部分输出。但流处理过程长期运行并持续产生输出,无法简单地丢弃所有输出。因此,需要微批处理、检查点、事务或幂等写入等机制,在更细的粒度上进行恢复。
脚注
参考文献
Tyler Akidau, Robert Bradshaw, Craig Chambers, Slava Chernyak, Rafael J. Fernández-Moctezuma, Reuven Lax, Sam McVeety, Daniel Mills, Frances Perry, Eric Schmidt, and Sam Whittle. The Dataflow Model: A Practical Approach to Balancing Correctness, Latency, and Cost in Massive-Scale, Unbounded, Out-of-Order Data Processing. Proceedings of the VLDB Endowment, volume 8, issue 12, pages 1792–1803, August 2015. doi:10.14778/2824032.2824076 ↩︎ ↩︎
Harold Abelson, Gerald Jay Sussman, and Julie Sussman. Structure and Interpretation of Computer Programs, 2nd edition. MIT Press, 1996. ISBN: 978-0-262-51087-5, archived at archive.org/details/sicp_20211010 ↩︎
Patrick Th. Eugster, Pascal A. Felber, Rachid Guerraoui, and Anne-Marie Kermarrec. The Many Faces of Publish/Subscribe. ACM Computing Surveys, volume 35, issue 2, pages 114–131, June 2003. doi:10.1145/857076.857078 ↩︎
Don Carney, Uğur Çetintemel, Mitch Cherniack, Christian Convey, Sangdon Lee, Greg Seidman, Michael Stonebraker, Nesime Tatbul, and Stan Zdonik. Monitoring Streams – A New Class of Data Management Applications. At 28th International Conference on Very Large Data Bases (VLDB), August 2002. doi:10.1016/B978-155860869-6/50027-5 ↩︎
Matthew Sackman. Pushing Back. wellquite.org, May 2016. Archived at perma.cc/3KCZ-RUFY ↩︎ ↩︎
Thomas Figg (tef). how (not) to write a pipeline. cohost.org, June 2023. Archived at perma.cc/A3V8-NYCM ↩︎
Vicent Martí. Brubeck, a statsd-Compatible Metrics Aggregator. github.blog, June 2015. Archived at perma.cc/TP3Q-DJYM ↩︎
Seth Lowenberger. MoldUDP64 Protocol Specification V 1.00. nasdaqtrader.com, July 2009. Archived at https://perma.cc/7CRQ-QBD7 ↩︎
Ian Malpass. Measure Anything, Measure Everything. codeascraft.com, February 2011. Archived at archive.org ↩︎
Dieter Plaetinck. 25 Graphite, Grafana and statsd Gotchas. grafana.com, March 2016. Archived at perma.cc/3NP3-67U7 ↩︎
Jeff Lindsay. Web Hooks to Revolutionize the Web. progrium.com, May 2007. Archived at perma.cc/BF9U-XNX4 ↩︎
Jim N. Gray. Queues Are Databases. Microsoft Research Technical Report MSR-TR-95-56, December 1995. Archived at arxiv.org ↩︎
Mark Hapner, Rich Burridge, Rahul Sharma, Joseph Fialli, Kate Stout, and Nigel Deakin. JSR-343 Java Message Service (JMS) 2.0 Specification. jms-spec.java.net, March 2013. Archived at perma.cc/E4YG-46TA ↩︎
Sanjay Aiyagari, Matthew Arrott, Mark Atwell, Jason Brome, Alan Conway, Robert Godfrey, Robert Greig, Pieter Hintjens, John O’Hara, Matthias Radestock, Alexis Richardson, Martin Ritchie, Shahrokh Sadjadi, Rafael Schloming, Steven Shaw, Martin Sustrik, Carl Trieloff, Kim van der Riet, and Steve Vinoski. AMQP: Advanced Message Queuing Protocol Specification. Version 0-9-1, November 2008. Archived at perma.cc/6YJJ-GM9X ↩︎
Architectural overview of Pub/Sub. cloud.google.com, 2025. Archived at perma.cc/VWF5-ABP4 ↩︎ ↩︎
Aris Tzoumas. Lessons from scaling PostgreSQL queues to 100k events per second. rudderstack.com, July 2025. Archived at perma.cc/QD8C-VA4Y ↩︎
Robin Moffatt. Kafka Connect Deep Dive – Error Handling and Dead Letter Queues. confluent.io, March 2019. Archived at perma.cc/KQ5A-AB28 ↩︎
Dunith Danushka. Message reprocessing: How to implement the dead letter queue. redpanda.com. Archived at perma.cc/R7UB-WEWF ↩︎
Damien Gasparina, Loic Greffier, and Sebastien Viale. KIP-1034: Dead letter queue in Kafka Streams. cwiki.apache.org, April 2024. Archived at perma.cc/3VXV-QXAN ↩︎
Jay Kreps, Neha Narkhede, and Jun Rao. Kafka: A Distributed Messaging System for Log Processing. At 6th International Workshop on Networking Meets Databases (NetDB), June 2011. Archived at perma.cc/CSW7-TCQ5 ↩︎
Jay Kreps. Benchmarking Apache Kafka: 2 Million Writes Per Second (On Three Cheap Machines). engineering.linkedin.com, April 2014. Archived at archive.org ↩︎
Kartik Paramasivam. How We’re Improving and Advancing Kafka at LinkedIn. engineering.linkedin.com, September 2015. Archived at perma.cc/3S3V-JCYJ ↩︎
Philippe Dobbelaere and Kyumars Sheykh Esmaili. Kafka versus RabbitMQ: A comparative study of two industry reference publish/subscribe implementations. At 11th ACM International Conference on Distributed and Event-based Systems (DEBS), June 2017. doi:10.1145/3093742.3093908 ↩︎
Kate Holterhoff. Why Message Queues Endure: A History. redmonk.com, December 2024. Archived at perma.cc/6DX8-XK4W ↩︎
Andrew Schofield. KIP-932: Queues for Kafka. cwiki.apache.org, May 2023. Archived at perma.cc/LBE4-BEMK ↩︎
Jack Vanlightly. The advantages of queues on logs. jack-vanlightly.com, October 2023. Archived at perma.cc/WJ7V-287K ↩︎
Jay Kreps. The Log: What Every Software Engineer Should Know About Real-Time Data’s Unifying Abstraction. engineering.linkedin.com, December 2013. Archived at perma.cc/2JHR-FR64 ↩︎ ↩︎
Andy Hattemer. Change Data Capture is having a moment. Why? materialize.com, September 2021. Archived at perma.cc/AL37-P53C ↩︎
Prem Santosh Udaya Shankar. Streaming MySQL Tables in Real-Time to Kafka. engineeringblog.yelp.com, August 2016. Archived at perma.cc/5ZR3-2GVV ↩︎
Andreas Andreakis, Ioannis Papapanagiotou. DBLog: A Watermark Based Change-Data-Capture Framework. October 2020. Archived at arxiv.org ↩︎
Jiri Pechanec. Percolator. debezium.io, October 2021. Archived at perma.cc/EQ8E-W6KQ ↩︎
Debezium maintainers. Debezium Connector for Cassandra. debezium.io. Archived at perma.cc/WR6K-EKMD ↩︎
Neha Narkhede. Announcing Kafka Connect: Building Large-Scale Low-Latency Data Pipelines. confluent.io, February 2016. Archived at perma.cc/8WXJ-L6GF ↩︎ ↩︎
Chris Riccomini. Kafka change data capture breaks database encapsulation. cnr.sh, November 2018. Archived at perma.cc/P572-9MKF ↩︎
Gunnar Morling. “Change Data Capture Breaks Encapsulation”. Does it, though? decodable.co, November 2023. Archived at perma.cc/YX2P-WNWR ↩︎
Gunnar Morling. Revisiting the Outbox Pattern. decodable.co, October 2024. Archived at perma.cc/M5ZL-RPS9 ↩︎
Ashish Gupta and Inderpal Singh Mumick. Maintenance of Materialized Views: Problems, Techniques, and Applications. IEEE Data Engineering Bulletin, volume 18, issue 2, pages 3–18, June 1995. Archived at archive.org ↩︎ ↩︎ ↩︎
Mihai Budiu, Tej Chajed, Frank McSherry, Leonid Ryzhyk, Val Tannen. DBSP: Incremental Computation on Streams and Its Applications to Databases. SIGMOD Record, volume 53, issue 1, pages 87–95, March 2024. doi:10.1145/3665252.3665271 ↩︎ ↩︎
Jim Gray and Andreas Reuter. Transaction Processing: Concepts and Techniques. Morgan Kaufmann, 1992. ISBN: 9781558601901 ↩︎
Martin Kleppmann. Accounting for Computer Scientists. martin.kleppmann.com, March 2011. Archived at perma.cc/9EGX-P38N ↩︎
Pat Helland. Immutability Changes Everything. At 7th Biennial Conference on Innovative Data Systems Research (CIDR), January 2015. ↩︎ ↩︎
Martin Kleppmann. Making Sense of Stream Processing. Report, O’Reilly Media, May 2016. Archived at perma.cc/RAY4-JDVX ↩︎
Kartik Paramasivam. Stream Processing Hard Problems – Part 1: Killing Lambda. engineering.linkedin.com, June 2016. Archived at archive.org ↩︎
Stéphane Derosiaux. CQRS: What? Why? How? sderosiaux.medium.com, September 2019. Archived at perma.cc/FZ3U-HVJ4 ↩︎
Baron Schwartz. Immutability, MVCC, and Garbage Collection. xaprb.com, December 2013. Archived at archive.org ↩︎
Daniel Eloff, Slava Akhmechet, Jay Kreps, et al. Re: Turning the Database Inside-out with Apache Samza. Hacker News discussion, news.ycombinator.com, March 2015. Archived at perma.cc/ML9E-JC83 ↩︎
Datomic Documentation: Excision. Cognitect, Inc., docs.datomic.com. Archived at perma.cc/J5QQ-SH32 ↩︎
Fossil Documentation: Deleting Content from Fossil. fossil-scm.org, 2025. Archived at perma.cc/DS23-GTNG ↩︎
Jay Kreps. The irony of distributed systems is that data loss is really easy but deleting data is surprisingly hard. x.com, March 2015. Archived at perma.cc/7RRZ-V7B7 ↩︎
Brent Robinson. Crypto shredding: How it can solve modern data retention challenges. medium.com, January 2019. Archived at https://perma.cc/4LFK-S6XE ↩︎
Matthew D. Green and Ian Miers. Forward Secure Asynchronous Messaging from Puncturable Encryption. At IEEE Symposium on Security and Privacy, May 2015. doi:10.1109/SP.2015.26 ↩︎
David C. Luckham. What’s the Difference Between ESP and CEP? complexevents.com, June 2019. Archived at perma.cc/E7PZ-FDEF ↩︎
Arvind Arasu, Shivnath Babu, and Jennifer Widom. The CQL Continuous Query Language: Semantic Foundations and Query Execution. The VLDB Journal, volume 15, issue 2, pages 121–142, June 2006. doi:10.1007/s00778-004-0147-z ↩︎
Julian Hyde. Data in Flight: How Streaming SQL Technology Can Help Solve the Web 2.0 Data Crunch. ACM Queue, volume 7, issue 11, December 2009. doi:10.1145/1661785.1667562 ↩︎
Philippe Flajolet, Éric Fusy, Olivier Gandouet, and Frédéric Meunier. HyperLogLog: The Analysis of a Near-Optimal Cardinality Estimation Algorithm. At Conference on Analysis of Algorithms (AofA), June 2007. doi:10.46298/dmtcs.3545 ↩︎
Jay Kreps. Questioning the Lambda Architecture. oreilly.com, July 2014. Archived at perma.cc/2WY5-HC8Y ↩︎
Ian Reppel. An Overview of Apache Streaming Technologies. ianreppel.org, March 2016. Archived at perma.cc/BB3E-QJLW ↩︎
Jay Kreps. Why Local State is a Fundamental Primitive in Stream Processing. oreilly.com, July 2014. Archived at perma.cc/P8HU-R5LA ↩︎ ↩︎
RisingWave Labs. Deep Dive Into the RisingWave Stream Processing Engine - Part 2: Computational Model. risingwave.com, November 2023. Archived at perma.cc/LM74-XDEL ↩︎
Frank McSherry, Derek G. Murray, Rebecca Isaacs, and Michael Isard. Differential dataflow. At 6th Biennial Conference on Innovative Data Systems Research (CIDR), January 2013. ↩︎
Andy Hattemer. Incremental Computation in the Database. materialize.com, March 2020. Archived at perma.cc/AL94-YVRN ↩︎
Shay Banon. Percolator. elastic.co, February 2011. Archived at perma.cc/LS5R-4FQX ↩︎
Alan Woodward and Martin Kleppmann. Real-Time Full-Text Search with Luwak and Samza. martin.kleppmann.com, April 2015. Archived at perma.cc/2U92-Q7R4 ↩︎
Tyler Akidau. The World Beyond Batch: Streaming 102. oreilly.com, January 2016. Archived at perma.cc/4XF9-8M2K ↩︎ ↩︎
Stephan Ewen. Streaming Analytics with Apache Flink. At Kafka Summit, April 2016. Archived at perma.cc/QBQ4-F9MR ↩︎
Tyler Akidau, Alex Balikov, Kaya Bekiroğlu, Slava Chernyak, Josh Haberman, Reuven Lax, Sam McVeety, Daniel Mills, Paul Nordstrom, and Sam Whittle. MillWheel: Fault-Tolerant Stream Processing at Internet Scale. Proceedings of the VLDB Endowment, volume 6, issue 11, pages 1033–1044, August 2013. doi:10.14778/2536222.2536229 ↩︎ ↩︎
Alex Dean. Improving Snowplow’s Understanding of Time. snowplow.io, September 2015. Archived at perma.cc/6CT9-Z3Q2 ↩︎
Azure Stream Analytics: Windowing functions. Microsoft Azure Reference, learn.microsoft.com, July 2025. Archived at archive.org ↩︎
Rajagopal Ananthanarayanan, Venkatesh Basker, Sumit Das, Ashish Gupta, Haifeng Jiang, Tianhao Qiu, Alexey Reznichenko, Deomid Ryabkov, Manpreet Singh, and Shivakumar Venkataraman. Photon: Fault-Tolerant and Scalable Joining of Continuous Data Streams. At ACM International Conference on Management of Data (SIGMOD), June 2013. doi:10.1145/2463676.2465272 ↩︎
Ben Kirwin. Doing the Impossible: Exactly-Once Messaging Patterns in Kafka. ben.kirw.in, November 2014. Archived at perma.cc/A5QL-QRX7 ↩︎
Pat Helland. Data on the Outside Versus Data on the Inside. At 2nd Biennial Conference on Innovative Data Systems Research (CIDR), January 2005. ↩︎
Ralph Kimball and Margy Ross. The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling, 3rd edition. John Wiley & Sons, 2013. ISBN: 978-1-118-53080-1 ↩︎
Viktor Klang. I’m coining the phrase ’effectively-once’ for message processing with at-least-once + idempotent operations. x.com, October 2016. Archived at perma.cc/7DT9-TDG2 ↩︎
Matei Zaharia, Tathagata Das, Haoyuan Li, Scott Shenker, and Ion Stoica. Discretized Streams: An Efficient and Fault-Tolerant Model for Stream Processing on Large Clusters. At 4th USENIX Conference in Hot Topics in Cloud Computing (HotCloud), June 2012. ↩︎
Kostas Tzoumas, Stephan Ewen, and Robert Metzger. High-Throughput, Low-Latency, and Exactly-Once Stream Processing with Apache Flink. ververica.com, August 2015. Archived at archive.org ↩︎ ↩︎ ↩︎
Paris Carbone, Gyula Fóra, Stephan Ewen, Seif Haridi, and Kostas Tzoumas. Lightweight Asynchronous Snapshots for Distributed Dataflows. arXiv:1506.08603 [cs.DC], June 2015. ↩︎ ↩︎
Ryan Betts and John Hugg. Fast Data: Smart and at Scale. Report, O’Reilly Media, October 2015. Archived at perma.cc/VQ6S-XQQY ↩︎
Neha Narkhede and Guozhang Wang. Exactly-Once Semantics Are Possible: Here’s How Kafka Does It. confluent.io, June 2019. Archived at perma.cc/Q2AU-Q2ED ↩︎
Jason Gustafson, Flavio Junqueira, Apurva Mehta, Sriram Subramanian, and Guozhang Wang. KIP-98 – Exactly Once Delivery and Transactional Messaging. cwiki.apache.org, November 2016. Archived at perma.cc/95PT-RCTG ↩︎
Pat Helland. Idempotence Is Not a Medical Condition. Communications of the ACM, volume 55, issue 5, page 56, May 2012. doi:10.1145/2160718.2160734 ↩︎
Jay Kreps. Re: Trying to Achieve Deterministic Behavior on Recovery/Rewind. Email to samza-dev mailing list, September 2014. Archived at perma.cc/7DPD-GJNL ↩︎
E. N. (Mootaz) Elnozahy, Lorenzo Alvisi, Yi-Min Wang, and David B. Johnson. A Survey of Rollback-Recovery Protocols in Message-Passing Systems. ACM Computing Surveys, volume 34, issue 3, pages 375–408, September 2002. doi:10.1145/568522.568525 ↩︎
Adam Warski. Kafka Streams – How Does It Fit the Stream Processing Landscape? softwaremill.com, June 2016. Archived at perma.cc/WQ5Q-H2J2 ↩︎
Stephan Ewen, Fabian Hueske, and Xiaowei Jiang. Batch as a Special Case of Streaming and Alibaba’s contribution of Blink. flink.apache.org, February 2019. Archived at perma.cc/A529-SKA9 ↩︎
13 流式系统的哲学

如果一件事物以另一件事物为目的,那么它的终极目的就不可能只是保存自身。因此,船长不会把保全受托的船只当作终极目的,因为船只另有其目的,也就是航行。
(这段话常被引述为:如果船长的最高目标是保护船只,他就会让船永远停在港口。)
圣托马斯・阿奎那,《神学大全》(1265—1274)
我们在 第 2 章 中讨论了构建 可靠(reliable)、可伸缩(scalable)、可维护(maintainable)的应用与系统这一目标。这些主题贯穿全书各章:例如,我们讨论了许多有助于提升可靠性的容错算法、提升可伸缩性的分片,以及提升可维护性的演化与抽象机制。
在本章中,我们将把所有这些想法汇集起来,并特别以 第 12 章 的 流处理(stream processing)与 事件驱动架构(event-driven architecture)为基础,形成一套能够实现上述目标的应用开发哲学。与前几章相比,本章的立场更为鲜明:它将深入阐述一种特定的哲学,而不是比较多种不同的方法。
数据集成
本书反复出现的一个主题是:对于任何给定的问题,往往都有若干种解决方案,而每种方案都有不同的优点、缺点与利弊权衡。例如,在 第 4 章 讨论存储引擎时,我们看到了日志结构存储、B 树和列式存储;在 第 6 章 讨论复制时,我们看到了单主、多主和无主复制。
如果你面临的问题是“我想存储一些数据,稍后再把它查出来”,那么并不存在唯一正确的解决方案;不同的方法各自适用于不同的情形。软件实现通常必须选择一种具体的方法。要让一条代码路径既稳健又有良好的性能,本就已经很难;试图在一个软件中包办一切,几乎注定会得到糟糕的实现。
因此,选择哪一种软件工具最合适,同样取决于具体情形。每一种软件——即便是所谓的“通用”数据库——都是针对某种特定的使用模式设计的。
面对如此繁多的选择,第一个挑战便是弄清各种软件产品分别适合什么情形。供应商不愿告诉你自己的软件不适合哪些工作负载,这完全可以理解;不过,希望前面的章节已经让你知道应该提出哪些问题,从而读懂言外之意,更好地理解其中的权衡。
然而,即使你已经完全掌握了工具及其适用情形之间的对应关系,仍然会遇到另一个挑战:在复杂应用中,数据往往会以许多不同的方式使用。几乎不可能有一种软件适合数据的 所有 使用情形,因此,为了提供应用所需的功能,你不可避免地需要把几种不同的软件组合起来。
通过衍生数据组合专用工具
例如,为了支持任意关键词查询,通常需要把 OLTP 数据库与全文检索索引集成起来。尽管某些数据库(例如 PostgreSQL)内置的全文索引功能足以满足简单应用的需要 1,但更复杂的检索功能仍然需要专业的信息检索工具。反过来,搜索索引通常又不适合作为持久的权威记录系统,因此许多应用都需要组合使用这两种工具,才能满足全部需求。
我们在 “保持系统同步” 中谈到过数据系统的集成问题。数据表示越多,集成就越困难。除了数据库和搜索索引,你可能还需要在分析系统中保存数据副本,例如数据仓库、批处理(batch processing)系统或流处理系统;维护由原始数据衍生而来的缓存或反规范化对象;让数据经过机器学习、分类、排名或推荐系统;或者根据数据变更发送通知。
理解数据流
为了满足不同的访问模式,如果同一份数据的副本需要保存在多个存储系统中,你就必须清楚地界定输入和输出:数据最先写到哪里?哪些表示是从哪些来源衍生出来的?怎样才能以正确的格式,把数据送到所有正确的位置?
例如,你可以让数据首先写入作为权威记录系统的数据库,捕获该数据库中的变更(参见 “变更数据捕获”),再按相同顺序把这些变更应用到搜索索引。如果变更数据捕获(CDC)是更新索引的唯一途径,你就可以确信索引完全衍生自权威记录系统,因而与之保持一致(软件缺陷除外)。在这个系统中,只有写入数据库才能提供新的输入。
如果允许应用同时直接写入搜索索引和数据库,就会引入 图 12-4 所示的问题:两个客户端并发提交相互冲突的写入,而两个存储系统却以不同的顺序处理它们。此时,无论数据库还是搜索索引,都不能“说了算”来决定写入顺序;它们可能作出相互矛盾的决定,并从此永久不一致。
如果能够把所有用户输入都汇入一个系统,由它决定全部写入的顺序,那么只需按相同顺序处理这些写入,就能更容易地衍生出数据的其他表示。这正是我们在 “共识的实践” 中见过的状态机复制方法的一种应用。使用变更数据捕获还是事件溯源日志并不是最重要的,真正重要的是先确定一个全序。
根据事件日志更新衍生数据系统,往往可以做到 确定性(determinism)与 幂等性(idempotence;参见 “幂等性”),因而很容易从故障中恢复。
衍生数据与分布式事务
让不同数据系统彼此保持一致的经典方法是使用分布式事务,如 “两阶段提交(2PC)” 所述。相比之下,使用衍生数据系统的效果如何?
从抽象层面看,两者以不同手段实现了相似的目标。分布式事务使用锁来实现互斥,以此决定写入顺序;而 CDC 与事件溯源则用日志来排序。分布式事务通过原子提交确保变更恰好生效一次;基于日志的系统通常依靠确定性重试与幂等性。
两者最大的区别在于:事务系统通常保证一个值写入后,立即就能读到它的最新值(参见 “读己之写”)。衍生数据系统则往往异步更新,因此默认并不保证读操作所见的数据是最新的。
在一些范围有限、愿意承担分布式事务成本的环境中,分布式事务已得到成功应用。然而,XA 的容错性和性能都不理想(参见 “跨不同系统的分布式事务”),这严重限制了它的实用性。或许可以设计出一种更好的分布式事务协议,但要让这种协议获得广泛采用,并与现有工具集成,将极具挑战,短期内也不太可能实现。
由于目前还没有一种得到广泛支持的优良分布式事务协议,基于日志的衍生数据是集成不同数据系统最有前景的方法。不过,读己之写等保证确实很有用;一味告诉所有人“最终一致性不可避免——接受现实,学会应付吧”,并无助益(至少在没有妥善说明 如何 应对时是这样)。
本章稍后将讨论一些在异步衍生系统之上实现更强保证的方法,努力在分布式事务与基于日志的异步系统之间找到一条中间道路。
全序的局限
对于规模足够小的系统,构建全序事件日志完全可行(采用单主复制的数据库如此流行,便证明了这一点:它们构建的正是这样的日志)。不过,随着系统扩展到更大、更复杂的工作负载,局限便开始显现:
在大多数情况下,构建全序日志要求所有事件都经过 单个领导者节点,由它决定顺序。如果事件吞吐量超出单台机器的处理能力,就需要把日志分片到多台机器上。此时,两个不同分片中的事件孰先孰后便不再明确。
如果服务器分布在多个 地理上分散 的区域——例如,为了容忍整个数据中心离线——通常会在每个数据中心分别设置领导者,因为网络延迟会使跨数据中心的同步协调效率低下。这意味着,来自两个不同数据中心的事件之间没有确定的顺序。
当应用以 微服务 形式部署时,一种常见的设计选择是把每项服务及其持久状态作为独立单元部署,不让服务之间共享持久状态。当两个事件分别产生于不同服务时,它们之间没有确定的顺序。
一些应用会在客户端维护状态:用户输入后立即更新,不等待服务器确认,甚至在离线时仍能继续工作。在这样的应用中,客户端与服务器很可能以不同的顺序看到事件。
从形式上说,决定事件全序的问题称为 全序广播(total order broadcast),它等价于共识(参见 “共识的多面性”)。大多数共识算法针对的是单个节点吞吐量足以处理整个事件流的情形,并没有提供让多个节点共同分担事件排序工作的机制。
排序事件以捕获因果关系
如果事件之间没有因果联系,缺少全序并不是什么大问题,因为并发事件可以按任意顺序排列。有些情形也很容易处理:例如,同一个对象有多次更新时,只要把特定对象 ID 的所有更新都路由到同一个日志分片,就能为它们建立全序。然而,因果依赖有时会以更隐蔽的方式出现。
例如,考虑一个社交网络服务,以及两个曾是情侣、但刚刚分手的用户。其中一人先把另一人移出好友列表,然后向剩余好友发送消息,抱怨自己的前任。这个用户的本意是,不让前任看到这条粗鲁的消息,因为消息是在好友关系解除之后发送的。
然而,如果一个系统把好友关系状态和消息存放在不同的位置,那么 解除好友 事件与 发送消息 事件之间的顺序依赖可能会丢失。如果没有捕捉到这种因果依赖,负责发送新消息通知的服务就可能先处理 发送消息 事件、后处理 解除好友 事件,从而错误地向前任发出通知。
在这个例子中,通知实际上是消息与好友列表之间的连接,因此它涉及我们之前讨论过的连接时序问题(参见 “连接的时间依赖性”)。遗憾的是,这个问题似乎没有简单的答案 2、3。一些可能的起点包括:
逻辑时间戳无需协调即可提供全序(参见 “ID 生成器和逻辑时钟”),因而在全序广播不可行时或许能派上用场。然而,接收方仍需处理乱序到达的事件,而且系统还必须传递额外的元数据。
如果能用一条日志事件记录用户作出决定前所看到的系统状态,并为该事件赋予唯一标识符,那么后续事件便可引用这个事件 ID,从而记录因果依赖 4。
冲突解决算法(参见 “自动解决冲突”)有助于处理以意外顺序到达的事件。它们适合用于维护状态;但如果某个操作会产生外部副作用(例如向用户发送通知),这些算法就无能为力了。
或许未来会出现新的应用开发模式,能够高效捕捉因果依赖、正确维护衍生状态,而不必强迫所有事件都经过全序广播这一瓶颈。
批处理与流处理
数据集成(data integration)的目标,是确保数据以正确的形式出现在所有正确的位置。为此,需要消费输入,进行转换、连接、过滤、聚合、模型训练与评估,最终再写入适当的输出。批处理器和流处理器正是实现这一目标的工具。批处理与流处理的输出是衍生数据集,例如搜索索引、物化视图、向用户展示的推荐结果、聚合指标,等等。
正如我们在 第 11 章 和 第 12 章 中看到的,批处理与流处理有许多共同原则;两者最根本的区别在于,流处理器处理的是无界数据集,而批处理的输入大小已知且有限。
维护衍生状态
批处理带有很强的函数式风格(即使代码并不是用函数式编程语言编写的):它鼓励使用确定性的 纯函数(pure function),其输出只取决于输入,除了明确的输出之外没有其他 副作用(side effect);输入被视为不可变,输出则只能追加。流处理与之类似,不过它扩展了算子,使其能够维护受管理且容错的状态。
输入和输出定义明确的确定性函数,不仅有利于容错,也能简化对组织内部数据流的推理 5。无论衍生数据是搜索索引、统计模型还是缓存,都可以把它看成数据管道:从一项事物衍生出另一项事物,让一个系统的状态变更经过函数式应用代码,再把相应效果施加到衍生系统上。这样思考大有裨益。
原则上,衍生数据系统也可以同步维护,就像关系数据库在写入被索引表的同一事务中,同步更新二级索引一样。然而,异步恰恰是基于事件日志的系统能够保持稳健的原因:系统某一部分的故障可以被局限在本地;分布式事务则会在任何一个参与者失败时中止,因而容易把故障扩散到系统其他部分,将其放大。
我们在 “分片与二级索引” 中看到,二级索引常常跨越分片边界。带有二级索引的分片系统,要么需要把写入发送到多个分片(按词项分区的索引),要么需要把读取发送到所有分片(按文档分区的索引)。如果异步维护索引,这种跨分片通信也最为可靠、最具可伸缩性 6。
为应用演化而重新处理数据
维护衍生数据时,批处理和流处理都很有用。流处理可以用很低的延迟把输入中的变更反映到衍生视图中;批处理则可以重新处理大量累积的历史数据,从已有数据集衍生出新的视图。
尤其是,重新处理现有数据为维护和演化系统、支持新功能与变化后的需求,提供了一种良好机制。如果不能重新处理,模式演化就只能局限于简单改动,例如为记录添加一个新的可选字段,或者增加一种新的记录类型。而有了重新处理,就可以把数据集重组为完全不同的模型,从而更好地满足新需求。
大规模的“模式迁移”也会发生在非计算机系统中。例如,19 世纪英国铁路建设初期,轨距(两条铁轨之间的距离)存在多种相互竞争的标准。为一种轨距建造的列车无法在另一种轨距的轨道上行驶,这限制了铁路网络可能实现的互联 7。
1846 年终于确定了统一的标准轨距,其他轨距的线路都必须改造——可怎样才能在不让铁路停运几个月乃至几年的情况下完成改造?解决办法是先增加第三条铁轨,把线路改成 双轨距 或 混合轨距。这种改造可以逐步进行;完成之后,两种轨距的列车都能在同一条线路上行驶,各自使用三条铁轨中的两条。最终,所有列车都改用标准轨距后,非标准轨距所用的那条铁轨便可拆除。
以这种方式“重新处理”既有轨道,并让新旧版本并行存在,就能在数年时间里逐步改变轨距。尽管如此,这仍是一项昂贵的工程,所以非标准轨距至今依然存在。例如,旧金山湾区的 BART 系统使用的轨距就不同于美国大多数铁路。
衍生视图允许系统 渐进式 演化。如果要重组一个数据集,并不需要突然切换完成迁移。你可以把旧模式和新模式作为底层同一份数据上的两个独立衍生视图,并排维护。随后,先把少量用户转向新视图,以测试其性能并发现缺陷,同时让大多数用户继续使用旧视图。之后逐步提高访问新视图的用户比例,最终删除旧视图 8、9。
这种渐进迁移的妙处在于:如果出了问题,过程中的每个阶段都很容易逆转,始终有一个可用的系统供你退回。由于不可逆损害的风险降低,你可以更有信心地继续推进,从而更快地改进系统 10。
统一批处理与流处理
统一批处理与流处理的一项早期提案是 Lambda 架构 11。它存在不少问题 12,如今已很少使用。较新的系统允许在同一系统中实现批计算(重新处理历史数据)与流计算(在事件到达时处理事件)13;这种方法有时称为 Kappa 架构 12。
要在一个系统中统一批处理与流处理,需要具备以下功能:
能够让历史事件通过处理近期事件流的同一个处理引擎重放。例如,基于日志的消息代理可以重放消息,一些流处理器也能从分布式文件系统或对象存储中读取输入。
为流处理器提供 恰好一次语义(exactly-once semantics)——也就是说,即使实际发生了故障,也要确保输出与从未发生故障时相同。与批处理一样,这要求丢弃所有失败任务的部分输出。
提供按事件时间而非处理时间划分窗口的工具,因为重新处理历史事件时,处理时间没有任何意义。例如,Apache Beam 提供了表达这类计算的 API,之后可以用 Apache Flink 或 Google Cloud Dataflow 来运行。
分拆数据库
在最抽象的层面上,数据库、批处理器、流处理器和操作系统执行着相同的功能:存储一些数据,并允许你处理和查询这些数据 14、15。数据库把数据存储为某种数据模型中的记录(表中的行、文档、图中的顶点等),操作系统的文件系统则把数据存储在文件中——但二者本质上都是“信息管理”系统 16。正如我们在 第 11 章 中看到的,批处理器就像 Unix 的分布式版本。
当然,实际差异仍然很多。例如,许多文件系统无法很好地处理一个包含 1000 万个小文件的目录,而数据库中有 1000 万条小记录却完全稀松平常。尽管如此,操作系统与数据库之间的异同仍然值得探究。
Unix 与关系数据库采用截然不同的哲学来处理信息管理问题。Unix 认为自己的目标是向程序员提供一种合乎逻辑、但层次相当低的硬件抽象;关系数据库则希望向应用程序员提供高层次抽象,隐藏磁盘数据结构、并发、崩溃恢复等复杂问题。Unix 发展出了管道以及本质上只是字节序列的文件,数据库则发展出了 SQL 与事务。
哪种方法更好?当然要看你想要什么。Unix 的“简单”,在于它只是硬件资源外面一层相当薄的包装;关系数据库的“简单”,则在于一条简短的声明式查询就能借助大量强大的基础设施(查询优化、索引、连接方法、并发控制、复制等),而查询作者无需了解实现细节。
这两种哲学之间的张力已经持续数十年(Unix 和关系模型都出现于 20 世纪 70 年代初),至今仍未消解。例如,可以把 NoSQL 运动理解为:试图把 Unix 式的低层抽象方法应用于分布式 OLTP 数据存储领域。
本节试图调和这两种哲学,希望能够兼取二者之长。
组合使用数据存储技术
在本书的过程中,我们讨论了数据库提供的各种功能及其工作原理,其中包括:
二级索引,使你可以根据字段值高效搜索记录;
物化视图,一种预先计算的查询结果缓存;
复制日志,使其他节点上的数据副本保持最新;以及
全文检索索引,允许在文本中进行关键词搜索,一些关系数据库也内置了这种索引 1。
在 第 11 章 和 第 12 章 中,我们也遇到了类似主题。我们谈过如何构建全文检索索引、如何维护物化视图,以及如何通过变更数据捕获,把数据库中的变更复制到衍生数据系统。
数据库内置的功能,与人们使用批处理器和流处理器构建的衍生数据系统,似乎存在诸多相似之处。
创建索引
想一想,在关系数据库中运行 CREATE INDEX 创建新索引时会发生什么。数据库必须扫描表的一致性快照,取出所有要索引的字段值,对其排序,再写出索引。接着,它还必须处理拍摄一致性快照后积压的所有写入(假设创建索引时没有锁住表,因此写入可以继续)。完成之后,每当事务写入该表,数据库都必须继续更新索引。
这个过程与设置新的从库副本极其相似(参见 “设置新的副本”),也很像在流处理系统中引导变更数据捕获(参见 “初始快照”)。
每次运行 CREATE INDEX,数据库本质上都是在重新处理现有数据集,并把索引衍生为既有数据之上的一个新视图。现有数据可能是状态快照,而不是曾经发生过的所有变更的日志,但二者密切相关。
一切的元数据库
从这个角度看,整个组织的数据流开始像一个巨大的数据库 5。每当批处理、流处理或 ETL 过程把数据从一种位置和形式传送到另一种位置和形式,它就像是在充当维护索引或物化视图的数据库子系统。
这样看来,批处理器和流处理器就像触发器、存储过程与物化视图维护算法的精巧实现;它们维护的衍生数据系统则像不同种类的索引。例如,关系数据库可能支持 B 树索引、哈希索引、空间索引以及其他索引。在新兴的衍生数据系统架构中,这些能力不再作为单个集成数据库产品的功能来实现,而是由各种不同的软件提供,运行在不同机器上,并由不同团队管理。
这些发展未来会把我们带向何方?如果从“没有任何一种数据模型或存储格式适合所有访问模式”这一前提出发,那么仍有两条途径,可以把不同的存储与处理工具组合成一个协调一致的系统:
- 联合数据库:统一读取
可以为各种底层存储引擎和处理方法提供统一的查询接口——这种方法称为 联合数据库(federated database)或 多模存储(polystore)17、18。例如,PostgreSQL 的 外部数据封装器(foreign data wrapper)功能符合这种模式,Trino、Hoptimator 和 Xorq 等联合查询引擎也是如此。需要专用数据模型或查询接口的应用仍可直接访问底层存储引擎;而希望组合不同位置数据的用户,则可以通过联合接口轻松完成。
联合查询接口延续了关系模型的传统:提供带有高层查询语言和优雅语义的单一集成系统,但其实现非常复杂。
- 分拆数据库:统一写入
联合能够解决跨多个不同系统的只读查询问题,却无法很好地解决这些系统之间的写入 同步。前面说过,在单个数据库中,创建一致的索引是一项内置功能。当我们组合多个存储系统时,同样需要确保所有数据变更最终到达所有正确的位置,即使发生故障也不例外。让存储系统更容易可靠地连接起来(例如通过变更数据捕获和事件日志),就像把数据库的索引维护功能 分拆 出来,使它能够跨不同技术同步写入 5、19。
分拆方法遵循 Unix 的传统:小工具各自做好一件事 20,通过统一的低层 API(管道)通信,再用更高层的语言(shell)组合起来 14。
让分拆行得通
联合与分拆是一枚硬币的两面:都是用不同组件组成可靠、可伸缩、可维护的系统。联合只读查询需要把一种数据模型映射到另一种数据模型,这需要一些思考,但归根结底是个相当容易处理的问题。让多个存储系统的写入保持同步,才是更困难的工程问题,因此这里将重点讨论它。
同步写入的传统方法要求跨异构存储系统使用分布式事务 17,但如前所述,这种方法问题重重。单个存储系统或流处理系统内部的事务是可行的;然而,当数据跨越不同技术之间的边界时,带有幂等写入的异步事件日志要稳健、实用得多。
例如,一些流处理器内部使用分布式事务来实现恰好一次语义,而且效果可以很好。然而,如果一项事务需要涉及由不同团队编写的系统(例如从流处理器把数据写入分布式键值存储或搜索索引),缺少标准化事务协议就会使集成难上加难。带有幂等消费者的有序事件日志是一种简单得多的抽象,因此更有可能跨异构系统实现 5。
基于日志的集成有一项巨大优势:各个组件之间 松散耦合(loose coupling)。这种优势体现在两个方面:
在系统层面,异步事件流使整个系统更能抵御个别组件中断或性能下降。如果某个消费者速度很慢或发生故障,事件日志可以缓冲消息,让生产者和其他消费者不受影响地继续运行。故障消费者修复后可以追赶进度,因此不会漏掉任何数据,而故障也被限制在局部。相比之下,分布式事务中的同步交互往往会把局部故障升级为大规模失效。
在人员层面,分拆数据系统使不同团队可以彼此独立地开发、改进和维护不同的软件组件与服务。专业化让每个团队都能专心做好一件事,并通过定义明确的接口与其他团队的系统交互。事件日志提供的接口既足够强大,可以表达相当强的一致性属性(得益于事件的持久性与顺序),又足够通用,几乎适用于任何种类的数据。
分拆式系统与集成式系统
即使分拆确实成为未来的方向,它也不会取代现有形态的数据库——人们仍会一如既往地需要数据库。流处理器需要数据库来维护状态,批处理器与流处理器的输出也需要数据库来提供查询服务。专用查询引擎对特定工作负载仍然十分重要:例如,数据仓库中的查询引擎针对探索式分析查询进行了优化,很擅长处理这类工作负载。
运行多种基础设施所带来的复杂性可能是个问题:每种软件都有学习曲线、配置问题和运维怪癖,因此值得尽量减少部署中的活动部件。对于其设计所针对的工作负载,与用应用代码把多个工具拼接起来的系统相比,单一集成软件产品也可能提供更好、更可预测的性能 21。为并不需要的规模构建系统只是徒费力气,还可能把你锁定在僵化的设计中;这实际上是一种过早优化。
分拆的目标并不是在特定工作负载的性能上与单个数据库竞争;它的目标是让你能够组合多个不同的数据库,从而在远比单一软件所能覆盖的工作负载范围内取得良好性能。它追求的是广度,而不是深度。
因此,如果有一种技术能够满足你的全部需求,最好的选择很可能就是直接使用该产品,而不是试图用更低层的组件自行重新实现。只有当没有任何单一软件能够满足全部需求时,分拆与组合的优势才会显现。
用于组合数据系统的工具正在不断完善:Debezium 可以从许多数据库中抽取变更流;Kafka 协议正在成为事件流事实上的标准;增量视图维护引擎(参见 “增量视图维护”)则让复杂查询的缓存可以预先计算并持续更新。
围绕数据流设计应用
底层数据一旦变化便更新衍生数据,这个基本想法并不新鲜。例如,电子表格早已有强大的数据流编程能力 22:你可以在一个单元格中放入公式(比如求另一列单元格之和),每当公式的任何输入发生变化,公式结果都会自动重新计算。这正是我们希望数据系统在系统层面做到的事:数据库中的一条记录发生变化时,该记录的所有索引都应自动更新,所有依赖它的缓存视图或聚合结果也应自动刷新。你不必操心刷新过程的技术细节,只需要相信它会正确运行。
因此,大多数数据系统仍有许多地方需要向 1979 年的 VisiCalc 学习 23。与电子表格不同,当今的数据系统必须容错、可伸缩,并能持久地存储数据;它们还必须能够集成不同团队在不同时间编写的异构技术,并复用既有库与服务。指望所有软件都使用某一种语言、框架或工具开发,并不现实。
本节将进一步展开这些想法,探讨如何围绕数据库分拆与数据流的理念来构建应用。
应用代码作为衍生函数
一个数据集从另一个数据集衍生出来时,需要经过某种转换函数。例如:
二级索引是一种衍生数据集,其转换函数很直接:对于基础表中的每一行或每一份文档,取出要索引的列值或字段值,再按这些值排序(假设使用按键排序的 SSTable 或 B 树索引)。
全文检索索引的创建过程,是先应用语言检测、分词、词干提取或词形还原、拼写纠正、同义词识别等各种自然语言处理函数,再构建用于高效查找的数据结构(例如倒排索引)。
在机器学习系统中,可以把模型看作是对训练数据应用各种特征提取和统计分析函数后得到的衍生物。模型应用于新的输入数据时,模型输出衍生自输入与模型(因此也间接衍生自训练数据)。
缓存通常以用户界面(UI)将要展示的形式保存数据聚合结果。因此,填充缓存需要知道 UI 引用了哪些字段;UI 的变更可能要求更新缓存填充方式的定义,并重建缓存。
二级索引的衍生函数需求极其常见,因此许多数据库都把它作为核心功能内置其中,只要执行 CREATE INDEX 就能调用。对于全文索引,常见语言的基础语言学功能或许内置于数据库,但更复杂的功能往往需要针对具体领域调整。在机器学习中,特征工程出了名地依赖具体应用,常常必须融入应用的用户交互与部署方式等详细知识 24。
如果创建衍生数据集的函数不像创建二级索引那样是标准化的套路,就需要用自定义代码处理应用特有的部分。而许多数据库恰恰难以应付这种自定义代码。关系数据库通常支持触发器、存储过程和用户定义函数,可以借此在数据库内部执行应用代码;但在数据库设计中,这些能力多少像是事后补上的。
分离应用代码与状态
理论上,数据库可以像操作系统一样,成为任意应用代码的部署环境。然而实践证明,数据库并不适合这个用途。依赖项与包管理、版本控制、滚动升级、可演化性、监控、指标、调用网络服务、与外部系统集成——数据库都无法很好地满足这些现代应用开发需求。
另一方面,Kubernetes、Docker、Mesos、YARN 等部署和集群管理工具,正是为运行应用代码而专门设计的。它们专注于做好这一件事,因此远胜于那些只把执行用户定义函数当作众多功能之一的数据库。
今天,大多数 Web 应用都以无状态服务的形式部署:任意用户请求都可以路由到任意应用服务器,服务器发出响应后便忘掉该请求的一切。这种部署方式很方便,因为服务器可以随意增加或移除;不过状态总得有个去处——通常是数据库。总体趋势是把无状态应用逻辑与状态管理(数据库)分开:既不把应用逻辑放进数据库,也不把持久状态放进应用 25。函数式编程社区喜欢开玩笑说:“我们信奉 教会(Church) 与 国家(state) 分离。”26
解释笑话通常会毁掉笑话,不过为了照顾没听懂的读者,这里还是解释一下。Church 指数学家阿隆佐・邱奇(Alonzo Church);他创造了 lambda 演算——一种早期计算形式,也是大多数函数式编程语言的基础。Lambda 演算没有可变状态(也就是没有可以被覆写的变量),所以也可以说,可变状态与 Church 的工作彼此分离。
在这种典型的 Web 应用模型中,数据库充当一种可以通过网络同步访问的可变共享变量。应用可以读取和更新这个变量,数据库则负责将它持久保存,并提供一定的并发控制与容错能力。
然而,在大多数编程语言中,你无法订阅可变变量的变化——只能定期读取它。与电子表格不同,变量的值发生变化时,读取者不会收到通知。(你可以在自己的代码中实现这种通知,这称为 观察者模式,observer pattern,但大多数语言都没有把这种模式作为内置功能。)
数据库继承了这种对待可变数据的被动方式:如果想知道数据库内容是否发生变化,你通常只能轮询(即定期重复查询)。订阅变更才刚刚开始成为数据库的一项功能。
数据流:状态变更与应用代码的相互作用
从数据流角度思考应用,意味着要重新协商应用代码与状态管理之间的关系。我们不再把数据库当作受应用操纵的被动变量,而是更加关注状态、状态变更以及处理这些变更的代码之间如何相互作用、彼此协作。应用代码响应一处的状态变更,并在另一处触发状态变更。
我们已经在变更数据捕获、Actor 模型、触发器和增量视图维护中见过这种想法。分拆数据库,就是把这一想法应用到主数据库之外的衍生数据集创建过程:缓存、全文检索索引、机器学习系统或分析系统。为此,我们可以使用流处理与消息传递系统。
维护衍生数据需要以下性质,而基于日志的消息代理能够提供这些性质:
维护衍生数据时,状态变更的顺序往往十分重要(如果多个视图都衍生自同一事件日志,它们就必须按相同顺序处理事件,才能彼此保持一致)。
容错必不可少:哪怕只丢失一条消息,衍生数据集也会与数据源永久失去同步。消息传递和衍生状态更新都必须可靠。
稳定的消息顺序和容错的消息处理要求相当严格,但它们的开销比分布式事务小得多,运维上也更加稳健。现代流处理器可以大规模提供这些顺序与可靠性保证,并允许应用代码作为流算子运行。
这类应用代码可以执行任意处理,补足数据库内置衍生函数通常不具备的能力。就像用管道串联起来的 Unix 工具一样,流算子也可以组合起来,围绕数据流构建大型系统。每个算子都以状态变更流作为输入,并产生其他状态变更流作为输出。
流处理器与服务
目前占主导地位的应用开发风格,是把功能拆分成一组 服务,服务之间通过 REST API 等同步网络请求通信。与单体应用相比,这种面向服务架构的主要优势,在于通过松散耦合实现组织上的可伸缩性:不同团队可以分别负责不同服务,从而减少团队间的协调工作(前提是各项服务能够独立部署和更新)。
把流算子组合成数据流系统,与微服务方法有许多相似之处 27、28。不过,两者底层的通信机制截然不同:前者使用单向异步消息流,后者使用同步的请求/响应交互。
除了 “事件驱动的架构” 中列出的优势(例如更好的容错性),数据流系统还可以获得优于传统 REST API 或 RPC 的性能。例如,假设顾客购买一件以一种货币定价、却用另一种货币付款的商品。要完成货币换算,就需要知道当前汇率。这个操作可以通过两种方式实现 27、29:
采用微服务方法时,处理购买操作的代码很可能查询汇率服务或数据库,以获得某种货币的当前汇率。
采用数据流方法时,处理购买操作的代码会预先订阅汇率更新流,并在汇率发生变化时把当前汇率记录到本地数据库中。真正处理购买操作时,只需查询本地数据库。
第二种方法用本地数据库查询,取代了对另一项服务的同步网络请求(本地数据库可能就在同一台机器上,甚至在同一个进程中)。在微服务方法中,也可以把汇率缓存在处理购买操作的服务本地,从而避免同步网络请求。然而,为了让缓存保持新鲜,就必须定期轮询汇率更新,或者订阅变更流——这恰好就是数据流方法所做的事。
数据流方法不仅更快,而且面对另一项服务发生故障时也更稳健。最快、最可靠的网络请求,就是根本不发出网络请求!RPC 不复存在,取而代之的是购买事件与汇率更新事件之间的流连接。
这种连接依赖于时间:如果日后重新处理购买事件,汇率早已改变。若想重建原始输出,就必须获得当初购买时的历史汇率。无论是查询服务还是订阅汇率更新流,都需要处理这种时间依赖性(参见 “连接的时间依赖性”)。
订阅变更流,而不是等到需要时才查询当前状态,使我们更接近电子表格式的计算模型:某项数据一旦变化,所有依赖它的衍生数据都能迅速更新。时间依赖连接等方面仍有许多悬而未决的问题,但围绕数据流理念构建应用,是一个很有前景、值得探索的方向。
观察衍生状态
从抽象层面看,上一节讨论的数据流系统提供了一套创建并持续更新衍生数据集(例如搜索索引、物化视图和预测模型)的过程。我们把这个过程称为 写路径(write path):每当有信息写入系统,它可能经过多轮批处理和流处理,最终所有衍生数据集都会更新,纳入这次写入的数据。图 13-1 展示了更新搜索索引的例子。

但你最初为什么要创建衍生数据集?很可能是为了日后查询。这就是 读路径(read path):处理用户请求时,从衍生数据集中读取数据,也许再对结果做些处理,最后构造返回给用户的响应。
写路径和读路径合在一起,涵盖了数据的完整旅程:从收集数据的地方,直至数据被消费的地方(很可能由另一个人消费)。写路径是预先计算的那一段——也就是数据一到达便立即完成,不管有没有人要求查看。读路径则只在有人请求时才发生。如果你熟悉函数式编程语言,或许会发现写路径类似于立即求值,读路径则类似于惰性求值。
如 图 13-1 所示,衍生数据集正是写路径与读路径相遇之处。它代表着写入时所需工作量与读取时所需工作量之间的权衡。
物化视图与缓存
全文检索索引就是一个很好的例子:写路径更新索引,读路径在索引中检索关键词。读写两端都要做些工作。写入需要更新文档中所有词项的索引条目;读取需要搜索查询中的每个词,并应用布尔逻辑,找出包含查询中 所有 词(AND 运算符)的文档,或者包含每个词的 任一 同义词(OR 运算符)的文档。
如果没有索引,搜索查询就必须扫描所有文档(类似 grep);文档数量一多,代价便会极其高昂。没有索引意味着写路径上的工作较少(无需更新索引),但读路径上的工作会多得多。
反过来,也可以设想预先计算所有可能查询的搜索结果。这样一来,读路径的工作就少了:无需进行布尔逻辑计算,只要找到相应查询的结果并返回即可。然而,写路径会昂贵得多:可能提出的搜索查询集合是无限的(或者至少随语料库中的词项数量呈指数增长),因此不可能预先计算所有搜索结果。
另一种选择是,只为一组固定的最常见查询预先计算搜索结果,使这些查询无需访问索引便能迅速得到响应;不常见的查询仍由索引处理。这通常称为常见查询的 缓存(cache),不过也可以称为物化视图:一旦出现应当纳入某项常见查询结果的新文档,它就必须随之更新。
这个例子说明,索引并不是写路径与读路径之间唯一可能的边界。既可以缓存常见搜索结果;文档数量较少时,也可以不用索引,进行类似 grep 的扫描。从这个角度看,缓存、索引与物化视图的作用很简单:它们移动了读路径与写路径之间的边界。我们通过预先计算结果,让写路径多做一些工作,从而节省读路径的开销。
写路径与读路径之间的工作边界,实际上正是 “案例研究:社交网络首页时间线” 中社交网络示例的主题。在那个例子中,我们还看到,名人与普通用户的读写路径边界可以划在不同位置。走过 500 页,我们又回到了原点!
有状态、可离线的客户端
写路径与读路径之间的边界很有意思,因为我们可以讨论如何移动这条边界,并探究这种移动在实践中意味着什么。下面换一个语境来看看这个想法。
过去,Web 浏览器是无状态客户端,只有接入互联网时才能做有用的事(离线时差不多只能在先前联网加载的页面里上下滚动)。然而,如今的单页 JavaScript Web 应用具备了许多有状态能力,包括客户端用户界面交互,以及 Web 浏览器内的持久化本地存储。移动应用同样可以在设备上保存大量状态,大多数用户交互也无需往返服务器。
我们在 “同步引擎与本地优先软件” 中看到,持久本地状态使一类应用成为可能:用户无需联网便可离线工作,有网络连接时再在后台与远程服务器同步 30。移动设备的蜂窝网络连接有时缓慢而不可靠;如果用户界面不用等待同步网络请求,而且应用大体上可以离线工作,对用户而言将是巨大优势。
当我们摆脱“无状态客户端与中央数据库通信”这一假设,转而在最终用户设备上维护状态时,一个充满新机会的世界便随之开启。尤其是,可以把设备上的状态视为 服务器状态的缓存。屏幕上的像素,是客户端应用中模型对象的物化视图;而模型对象,则是远程数据中心状态的本地副本 31。
将状态变更推送给客户端
在典型网页中,如果你用 Web 浏览器加载页面,随后服务器上的数据发生变化,那么除非重新加载页面,否则浏览器不会得知这一变化。浏览器只在某个时间点读取数据,并假定数据是静态的——它不会订阅服务器更新。因此,浏览器中的状态是一份陈旧缓存,除非明确轮询变更,否则不会更新。(RSS 等基于 HTTP 的 Feed 订阅协议,其实只是一种基本的轮询。)
较新的协议已经超越 HTTP 的基本请求/响应模式:服务器发送事件(EventSource API)与 WebSocket 提供了通信信道,让 Web 浏览器可以与服务器保持一条打开的 TCP 连接;只要连接仍在,服务器便能主动向浏览器推送消息。这样一来,服务器就能把客户端本地所存状态的任何变更主动告诉它,从而降低客户端状态的陈旧程度。
用写路径与读路径模型来说,主动把状态变更一路推送到客户端设备,意味着把写路径延伸至最终用户。客户端首次初始化时仍需要通过读路径取得初始状态,但此后便可依靠服务器发来的状态变更流。我们讨论过的流处理与消息传递理念,并不只限于在数据中心内运行:还可以继续向外延伸,直达最终用户设备 32。
设备有时会离线,在此期间无法收到服务器发出的任何状态变更通知。不过,这个问题我们已经解决过了:在 “消费者偏移量” 中,我们讨论了基于日志的消息代理的消费者如何在故障或断开后重新连接,并确保不漏掉断线期间到达的任何消息。同样的技术也适用于单个用户:每台设备都是一条小型事件流的订阅者。
端到端事件流
React 与 Elm 等用于开发有状态客户端和用户界面的工具 33,已经能够在底层状态发生变化时更新渲染出的用户界面。把这种编程模型进一步扩展,让服务器也能把状态变更事件推入客户端事件管道,是一件非常自然的事。
这样,状态变更就能沿端到端的写路径流动:从一台设备上触发状态变更的交互开始,经过事件日志、多个衍生数据系统与流处理器,一路到达另一台设备上观察该状态的用户界面。这些状态变更可以用相当低的延迟传播——例如端到端不到一秒。
一些应用(例如即时通讯与在线游戏)已经采用这种“实时”架构(这里指低延迟交互,而非响应时间保证)。但我们为什么不以这种方式构建所有应用?
挑战在于,无状态客户端与请求/响应交互的假设,已经深深嵌入我们的数据库、库、框架和协议。许多数据存储都支持一次请求返回一次响应的读写操作,但能够订阅变更的却少得多——也就是让一次请求随着时间推移返回一连串响应。
为了把写路径一直延伸到最终用户,我们必须从根本上重新思考许多系统的构建方式:离开请求/响应交互,转向发布/订阅数据流 31。这需要付出努力,但也会带来响应更灵敏的用户界面,以及更好的离线支持。
读也是事件
前面说过,当流处理器把衍生数据写入某个存储(数据库、缓存或索引),而这个存储随后接受查询时,它就充当了写路径与读路径之间的边界。该存储允许对数据进行随机访问读取;否则,读取查询就必须扫描整条事件日志。
在许多情况下,数据存储与流处理系统彼此分离。但别忘了,流处理器也需要维护状态,才能执行聚合与连接。这种状态通常隐藏在流处理器内部,不过有些框架也允许外部客户端查询它 34,从而让流处理器本身变成一种简单的数据库。
我们再把这个想法推进一步。到目前为止,写入通过事件日志进入存储,而读取则是短暂的网络请求,直接发往保存待查数据的节点。这种设计很合理,却不是唯一选择。我们也可以把读取请求表示成事件流,把读事件和写事件都送入流处理器;处理器通过向输出流发出读取结果,来响应读事件 35。
当读写都表示为事件,并路由到同一个流算子处理时,我们实际上是在读取查询流与数据库之间执行流表连接。读事件需要发送到保存相应数据的数据库分片,就像批处理器和流处理器执行连接时,需要按同一个键对输入进行协同分区一样。
处理请求与执行连接之间的这种对应关系,是一个非常基础的概念 36。一次性读取请求穿过连接算子后,算子立刻将它忘掉;订阅请求则是一项持久连接,与连接另一侧过去和未来的事件不断匹配。
记录读事件日志,在追踪系统中的因果依赖与数据溯源方面也可能有益:它让你能够重建用户在作出某项决定前看到了什么。例如,在网上商店中,向顾客显示的预计送达日期与库存状态,很可能会影响他们是否选择购买一件商品 4。要分析这种关联,就必须记录用户对送货与库存状态查询的结果。
因此,把读取请求写入持久存储,有助于更好地追踪因果依赖,但会增加存储与 I/O 成本。如何优化这类系统、降低开销,仍是一个开放的研究问题 2。不过,如果你本来就出于运维目的,在处理请求时顺带记录了读取请求日志,那么反过来让日志成为请求来源,并不算多么巨大的改变。
多分片数据处理
对于只涉及单个分片的查询,通过流发送查询并收集响应或许有些小题大做。不过,这个想法开启了一种可能:利用流处理器已经具备的消息路由、分片与连接基础设施,分布式执行需要组合多个分片数据的复杂查询。
Storm 的分布式 RPC 功能支持这种使用模式。例如,它曾被用于计算社交网络上看过某个 URL 的人数——也就是发布过该 URL 的所有用户,其关注者集合的并集 37。由于用户集合经过分片,这项计算必须组合许多分片的结果。
这种模式的另一个例子是欺诈防范:为了评估某项购买事件是否可能存在欺诈,可以检查用户 IP 地址、电子邮件地址、账单地址、送货地址等各自的信誉评分。每个信誉数据库本身都经过分片,因此,为某项购买事件收集这些评分,需要依次连接多个采用不同分片方式的数据集 38。
数据仓库查询引擎内部的查询执行图,也具有类似特征。如果需要执行这种多分片连接,使用原生提供该功能的数据库,很可能比借助流处理器自行实现更简单。不过,把查询视为流,仍为构建逼近传统现成方案能力极限的大规模应用提供了一种选择。
追求正确性
对于只读取数据的无状态服务,出了问题也没什么大不了:修复缺陷、重启服务,一切便恢复正常。数据库等有状态系统却没这么简单:它们的设计目标是(近乎)永久保存信息,因此一旦出了问题,影响也可能永远持续——这意味着我们必须更加仔细地思考 39。
我们希望构建既可靠又 正确 的应用(也就是即使面对各种故障,程序的语义仍有明确的定义,也能为人理解)。大约四十年来,原子性、隔离性和持久性等事务属性,一直是构建正确应用的首选工具。然而,这套基础并不像看起来那样牢固——弱隔离级别所引发的困惑便是一例(参见 “弱隔离级别”)。
在某些领域,事务已被彻底抛弃,取而代之的是性能与可伸缩性更好、语义却混乱得多的模型。人们经常谈论 一致性,却很少把它定义清楚。有些人声称,为了更高的可用性,我们应该“拥抱弱一致性”,却说不清这在实践中究竟意味着什么。
对于如此重要的主题,我们的理解与工程方法却出奇地不可靠。例如,要判断某个应用在特定事务隔离级别或复制配置下运行是否安全,非常困难 40、41。简单方案在并发度低、没有故障时往往看似正确,一旦环境要求更高,便会暴露出许多隐蔽缺陷。
例如,Kyle Kingsbury 的 Jepsen 实验 42 揭示了某些产品宣称的安全保证,与它们遭遇网络问题和崩溃时的实际行为之间存在巨大差距。即便数据库等基础设施产品本身毫无问题,应用代码仍须正确使用它们提供的功能;如果配置本就难以理解(弱隔离级别、法定人数配置等都是如此),这个过程很容易出错。
如果你的应用能够容忍偶尔以不可预测的方式损坏或丢失数据,事情会简单得多;或许只要祈求好运,就能勉强应付。反过来,如果你需要更强的正确性保证,可串行化与原子提交是成熟的方法,却也代价不菲:它们通常只能在单个数据中心内工作(排除了地理分布式架构),还会限制系统能够达到的规模与容错能力。
传统事务方法并不会消失,但要让应用既正确、又能抵御故障,事务并不是最终答案。本节将探讨在数据流架构语境下思考正确性的几种方式。
数据库的端到端原则
应用使用了具有较强安全属性的数据系统(例如可串行化事务),并不等于它就不会丢失或损坏数据。例如,如果应用缺陷导致它写入错误数据,或者从数据库删除数据,可串行化事务也救不了你。这正是支持不可变与仅追加数据的一条理由:如果不让错误代码拥有摧毁正确数据的能力,从这类错误中恢复就容易得多。
尽管不可变性很有用,但它本身并非万灵药。下面来看一个更隐蔽的数据损坏例子。
恰好一次执行操作
在 “容错” 中,我们见过 恰好一次(或 等效一次)语义。如果处理消息时出了问题,可以选择放弃(丢弃消息,也就是造成数据丢失),也可以重试。选择重试,就要承担一种风险:第一次其实已经成功,只是你没能得知,于是消息最终被处理两次。
处理两次也是一种数据损坏:我们不希望同一项服务向顾客收取两次费用(多收费),也不希望计数器递增两次(夸大指标)。在这里,恰好一次 是指这样安排计算:即便某项操作确实由于故障而重试,最终效果也与从未发生故障时相同。前面已经讨论过几种实现方式。
最有效的方法之一,是让操作变得 幂等:也就是无论执行一次还是多次,效果都相同。然而,要把本来并不幂等的操作改造成幂等操作,需要额外投入并谨慎处理:你可能需要维护额外的元数据(例如曾经更新过某个值的操作 ID 集合),并确保从一个节点故障切换到另一个节点时使用栅栏机制(参见 “分布式锁和租约”)。
抑制重复
这种需要抑制重复的模式,还会出现在流处理之外的许多地方。例如,TCP 使用数据包的序列号,让接收方按正确顺序排列数据包,并判断网络中是否有包丢失或重复。丢失的包会被重传,重复的包则由 TCP 栈移除,之后数据才交给应用。
不过,这种重复抑制只能在单条 TCP 连接的范围内发挥作用。假设这条 TCP 连接把客户端连到数据库,当前正在执行 例 13-1 中的事务。在许多数据库中,事务与客户端连接绑定(如果客户端发送多条查询,数据库之所以知道它们属于同一事务,是因为它们都从同一条 TCP 连接发来)。如果客户端发出 COMMIT 之后、尚未收到数据库服务器的回应之前遭遇网络中断与连接超时,它便无从知道事务究竟已经提交还是已经中止(图 9-1)。
例 13-1. 从一个账户向另一个账户非幂等地转账
客户端可以重新连接数据库并重试事务,但这已经超出 TCP 重复抑制的范围。由于 例 13-1 中的事务并不幂等,结果可能实际转了 $22,而不是预期的 $11。因此,尽管 例 13-1 是说明事务原子性的标准示例,它实际上并不正确,真正的银行也不会这样工作 3。
两阶段提交协议(参见 “两阶段提交(2PC)”)打破了 TCP 连接与事务之间的一一对应,因为它必须允许事务协调者在网络故障后重新连接数据库,并告诉数据库应当提交还是中止悬而未决的事务。这足以保证事务只执行一次吗?很遗憾,并不足够。
即使能够抑制数据库客户端与服务器之间的重复事务,我们仍然要担心最终用户设备与应用服务器之间的网络。例如,如果最终用户客户端是 Web 浏览器,它可能通过 HTTP POST 请求向服务器提交指令。也许用户的蜂窝数据连接很差:POST 成功发出,但信号在服务器响应到达之前变得太弱。
此时,用户很可能看到错误消息,并手动重试。Web 浏览器会警告:“确定要再次提交此表单吗?”——用户选择确定,因为他们本来就希望操作发生。(Post/Redirect/Get 模式 43 可以在正常情况下避免这条警告,却无法解决 POST 请求超时。)在 Web 服务器看来,重试是另一次请求;在数据库看来,它也是另一个事务。通常的去重机制无济于事。
唯一标识请求
要让请求经过多跳网络通信后仍然幂等,只依靠数据库提供的事务机制是不够的——必须考虑请求的 端到端 流程。
例如,可以为请求生成唯一标识符(如 UUID),将它作为隐藏表单字段放入客户端应用;也可以对所有相关表单字段计算哈希,衍生出请求 ID 3。如果 Web 浏览器提交两次 POST 请求,两次请求就会携带同一个请求 ID。随后,可以把这个请求 ID 一路传到数据库,并检查给定 ID 的请求永远只执行一次,如 例 13-2 所示。
例 13-2. 使用唯一 ID 抑制重复请求
例 13-2 依赖 request_id 列上的唯一性约束。如果事务试图插入一个已经存在的 ID,INSERT 就会失败,事务随之中止,避免再次生效。即便隔离级别较弱,关系数据库通常也能正确维护唯一性约束(而应用层面的“先检查再插入”在非可串行化隔离下可能失效,如 “写偏差与幻读” 所述)。
除了抑制重复请求,例 13-2 中的 requests 表还充当了一种事件日志,可用于事件溯源或变更数据捕获。账户余额的更新其实不必与插入事件发生在同一事务中,因为它们是冗余状态,可以由下游消费者从请求事件衍生出来——只要事件得到恰好一次处理,而这一点同样可以借助请求 ID 强制保证。
端到端原则
抑制重复事务的情形,只是一个更普遍原则的例子。这个原则称为 端到端原则(end-to-end argument),由 Saltzer、Reed 和 Clark 于 1984 年提出 44:
只有借助位于通信系统两端的应用所掌握的知识与提供的协助,所讨论的功能才能得到完整、正确的实现。因此,不可能把这一功能作为通信系统本身的一项功能来提供。(有时,通信系统提供的不完整版本可以用来提升性能。)
在我们的例子中,所讨论的功能 是重复抑制。TCP 会在 TCP 连接层面抑制重复数据包,一些流处理器则在消息处理层面提供所谓的恰好一次语义;但如果第一次请求超时,这些机制都不足以防止用户再次提交同一请求。TCP、数据库事务和流处理器自身都无法彻底排除这种重复。解决问题需要端到端方案:让事务标识符从最终用户客户端一路传到数据库。
端到端原则同样适用于检查数据完整性:以太网、TCP 与 TLS 内置的校验和可以检测网络数据包损坏,却无法检测网络连接两端收发软件中的缺陷所造成的损坏,也无法检测存储数据的磁盘发生的损坏。如果想捕捉所有可能的数据损坏来源,就还需要端到端校验和。
类似的道理也适用于加密 44:家庭 WiFi 网络的密码可以阻止他人窃听你的 WiFi 流量,却防不住互联网其他地方的攻击者;客户端与服务器之间的 TLS/SSL 可以抵御网络攻击者,却防不住服务器本身遭到入侵。只有端到端加密与认证才能抵御所有这些威胁。
尽管低层功能(TCP 重复抑制、以太网校验和、WiFi 加密)单凭自身无法提供所需的端到端功能,它们仍然有用,因为它们降低了高层发生问题的概率。例如,如果没有 TCP 把数据包重新排成正确顺序,HTTP 请求往往会变得支离破碎。我们只需记住:仅靠低层可靠性功能,并不足以保证端到端正确性。
在数据系统中应用端到端思维
这又把我们带回最初的论点:应用使用了提供较强安全属性的数据系统(例如可串行化事务),并不代表它一定不会丢失或损坏数据。应用自身同样必须采取端到端措施,例如抑制重复。
这未免令人遗憾,因为容错机制很难正确实现。TCP 等低层可靠性机制相当有效,因此剩余的高层故障很少发生。若能把余下的高层容错机制封装成一种抽象,让应用代码不必操心,那再好不过——但我们似乎还没有找到合适的抽象。
长期以来,事务一直被视为有用的抽象。正如 第 8 章 所述,它把各种可能的问题(并发写入、违反约束、崩溃、网络中断、磁盘故障)压缩成两种可能结果:提交或中止。这极大简化了编程模型,但仍然不够。
事务的代价很高,涉及异构存储技术时尤其如此(参见 “跨不同系统的分布式事务”)。当我们因为分布式事务代价过高而拒绝使用它时,最终不得不在应用代码中重新实现容错机制。本书大量例子表明,对并发与部分失效进行推理既困难又反直觉,因此大多数应用级机制都无法正确工作,结果便是数据丢失或损坏。
因此,值得探索这样的容错抽象:既能轻松提供应用特有的端到端正确性,又能在大规模分布式环境中保持良好的性能与运维特性。
强制约束
下面结合数据库分拆的理念来思考正确性。前面看到,只要把请求 ID 从客户端一路传到记录写入的数据库,就能实现端到端重复抑制。那么,其他类型的约束呢?
我们特别关注 唯一性约束——也就是 例 13-2 所依赖的约束。在 “约束与唯一性保证” 中,我们还见过另外几种需要强制唯一性的应用功能:用户名或电子邮件地址必须唯一标识一名用户;文件存储服务不能有多个同名文件;两个人不能预订同一个航班座位或剧院座位。
其他约束也十分相似,例如确保账户余额永不为负、售出的商品不超过仓库库存,或者会议室的预订时间不能重叠。强制唯一性的技术通常也能用于这类约束。
唯一性约束需要共识
我们在 第 10 章 中看到,在分布式环境中强制唯一性约束需要共识:如果有多个取值相同的并发请求,系统必须设法决定接受哪一个冲突操作,并以违反约束为由拒绝其余操作。
达成这种共识最常见的方法,是让单个节点担任领导者,负责作出所有决定。只要你不介意让全部请求汇入单个节点(哪怕客户端身处地球另一端),而且该节点不发生故障,这种方法就行得通。Raft 等共识算法则解决了当前领导者失效(或者因网络问题而被认为失效)时,如何安全选举新领导者并避免脑裂的问题。
唯一性检查可以根据必须唯一的值进行分片,从而横向扩展。例如,如果要像 例 13-2 那样按请求 ID 保证唯一性,就可以确保所有具有相同请求 ID 的请求都路由到同一个分片;如果用户名必须唯一,则可以按用户名的哈希值分片。
不过,异步多主复制并不适用,因为不同领导者可能并发接受相互冲突的写入,使值不再唯一。如果希望立即拒绝任何违反约束的写入,同步协调便不可避免 45。
基于日志的消息传递中的唯一性
共享日志保证所有消费者以相同顺序看到消息——这种保证在形式上称为 全序广播,并且等价于共识(参见 “共识的多面性”)。在使用基于日志消息传递的数据库分拆方法中,可以采用非常相似的方式强制唯一性约束。
流处理器用单个线程依次消费某个日志分片中的所有消息。因此,如果日志按照必须唯一的值来分片,流处理器就能毫无歧义地、确定性地判断,多项冲突操作中哪一项最先出现在日志里。例如,多个用户试图注册同一个用户名时 46:
每个用户名请求都被编码成一条消息,并追加到由用户名哈希值决定的分片。
流处理器依次读取日志中的请求,用本地数据库记录哪些用户名已经被占用。每当有请求申请一个可用用户名,处理器就把该名称记为已占用,并向输出流发出成功消息;每当请求申请一个已经占用的用户名,处理器就向输出流发出拒绝消息。
请求用户名的客户端观察输出流,等待与自身请求对应的成功或拒绝消息。
这一算法与我们在 第 10 章 中见过的、使用共享日志实现共识的构造相同。只要增加分片数量,就能轻松扩展到很高的请求吞吐量,因为每个分片都可以独立处理。
这种方法不仅适用于唯一性约束,也适用于许多其他约束。其基本原则是:任何可能冲突的写入都路由到同一个分片,依次处理。冲突的定义可能取决于具体应用,但流处理器可以用任意逻辑来验证请求。
多分片请求处理
当一项操作涉及多个分片时,要让它在满足约束的同时原子执行,问题就更有意思了。例 13-2 可能涉及三个分片:保存请求 ID 的分片、保存收款方账户的分片,以及保存付款方账户的分片。这三者彼此独立,没有理由一定落在同一个分片中。
采用传统数据库方法时,执行这项事务需要跨三个分片原子提交;这实质上迫使它与这三个分片中任何一个分片上的其他所有事务形成全序。既然出现了跨分片协调,各分片便无法再独立处理,吞吐量很可能因此受损。
然而,借助分片日志与流处理器,无需跨分片事务也能实现等价的正确性。图 13-2 展示了一项付款事务:先检查源账户余额是否充足;若余额充足,则在扣除手续费的同时,把一笔金额原子地转入目标账户。具体过程如下 47:

用户客户端为从源账户向目标账户转账的请求赋予唯一请求 ID,再根据源账户 ID,把请求追加到相应日志分片。
流处理器读取请求日志,并维护一个数据库,其中保存源账户的状态以及已经处理过的请求 ID。这个数据库的内容完全衍生自日志。当流处理器遇到一个从未见过的请求 ID 时,它会在本地数据库中检查源账户余额是否足以完成转账。
如果余额充足,处理器就在本地数据库中更新源账户状态,预留付款金额,并向另外几条日志发出事件:向源账户的日志分片(也就是处理器自己的输入日志)发出一条出账事件,向目标账户的日志分片发出一条入账事件,再向手续费账户的日志分片发出一条入账事件。发出的这些事件都包含原始请求 ID。
出账事件最终会回到源账户处理器(其间可能已经收到一些不相干的事件)。流处理器根据请求 ID 认出,这是先前已经预留的一笔付款,于是现在执行付款,再次更新本地保存的源账户状态。它会根据请求 ID 忽略重复事件。
目标账户与手续费账户的日志分片分别由独立的流处理任务消费。它们收到入账事件后,会更新各自的本地状态以反映这笔款项,并根据请求 ID 对事件去重。
图 13-2 把三个账户画在三个不同分片中,但它们也完全可以位于同一个分片——这无关紧要。我们只需要保证:给定账户的所有事件都严格按照日志顺序处理,并采用至少一次语义,而且流处理器是确定性的。
例如,设想源账户处理器在处理付款请求时崩溃。崩溃之前,输出消息可能已经发出,也可能尚未发出。处理器从崩溃中恢复后,会再次处理同一个请求(因为采用至少一次语义);由于处理器具有确定性,它仍会对是否允许付款作出相同决定。因此,它会向出账、入账和手续费账户分片发出带有相同请求 ID 的同一批输出消息。如果这些消息是重复的,下游消费者会根据请求 ID 将其忽略。
这个系统的原子性不来自任何事务,而来自把初始请求事件写入源账户日志这一原子操作。一旦那条事件进入日志,所有下游事件最终也都会写入——可能要等流处理器从崩溃中恢复,可能还会出现重复,但它们终究会出现。
如果采用恰好一次语义,这个例子实现起来会更容易,因为它能确保流处理器的本地状态与已经处理的消息集合保持一致。因此,如果处理器崩溃并重新处理某些消息,它的本地状态也会重置到处理这些消息之前的状态。
如果 图 13-2 中的用户想知道转账是否获批,可以订阅源账户的日志分片,等待出账事件。如果希望在余额不足时明确通知用户,流处理器可以向该日志分片发出一条“付款被拒”事件。
通过把多分片事务拆成多个采用不同分片方式的阶段,并使用端到端请求 ID,我们实现了相同的正确性属性(每个请求对付款方与收款方账户都恰好应用一次):即使发生故障也不例外,而且无需使用原子提交协议。
及时性与完整性
许多事务系统都有一项便利的性质:一个事务提交后,其写入立刻对其他事务可见。这项性质的形式化名称是 严格可串行化(strict serializability;参见 “线性一致性与可串行化”)。
把一项操作分拆为流处理器的多个阶段后,情况却并非如此:日志消费者在设计上就是异步的,所以发送者不会等待消费者处理完自己的消息。不过,客户端仍可以等待某条消息出现在输出流上。例如,图 13-2 中的用户可以等待出账事件或付款被拒事件,这取决于源账户中是否有足够资金。
在这个例子中,检查源账户余额是否正确,并不取决于发出请求的用户是否等待结果。等待只是为了同步告知用户付款是否成功,这项通知与处理请求产生的效果彼此解耦。
更一般地说,一致性(consistency)这个术语混合了两种不同的需求,而它们值得分开考虑:
- 及时性(timeliness)
及时性是指确保用户观察到系统的最新状态。前面看到,如果用户从陈旧的数据副本中读取,可能观察到不一致的系统状态(参见 “复制延迟的问题”)。不过,这种不一致只是暂时的,只需等待并重试,最终便会消失。
CAP 定理中的一致性指线性一致性,这是实现及时性的一种强保证。写后读一致性(read-after-write consistency)等较弱的及时性属性同样有用。
- 完整性(integrity)
完整性是指没有损坏:既不丢失数据,也没有相互矛盾或虚假的数据。尤其是,如果某个衍生数据集作为底层数据之上的视图来维护,衍生过程必须正确。例如,数据库索引必须准确反映数据库内容——漏掉某些记录的索引没什么用。
如果完整性遭到破坏,不一致就是永久的:大多数情况下,等待和重试无法修复数据库损坏,必须明确进行检查和修复。在 ACID 事务语境中,“一致性”通常被理解为某种应用特有的完整性概念。原子性与持久性是维护完整性的重要工具。
用一句口号来说:违反及时性叫“最终一致”,违反完整性则叫“永远不一致”。
在大多数应用中,完整性都比及时性重要得多。及时性遭到破坏会令人烦恼和困惑,完整性遭到破坏却可能带来灾难。
例如,信用卡账单上没有出现过去 24 小时内完成的一笔交易,并不会令人意外——这类系统存在一定延迟很正常。我们知道银行会异步对账和结算交易,因此这里的及时性并不重要 3。然而,如果账单余额不等于交易总额加上上期账单余额(求和出错),或者一笔交易向你扣了款、商户却没有收到钱(资金凭空消失),问题就非常严重。这些都是对系统完整性的破坏。
数据流系统的正确性
ACID 事务通常同时提供及时性保证(例如线性一致性)和完整性保证(例如原子提交)。因此,如果从 ACID 事务的角度看待应用正确性,及时性与完整性之间的区别便无关紧要。
另一方面,本章讨论的基于事件的数据流系统有一项有趣性质:它们把及时性与完整性解耦了。异步处理事件流时,除非明确构建消费者,让它等到消息到达后才返回,否则就没有及时性保证。例如,用户可以请求一笔付款,随后在流处理器执行该请求之前读取自己的账户状态;此时,用户看不到刚刚请求的付款。
然而,完整性事实上是流式系统的核心。恰好一次(exactly-once)或 等效一次(effectively-once)语义就是维护完整性的一种机制。事件丢失或生效两次,都可能破坏数据系统的完整性。因此,面对故障时,容错消息传递与重复抑制(例如幂等操作)是维护数据系统完整性的关键。
正如上一节所见,可靠的流处理系统无需分布式事务与原子提交协议也能保持完整性。这意味着它们有望实现同等程度的正确性,同时获得好得多的性能与运维稳健性。我们通过组合以下机制实现了这种完整性:
把写入操作的内容表示成一条消息,使其能够轻松原子写入——这种方式非常适合事件溯源
使用确定性衍生函数,从这一条消息衍生出所有其他状态更新,类似于存储过程
让客户端生成的请求 ID 贯穿所有处理层次,从而实现端到端重复抑制与幂等性
让消息不可变,并允许不时重新处理衍生数据,从而更容易从缺陷中恢复
宽松解释约束
如前所述,强制唯一性约束需要共识,通常通过让某个分片中的所有事件都汇入单个节点来实现。如果希望采用传统形式的唯一性约束,这项限制便无法避免,流处理也绕不过去。
不过还要意识到:在许多真实应用中,业务需求其实允许违反那些看似硬性约束的规则:
如果顾客订购的商品超过仓库库存,可以补订货物,为延误向顾客道歉,并提供折扣。其实,即便只是叉车碾坏了仓库里的部分商品,导致实际库存少于预期,你也必须这样处理 3。因此,为了应对叉车事故,道歉工作流本来就必须纳入业务流程;对库存数量设置硬约束或许没有必要。
同样,许多航空公司会超卖机票,因为预计有些乘客会误机;许多酒店也会超卖客房,因为预计有些客人会取消预订。在这些情形中,企业出于业务考虑故意违反“一座一人”的约束,并设置补偿流程(退款、升级、在附近酒店免费提供房间),处理需求超出供给的情况。即便没有超卖,也需要道歉与补偿流程,以应对恶劣天气或员工罢工造成的航班取消——从这类问题中恢复本来就是正常业务的一部分 3。
如果有人取出的金额超过账户余额,银行可以收取透支费,并要求对方偿还欠款。只要限制每日提款总额,银行承担的风险就有上限。
在跨组织集成数据的系统中,不一致不可避免,因此必须有修正机制来处理它们。正如 “批处理用例” 所指出的,银行之间的付款结算就是一个例子。
因此,在许多业务场景中,暂时违反约束、稍后再通过道歉修正,是可以接受的。这种用于纠正错误的变更称为 补偿性事务(compensating transaction)48、49。道歉的代价各不相同(金钱或声誉上的代价),却往往很低:已经发出的电子邮件无法撤回,但可以再发一封邮件更正;信用卡不慎扣款两次,可以退回其中一笔,代价只是手续费,或许再加上一项顾客投诉。ATM 一旦吐出现金,确实无法直接收回;但原则上,如果账户已经透支而顾客拒绝还款,可以派催收人员追回欠款。
道歉的代价能否接受,是一项业务决策。如果能够接受,那么“写入数据前先检查全部约束”的传统模型就限制过多。完全可以先乐观地执行写入,再事后检查约束。对于那些一旦出错便很难挽回的事情,仍可以确保在执行前完成验证;但这并不意味着,连数据写入之前也必须先做验证。
这些应用 确实 需要完整性:谁也不希望预订记录丢失,或因借贷不匹配而让资金凭空消失。但是,它们在强制约束时 并不需要 及时性:如果售出的商品超过仓库库存,事后道歉并补救即可。这与我们在 “处理写入冲突” 中讨论的冲突解决方法相似。
避免协调的数据系统
我们现在已经做了两个有趣的观察:
数据流系统无需原子提交、线性一致性或同步的跨分片协调,也能维护衍生数据的完整性保证。
尽管严格的唯一性约束需要及时性与协调,许多应用其实可以接受宽松约束:只要完整性始终得到维护,约束可以暂时遭到违反,稍后再修复。
把这两点结合起来就意味着:数据流系统无需协调,便可为许多应用提供数据管理服务,同时仍给出强有力的完整性保证。这种 避免协调(coordination-avoiding)的数据系统极具吸引力:与需要同步协调的系统相比,它们能获得更好的性能与容错能力 45。
例如,这类系统可以采用多主配置,分布在多个数据中心,并在区域之间异步复制。任何一个数据中心都能独立于其他数据中心继续运行,因为不需要跨区域同步协调。这样的系统只提供较弱的及时性保证——不引入协调就不可能实现线性一致性——却仍能提供强有力的完整性保证。
在这种情况下,可串行化事务作为维护衍生状态的一环仍然有用,不过可以把它限制在自己擅长的小范围内 6。不再需要 XA 等异构分布式事务。仍然可以在确有需要之处引入同步协调(例如在执行无法恢复的操作之前,强制实施严格约束);但如果应用中只有一小部分需要协调,就没必要让所有部分都付出协调成本 32。
也可以换个角度看协调与约束:它们减少了因不一致而道歉的次数,却也可能降低系统性能和可用性,从而增加因服务中断而道歉的次数。道歉次数不可能降到零,但可以根据自身需要寻找最佳平衡点——既不会出现太多不一致,也不会遇到太多可用性问题。
信任但验证
前面关于正确性、完整性与容错的所有讨论,都建立在一组假设之上:某些事情可能出错,另一些事情不会。我们把这些假设称为 系统模型(system model;参见 “系统模型与现实”)。例如,我们应当假设进程可能崩溃、机器可能突然断电、网络可能任意延迟或丢弃消息;但也可能假设,写入磁盘的数据经过 fsync 后不会丢失、内存中的数据不会损坏、CPU 的乘法指令总能返回正确结果。
这些假设相当合理,因为绝大多数时候它们都成立;如果必须时刻担心计算机会算错,我们将寸步难行。传统系统模型以二元方式看待故障:假设有些事情可能发生,另一些事情绝不可能发生。现实却更像是概率问题:有些事情更常见,有些事情较少见。真正的问题是,违反假设的情况是否频繁到我们会在实践中遇见。
我们已经看到,数据可能在内存中损坏(参见 “硬件与软件故障”),可能在磁盘上损坏(参见 “复制与持久性”),也可能在网络中损坏(参见 “弱形式的撒谎”)。或许我们应该更加重视这一点?当系统规模足够大,再小概率的事情也会发生。
面对软件缺陷时维护完整性
除了这类硬件问题,软件缺陷也始终是一项风险,而低层的网络、内存或文件系统校验和捕捉不到它们。即便广泛使用的数据库软件也存在缺陷:例如,过去某些版本的 MySQL 未能正确维护唯一性约束 50,PostgreSQL 的可串行化隔离级别过去也曾出现写偏差异常 51。MySQL 与 PostgreSQL 都是稳健且口碑良好的数据库,经过许多人多年的实战检验;不够成熟的软件,情况很可能糟得多。
尽管人们投入大量精力仔细设计、测试和审查,缺陷仍会悄然混入。它们虽然罕见,最终也会被发现和修复,却仍然存在一段可能损坏数据的窗口期。
至于应用代码,我们必须假设其中有更多缺陷,因为大多数应用接受的审查与测试,远远不及数据库代码。许多应用甚至没有正确使用数据库提供的完整性维护功能,例如外键或唯一性约束 25。
ACID 意义上的一致性,建立在这样一种想法之上:数据库从一致状态开始,事务再把它从一个一致状态转变为另一个一致状态。因此,我们期望数据库始终处于一致状态。然而,只有假设事务没有缺陷,这种说法才有意义。如果应用以某种错误方式使用数据库——例如不安全地采用弱隔离级别——数据库的完整性便无法保证。
不要盲信承诺
硬件和软件都不总能达到理想状态,因此数据损坏迟早似乎不可避免。至少,我们应该有办法发现数据已经损坏,从而修复它,并努力追查错误来源。检查数据完整性的过程称为 审计(auditing)。
正如 “不可变事件的优点” 所述,审计并不只适用于财务应用。不过,可审计性在金融领域格外重要,恰恰因为人人都知道错误难免发生,也都认可能够发现并修复问题的必要性。
成熟系统同样倾向于考虑小概率故障的可能性,并管理这种风险。例如,HDFS 和 Amazon S3 等大规模存储系统不会完全信任磁盘:它们运行后台进程,不断回读文件、与其他副本比较,并把文件从一个磁盘移动到另一个磁盘,以降低静默损坏的风险 52、53。
如果想确认数据仍然存在,就必须真正读取并检查。绝大多数时候数据依然完好;但万一不是,你肯定希望越早发现越好。同理,不时尝试从备份恢复也很重要——否则,你可能直到数据已经丢失、为时已晚,才发现备份根本无法使用。不要盲信一切都在正常工作。
HDFS 与 S3 仍然必须假设磁盘在绝大多数时候能够正确工作——这个假设很合理,却不同于假设磁盘 始终 正确工作。然而,目前采用这种“信任,但要验证”方式持续自我审计的系统并不多。许多系统假定正确性保证是绝对的,完全没有为罕见的数据损坏预作安排。未来,我们或许会看到更多 自我验证(self-validating)或 自我审计(self-auditing)系统:它们不断检查自身完整性,而不是依赖盲目信任 54。
为可审计性而设计
如果一个事务修改了数据库中的多个对象,事后很难看出这项事务究竟意味着什么。即便捕获了事务日志,各个表里的插入、更新与删除也未必能清楚说明,为什么 要执行这些修改。当初决定作出这些修改的应用逻辑调用转瞬即逝,无法重现。
相比之下,基于事件的系统可以提供更好的可审计性。在事件溯源方法中,系统的用户输入被表示为一条不可变事件,由此产生的所有状态更新都衍生自这条事件。衍生过程可以做到确定性与可重复性,因此,用同一版本的衍生代码处理同一份事件日志,便会得到相同的状态更新。
明确表示数据流,能让 数据溯源(data provenance)清晰得多,从而使完整性检查更切实可行。对于事件日志,可以用哈希检查事件存储是否遭到损坏;对于任何衍生状态,可以重新运行当初从事件日志衍生它的批处理器与流处理器,检查是否得到同样结果,甚至还可以并行运行一条冗余的衍生流程。
具有确定性且定义明确的数据流,也让系统执行过程更容易调试和追踪,从而查明系统 为什么 做了某件事 4、55。如果发生意外,能够重现导致意外事件的确切情境将极有价值——这是一种时间旅行式调试能力。
再谈端到端原则
如果无法完全相信系统中的每个组件都不会造成损坏——每一件硬件都不出故障,每一段软件都没有缺陷——那么至少必须定期检查数据完整性。如果不检查,往往要等损坏造成下游影响、为时已晚时才会发现;那时追查问题将困难得多,代价也高得多。
检查数据系统完整性,最好采用端到端方式:完整性检查涵盖的系统越多,处理流程某个阶段的损坏就越不容易逃过检查。如果能够检查整条衍生数据管道端到端的正确性,那么路径上的所有磁盘、网络、服务与算法,也都隐含在检查范围之内。
持续进行端到端完整性检查,会增强你对系统正确性的信心,从而让你行动得更快 56。审计与自动化测试一样,提高了迅速发现缺陷的概率,因而降低系统变更或采用新存储技术造成损害的风险。如果不再害怕作出改变,就能更好地推动应用演化,以满足不断变化的需求。
可审计数据系统的工具
目前,很少有数据系统把可审计性当作首要目标。一些应用会实现自己的审计机制,例如把所有变更记录到独立的审计表;然而,要保证审计日志与数据库状态的完整性仍然很难。可以借助硬件安全模块定期签名,让事务日志不可篡改,但这并不能保证一开始进入日志的就是正确事务。
Bitcoin 或 Ethereum 等区块链,是带有密码学一致性检查的共享仅追加日志;其中存储的交易是事件,智能合约基本上就是流处理器。它们使用的共识协议确保所有节点对同一事件序列达成一致。与 第 10 章 的共识协议不同,区块链具有拜占庭容错能力:即便某些参与节点的数据已经损坏,系统仍能继续工作,因为各个副本会不断互相检查完整性。
对于大多数应用,区块链的开销太高,并不实用。不过,其中一些密码学工具也能用于更轻量的环境。例如,默克尔树 57 是由哈希构成的树,可以高效证明某条记录出现在某个数据集中(也能证明其他一些事情)。证书透明性 使用经过密码学验证的仅追加日志与默克尔树,检查 TLS/SSL 证书的有效性 58、59;它让每条日志由单个领导者负责,从而无需共识协议。
未来,证书透明性与分布式账本所采用的完整性检查和审计算法,或许会在一般数据系统中得到更广泛的应用。要让它们拥有与不带密码学审计的系统相同的可伸缩性,并把性能损失尽可能压低,还需要投入一些工作;但这些技术仍然值得关注。
本章小结
本章以流处理理念为基础,讨论了设计数据系统的新方法。我们从一个观察出发:没有任何一种工具能够高效服务所有可能的用例,因此应用必然需要组合多种不同的软件来实现目标。我们讨论了如何利用批处理与事件流,让数据变更在不同系统之间流动,从而解决这一 数据集成 问题。
在这种方法中,某些系统被指定为权威记录系统,其他数据则通过转换衍生自它们。这样,我们就能维护索引、物化视图、机器学习模型、统计摘要等。衍生与转换过程保持异步和松散耦合,可以防止一处的问题扩散到系统中无关的部分,从而增强整个系统的稳健性与容错能力。
把数据流表示为从一个数据集到另一个数据集的转换,也有助于应用演化:如果要修改某个处理步骤——例如改变索引或缓存的结构——只需让新的转换代码重新处理整个输入数据集,再次衍生出输出。同样,如果出现问题,也可以修复代码并重新处理数据来恢复。
这些过程与数据库内部既有的工作十分相似,因此,我们把数据流应用重新表述为对数据库组件的 分拆,并通过组合这些松散耦合的组件来构建应用。
观察底层数据的变更,就能更新衍生状态;下游消费者还可以继续观察衍生状态本身。我们甚至可以让这种数据流一路抵达显示数据的最终用户设备,从而构建能够动态更新、反映数据变化,并且离线时仍可工作的用户界面。
接下来,我们讨论了如何保证所有这些处理在发生故障时仍然正确。通过异步处理事件、使用端到端请求标识符使操作幂等,并异步检查约束,就能以可伸缩的方式实现强完整性保证。客户端可以等待检查通过,也可以不等待便继续执行,但要承担约束遭到违反、事后必须道歉的风险。这种方法比使用分布式事务的传统方法更可伸缩、更稳健,也更符合许多业务流程的实际运作方式。
围绕数据流构建应用并异步检查约束,可以避免大部分协调,创建既能维护完整性、又有良好性能的系统,即使处于地理分布式环境或发生故障也不例外。最后,我们简要讨论了如何通过审计验证数据完整性、发现损坏,并指出区块链所用的技术也与事件驱动系统颇为相似。
脚注
参考文献
Rachid Belaid. Postgres Full-Text Search is Good Enough! rachbelaid.com, July 2015. Archived at perma.cc/ZVP9-YDCB ↩︎ ↩︎
Philippe Ajoux, Nathan Bronson, Sanjeev Kumar, Wyatt Lloyd, and Kaushik Veeraraghavan. Challenges to Adopting Stronger Consistency at Scale. At 15th USENIX Workshop on Hot Topics in Operating Systems (HotOS), May 2015. ↩︎ ↩︎
Pat Helland and Dave Campbell. Building on Quicksand. At 4th Biennial Conference on Innovative Data Systems Research (CIDR), January 2009. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Jessica Kerr. Provenance and Causality in Distributed Systems. jessitron.com, September 2016. Archived at perma.cc/DTD2-F8ZM ↩︎ ↩︎ ↩︎
Jay Kreps. The Log: What Every Software Engineer Should Know About Real-Time Data’s Unifying Abstraction. engineering.linkedin.com, December 2013. Archived at perma.cc/2JHR-FR64 ↩︎ ↩︎ ↩︎ ↩︎
Pat Helland. Life Beyond Distributed Transactions: An Apostate’s Opinion. At 3rd Biennial Conference on Innovative Data Systems Research (CIDR), January 2007. ↩︎ ↩︎
Lionel A. Smith. The Broad Gauge Story. Journal of the Monmouthshire Railway Society, Summer 1985. Archived at perma.cc/DDK9-JA6X ↩︎
Jacqueline Xu. Online Migrations at Scale. stripe.com, February 2017. Archived at perma.cc/ZQY2-EAU2 ↩︎
Flavio Santos and Robert Stephenson. Changing the Wheels on a Moving Bus — Spotify’s Event Delivery Migration. engineering.atspotify.com, October 2021. Archived at perma.cc/5C4V-G8EV ↩︎
Molly Bartlett Dishman and Martin Fowler. Agile Architecture. At O’Reilly Software Architecture Conference, March 2015. ↩︎
Nathan Marz and James Warren. Big Data: Principles and Best Practices of Scalable Real-Time Data Systems. Manning, 2015. ISBN: 978-1-617-29034-3 ↩︎
Jay Kreps. Questioning the Lambda Architecture. oreilly.com, July 2014. Archived at perma.cc/PGH6-XUCH ↩︎ ↩︎
Raul Castro Fernandez, Peter Pietzuch, Jay Kreps, Neha Narkhede, Jun Rao, Joel Koshy, Dong Lin, Chris Riccomini, and Guozhang Wang. Liquid: Unifying Nearline and Offline Big Data Integration. At 7th Biennial Conference on Innovative Data Systems Research (CIDR), January 2015. ↩︎
Dennis M. Ritchie and Ken Thompson. The UNIX Time-Sharing System. Communications of the ACM, volume 17, issue 7, pages 365–375, July 1974. doi:10.1145/361011.361061 ↩︎ ↩︎
Wes McKinney. The Road to Composable Data Systems: Thoughts on the Last 15 Years and the Future. wesmckinney.com, September 2023. Archived at perma.cc/J9SJ-886N ↩︎
Eric A. Brewer and Joseph M. Hellerstein. CS262a: Advanced Topics in Computer Systems. Lecture notes, University of California, Berkeley, cs.berkeley.edu, August 2011. Archived at perma.cc/TE79-LGWU ↩︎
Michael Stonebraker. The Case for Polystores. wp.sigmod.org, July 2015. Archived at perma.cc/G7J2-KR45 ↩︎ ↩︎
Jennie Duggan, Aaron J. Elmore, Michael Stonebraker, Magda Balazinska, Bill Howe, Jeremy Kepner, Sam Madden, David Maier, Tim Mattson, and Stan Zdonik. The BigDAWG Polystore System. ACM SIGMOD Record, volume 44, issue 2, pages 11–16, June 2015. doi:10.1145/2814710.2814713 ↩︎
David B. Lomet, Alan Fekete, Gerhard Weikum, and Mike Zwilling. Unbundling Transaction Services in the Cloud. At 4th Biennial Conference on Innovative Data Systems Research (CIDR), January 2009. ↩︎
Martin Kleppmann and Jay Kreps. Kafka, Samza and the Unix Philosophy of Distributed Data. IEEE Data Engineering Bulletin, volume 38, issue 4, pages 4–14, December 2015. ↩︎
John Hugg. Winning Now and in the Future: Where Volt Active Data Shines. voltactivedata.com, March 2016. Archived at perma.cc/44MP-3MWM ↩︎
Felienne Hermans. Spreadsheets Are Code. At Code Mesh, November 2015. ↩︎
Dan Bricklin and Bob Frankston. VisiCalc: Information from Its Creators. danbricklin.com. Archived at archive.org ↩︎
D. Sculley, Gary Holt, Daniel Golovin, Eugene Davydov, Todd Phillips, Dietmar Ebner, Vinay Chaudhary, and Michael Young. Machine Learning: The High-Interest Credit Card of Technical Debt. At NIPS Workshop on Software Engineering for Machine Learning (SE4ML), December 2014. Archived at https://perma.cc/M3MD-U7WL ↩︎
Peter Bailis, Alan Fekete, Michael J. Franklin, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. Feral Concurrency Control: An Empirical Investigation of Modern Application Integrity. At ACM International Conference on Management of Data (SIGMOD), June 2015. doi:10.1145/2723372.2737784 ↩︎ ↩︎
Guy Steele. Re: Need for Macros (Was Re: Icon). email to ll1-discuss mailing list, people.csail.mit.edu, December 2001. Archived at perma.cc/K9X8-CJ65 ↩︎
Ben Stopford. Microservices in a Streaming World. At QCon London, March 2016. ↩︎ ↩︎
Adam Bellemare. Building Event-Driven Microservices, 2nd Edition. O’Reilly Media, 2025. ↩︎
Christian Posta. Why Microservices Should Be Event Driven: Autonomy vs Authority. blog.christianposta.com, May 2016. Archived at perma.cc/E6N9-3X92 ↩︎
Alex Feyerke. Designing Offline-First Web Apps. alistapart.com, December 2013. Archived at perma.cc/WH7R-S2DS ↩︎
Martin Kleppmann. Turning the Database Inside-out with Apache Samza. at Strange Loop, September 2014. Archived at perma.cc/U6E8-A9MT ↩︎ ↩︎
Sebastian Burckhardt, Daan Leijen, Jonathan Protzenko, and Manuel Fähndrich. Global Sequence Protocol: A Robust Abstraction for Replicated Shared State. At 29th European Conference on Object-Oriented Programming (ECOOP), July 2015. doi:10.4230/LIPIcs.ECOOP.2015.568 ↩︎ ↩︎
Evan Czaplicki and Stephen Chong. Asynchronous Functional Reactive Programming for GUIs. At 34th ACM SIGPLAN Conference on Programming Language Design and Implementation (PLDI), June 2013. doi:10.1145/2491956.2462161 ↩︎
Eno Thereska, Damian Guy, Michael Noll, and Neha Narkhede. Unifying Stream Processing and Interactive Queries in Apache Kafka. confluent.io, October 2016. Archived at perma.cc/W8JG-EAZF ↩︎
Frank McSherry. Dataflow as Database. github.com, July 2016. Archived at perma.cc/384D-DUFH ↩︎
Peter Alvaro. I See What You Mean. At Strange Loop, September 2015. ↩︎
Nathan Marz. Trident: A High-Level Abstraction for Realtime Computation. blog.x.com, August 2012. Archived at archive.org ↩︎
Edi Bice. Low Latency Web Scale Fraud Prevention with Apache Samza, Kafka and Friends. At Merchant Risk Council MRC Vegas Conference, March 2016. Archived at perma.cc/T3H5-QN3R ↩︎
Charity Majors. The Accidental DBA. charity.wtf, October 2016. Archived at perma.cc/6ANP-ARB6 ↩︎
Arthur J. Bernstein, Philip M. Lewis, and Shiyong Lu. Semantic Conditions for Correctness at Different Isolation Levels. At 16th International Conference on Data Engineering (ICDE), February 2000. doi:10.1109/ICDE.2000.839387 ↩︎
Sudhir Jorwekar, Alan Fekete, Krithi Ramamritham, and S. Sudarshan. Automating the Detection of Snapshot Isolation Anomalies. At 33rd International Conference on Very Large Data Bases (VLDB), September 2007. ↩︎
Kyle Kingsbury. Jespen: Distributed Systems Safety Research. jepsen.io. ↩︎
Michael Jouravlev. Redirect After Post. theserverside.com, August 2004. Archived at archive.org ↩︎
Jerome H. Saltzer, David P. Reed, and David D. Clark. End-to-End Arguments in System Design. ACM Transactions on Computer Systems, volume 2, issue 4, pages 277–288, November 1984. doi:10.1145/357401.357402 ↩︎ ↩︎
Peter Bailis, Alan Fekete, Michael J. Franklin, Ali Ghodsi, Joseph M. Hellerstein, and Ion Stoica. Coordination Avoidance in Database Systems. Proceedings of the VLDB Endowment, volume 8, issue 3, pages 185–196, November 2014. doi:10.14778/2735508.2735509 ↩︎ ↩︎
Alex Yarmula. Strong Consistency in Manhattan. blog.x.com, March 2016. Archived at archive.org ↩︎
Martin Kleppmann, Alastair R. Beresford, and Boerge Svingen. Online Event Processing: Achieving consistency where distributed transactions have failed. Communications of the ACM, volume 62, issue 5, pages 43-49, May 2019. doi:10.1145/3312527 ↩︎
Jim Gray. The Transaction Concept: Virtues and Limitations. At 7th International Conference on Very Large Data Bases (VLDB), September 1981. Archived at perma.cc/8VPT-N5H6 ↩︎
Hector Garcia-Molina and Kenneth Salem. Sagas. At ACM International Conference on Management of Data (SIGMOD), May 1987. doi:10.1145/38713.38742 ↩︎
Annamalai Gurusami and Daniel Price. Bug #73170: Duplicates in Unique Secondary Index Because of Fix of Bug#68021. bugs.mysql.com, July 2014. Archived at perma.cc/P6BV-W7JJ ↩︎
Gary Fredericks. Postgres Serializability Bug. github.com, September 2015. Archived at perma.cc/N8UP-2822 ↩︎
Xiao Chen. HDFS DataNode Scanners and Disk Checker Explained. blog.cloudera.com, December 2016. Archived at perma.cc/6S36-X98L ↩︎
Daniel Persson. How does Ceph scrubbing work? youtube.com, March 2022. ↩︎
Jay Kreps. Getting Real About Distributed System Reliability. blog.empathybox.com, March 2012. Archived at perma.cc/9B5Q-AEBW ↩︎
Martin Fowler. The LMAX Architecture. martinfowler.com, July 2011. Archived at perma.cc/5AV4-N6RJ ↩︎
Sam Stokes. Move Fast with Confidence. five-eights.com, July 2016. Archived at perma.cc/J8C6-DHXB ↩︎
Ralph C. Merkle. A Digital Signature Based on a Conventional Encryption Function. At CRYPTO ‘87, August 1987. doi:10.1007/3-540-48184-2_32 ↩︎
Ben Laurie. Certificate Transparency. ACM Queue, volume 12, issue 8, pages 10-19, August 2014. doi:10.1145/2668152.2668154 ↩︎
Mark D. Ryan. Enhanced Certificate Transparency and End-to-End Encrypted Mail. At Network and Distributed System Security Symposium (NDSS), February 2014. doi:10.14722/ndss.2014.23379 ↩︎
14 做正确的事情
拿世间的美好、丑陋与残酷喂养 AI 系统,却幻想它只会映照美好。
Vinay Uday Prabhu、Abeba Birhane,大规模数据集:计算机视觉的一场皮洛士式胜利?(2020)
在本书的最后一章,让我们退后一步。全书至此,我们考察了形形色色的数据系统架构,权衡了它们的利弊,也探讨了构建可靠、可伸缩、可维护应用的技术。然而,我们一直略过了讨论中一个重要而根本的部分,现在该把它补上了。
每个系统都是为某种目的而建;我们采取的每个行动,都会产生预期和非预期的后果。目的也许只是赚钱,但对世界造成的影响可能远远超出最初的目的。身为构建这些系统的工程师,我们有责任仔细思考这些后果,并有意识地选择自己希望生活在怎样的世界中。
我们常把数据当作抽象事物来谈论,但请记住,许多数据集记录的是人:他们的行为、兴趣与身份。我们必须怀着人性与尊重对待这类数据。用户也是人,人的尊严至高无上 1。
软件开发越来越多地涉及重大的伦理抉择。ACM《伦理与职业行为准则》等指南可以帮助软件工程师处理这些问题 2;然而在实践中,它们很少得到讨论、应用和落实。因此,工程师和产品经理有时会轻率地对待隐私,以及产品可能造成的负面后果 3、4。
技术本身并无善恶,关键在于如何使用它,以及它会给人带来什么影响。搜索引擎这样的软件系统如此,枪支这样的武器也一样。软件工程师不能只关注技术而无视其后果;伦理责任同样要由我们承担。伦理思考并不容易,却重要得不容回避。
可是,什么算“好”、什么算“坏”,并没有明确的定义;计算领域的大多数人甚至不讨论这个问题 5。不同于计算领域的许多概念,伦理学的核心概念没有固定、确定的精确含义,而是需要解释,并且这种解释可能带有主观性 6。伦理不是照着清单逐项打勾,确认自己已经合规;它是一个参与式、迭代式的反思过程,需要与相关各方对话,并对结果负责 7。
预测分析
例如,预测分析(predictive analytics)正是人们热衷于大数据和 AI 的主要原因之一。用数据分析预测天气或疾病传播是一回事 8;预测一名已定罪者是否可能再犯、贷款申请人是否可能违约,或保险客户是否可能提出高额索赔,则是另一回事 9。后一类预测会直接影响个人的生活。
支付网络当然希望阻止欺诈交易,银行希望避免不良贷款,航空公司希望避免劫机,企业也希望避免雇到能力不足或不可信赖的人。从它们的角度看,错失商机的代价不大,不良贷款或问题员工造成的损失却高得多,因此组织自然希望谨慎行事。拿不准时,拒绝总比答应稳妥。
然而,随着算法决策越来越普遍,被某种算法标为高风险的人——无论判断正确与否——可能接连遭到这样的拒绝。一个人若被系统性地排除在就业、航空出行、保险、房屋租赁、金融服务以及社会生活的其他关键领域之外,其自由会受到极大限制,以至于这种处境被称为“算法监狱(algorithmic prison)”10。在尊重人权的国家,刑事司法制度坚持无罪推定;自动化系统却可能在没有任何罪证、几乎无从申诉的情况下,系统性地、任意地剥夺一个人参与社会的机会。
偏见与歧视
算法作出的决定不一定比人类更好,也不一定更差。每个人都可能心存偏见,即便主动设法克服也不例外;歧视性做法还可能沉淀为文化与制度。人们寄希望于以数据而非人的主观判断与直觉为依据,从而作出更公平的决定,也给传统制度中经常被忽视的人更多机会 11。
开发预测分析和 AI 系统时,我们不只是用软件规定何时同意、何时拒绝,把人的决策自动化;甚至连规则本身也交给系统从数据中推断。然而,这些系统学到的模式并不透明:即使数据中确实存在某种相关性,我们也未必知道原因。如果算法的输入带有系统性偏见,系统很可能会学到这种偏见,并在输出中将其放大 12。
许多国家的 反歧视法(anti-discrimination law)禁止根据族裔、年龄、性别、性取向、残障或信仰等 受保护特征(protected characteristic)区别对待他人。个人数据中的其他特征或许可以分析,但如果它们与受保护特征相关,又该怎么办?例如,在种族隔离的社区中,一个人的邮政编码,甚至 IP 地址,都可以有力地预测其种族。如此看来,相信算法能够以带有偏见的数据为输入,却产出公平公正的结果,实在荒谬 13、14。然而,数据驱动决策的支持者似乎经常默认这种信念;有人讽刺这种态度说,“机器学习就像为偏见洗钱” 15。
预测分析系统不过是在外推过去;如果过去充满歧视,它们就会固化并放大这种歧视 16。要让未来比过去更好,需要道德想象力,而这只有人类才能提供 17。数据与模型应该是我们的工具,而不是我们的主人。
责任与问责
自动化决策引出了 责任(responsibility)与 问责(accountability)问题 17。如果人犯了错,可以追究其责任,受决定影响的人也可以申诉。算法同样会犯错,但出了问题,谁来负责 18?自动驾驶汽车造成事故,责任由谁承担?自动信用评分算法若系统性地歧视某一种族或宗教的人,他们有没有救济途径?如果机器学习系统作出的决定受到司法审查,你能否向法官解释算法是怎样得出这一决定的?任何人都不应把责任推给算法,借此逃避问责。
信用评级机构是收集个人数据并据此作出决定的一个早期例子。糟糕的信用评分会给生活带来困难,但至少信用分通常基于当事人实际借贷历史中的相关事实,记录有误时也能更正——尽管评级机构一般不会让更正变得容易。相比之下,基于机器学习的评分算法通常使用范围广得多的输入数据,而且更加不透明,因而很难看清某项决定是如何得出的,也很难判断某个人是否受到了不公平或歧视性对待 19。
信用分概括的是“你过去表现如何?”,预测分析通常依据的却是“谁与你相似,以及与你相似的人过去表现如何?”。拿他人的行为来类比一个人,实际上就是在制造刻板印象,例如根据居住地——它往往是种族和社会经济阶层的近似指标——给人归类。那些被分错类别的人怎么办?而且,如果错误数据导致了错误决定,当事人几乎无从寻求救济 17。
许多数据本质上都是统计性的。这意味着,即使总体概率分布正确,落到个案上也很可能出错。例如,假如你所在国家的平均预期寿命是 80 岁,并不意味着你会在 80 岁生日当天去世。仅凭平均值和概率分布,很难判断某一个人究竟能活到多大年纪。同样,预测系统给出的是概率性结果,放到具体个案上完全可能出错。
盲目相信数据在决策中至高无上,不仅是一种妄想,而且非常危险。随着数据驱动决策日益普及,我们需要弄清楚如何让算法透明并接受问责,如何避免强化既有偏见,以及如何在算法不可避免地犯错时加以纠正。
我们还要弄清楚如何防止数据被用来伤害人,并让它发挥积极作用。例如,数据分析可以揭示人们生活中的财务与社会特征。一方面,这种能力可用于集中援助与支持,帮助最需要帮助的人;另一方面,掠夺性企业有时也会用它识别弱势群体,再向他们兜售高息贷款和毫无价值的大学文凭等高风险产品 17、20。
反馈循环
即便是推荐系统这类对人们生活的影响没有那么直接、深远的预测应用,也有一些难题必须正视。当服务越来越善于预测用户想看什么时,最终可能只向人们展示他们已经认同的观点,形成滋生刻板印象、错误信息与社会极化的回音室。我们已经看到了社交媒体回音室对竞选活动的影响。
当预测分析开始左右人们的生活时,自我强化的 反馈循环(feedback loop)会造成尤其恶劣的问题。例如,假设雇主用信用分评估求职者。你原本工作能力很强,信用记录也很好,却因一场自己无力控制的变故突然陷入财务困境。几次账单逾期之后,信用分随之下降,找到工作的机会也越来越少。失业又把你推向贫困,进一步拉低评分,让工作变得更加难找 17。这是有毒假设造成的恶性循环,却披着数学严谨性与数据客观性的外衣。
另一个反馈循环的例子是:经济学家发现,德国的加油站引入算法定价后,市场竞争反而减弱,消费者支付的价格随之上涨,因为算法学会了合谋 21。
我们无法总是预见这种反馈循环何时出现。不过,只要思考整个系统——不仅包括计算机化的部分,也包括与之互动的人——许多后果仍然可以预判。这种方法称为 系统思维(systems thinking)22。我们可以尝试理解,数据分析系统会如何响应不同的行为、结构或特征。它会巩固并放大人与人之间既有的差异,例如让富者愈富、贫者愈贫,还是会努力消除不公?而且,即使怀有最好的初衷,也必须提防意料之外的后果。
隐私与追踪
预测分析用数据自动作出关于人的决定,随之带来种种问题;除此之外,收集数据本身也存在伦理问题。收集数据的组织与数据被收集的人之间,究竟是什么关系?
如果系统只存储用户明确输入的数据,是因为用户希望它以某种方式存储和处理这些数据,那么系统就是在为用户提供服务:用户是客户。然而,如果系统只是在用户做其他事情时,顺带追踪并记录其活动,双方的关系就没有那么清楚了。服务不再只是照用户的吩咐行事,而是有了自己的利益,并且这种利益可能与用户的利益冲突。
对于许多在线服务面向用户的功能,追踪行为数据已经越来越重要:追踪用户点击了哪些搜索结果,有助于改进结果排名;推荐“喜欢 X 的人也喜欢 Y”,能帮助用户发现有趣而有用的事物;A/B 测试和用户流程分析,则能帮助判断如何改进用户界面。这些功能需要在一定程度上追踪用户行为,而用户也能从中受益。
然而,根据公司的商业模式,追踪往往不会止步于此。如果一项服务靠广告维持,广告主才是真正的客户,用户的利益便退居其次。追踪的数据越来越细,分析触及的范围越来越广,数据也会长期保留,以便为营销目的建立每个人的详细画像。
此时,公司与被收集数据的用户之间,便呈现出一种截然不同的关系。用户得到免费服务,又被诱导尽量多地参与其中;追踪用户主要不是为了服务这个人,而是为了满足出资维持服务的广告主的需求。用一个含义更阴暗的词来描述这种关系再合适不过:监视(surveillance)。
监视
让我们做一个思想实验:把 数据 一词换成 监视,再看看那些常见说法听起来是否依然悦耳 23。例如:“在我们这个监视驱动的组织中,我们收集实时监视流,并把它们存入监视仓库。我们的监视科学家运用高级分析和监视处理来获得新的洞见。”
对于《设计监视密集型应用》这本书而言,这个思想实验显得格外尖锐,甚至带有本书少见的论战色彩;但要强调这一点,就需要这样的措辞。在试图让软件“吞噬世界”的过程中 24,我们建成了人类有史以来规模最大的群体监视基础设施。我们正在迅速走近这样一个世界:每处有人居住的空间里,都至少有一个连接互联网的麦克风——智能手机、智能电视、声控助理设备、婴儿监视器,甚至使用云端语音识别的儿童玩具。许多这类设备的安全记录糟糕透顶 25。
与过去相比,新的变化在于数字化使大规模收集个人数据变得轻而易举。我们的位置与行踪、社会关系与通信、购物与支付以及健康状况,几乎都无法摆脱监视。实施监视的组织最终可能比当事人自己更了解这个人——例如,在当事人尚未察觉时,就发现其疾病或经济问题。
即使是过去最极权、最压迫的政权,也只能梦想在每个房间里装上麦克风,强迫每个人时刻携带能够追踪位置和行踪的设备。数字技术带来的好处如此之大,以至于今天的我们竟自愿接受了这个全面监视的世界。区别只在于,数据是由企业收集来为我们提供服务,而不是由试图控制我们的政府机构收集 26。
并非所有数据收集都一定称得上监视,但从监视的角度审视它,有助于理解我们与数据收集者的关系。为什么人们似乎乐于接受企业的监视?也许你觉得自己没什么可隐瞒——换句话说,你完全顺应现有的权力结构,不属于边缘化的少数群体,也不必担心遭受迫害 27。但并非人人都有这样的幸运。又或许是因为目的看起来无害:不是公然胁迫、逼人服从,只是提供更好的推荐与更个性化的营销。然而,结合上一节对预测分析的讨论,这两者之间的界线就没有那么清楚了。
我们已经看到,汽车在未经驾驶者同意的情况下追踪驾驶行为,而这些数据又会影响汽车保险费率 28;健康保险的承保条件也可能取决于人们是否佩戴健身追踪设备。当监视被用来决定保险、就业等关系人生的重要事项时,它就不再显得无害。此外,数据分析还能揭示出乎意料的私密信息:例如,智能手表或健身追踪器中的运动传感器,可以相当准确地推断你正在输入什么,甚至包括密码 29。传感器会越来越精确,分析算法也只会越来越强。
同意与选择自由
我们或许会说,用户自愿选择使用追踪其活动的服务,也接受了服务条款与隐私政策,因此已经 同意(consent)收集数据。我们甚至可以声称,用户用自己提供的数据换取了有价值的服务,而追踪是提供服务所必需的。毫无疑问,社交网络、搜索引擎以及其他各种免费在线服务的确对用户很有价值——但这种说法存在问题。
首先应该问清楚,追踪究竟在哪种意义上不可或缺。有些追踪的确直接用于改进面向用户的功能:例如,追踪搜索结果的点击率,可以提升搜索引擎的结果排名与相关性;追踪顾客经常一起购买的商品,可以帮助网店推荐相关产品。然而,如果追踪用户交互是为了推荐内容,或是为广告建立用户画像,就很难说这是否真正符合用户的利益——还是因为广告在为服务买单,追踪才变得“必要”?
其次,用户几乎不知道自己把哪些数据送进了我们的数据库,也不知道这些数据会如何保存和处理;大多数隐私政策更善于遮掩,而不是说明真相。如果不了解自己的数据将被如何处置,用户便不可能作出有意义的同意。一个用户的数据往往还会透露其他人的信息,而这些人既不是服务的用户,也没有接受任何条款。我们在本书这一部分讨论的衍生数据集,可能把整个用户群的数据与行为追踪数据、外部数据源组合起来;这恰恰是用户不可能真正理解的数据。
而且,从用户身上抽取数据是一个单向过程,既不是真正互惠的关系,也不是公平的价值交换。双方没有对话,用户也不能就提供多少数据、换取什么服务进行协商:服务与用户之间的关系高度不对称,完全是一边倒的。条件由服务制定,而不是由用户决定 30、31。
欧盟《通用数据保护条例》(GDPR)要求,同意必须是“自愿作出、具体、知情且明确无误的”;用户还必须能够“拒绝或撤回同意而不受不利影响”,否则就不能算“自愿作出”。任何征求同意的请求,都必须“采用易于理解、便于获取的形式,并使用清晰明白的语言”。此外,“沉默、预先勾选的选框或无行动均不构成同意” 32。同意并不是合法处理个人数据的唯一依据;例如,合法利益(legitimate interest)也允许出于防范欺诈等目的使用某些数据 33。
你也许会说,不愿接受监视的用户只要选择不使用这项服务即可。但这种选择同样算不上自由:如果一项服务普及到“被大多数人视为参与基本社会生活所必需” 30,就不能合理地要求人们退出这项服务——使用它实际上已成为强制要求。例如,在多数西方社会中,随身携带智能手机、通过社交网络与人交往、使用 Google 查找信息,都已经成为常态。尤其是在一项服务具有网络效应时,选择 不 使用它需要付出社会代价。
因为追踪政策而拒绝使用一项服务,说来容易,做到却很难。这些平台就是专门为吸引用户而设计的;许多平台还采用游戏机制和赌博中常见的手法,让用户不断回来 34。即使用户能够摆脱这些诱导,拒绝参与也只是少数特权者才有的选择:他们既有时间和知识去理解隐私政策,也承担得起可能错失社会交往或职业机会的代价。对于处境不那么优越的人,并不存在真正的选择自由,监视变得无从逃避。
隐私与数据使用
有时人们声称“隐私已死”,理由是一些用户愿意把生活中的种种事情发布到社交媒体上,其中有日常琐事,也有极其私密的内容。然而,这种说法是错误的,源于对 隐私(privacy)一词的误解。
拥有隐私并不意味着把一切都藏起来,而是有权自由选择向谁透露什么、公开什么、保密什么。隐私权是一种决定权:在每一种情境中,它都让每个人自行决定,要站在从保密到透明这条光谱的什么位置 30。这是个人自由与自主的重要组成部分。
例如,罹患罕见病的人也许非常乐意把自己的私密医疗数据交给研究人员,只要这些数据有望帮助开发治疗方法。关键在于,这个人可以选择谁能访问数据,以及数据用于什么目的。如果病情信息可能妨碍他们获得医疗保险、就业机会或其他重要权益,他们大概会谨慎得多。
通过监视基础设施从人们身上抽取数据时,隐私权未必遭到削弱,而是转移到了数据收集者手中。获取数据的公司实际上是在说:“相信我们会妥善使用你的数据。”这意味着,决定透露什么、保密什么的权利,从个人手中转到了公司手中。
这些公司反过来又会将大部分监视结果秘而不宣,因为公开真相会令人毛骨悚然,也会损害它们的商业模式——这种模式依靠比其他公司更了解人来获利。用户的私密信息只会间接显露出来,例如以广告定向工具的形式,供广告主锁定某类特定人群,比如患有某种疾病的人。
即使无法从某条广告所针对的人群中重新识别出某个用户,他们也已经失去了决定是否披露某些私密信息的自主权。不再是用户根据个人意愿决定向谁透露什么,而是由公司行使这项隐私权,目标则是让利润最大化。
许多公司追求的,只是不要让人 觉得 它们令人不安。它们避而不谈数据收集究竟有多么侵犯隐私,只顾管理用户的观感。可就连观感也常常管理得一团糟:例如,某件事在事实上也许没有错,但如果会唤起痛苦的回忆,用户可能根本不愿再次看到它 35。对任何数据,我们都应该预料它可能是错的、不可取的,或者在某些情境下并不合时宜,并为处理这些问题建立机制。何谓“不可取”或“不合时宜”,当然要靠人来判断;除非我们明确要求算法尊重人的需要,否则算法根本不懂这些概念。身为这些系统的工程师,我们必须保持谦逊,承认这类问题可能发生,并预先做好准备。
在线服务的隐私设置允许用户控制自己的哪些数据可以被其他用户看见。这只是把部分控制权交还给用户的起点。无论用户如何设置,服务本身仍能不受限制地访问数据,并可按照隐私政策的许可任意使用。即使服务承诺不把数据卖给第三方,通常也会赋予自己不受限制的权利,在内部处理和分析数据,而这些处理往往远远超出用户能够直接看到的范围。
如此大规模地把隐私权从个人转移给企业,在历史上前所未有 30。监视从来都有,但过去代价高昂、依赖人工,既不能自动化,也无法大规模扩展。信任关系也一直存在,例如病人与医生、被告与律师之间的关系;但在这些情形下,数据的使用受到严格的伦理、法律与监管约束。互联网服务却让人们可以在未经有效同意的情况下积累海量敏感信息,又在用户不了解私密数据去向的情况下,大规模加以利用。
数据资产与权力
行为数据是用户与服务交互的副产品,因此有时被称为“数据废气”(data exhaust),仿佛这些数据只是毫无价值的废料。从这个角度看,行为分析和预测分析就像一种回收利用,从本来会被丢弃的数据中提取价值。
更准确的看法也许恰好相反:从经济角度看,如果定向广告为服务提供收入,那么产生行为数据的用户活动就可以视为一种劳动 36。甚至还可以说,用户与之交互的应用,不过是引诱用户不断把更多个人信息送入监视基础设施的手段 30。在线服务所承载的可贵的人类创造力与社会关系,就这样被数据抽取机器无情地利用。
个人数据是宝贵的资产,数据经纪商的存在就是明证。这是一个行事隐秘、见不得光的行业:它购买、汇总、分析和推断极具侵扰性的个人数据,再将其转售,主要用于营销 20。初创公司的估值往往取决于用户数和“眼球”数量——也就是它们的监视能力。
数据既然有价值,自然有很多人想得到它。公司当然想要——这正是它们收集数据的原因。政府也想拿到这些数据:通过秘密交易、胁迫、法律强制,或者干脆窃取 37。一家公司破产时,收集的个人数据也是会被变卖的资产之一。而且,数据很难保护周全,泄露事件频繁得令人不安。
这些现象使批评者认为,数据不仅是一种资产,更是一种“有毒资产” 37,至少也是“危险物质” 38。数据或许不是什么“新黄金”或“新石油”,而是“新铀” 39。即使自信能够防止数据遭到滥用,每次收集数据时,我们仍需权衡它的好处与落入恶人之手的风险:计算机系统可能被罪犯或敌对国家的情报机构攻破;数据可能被内鬼泄露;公司可能落入不认同我们价值观、不择手段的管理层手中;国家也可能被一个强迫我们交出数据时毫无顾忌的政权接管。
收集数据时,我们不能只考虑今天的政治环境,还必须考虑未来所有可能出现的政府。没有人能保证今后当选的每一届政府都会尊重人权与公民自由;因此,“部署日后可能助长警察国家的技术,有违健全的公民社会规范” 40。
俗话说,“知识就是力量”。不仅如此,“审视他人而让自己免受审视,是最重要的权力形式之一” 41。这正是极权政府渴求监视的原因:它赋予政府控制民众的力量。今天的科技公司虽然没有公开谋求政治权力,但积累的数据与知识仍然赋予它们左右我们生活的巨大力量;其中很大一部分都在暗中发挥作用,不受公众监督 42。
回顾工业革命
数据是信息时代的决定性特征。互联网、数据存储与处理,以及软件驱动的自动化,正在深刻影响全球经济与人类社会。信息技术已经改变了我们的日常生活和社会组织,并且很可能在未来几十年继续带来根本变化,这自然让人联想到工业革命 17、26。
工业革命源于技术与农业的重大进步,带来了持续的经济增长,长远来看也显著提高了生活水平。然而,它同样伴随着严重问题:烟尘和化工过程造成可怕的空气污染,工业与生活废弃物也严重污染水源。工厂主生活奢华,城市工人却往往居住在简陋的房屋中,长时间在恶劣条件下劳动。雇用童工十分普遍,甚至让儿童在矿井中从事危险而低薪的工作。
人们花了很长时间,才建立起环境保护法规、工作场所安全规程、童工禁令和食品卫生检查等保障措施。工厂不能再把废料排入河流、出售受污染的食品或剥削工人,经营成本无疑会随之上升。然而,整个社会从这些法规中受益匪浅,今天几乎没有人愿意回到它们出现之前的年代 17。
正如工业革命有着必须治理的黑暗面,迈向信息时代的过程也带来了我们必须正视并解决的重大问题 43、44。数据的收集与使用就是其中之一。用 Bruce Schneier 的话来说 26:
数据是信息时代的污染问题,保护隐私则是环境挑战。几乎所有计算机都会产生信息。它堆积在周围,开始溃烂。如何处理它——如何控制它,又如何处置它——是信息经济健康发展的核心。今天,我们回望工业时代最初的几十年,会疑惑祖先为何在急于建设工业世界时无视污染;同样,我们的后代也会回望信息时代最初的几十年,并根据我们如何应对数据收集与滥用的挑战来评价我们。
我们应该努力让他们感到骄傲。
立法与自律
数据保护法或许能够帮助维护个人权利。例如,欧盟 GDPR 规定,个人数据必须“为特定、明确且合法的目的而收集,不得以与这些目的不相容的方式作进一步处理”;而且,数据必须“相对于处理目的而言充分、相关,并仅限于必要范围” 32。
然而,数据最小化(data minimization)原则与大数据的哲学针锋相对。大数据追求尽可能多地收集数据,将其与其他数据集组合,通过实验和探索获得新的洞见。探索意味着把数据用于未曾预料的目的,这恰好与收集数据时必须声明的“特定、明确”目的相反。GDPR 虽然给在线广告行业带来了一些影响 45,执行力度却一直很弱 46,而且似乎没有促使整个科技行业的文化与实践发生多大改变。
收集大量个人数据的公司反对监管,认为它会增加负担、妨碍创新。这种反对在一定程度上不无道理。例如,共享医疗数据显然会带来隐私风险,却也蕴藏着机会:如果数据分析能帮助我们改进诊断、找到更好的治疗方法,可以挽救多少生命 47?监管过度也许会阻碍这类突破。要在潜在机会与风险之间找到平衡并不容易 41。
归根结底,科技行业对待个人数据的文化必须改变。我们应该停止把用户视为有待优化的指标,记住他们是值得尊重、拥有尊严和自主权的人。我们应该自觉约束收集与处理数据的做法,建立并维系依赖我们软件的人们对我们的信任 48。我们也有责任让终端用户了解其数据如何被使用,而不是继续把他们蒙在鼓里。
我们应该让每个人保有隐私——也就是对自己数据的控制权——而不是用监视手段把这种控制权夺走。个人控制自身数据的权利,就像国家公园里的自然环境:如果我们不明确地保护、照料它,它就会遭到破坏。这将成为一场公地悲剧,最终所有人都会受害。无处不在的监视并非不可避免,我们仍然来得及阻止它。
第一步是不要永久保留数据,而要在不再需要时尽快清除,并从一开始就尽量少收集 48、49。手中没有的数据,就不可能泄露、被盗,也不可能被政府强迫交出。总的来说,我们必须改变文化与态度。身为技术从业者,如果不考虑自己工作的社会影响,就是没有尽到本职 50。
总结
至此,我们来到了全书的终点。这一路讨论了许多内容:
在 第 1 章 中,我们对比了分析型系统与事务型系统、云服务与自托管、分布式系统与单节点系统,并讨论了如何在业务需求与用户需求之间取得平衡。
在 第 2 章 中,我们介绍了如何定义性能、可靠性、可伸缩性和可维护性等非功能性需求。
在 第 3 章 中,我们考察了关系模型、文档模型、图模型、事件溯源和数据框等一系列数据模型,还介绍了 SQL、Cypher、SPARQL、Datalog 与 GraphQL 等查询语言的示例。
在 第 4 章 中,我们讨论了用于 OLTP 的存储引擎(LSM 树和 B 树)、用于分析的列式存储,以及用于信息检索的全文索引与向量索引。
在 第 5 章 中,我们考察了将数据对象编码为字节的不同方式,以及如何随着需求变化支持演化。我们还比较了数据通过数据库、服务调用、工作流引擎和事件驱动架构在进程之间流动的几种方式。
在 第 6 章 中,我们研究了单主复制、多主复制与无主复制之间的权衡,也讨论了写后读一致性等一致性模型,以及让客户端可以离线工作的同步引擎。
在 第 7 章 中,我们深入讨论了分片,包括再平衡策略、请求路由和二级索引。
在 第 8 章 中,我们讨论了事务的持久性、读已提交、快照隔离和可串行化等隔离级别的实现方式,以及如何保证分布式事务的原子性。
在 第 9 章 中,我们梳理了分布式系统中的根本问题,包括网络故障与延迟、时钟误差、进程暂停和崩溃,并看到这些问题为何让正确实现一把看似简单的锁都变得十分困难。
在 第 10 章 中,我们详细讨论了各种形式的共识,以及共识所实现的一致性模型——线性一致性。
在 第 11 章 中,我们深入研究了批处理,从简单的 Unix 工具链,一直讲到使用分布式文件系统或对象存储的大规模分布式批处理器。
在 第 12 章 中,我们把批处理推广为流处理,并讨论了底层消息代理、变更数据捕获、容错,以及流连接等处理模式。
在 第 13 章 中,我们探讨了一套流式系统的哲学,使彼此不同的数据系统更容易集成、系统更容易演化,应用也更容易伸缩。
最后,在本章中,我们退后一步,审视了构建数据密集型应用所涉及的一些伦理问题。我们看到,数据虽然可以用来行善,也可能造成严重伤害:作出深刻影响个人生活、却难以申诉的决定,导致歧视与剥削,让监视成为常态,并暴露私密信息。我们还面临数据泄露的风险;即使出于善意使用数据,也可能造成意料之外的后果。
软件和数据正在给世界带来如此巨大的影响。身为工程师,我们必须牢记,自己有责任为希望生活其中的世界而努力——一个怀着人性与尊重对待每个人的世界。让我们一起朝着这个目标前进。
脚注
参考文献
David Schmudde. What If Data Is a Bad Idea?. schmud.de, August 2024. Archived at perma.cc/ZXU5-XMCT ↩︎
ACM Code of Ethics and Professional Conduct. Association for Computing Machinery, acm.org, 2018. Archived at perma.cc/SEA8-CMB8 ↩︎
Igor Perisic. Making Hard Choices: The Quest for Ethics in Machine Learning. linkedin.com, November 2016. Archived at perma.cc/DGF8-KNT7 ↩︎
John Naughton. Algorithm Writers Need a Code of Conduct. theguardian.com, December 2015. Archived at perma.cc/TBG2-3NG6 ↩︎
Ben Green. “Good” isn’t good enough. At NeurIPS Joint Workshop on AI for Social Good, December 2019. Archived at perma.cc/H4LN-7VY3 ↩︎
Deborah G. Johnson and Mario Verdicchio. Ethical AI is Not about AI. Communications of the ACM, volume 66, issue 2, pages 32–34, January 2023. doi:10.1145/3576932 ↩︎
Marc Steen. Ethics as a Participatory and Iterative Process. Communications of the ACM, volume 66, issue 5, pages 27–29, April 2023. doi:10.1145/3550069 ↩︎
Logan Kugler. What Happens When Big Data Blunders? Communications of the ACM, volume 59, issue 6, pages 15–16, June 2016. doi:10.1145/2911975 ↩︎
Miri Zilka. Algorithms and the criminal justice system: promises and challenges in deployment and research. At University of Cambridge Security Seminar Series, March 2023. ↩︎
Bill Davidow. Welcome to Algorithmic Prison. theatlantic.com, February 2014. Archived at archive.org ↩︎
Don Peck. They’re Watching You at Work. theatlantic.com, December 2013. Archived at perma.cc/YR9T-6M38 ↩︎
Leigh Alexander. Is an Algorithm Any Less Racist Than a Human? theguardian.com, August 2016. Archived at perma.cc/XP93-DSVX ↩︎
Jesse Emspak. How a Machine Learns Prejudice. scientificamerican.com, December 2016. perma.cc/R3L5-55E6 ↩︎
Rohit Chopra, Kristen Clarke, Charlotte A. Burrows, and Lina M. Khan. Joint Statement on Enforcement Efforts Against Discrimination and Bias in Automated Systems. ftc.gov, April 2023. Archived at perma.cc/YY4Y-RCCA ↩︎
Maciej Cegłowski. The Moral Economy of Tech. idlewords.com, June 2016. Archived at perma.cc/L8XV-BKTD ↩︎
Greg Nichols. Artificial Intelligence in healthcare is racist. zdnet.com, November 2020. Archived at perma.cc/3MKW-YKRS ↩︎
Cathy O’Neil. Weapons of Math Destruction: How Big Data Increases Inequality and Threatens Democracy. Crown Publishing, 2016. ISBN: 978-0-553-41881-1 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Julia Angwin. Make Algorithms Accountable. nytimes.com, August 2016. Archived at archive.org ↩︎
Bryce Goodman and Seth Flaxman. European Union Regulations on Algorithmic Decision-Making and a ‘Right to Explanation’. At ICML Workshop on Human Interpretability in Machine Learning, June 2016. Archived at arxiv.org/abs/1606.08813 ↩︎
A Review of the Data Broker Industry: Collection, Use, and Sale of Consumer Data for Marketing Purposes. Staff Report, United States Senate Committee on Commerce, Science, and Transportation, commerce.senate.gov, December 2013. Archived at perma.cc/32NV-YWLQ ↩︎ ↩︎
Stephanie Assad, Robert Clark, Daniel Ershov, and Lei Xu. Algorithmic Pricing and Competition: Empirical Evidence from the German Retail Gasoline Market. Journal of Political Economy, volume 132, issue 3, pages 723-771, March 2024. doi:10.1086/726906 ↩︎
Donella H. Meadows and Diana Wright. Thinking in Systems: A Primer. Chelsea Green Publishing, 2008. ISBN: 978-1-603-58055-7 ↩︎
Daniel J. Bernstein. Listening to a “big data”/“data science” talk. Mentally translating “data” to “surveillance”: “...everything starts with surveillance...” x.com, May 2015. Archived at perma.cc/EY3D-WBBJ ↩︎
Marc Andreessen. Why Software Is Eating the World. a16z.com, August 2011. Archived at perma.cc/3DCC-W3G6 ↩︎
J. M. Porup. ‘Internet of Things’ Security Is Hilariously Broken and Getting Worse. arstechnica.com, January 2016. Archived at archive.org ↩︎
Bruce Schneier. Data and Goliath: The Hidden Battles to Collect Your Data and Control Your World. W. W. Norton, 2015. ISBN: 978-0-393-35217-7 ↩︎ ↩︎ ↩︎
The Grugq. Nothing to Hide. grugq.tumblr.com, April 2016. Archived at perma.cc/BL95-8W5M ↩︎
Federal Trade Commission. FTC Takes Action Against General Motors for Sharing Drivers’ Precise Location and Driving Behavior Data Without Consent. ftc.gov, January 2025. Archived at perma.cc/3XGV-3HRD ↩︎
Tony Beltramelli. Deep-Spying: Spying Using Smartwatch and Deep Learning. Masters Thesis, IT University of Copenhagen, December 2015. Archived at arxiv.org/abs/1512.05616 ↩︎
Shoshana Zuboff. Big Other: Surveillance Capitalism and the Prospects of an Information Civilization. Journal of Information Technology, volume 30, issue 1, pages 75–89, April 2015. doi:10.1057/jit.2015.5 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Michiel Rhoen. Beyond Consent: Improving Data Protection Through Consumer Protection Law. Internet Policy Review, volume 5, issue 1, March 2016. doi:10.14763/2016.1.404 ↩︎
Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016. Official Journal of the European Union, L 119/1, May 2016. ↩︎ ↩︎
UK Information Commissioner’s Office. What is the ’legitimate interests’ basis? ico.org.uk. Archived at perma.cc/W8XR-F7ML ↩︎
Tristan Harris. How a handful of tech companies control billions of minds every day. At TED2017, April 2017. ↩︎
Carina C. Zona. Consequences of an Insightful Algorithm. At GOTO Berlin, November 2016. ↩︎
Imanol Arrieta Ibarra, Leonard Goff, Diego Jiménez Hernández, Jaron Lanier, and E. Glen Weyl. Should We Treat Data as Labor? Moving Beyond ‘Free’. American Economic Association Papers Proceedings, volume 1, issue 1, December 2017. ↩︎
Bruce Schneier. Data Is a Toxic Asset, So Why Not Throw It Out? schneier.com, March 2016. Archived at perma.cc/4GZH-WR3D ↩︎ ↩︎
Cory Scott. Data is not toxic - which implies no benefit - but rather hazardous material, where we must balance need vs. want. x.com, March 2016. Archived at perma.cc/CLV7-JF2E ↩︎
Mark Pesce. Data is the new uranium – incredibly powerful and amazingly dangerous. theregister.com, November 2024. Archived at perma.cc/NV8B-GYGV ↩︎
Bruce Schneier. Mission Creep: When Everything Is Terrorism. schneier.com, July 2013. Archived at perma.cc/QB2C-5RCE ↩︎
Lena Ulbricht and Maximilian von Grafenstein. Big Data: Big Power Shifts? Internet Policy Review, volume 5, issue 1, March 2016. doi:10.14763/2016.1.406 ↩︎ ↩︎
Ellen P. Goodman and Julia Powles. Facebook and Google: Most Powerful and Secretive Empires We’ve Ever Known. theguardian.com, September 2016. Archived at perma.cc/8UJA-43G6 ↩︎
Judy Estrin and Sam Gill. The World Is Choking on Digital Pollution. washingtonmonthly.com, January 2019. Archived at perma.cc/3VHF-C6UC ↩︎
A. Michael Froomkin. Regulating Mass Surveillance as Privacy Pollution: Learning from Environmental Impact Statements. University of Illinois Law Review, volume 2015, issue 5, August 2015. Archived at perma.cc/24ZL-VK2T ↩︎
Pengyuan Wang, Li Jiang, and Jian Yang. The Early Impact of GDPR Compliance on Display Advertising: The Case of an Ad Publisher. Journal of Marketing Research, volume 61, issue 1, April 2023. doi:10.1177/00222437231171848 ↩︎
Johnny Ryan. Don’t be fooled by Meta’s fine for data breaches. The Economist, May 2023. Archived at perma.cc/VCR6-55HR ↩︎
Jessica Leber. Your Data Footprint Is Affecting Your Life in Ways You Can’t Even Imagine. fastcompany.com, March 2016. Archived at archive.org ↩︎
Maciej Cegłowski. Haunted by Data. idlewords.com, October 2015. Archived at archive.org ↩︎ ↩︎
Sam Thielman. You Are Not What You Read: Librarians Purge User Data to Protect Privacy. theguardian.com, January 2016. Archived at archive.org ↩︎
Jez Humble. It’s a cliché that people get into tech to “change the world”. So then, you have to actually consider what the impact of your work is on the world. The idea that you can or should exclude societal and political discussions in tech is idiotic. It means you’re not doing your job. x.com, April 2021. Archived at perma.cc/3NYS-MHLC ↩︎
术语表
请注意:本术语表的定义刻意保持简短,旨在传达核心概念,而非覆盖术语的全部细节。更多内容请参阅正文对应章节。
异步(asynchronous)
不等待某件事完成(例如通过网络把数据发送到另一个节点),且不假设它会在多长时间内完成。参见“同步与异步复制”、“同步网络与异步网络”和“系统模型与现实”。
原子(atomic)
- 在并发语境下:指一个操作看起来在某个单一时刻生效,其他并发进程不会看到它处于“半完成”状态。另见 isolation。
- 在事务语境下:指一组写入要么全部提交、要么全部回滚,即使发生故障也不例外。参见“原子性”和“两阶段提交(2PC)”。
背压(backpressure)
当接收方跟不上时,强制发送方降速。也称为 flow control。参见“系统过载后无法恢复时会发生什么”。
批处理(batch process)
以一个固定(通常较大)数据集为输入、产出另一份数据且不修改输入的计算。参见第 11 章。
有界(bounded)
具有已知上限或大小。例如可用于描述网络延迟(参见“超时与无界延迟”)和数据集(参见第 12 章导言)。
拜占庭故障(Byzantine fault)
节点以任意错误方式行为,例如向不同节点发送相互矛盾或恶意消息。参见“拜占庭故障”。
缓存(cache)
通过记住近期访问数据来加速后续读取的组件。缓存通常不完整:若未命中,需要回源到更慢但完整的底层数据存储。
CAP 定理(CAP theorem)
一个在实践中经常被误解、且不太有直接指导价值的理论结果。参见“CAP 定理”。
因果关系(causality)
当一件事“先于”另一件事发生时产生的事件依赖关系。例如后续事件对先前事件的响应、建立在先前事件之上,或必须结合先前事件理解。参见“happens-before 关系与并发”。
共识(consensus)
分布式计算中的基本问题:让多个节点就某件事达成一致(例如谁是主节点)。这比直觉上要困难得多。参见“共识”。
数据仓库(data warehouse)
将多个 OLTP 系统的数据汇总并整理后,用于分析场景的数据库。参见“数据仓库”。
声明式(declarative)
描述“想要什么性质”,而非“如何一步步实现”。在数据库查询中,优化器接收声明式查询并决定最佳执行方式。参见“术语:声明式查询语言”。
反规范化(denormalize)
在已规范化数据集中引入一定冗余(常见形式为缓存或索引)以换取更快读取。反规范化值可看作预计算结果,类似物化视图。参见“规范化、反规范化与连接”。
派生数据(derived data)
通过可重复流程由其他数据生成的数据集,必要时可重新计算。通常用于加速某类读取。索引、缓存、物化视图都属于派生数据。参见“记录系统与派生数据”。
确定性(deterministic)
一个函数在相同输入下总产生相同输出,不依赖随机数、当前时间、网络交互等不可预测因素。参见“确定性的力量”。
分布式(distributed)
系统在多个通过网络连接的节点上运行。其典型特征是 部分失效:一部分坏了,另一部分仍在工作,而软件往往难以精确知道哪里坏了。参见“故障与部分失效”。
持久性(durable)
以你相信不会丢失的方式存储数据,即使发生各种故障。参见“持久性”。
ETL
Extract-Transform-Load(提取-转换-加载):从源数据库抽取数据,转成更适合分析查询的形式,再加载到数据仓库或批处理系统。参见“数据仓库”。
故障切换(failover)
在单主系统中,将主角色从一个节点切到另一个节点的过程。参见“处理节点故障”。
容错(fault-tolerant)
出现故障(如机器崩溃、链路故障)后仍可自动恢复。参见“可靠性与容错”。
流量控制(flow control)
见 backpressure。
追随者(follower)
不直接接收客户端写入、仅应用来自主节点变更的副本。也称 secondary、read replica 或 hot standby。参见“单主复制”。
全文检索(full-text search)
按任意关键词搜索文本,通常支持近似拼写、同义词等能力。全文索引是支持此类查询的一种 secondary index。参见“全文检索”。
图(graph)
由 vertices(可引用对象,也称 nodes 或 entities)和 edges(顶点间连接,也称 relationships 或 arcs)组成的数据结构。参见“图状数据模型”。
哈希(hash)
把输入映射成看似随机数字的函数。相同输入总得相同输出;不同输入通常输出不同,但也可能碰撞(collision)。参见“按键的哈希分片”。
幂等(idempotent)
可安全重试的操作:执行多次与执行一次效果相同。参见“幂等性”。
索引(index)
一种可高效检索“某字段取某值”的记录的数据结构。参见“OLTP 的存储与索引”。
隔离性(isolation)
在事务语境下,并发事务相互干扰的程度。Serializable 最强,也常用更弱隔离级别。参见“隔离性”。
连接(join)
把具有关联关系的记录拼在一起。常见于一个记录引用另一个记录(外键、文档引用、图边)时,查询需要取到被引用对象。参见“规范化、反规范化与连接”和“JOIN 与 GROUP BY”。
领导者(leader)
当数据或服务跨多个节点复制时,被指定为可接受写入的副本。可通过协议选举或管理员指定。也称 primary 或 source。参见“单主复制”。
线性一致(linearizable)
表现得像系统里只有一份数据副本,且由原子操作更新。参见“线性一致性”。
局部性(locality)
一种性能优化:把经常被一起访问的数据放在一起。参见“读写的数据局部性”。
锁(lock)
保证同一时刻只有一个线程/节点/事务访问某资源的机制;其他访问者需等待锁释放。参见“两阶段锁(2PL)”和“分布式锁与租约”。
日志(log)
只追加写入的数据文件。WAL 用于崩溃恢复(参见“让 B 树可靠”);log-structured 存储把日志作为主存储格式(参见“日志结构存储”);replication log 用于主从复制(参见“单主复制”);event log 可表示数据流(参见“基于日志的消息代理 ”)。
物化(materialize)
把计算结果提前算出并写下来,而不是按需即时计算。参见“事件溯源与 CQRS”。
节点(node)
运行在某台计算机上的软件实例,通过网络与其他节点协作完成任务。
规范化(normalized)
数据结构中尽量避免冗余与重复。规范化数据库里某数据变化时通常只改一处,不需多处同步。参见“规范化、反规范化与连接”。
OLAP
Online Analytic Processing(在线分析处理):典型访问模式是对大量记录做聚合(如 count/sum/avg)。参见“事务系统与分析系统”。
OLTP
Online Transaction Processing(在线事务处理):典型访问模式是快速读写少量记录,通常按键索引。参见“事务系统与分析系统”。
分片(sharding)
把单机装不下的大数据集或计算拆成更小部分并分散到多台机器上。也称 partitioning。参见第 7 章。
百分位(percentile)
通过统计多少值高于/低于某阈值来描述分布。例如某时段 95 分位响应时间为 t,表示 95% 请求耗时小于 t,5% 更长。参见“描述性能”。
主键(primary key)
唯一标识一条记录的值(通常为数字或字符串)。在很多应用中由系统在创建时生成(顺序或随机),而非用户手工指定。另见 secondary index。
法定票数(quorum)
一个操作被判定成功前所需的最少投票节点数。参见“读写法定票数”。
再平衡(rebalance)
为均衡负载,把数据或服务从一个节点迁移到另一个节点。参见“键值数据的分片”。
复制(replication)
在多个节点(replicas)上保存同一份数据,以便部分节点不可达时仍可访问。参见第 6 章。
模式(schema)
对数据结构(字段、类型等)的描述。数据是否符合模式可在生命周期不同阶段检查(参见“文档模型中的模式灵活性”),模式也可随时间演进(参见第 5 章)。
二级索引(secondary index)
与主存储并行维护的附加结构,用于高效检索满足某类条件的记录。参见“多列索引与二级索引”和“分片与二级索引”。
可串行化(serializable)
一种 isolation 保证:多个事务并发执行时,行为等价于某个串行顺序逐个执行。参见“可串行化”。
无共享(shared-nothing)
一种架构:独立节点(各自 CPU、内存、磁盘)通过普通网络连接;相对的是共享内存或共享磁盘架构。参见“共享内存、共享磁盘与无共享架构”。
偏斜(skew)
- 分片负载不均:某些分片请求/数据很多,另一些很少。也称 hot spots。参见“负载偏斜与热点消除”。
- 一种时序异常,导致事件呈现为非预期的非顺序。参见“快照隔离与可重复读”中的读偏斜、“写偏斜与幻读”中的写偏斜、以及“用于事件排序的时间戳”中的时钟偏斜。
脑裂(split brain)
两个节点同时认为自己是领导者,可能破坏系统保证。参见“处理节点故障”和“少数服从多数”。
存储过程(stored procedure)
把事务逻辑编码到数据库服务器端执行,使事务过程中无需与客户端来回通信。参见“实际串行执行”。
流处理(stream process)
持续运行的计算:消费无穷事件流并产出结果。参见第 12 章。
同步(synchronous)
asynchronous 的反义词。
记录系统(system of record)
持有某类数据主权威版本的系统,也称 source of truth。数据变更首先写入这里,其他数据集可由其派生。参见“记录系统与派生数据”。
超时(timeout)
最简单的故障检测方式之一:在一定时间内未收到响应即判定超时。但无法确定是远端节点故障还是网络问题导致。参见“超时与无界延迟”。
全序(total order)
一种可比较关系(如时间戳),任意两者都能判定大小。若存在不可比较元素,则称 partial order(偏序)。
事务(transaction)
把多次读写封装为一个逻辑单元,以简化错误处理与并发问题。参见第 8 章。
两阶段提交(two-phase commit, 2PC)
保证多个数据库节点对同一事务要么都 atomically 提交、要么都中止的算法。参见“两阶段提交(2PC)”。
两阶段锁(two-phase locking, 2PL)
实现 serializable isolation 的算法:事务对读写数据加锁并持有到事务结束。参见“两阶段锁(2PL)”。
无界(unbounded)
没有已知上限或大小。与 bounded 相反。
索引
符号
- 3FS(分布式文件系统), 分布式文件系统
A
- 中止(事务), 事务, 原子性
- 级联, 没有脏读
- 在两阶段提交中, 两阶段提交(2PC)
- 乐观并发控制的性能, 可串行化快照隔离的性能
- 重试已中止的事务, 处理错误和中止
- 抽象, 云服务的分层, 简单性:管理复杂度, 数据模型与查询语言, 事务, 总结
- 意外复杂性, 简单性:管理复杂度
- 问责制, 责任与问责
- 会计(财务数据), 总结, 不可变事件的优点
- Accumulo(数据库)
- ACID 属性(事务), ACID 的含义
- 确认(消息), 确认与重新传递
- active/active replication(见 multi-leader replication)
- active/passive replication(见 基于领导者的复制)
- ActiveMQ(消息系统), 消息代理, 消息代理与数据库的对比
- 分布式事务支持, XA 事务
- ActiveRecord(对象关系映射器), 对象关系映射(ORM), 处理错误和中止
- activity (workflows)(见 workflow engines)
- Actor 模型, 分布式 actor 框架
- (另见 event-driven architecture)
- 与流处理的比较, 事件驱动架构与 RPC
- 自适应容量, 偏斜的工作负载与缓解热点
- Advanced Message Queuing Protocol(见 AMQP)
- 航空航天系统, 拜占庭故障
- Aerospike(数据库)
- 强一致性模式, 单对象写入
- AGE(图数据库), Cypher 查询语言
- 汇总
- 数据立方体和已实现视图, 物化视图与数据立方体
- 分批处理, 排序与内存聚合
- 流程中, 流分析
- 聚合管道(MongoDB), 规范化、反规范化与连接, 文档的查询语言
- 敏捷, 可演化性:让变化更容易
- 最小化不可逆性, 批处理, 应用演化后重新处理数据
- 充满自信地快速前进, 端到端原则重现
- 一致意见, 单值共识, 原子提交作为共识
- (另见 共识)
- AI (artificial intelligence)(见 machine learning)
- AI Act (European Union), 数据系统、法律与社会
- Airbyte, 数据仓库
- Airflow(工作流调度器), 持久化执行与工作流, 批处理, 工作流调度
- 云数据仓集成, 查询语言
- 用于 ETL, 提取-转换-加载(ETL)
- 阿卡迈
- 响应时间研究, 平均值、中位数与百分位点
- 算法
- 算法正确性, 定义算法的正确性
- B树, B 树-B 树变体
- 分布式系统, 系统模型与现实
- 归并排序, 构建和合并 SSTable, 混洗数据
- 调度, 资源分配
- SSTable 与 LSM 树, SSTable 文件格式-压实策略
- 全互联复制拓扑, 多主复制拓扑
- AllegroGraph(数据库), 图数据模型
- SPARQL 查询语言, SPARQL 查询语言
- ALTER TABLE 语句(SQL), 文档模型中的模式灵活性, 编码与演化
- 亚马逊
- Dynamo(见 Dynamo(数据库))
- 响应时间研究, 平均值、中位数与百分位点
- Amazon Web Services (AWS)
- Aurora(见 Aurora(云数据库))
- ClockBound(见 ClockBound(时间同步))
- 正确性测试, 形式化方法和随机测试
- DynamoDB(见 DynamoDB(数据库))
- EBS(见 EBS(虚拟块设备))
- Kinesis(见 Kinesis(消息系统))
- Neptune(见 Neptune(图数据库))
- 网络可靠性, 实践中的网络故障
- S3(见 S3(对象存储))
- 放大
- AMQP(高级消息队列协议), 消息代理与数据库的对比
- (另见 messaging systems)
- 比较基于日志的邮件, 日志与传统的消息传递相比, 重播旧消息
- 消息顺序, 确认与重新传递
- 分析系统, 分析型与事务型系统
- 分析, 分析型与事务型系统-记录系统与派生数据
- 与事务处理的比较, 事务处理与分析的特征
- 数据正常化, 规范化的权衡
- data warehousing(见 data warehousing)
- predictive(见 predictive analytics)
- 与批量处理的关系, 分析(Analytics)-分析(Analytics)
- 计划, 星型与雪花型:分析模式-星型与雪花型:分析模式
- 快速隔离查询, 快照隔离与可重复读
- 流式分析, 流分析
- 分析工程, 分析型与事务型系统
- 反熵, 追赶错过的写入
- Antithesis(确定性仿真测试), 确定性模拟测试
- Apache Accumulo(见 Accumulo)
- Apache ActiveMQ(见 ActiveMQ)
- Apache AGE(见 AGE)
- Apache Arrow(见 Arrow(数据格式))
- Apache Avro(见 Avro)
- Apache Beam(见 Beam)
- Apache BookKeeper(见 BookKeeper)
- Apache Cassandra(见 Cassandra)
- Apache Curator(见 Curator)
- Apache DataFusion(见 DataFusion(查询引擎))
- Apache Druid(见 Druid(数据库))
- Apache Flink(见 Flink(处理框架))
- Apache HBase(见 HBase)
- Apache Iceberg(见 Iceberg(表格式))
- Apache Jena(见 Jena)
- Apache Kafka(见 Kafka)
- Apache Lucene(见 Lucene)
- Apache Oozie(见 Oozie(工作流调度器))
- Apache ORC(见 ORC(数据格式))
- Apache Parquet(见 Parquet(数据格式))
- Apache Pig(查询语言), 查询语言
- Apache Pinot(见 Pinot(数据库))
- Apache Pulsar(见 Pulsar)
- Apache Qpid(见 Qpid)
- Apache Samza(见 Samza)
- Apache Solr(见 Solr)
- Apache Spark(见 Spark;见 Spark(处理框架))
- Apache Storm(见 Storm)
- Apache Superset(见 Superset(数据可视化软件))
- Apache Thrift(见 Thrift)
- Apache ZooKeeper(见 ZooKeeper)
- Apama (流式分析), 复合事件处理
- append-only files(见 logs)
- Application Programming Interfaces (APIs), 数据模型与查询语言
- 用于改变流, 变更流的 API 支持
- 分布式事务, XA 事务
- 服务费用, 流经服务的数据流:REST 与 RPC-RPC 的数据编码与演化
- (另见 services)
- 可演化性, RPC 的数据编码与演化
- RESTful, Web 服务
- application state(见 国家)
- approximate search(见 similarity search)
- 档案储存、数据库数据, 归档存储
- arcs(见 edges)
- ArcticDB(数据库), 数据框、矩阵与数组
- 算术平均值, 平均值、中位数与百分位点
- 数组
- Arrow(数据格式), 列式存储, DataFrames
- artificial intelligence(见 machine learning)
- ASCII text, Protocol Buffers
- ASN.1 (schema language), 模式的优点
- 关联表格, 多对一与多对多关系, 属性图
- 同步网络, 不可靠的网络, 术语表
- 同步复制, 同步复制与异步复制, 术语表
- 故障数据损失, 领导者故障:故障转移
- 从同步跟踪器读取, 复制延迟的问题
- 有多个领导, 多主复制
- 异步传输模式, 我们不能简单地使网络延迟可预测吗?
- 原子广播, 共享日志作为共识
- 原子钟, 带置信区间的时钟读数, 用于全局快照的同步时钟
- (另见 clocks)
- 原子性, 术语表
- 原子自增, 单对象写入
- 比较和设置, 条件写入(比较并设置), 什么使系统具有线性一致性?
- (另见 比较和设置)
- 异常数据, 规范化的权衡
- 获取和添加/递增, ID 生成器和逻辑时钟, 共识, 获取并增加作为共识
- 写入操作, 原子写操作
- 原子性, 原子性, 单对象与多对象操作, 术语表
- 可审计性, 信任但验证-用于可审计数据系统的工具
- 设计, 为可审计性而设计
- 自动审计系统, 不要盲目信任承诺
- 通过不可改变性, 不可变事件的优点
- 可审计数据系统工具, 用于可审计数据系统的工具
- Aurora(云数据库), 云原生系统架构
- Aurora DSQL(数据库)
- 快速隔离支持, 快照隔离与可重复读
- 自动缩放, 运维:自动/手动再平衡
- Automerge (CRDT library), 同步引擎的利弊
- 可用性, 可靠性与容错
- 可用区, 通过冗余容忍硬件故障, 读己之写
- Avro(数据格式), Avro-动态生成的模式
- 动态生成的计划, 动态生成的模式
- 对象容器文件, 但什么是写入者模式?, 归档存储
- 读者决定作家的计划, 但什么是写入者模式?
- 计划演变, 写入者模式与读取者模式
- 批量处理中的用途, MapReduce
- awk (Unix 工具) (英语)., 简单日志分析, 简单日志分析, 分布式作业编排
- Axon Framework, 事件溯源与 CQRS
- Azkaban(工作流调度器), 批处理
- Azure Blob Storage(对象存储), 云服务的分层, 设置新的副本
- 有条件的标题, 隔离僵尸进程和延迟请求
- Azure managed disks, 存储与计算的分离
- Azure SQL DB(数据库), 云原生系统架构
- Azure Storage, 对象存储
- Azure Synapse Analytics(数据库), 云原生系统架构
- Azure Virtual Machines
- 现场虚拟机, 故障处理
B
- B树(指数), B 树-B 树变体
- B+ trees, B 树变体
- 分支因子, B 树
- comparison to LSM-trees, 比较 B 树与 LSM 树-磁盘空间使用
- 崩溃恢复, 使 B 树可靠
- 通过分割页面增长, B 树
- 不可变变种, B 树变体, 索引与快照隔离
- 与硬分裂相似, 再平衡键范围分片数据
- 变体, B 树变体
- B2(对象存储), 分布式文件系统
- Backblaze B2(见 B2(对象存储))
- 后端, 数据系统架构中的权衡
- 返回, 指数, 描述性能, 处理错误和中止
- 背压, 描述性能, 读取性能, 消息传递系统, 术语表
- 备份
- 向后兼容, 编码与演化
- BadgerDB(数据库)
- 可序列事务, 可串行化快照隔离(SSI)
- BASE, contrast to ACID, ACID 的含义
- 击打弹壳(Unix), OLTP 系统的存储与索引
- 批处理, 批处理-本章小结, 术语表
- 方案规划和职能规划, MapReduce
- 惠益, 批处理
- 结合流处理, 统一批处理和流处理
- 与流处理的比较, 流处理
- 数据流引擎, 数据流引擎-数据流引擎
- 过失容忍, 故障处理, 消息传递系统
- 数据整合, 批处理与流处理-统一批处理和流处理
- 图表和迭代处理, 机器学习
- high-level APIs and languages, 查询语言-查询语言
- 云数据仓库中, 查询语言
- 在分布式系统中, 分布式系统中的批处理
- 加入和分组, JOIN 与 GROUP BY-JOIN 与 GROUP BY
- 限制, 批处理
- 基于日志的信息和, 重播旧消息
- 保持衍生状态, 维护派生状态
- 衡量业绩, 批处理
- 模式, 批处理模型
- 资源分配, 资源分配-资源分配
- 资源管理员, 分布式作业编排
- 调度器, 分布式作业编排
- 服务衍生数据, 对外提供派生数据-对外提供派生数据
- 移动数据, 混洗数据-混洗数据
- 任务执行, 分布式作业编排
- 使用大小写, 批处理用例-对外提供派生数据
- 使用 Unix 工具(例如), 使用 Unix 工具的批处理-排序与内存聚合
- 批处理框架
- 与操作系统的比较, 分布式系统中的批处理
- Beam (数据流库), 统一批处理和流处理
- BERT (language model), 向量嵌入
- 偏向, 偏见与歧视
- bidirectional replication(见 multi-leader replication)
- 泥浆大球, 简单性:管理复杂度
- 大数据
- 对数据最小化, 数据系统、法律与社会, 立法与自律
- BigQuery(数据库), 云原生系统架构, 云数据仓库, 批处理
- Bigtable(数据库)
- 硬化计划, 按键的范围分片
- 存储布局, 构建和合并 SSTable
- 平板(硬化), 分片
- 宽柱数据模型, 读写的数据局部性, 列压缩
- 二进制数据编码, 二进制编码-模式的优点
- 二进制编码
- binary strings, lack of support in JSON and XML, JSON、XML 及其二进制变体
- 比特币(催眠币), 用于可审计数据系统的工具
- 位图索引, 列压缩
- BitTorrent uTP protocol, TCP 的局限性
- Bkd-树木(指数), 多维索引与全文索引
- 无咎死后, 人类与可靠性
- Blazegraph(数据库), 图数据模型
- SPARQL 查询语言, SPARQL 查询语言
- blob storage(见 object storage)
- 块, 分布式文件系统
- 块设备(磁盘), 存储与计算的分离
- 块链, 总结
- 拜占庭断层承受力, 拜占庭故障, 共识, 用于可审计数据系统的工具
- 阻止原子承诺, 三阶段提交
- Bloom 过滤器(算法), 布隆过滤器, 读取性能, 流分析
- BookKeeper (replicated log), 将工作分配给节点
- 边框数据集, 流处理, 术语表
- (另见 batch processing)
- 受限延迟, 术语表
- 广播
- 全序广播(见 shared logs)
- 无中介消息, 直接从生产者传递给消费者
- 粗糙(计量聚合器), 直接从生产者传递给消费者
- BTM (transaction coordinator), 两阶段提交(2PC)
- 缓冲
- Bufstream(消息系统), 设置新的副本
- Bufstream(消息系统), 磁盘空间使用
- 新建或购买, 云服务与自托管
- 快速网络交通模式, 我们不能简单地使网络延迟可预测吗?
- 商业分析员, 分析型与事务型系统, 从数据仓库到数据湖
- 商业数据处理, 事务处理与分析的特征
- 商业情报, 分析型与事务型系统-数据仓库
- Business Process Execution Language (BPEL), 持久化执行与工作流
- Business Process Model and Notation (BPMN), 持久化执行与工作流
- 实例, 持久化执行与工作流
- 字节序列,编码数据, 编码数据的格式
- 拜占庭断层, 拜占庭故障-弱形式的谎言, 系统模型与现实, 术语表
- 拜占庭容错系统, 拜占庭故障
- Byzantine Generals Problem, 拜占庭故障
- 协商一致算法和, 共识, 用于可审计数据系统的工具
C
- 缓存, 全内存存储, 术语表
- 意见, 物化视图与数据立方体
- 作为衍生数据, 记录系统与派生数据, 组合使用数据存储技术-分拆系统与集成系统
- in CPUs, 查询执行:编译与向量化, 线性一致性与网络延迟
- 无效和赡养费, 保持系统同步, 维护物化视图
- 线性一致性, 线性一致性
- 云中的本地磁盘, 存储与计算的分离
- 日历同步, 同步引擎与本地优先软件, 同步引擎的利弊
- California Consumer Privacy Act (CCPA), 数据系统、法律与社会
- Camunda(工作流程引擎), 持久化执行与工作流
- (数据), 记录系统与派生数据
- CAP定理, CAP 定理-CAP 定理, 术语表
- 能力规划, 云时代的运维
- Cap’n Proto(数据格式), 编码数据的格式
- 碳排放, 分布式与单节点系统
- 级联中止, 没有脏读
- 连锁失败, 软件故障, 运维:自动/手动再平衡, 超时和无界延迟
- Cassandra(数据库)
- 数据变更捕获, 数据变更捕获的实现, 变更流的 API 支持
- 压缩战略, 压实策略
- consistency level ANY, 单主与无主复制的性能
- 散列变硬, 按键的哈希分片, 按哈希范围分片
- 最后写成的解决冲突, 检测并发写入
- 无领导复制, 无主复制
- 轻量事务, 单对象写入
- 线性,缺少, 实现线性一致性系统
- 日志结构存储, 构建和合并 SSTable
- 多区域支助, 多地区操作
- 二级指数, 本地二级索引
- 使用时钟, 仲裁一致性的局限, 用于事件排序的时间戳
- 节点(硬化), 分片
- 猫(Unix 工具), 简单日志分析
- 目录, 云数据仓库
- 因果关系, 版本向量
- (另见 causal dependencies)
- 因果关系, “先发生"关系与并发-版本向量
- 捕获, 版本向量, 排序事件以捕获因果关系, 读也是事件
- 按总订单, 全序的限制
- 事务中, 基于过时前提的决策
- 向朋友发送消息(例如), 排序事件以捕获因果关系
- 捕获, 版本向量, 排序事件以捕获因果关系, 读也是事件
- 因果关系, 术语表
- 因果顺序
- 与, 逻辑时钟
- 与, 逻辑时钟-使用逻辑时钟强制约束
- 发生关系前, “先发生"关系与并发
- 在可序列事务中, 基于过时前提的决策-检测影响先前读取的写入
- 与时钟不符, 用于事件排序的时间戳
- 命令要抓取的事件, 排序事件以捕获因果关系
- 违反《公约》的行为, 一致前缀读, 不同拓扑的问题, 用于事件排序的时间戳
- 带有同步时钟, 用于全局快照的同步时钟
- 因果顺序
- 基于单元格的架构, 面向多租户的分片
- 复合事件处理(见 复合事件处理)
- CephFS(分布式文件系统), 批处理, 对象存储
- 证书透明性, 用于可审计数据系统的工具
- c组, 分布式作业编排
- 数据变更捕获, 逻辑(基于行)日志复制, 数据变更捕获
- 变更流的 API 支持, 变更流的 API 支持
- 比较事件来源, 数据变更捕获与事件溯源
- 执行, 数据变更捕获的实现
- 初始快照, 初始快照
- 日志压缩, 日志压缩
- 更改日志, 状态、流和不变性
- 混乱工程, 容错, 故障注入
- 检查站
- 断路器(限制重试), 描述性能
- 电路交换网络, 同步与异步网络
- 循环缓冲器, 磁盘空间使用
- 循环复制地形, 多主复制拓扑
- Citus(数据库)
- 散列变硬, 固定数量的分片
- ClickHouse(数据库), 事务处理与分析的特征, 云原生系统架构
- 增量视图维护, 维护物化视图
- 点击流数据,分析, JOIN 与 GROUP BY
- 客户
- 电话服务, 流经服务的数据流:REST 与 RPC
- 脱机, 同步引擎与本地优先软件, 有状态、可离线的客户端
- 推动状态更改到, 将状态变更推送给客户端
- 请求路由, 请求路由
- ClockBound(时间同步), 带置信区间的时钟读数
- use in YugabyteDB, 用于全局快照的同步时钟
- 时钟, 不可靠的时钟-限制垃圾回收的影响
- 原子钟, 带置信区间的时钟读数, 用于全局快照的同步时钟
- 信任间隔, 带置信区间的时钟读数-用于全局快照的同步时钟
- 全球快照, 用于全局快照的同步时钟
- 混合逻辑时钟, 混合逻辑时钟
- logical(见 logical clocks)
- 偏斜, 最后写入胜利(丢弃并发写入), 仲裁一致性的局限, 对同步时钟的依赖-带置信区间的时钟读数, 实现线性一致性系统
- 杀人, 单调时钟
- 同步和准确性, 时钟同步和准确性-时钟同步和准确性
- synchronization using GPS, 不可靠的时钟, 时钟同步和准确性, 带置信区间的时钟读数, 用于全局快照的同步时钟
- 时间与单调时钟, 单调时钟与日历时钟
- 时间标记事件, 你用的是谁的时钟?
- 云服务, 云服务与自托管-云计算与超级计算
- 云内, 云原生系统架构-云时代的运维
- 云飞
- R2(见 R2(对象存储))
- 组合索引, 在索引中存储值
- 分组(记录顺序), 按哈希范围分片
- CockroachDB(数据库)
- 基于共识的复制, 单主复制
- 一致性模式, 什么使系统具有线性一致性?
- 键程硬化, 分片, 按键的范围分片
- 可序列事务, 可串行化快照隔离(SSI)
- 硬化二级指数, 全局二级索引
- 事务, 事务到底是什么?, 数据库内部的分布式事务
- 使用模型检查, 模型检查与规范语言
- 代码生成
- 用于查询执行, 查询执行:编译与向量化
- 带有协议缓冲, Protocol Buffers
- 协作编辑, 实时协作、离线优先和本地优先应用
- 列家庭(大表), 读写的数据局部性, 列压缩
- 面向列的存储, 列式存储-查询执行:编译与向量化
- comma-separated values(见 CSV)
- 命令查询责任分离, 事件溯源与 CQRS-事件溯源与 CQRS, 从同一事件日志中派生多个视图
- 命令(活动来源), 事件溯源与 CQRS
- 执行(事务), 事务
- 原子提交, 分布式事务-再谈恰好一次消息处理
- (另见 原子性)
- 读作承诺隔离, 读已提交
- three-phase commit (3PC), 三阶段提交
- 两阶段提交, 两阶段提交(2PC)-协调器故障
- 原子提交, 分布式事务-再谈恰好一次消息处理
- 通用业务, 冲突解决与复制
- 压实(Compaction)
- 比较和设置, 条件写入(比较并设置), 什么使系统具有线性一致性?
- 兼容性, 编码与演化, 数据流的模式
- 电话服务, RPC 的数据编码与演化
- 编码格式的属性, 总结
- 使用数据库, 流经数据库的数据流-归档存储
- 补偿事务, 不可变事件的优点, 宽松地解释约束
- 汇编, 查询执行:编译与向量化
- 复合事件处理, 复合事件处理
- 复杂度
- 理论模型中的蒸馏, 将系统模型映射到现实世界
- 重要和意外事项, 简单性:管理复杂度
- 使用抽象来隐藏, 数据模型与查询语言
- 管理, 简单性:管理复杂度
- composing data systems(见 unbundling databases)
- 压缩
- in SSTables, SSTable 文件格式
- 计算密集型应用程序, 数据系统架构中的权衡
- 电脑游戏, 同步引擎的利弊
- 缩写索引, 多维索引与全文索引
- 在散列硬化系统中, 按哈希范围分片
- 并发
- 演员编程模式, 分布式 actor 框架, 事件驱动架构与 RPC
- (另见 event-driven architecture)
- 事务隔离薄弱时出现的错误, 弱隔离级别
- 解决冲突, 处理写入冲突-处理写入冲突
- 定义, 处理写入冲突
- 检测并行写作, 检测并发写入-版本向量
- 双写、 问题, 保持系统同步
- 发生关系前, “先发生"关系与并发
- 在复制系统中, 复制延迟的问题-版本向量, 线性一致性-线性一致性与网络延迟
- 丢失更新, 防止丢失更新
- 多版本并发控制, 多版本并发控制(MVCC), 用于全局快照的同步时钟
- 乐观并发控制, 悲观并发控制与乐观并发控制
- 行动命令, 什么使系统具有线性一致性?
- 通过事件日志减少, 并发控制, 数据流:应用代码与状态变化的交互
- 时间和相对性, “先发生"关系与并发
- 事务隔离, 隔离性
- 写偏差, 写偏差与幻读-物化冲突
- 演员编程模式, 分布式 actor 框架, 事件驱动架构与 RPC
- 有条件写入, 条件写入(比较并设置)
- 会议管理系统(例如), 事件溯源与 CQRS
- conflict-free replicated datatypes (CRDTs), CRDT 与操作变换
- 冲突
- 撤销, 冲突避免
- 因果关系, “先发生"关系与并发
- 冲突检测
- 分布式事务, XA 事务的问题
- 在基于日志的系统中, 唯一性约束需要达成共识
- in serializable snapshot isolation (SSI), 检测影响先前读取的写入
- 在两阶段提交中, 系统性的承诺
- 解决冲突
- 通过中止事务, 悲观并发控制与乐观并发控制
- 通过道歉, 宽松地解释约束
- 最后写入胜利, 用于事件排序的时间戳
- 使用原子操作, 冲突解决与复制
- 确定什么是冲突, 处理写入冲突, 基于日志消息传递中的唯一性
- 无领导复制, 检测并发写入
- 丢失更新, 防止丢失更新-冲突解决与复制
- 实现, 物化冲突
- 决议, 处理写入冲突-处理写入冲突
- 自动, 自动冲突解决
- 无头系统, 检测并发写入
- 最后写入胜利, 最后写入胜利(丢弃并发写入)
- 使用自定义逻辑, 手动冲突解决, 捕获先发生关系
- 兄弟值, 手动冲突解决, 捕获先发生关系
- 合并, 捕获先发生关系
- 写偏差, 写偏差与幻读-物化冲突
- 调和
- Freight(消息系统), 设置新的副本, 磁盘空间使用
- 计划登记, JSON 模式, 但什么是写入者模式?
- 拥堵(网络)
- 撤销, TCP 的局限性
- 限制时钟的准确性, 带置信区间的时钟读数
- 排队延迟, 网络拥塞和排队
- 共识, 共识-总结, 术语表
- consent (GDPR), 同意与选择自由
- 一致性, 一致性, 及时性与完整性
- 跨越不同数据库, 领导者故障:故障转移, 保持系统同步, 从同一事件日志中派生多个视图, 派生数据与分布式事务
- 因果关系, 一致前缀读, 不同拓扑的问题, 排序事件以捕获因果关系
- 一致前缀读, 一致前缀读-一致前缀读
- 一致的快照, 设置新的副本, 快照隔离与可重复读-快照隔离、可重复读和命名混淆, 用于全局快照的同步时钟, 初始快照, 创建索引
- (另见 snapshots)
- 崩溃恢复, 使 B 树可靠
- enforcing constraints(见 constraints)
- 最终, 复制延迟的问题
- (另见 最终一致性)
- in ACID transactions, 一致性, 维护完整性,尽管软件有Bug
- 在 CAP 定理中, CAP 定理
- 领袖选举, 共识的微妙之处
- 微服务, 分布式系统的问题
- 线性一致性, 复制延迟的解决方案, 线性一致性-线性一致性与网络延迟
- 含义, 一致性
- 单调读, 单调读-单调读
- 二级指数, 多对象事务的需求, 索引与快照隔离, 理解数据流, 创建索引
- 读后写, 读己之写-读己之写
- 在衍生数据系统中, 派生数据与分布式事务
- strong(见 线性一致性)
- 及时性和完整性, 及时性与完整性
- 使用法定人数, 仲裁一致性的局限, 线性一致性与仲裁
- 连续的散列, 一致性哈希
- 一致前缀读, 一致前缀读
- 限制(数据库), 一致性, 写偏差的特征
- 领事(协调处), 协调服务
- 用于服务发现, 服务发现
- 消费者(信息流), 消息代理, 传递事件流
- content models (JSON Schema), JSON 模式
- 参数
- 事务之间, 处理错误和中止
- 屏蔽线程, 进程暂停
- 乐观并发控制的性能, 悲观并发控制与乐观并发控制
- 双相锁定, 两阶段锁定的性能
- 上下文开关, 延迟与响应时间, 进程暂停
- 收敛, 自动冲突解决-CRDT 与操作变换
- 协调
- 协调者, 两阶段提交(2PC)
- 复制写(B- 树), B 树变体, 索引与快照隔离
- 公共对象请求代理体系结构, 远程过程调用(RPC)的问题
- coronal mass ejection(见 solar storm)
- 正确性
- 数据腐败
- 余弦相似性(语义搜索), 向量嵌入
- Couchbase(数据库)
- 文档数据模型, 关系模型与文档模型
- 持久性, 全内存存储
- 散列变硬, 固定数量的分片
- 加入支持, 文档和关系数据库的融合
- 再平衡, 运维:自动/手动再平衡
- vBuckets(硬化), 分片
- CouchDB(数据库)
- 耦合(松紧), 可演化性:让变化更容易
- 覆盖索引, 在索引中存储值
- CozoDB(数据库), Datalog:递归关系查询
- CPUs
- 缓存一致性和内存障碍, 线性一致性与网络延迟
- 缓冲和管道, 查询执行:编译与向量化
- 计算错误的结果, 硬件与软件故障
- SIMD instructions, 查询执行:编译与向量化
- 断层和断层, 系统模型与现实
- CRDTs(见 conflict-free replicated datatypes)
- CREATE INDEX statement (SQL), 多列索引与二级索引, 创建索引
- 信用评级机构, 责任与问责
- 加密刷新, 事件溯源与 CQRS, 不变性的局限性
- 密码, 总结
- 密码学
- CSV (comma-separated values), OLTP 系统的存储与索引, JSON、XML 及其二进制变体
- Curator (ZooKeeper recipes), 锁定与领导者选举, 将工作分配给节点
- Cypher(查询语言), Cypher 查询语言
- comparison to SPARQL, SPARQL 查询语言
D
- Daft(处理框架)
- DataFrames, DataFrames
- 移动数据, 混洗数据
- Dagster(工作流调度器), 持久化执行与工作流, 批处理, 工作流调度
- 云数据仓集成, 查询语言
- 仪表板(业务情报), 事务处理与分析的特征
- Dask(处理框架), 数据框、矩阵与数组
- 数据目录, 云数据仓库
- 数据连接器, 数据仓库
- 数据合同, 提取-转换-加载(ETL)
- 数据变更捕获, 数据变更捕获与事件溯源
- data corruption(见 corruption of data)
- 数据方块, 物化视图与数据立方体
- 数据工程, 分析型与事务型系统
- 数据结构, 提取-转换-加载(ETL)
- data formats(见 编码)
- 数据基础设施, 数据系统架构中的权衡
- 数据集成, 数据集成-统一批处理和流处理, 本章小结
- 批量和流处理, 批处理与流处理-统一批处理和流处理
- 保持衍生状态, 维护派生状态
- 后处理数据, 应用演化后重新处理数据
- 统一, 统一批处理和流处理
- 通过解开数据库, 分拆数据库-多分区数据处理
- 与联邦数据库的比较, 一切的元数据库
- 通过生成数据合并工具, 组合使用派生数据的工具-排序事件以捕获因果关系
- 衍生数据与分布式事务, 派生数据与分布式事务
- 总订单的限制, 全序的限制
- 命令事件捕获因果关系, 排序事件以捕获因果关系
- 关于数据流的推理, 理解数据流
- 需求, 记录系统与派生数据
- 使用批量处理, 批处理, 提取-转换-加载(ETL)
- 批量和流处理, 批处理与流处理-统一批处理和流处理
- 数据湖, 从数据仓库到数据湖
- 数据湖区, 云数据仓库, 分析(Analytics)
- data locality(见 局部性)
- 数据网格, 提取-转换-加载(ETL)
- 数据最小化, 数据系统、法律与社会, 立法与自律
- 数据模型, 数据模型与查询语言-总结
- DataFrames and arrays, 数据框、矩阵与数组
- 类似图表的模型, 图数据模型-GraphQL
- 数据日志语言, Datalog:递归关系查询-Datalog:递归关系查询
- 属性图, 属性图
- RDF and triple-stores, 三元组存储与 SPARQL-SPARQL 查询语言
- 关系模型对文档模型, 关系模型与文档模型-文档和关系数据库的融合
- 支持多个, 事件溯源与 CQRS
- 数据管道, 从数据仓库到数据湖, 记录系统与派生数据, 提取-转换-加载(ETL)
- 数据产品, 超越数据湖
- data protection regulations(见 GDPR)
- 数据居住法, 分布式与单节点系统, 面向多租户的分片
- 数据科学, 分析型与事务型系统, 从数据仓库到数据湖
- 数据仓, 数据仓库
- 数据系统
- 数据存储, 数据仓库, 术语表
- 数据密集型应用, 数据系统架构中的权衡
- 数据库管理员, 云时代的运维
- 内部分布式事务, 跨不同系统的分布式事务, 数据库内部的分布式事务, 原子提交再现
- 数据库
- 归档存储, 归档存储
- 信件经纪人的比较, 消息代理与数据库的对比
- 数据流, 流经数据库的数据流
- 端到端参数, 端到端原则-在数据系统中应用端到端思考
- 检查完整性, 端到端原则重现
- 与事件流的关系, 数据库与流-不变性的局限性
- (另见 changelogs)
- 变更流的 API 支持, 变更流的 API 支持, 应用代码和状态的分离
- 数据变更捕获, 数据变更捕获-变更流的 API 支持
- 事件溯源, 数据变更捕获与事件溯源
- 保持系统同步, 保持系统同步-保持系统同步
- 不可改变事件哲学, 状态、流和不变性-不变性的局限性
- 分拆, 分拆数据库-多分区数据处理
- 数据中心
- 数据流动, 数据流的模式-分布式 actor 框架, 围绕数据流设计应用-流处理器和服务
- 数据流系统的正确性, 数据流系统的正确性
- 数据流引擎, 数据流引擎
- 与流处理的比较, 流处理
- DataFrames, DataFrames
- 批次处理框架中的支持, 批处理
- 事件驱动, 事件驱动的架构-分布式 actor 框架
- 关于, 理解数据流
- 通过数据库, 流经数据库的数据流
- 通过服务, 流经服务的数据流:REST 与 RPC-RPC 的数据编码与演化
- workflow engines(见 workflow engines)
- DataFrames, 数据框、矩阵与数组
- 执行, DataFrames
- 分批处理, DataFrames
- 在笔记本中, 机器学习
- 批次处理框架中的支持, 批处理
- DataFusion(查询引擎), 云数据仓库
- Datalog(查询语言), Datalog:递归关系查询-Datalog:递归关系查询
- 数据流(变化数据捕获), 变更流的 API 支持
- 数据类型
- binary strings in XML and JSON, JSON、XML 及其二进制变体
- 无冲突, CRDT 与操作变换
- 在 Avro 编码中, Avro
- 在协议缓冲中, 字段标签与模式演化
- numbers in XML and JSON, JSON、XML 及其二进制变体
- 日期和日期, 数据系统、法律与社会
- Datomic(数据库)
- B-树木存储, 索引与快照隔离
- 数据模型, 图数据模型, 三元组存储与 SPARQL
- 数据日志查询语言, Datalog:递归关系查询
- 切除, 不变性的局限性
- 事务语言, 存储过程的利弊
- 事务的序列执行, 实际串行执行
- Daylight Saving Time (DST), 日历时钟
- Db2(数据库)
- 数据变更捕获, 数据变更捕获的实现
- DBA (database administrator), 云时代的运维
- 僵局, 显式锁定
- Debezium(变化数据捕获), 数据变更捕获的实现
- 卡桑德拉岛, 变更流的 API 支持
- 数据整合, 分拆系统与集成系统
- 声明语言, 数据模型与查询语言, 术语表
- 并同步引擎, 同步引擎的利弊
- 数据日志, Datalog:递归关系查询
- 文档数据库中, 文档和关系数据库的融合
- recursive SQL queries, SQL 中的图查询
- SPARQL, SPARQL 查询语言
- DeepSeek
- 3FS(见 3FS)
- 延迟
- 删除数据, 不变性的局限性
- in LSM storage, 磁盘空间使用
- 法律依据, 数据系统、法律与社会
- Delta Lake(表格式), 构建和合并 SSTable, 云数据仓库
- 硬化和集群, 按哈希范围分片
- 非军事区(联网), 对外提供派生数据
- 非正常化(数据表示), 规范化、反规范化与连接-多对一与多对多关系, 术语表
- 在衍生数据系统中, 记录系统与派生数据
- in event sourcing/CQRS, 事件溯源与 CQRS
- 社会网络案例研究, 社交网络案例研究中的反规范化
- 实际意见, 物化视图与数据立方体
- 更新衍生数据, 单对象与多对象操作, 多对象事务的需求, 组合使用派生数据的工具
- 相对于正常化, 从同一事件日志中派生多个视图
- 衍生数据, 记录系统与派生数据, 流处理, 术语表
- 批处理, 批处理
- 事件溯源与 CQRS, 事件溯源与 CQRS
- 从变化数据抓取, 数据变更捕获的实现
- 通过日志维护导出状态, 数据库与流-变更流的 API 支持, 状态、流和不变性-并发控制
- 通过对流的订阅来观察, 端到端的事件流
- 批量和流处理的产出, 批处理与流处理
- 通过应用程序代码, 应用代码作为派生函数
- 相对于已分配事务, 派生数据与分布式事务
- 设计模式, 简单性:管理复杂度
- 决定性行动, 存储过程的利弊, 故障与部分失效, 术语表
- 确定性模拟测试(DST), 确定性模拟测试
- DevOps, 云时代的运维
- 维度表, 星型与雪花型:分析模式
- dimensional modeling(见 star schemas)
- directed acyclic graphs (DAG)
- 工作流程, 工作流调度
- (另见 workflow engines)
- 工作流程, 工作流调度
- 脏读, 没有脏读
- 脏字(事务隔离), 没有脏写
- 分类
- 存储和计算, 存储与计算的分离
- discord(分组聊天)
- GraphQL example, GraphQL
- 歧视, 偏见与歧视
- disks(见 hard disks)
- 分布式行为者框架, 分布式 actor 框架
- 分布式文件系统, 分布式文件系统-分布式文件系统
- 已分发分类账, 总结
- 分布式系统, 分布式系统的麻烦-总结, 术语表
- distributed transactions(见 transactions)
- Django(网络框架), 处理错误和中止
- DMZ (demilitarized zone), 对外提供派生数据
- DNS (Domain Name System), 请求路由, 服务发现
- 用于负载平衡, 负载均衡器、服务发现和服务网格
- Docker (集装箱管理器), 应用代码和状态的分离
- 文档数据模型, 关系模型与文档模型-文档和关系数据库的融合
- 比较关系模式, 何时使用哪种模型-文档和关系数据库的融合
- 多对象事务, 需要, 多对象事务的需求
- 硬化二级指数, 分片与二级索引
- 相对关系模式
- 模式的趋同, 文档和关系数据库的融合
- 数据位置, 读写的数据局部性
- document-partitioned indexes(见 local secondary indexes)
- 领域驱动设计, 简单性:管理复杂度, 事件溯源与 CQRS
- 点版向量, 版本向量
- 双重登录簿记, 总结
- DRBD (Distributed Replicated Block Device), 单主复制
- 漂移(小时), 时钟同步和准确性
- Druid(数据库), 事务处理与分析的特征, 列式存储, 从同一事件日志中派生多个视图
- 处理写入, 写入列式存储
- 预汇总, 分析(Analytics)
- 服务衍生数据, 对外提供派生数据
- Dryad(数据流引擎), 数据流引擎
- 双写、 问题, 保持系统同步
- DuckDB(数据库), 分布式系统的问题, 压实策略
- 面向列的存储, 列式存储
- 用于 ETL, 提取-转换-加载(ETL)
- 减少重复,消除, 抑制重复
- 持久性, 使 B 树可靠, 持久性, 术语表
- 持久执行, 持久化执行与工作流
- 依赖决定性因素, 确定性模拟测试
- Restate(见 Restate (workflow engine))
- Temporal(见 Temporal (workflow engine))
- durable functions(见 workflow engines)
- 时间(时间), 不可靠的时钟
- 用单音钟测量, 单调时钟
- 动态输入语言
- 类比于阅读时的图案, 文档模型中的模式灵活性
- Dynamo(数据库), 无主复制
- Dynamo-style databases(见 leaderless replication)
- DynamoDB(数据库)
- 自动缩放, 运维:自动/手动再平衡
- 散列变硬, 按哈希范围分片
- 基于领导者的复制, 单主复制
- 硬化二级指数, 全局二级索引
E
- EBS(虚拟块设备), 存储与计算的分离
- 比较对象存储, 设置新的副本
- ECC(见 error-correcting codes)
- EDB Postgres Distributed(数据库), 跨地域运行
- 边缘(图), 图数据模型
- 属性图模型, 属性图
- 编辑距离(全文搜索), 全文检索
- 有效即时语义, 容错, 恰好执行一次操作
- (另见 恰好一次语义)
- 维护完整性, 数据流系统的正确性
- Elastic Compute Cloud (EC2)
- 现场实例, 故障处理
- 弹性, 分布式与单节点系统
- 弹性搜索(搜索服务器)
- 精灵(编程语言), 端到端的事件流
- ELT (extract-load-transform), 数据仓库
- 与批量处理的关系, 提取-转换-加载(ETL)
- 严重平行(算法)
- 提取-转换-加载(ETL)(见 ETL)
- MapReduce, MapReduce
- (另见 MapReduce)
- 嵌入式存储引擎, 压实策略
- 嵌入(显示器), 向量嵌入
- 编码(数据格式), 编码与演化-模式的优点
- Avro, Avro-动态生成的模式
- binary variants of JSON and XML, 二进制编码
- 兼容性, 编码与演化
- 电话服务, RPC 的数据编码与演化
- 使用数据库, 流经数据库的数据流-归档存储
- 定义, 编码数据的格式
- JSON, XML, and CSV, JSON、XML 及其二进制变体
- 语言特定格式, 特定语言的格式
- 计划的价值, 模式的优点
- Protocol Buffers, Protocol Buffers-字段标签与模式演化
- 数据说明, 编码数据的格式
- 端到端原则, 端到端原则-在数据系统中应用端到端思考
- 浓缩(流), 流表连接(流扩充)
- Enterprise JavaBeans (EJB), 远程过程调用(RPC)的问题
- 企业软件, 数据系统架构中的权衡
- entities(见 vertices)
- 电子存储, 存储与计算的分离
- 时代(协商一致算法), 从单主复制到共识
- 时代(Unix 时间戳), 日历时钟
- 清除编码(错误校正), 分布式文件系统
- 错误处理
- 错误更正代码, 硬件与软件故障, 分布式文件系统
- Esper (CEP engine), 复合事件处理
- 基本复杂性, 简单性:管理复杂度
- 协调事务, 协调服务-服务发现
- 生成栅栏标志, 隔离僵尸进程和延迟请求, 协调服务
- 线性操作, 实现线性一致性系统, 共识的微妙之处
- 锁和领袖选举, 锁定与领导者选举
- 用于服务发现, 负载均衡器、服务发现和服务网格, 服务发现
- 用于硬性转让, 请求路由
- 使用 Raft 算法, 单主复制
- 伊特鲁姆(块链), 用于可审计数据系统的工具
- 以太网(网络), 云计算与超级计算, 不可靠的网络, 我们不能简单地使网络延迟可预测吗?
- 道德操守, 做正确的事情-立法与自律
- ETL, 数据仓库, 保持系统同步, 术语表
- 与批量处理的关系, 提取-转换-加载(ETL)-提取-转换-加载(ETL)
- 使用批量处理, 批处理
- 欧几利得距离(语义搜索), 向量嵌入
- European Union
- AI Act(见 AI Act)
- GDPR(见 GDPR)
- 事件溯源, 事件溯源与 CQRS-事件溯源与 CQRS
- 并更改数据捕获, 数据变更捕获与事件溯源
- 与变化数据捕获的比较, 数据变更捕获与事件溯源
- 不可更改性和可审计性, 状态、流和不变性, 为可审计性而设计
- 大型可靠数据系统, 操作标识符, 数据流系统的正确性
- 依赖决定性因素, 确定性模拟测试
- event streams(见 streams)
- 事件驱动的架构, 事件驱动的架构-分布式 actor 框架
- 分布式行为者框架, 分布式 actor 框架
- 事件, 传递事件流
- EventSource (browser API), 将状态变更推送给客户端
- EventStoreDB(数据库), 事件溯源与 CQRS
- 最终一致性, 复制, 复制延迟的问题, 安全性与活性
- 证据
- 数据用作, 人类与可靠性
- 可演化性, 可演化性:让变化更容易, 编码与演化
- 电话服务, RPC 的数据编码与演化
- 事件溯源, 事件溯源与 CQRS
- 图表结构数据, 属性图
- 数据库, 文档模型中的模式灵活性, 流经数据库的数据流-归档存储, 从同一事件日志中派生多个视图, 应用演化后重新处理数据
- 后处理数据, 应用演化后重新处理数据, 统一批处理和流处理
- Avro 的策略进化, 写入者模式与读取者模式
- 协议缓冲的策略演变, 字段标签与模式演化
- 阅读时的图谋, 文档模型中的模式灵活性, 编码与演化, 模式的优点
- 恰好一次语义, 恰好一次消息处理, 再谈恰好一次消息处理, 容错, 恰好执行一次操作
- 独占模式, 两阶段锁定的实现
- 指数备份, 描述性能, 处理错误和中止
- ext4 (file system), 分布式文件系统
- eXtended Architecture transactions(见 XA 事务)
- ETL(见 提取-转换-加载(ETL))
F
- 脸书
- 事实
- 事实表(星图), 星型与雪花型:分析模式
- 在数据日志中, Datalog:递归关系查询
- 如果来源, 事件溯源与 CQRS
- 慢故障, 系统模型与现实
- 失败停止模式, 系统模型与现实
- 故障切换, 领导者故障:故障转移, 术语表
- (另见 基于领导者的复制)
- 无领导复制,没有, 当节点故障时写入数据库
- 领袖选举, 分布式锁和租约, 共识, 从单主复制到共识
- 潜在问题, 领导者故障:故障转移
- 失败
- 费斯(媒介指数), 向量嵌入
- 假阳性(Bloom 过滤器), 布隆过滤器
- 扇出, 时间线的物化与更新, 多个消费者
- 断层注射, 容错, 实践中的网络故障, 故障注入
- 断层隔离, 面向多租户的分片
- 过失容忍, 可靠性与容错-人类与可靠性, 术语表
- 错误
- 特性工程(机器学习), 从数据仓库到数据湖
- 联邦数据库, 一切的元数据库
- Feldera(数据库)
- 增量视图维护, 维护物化视图
- 围栏, 线性一致性与网络延迟
- 屏障, 领导者故障:故障转移, 隔离僵尸进程和延迟请求-多副本隔离
- 获取和添加
- 与协商一致的关系, 获取并增加作为共识
- 纤维通道(网络), 分布式文件系统
- 字段标记(协议缓冲), Protocol Buffers-字段标签与模式演化
- Figma (图形软件), 实时协作、离线优先和本地优先应用
- filesystem in userspace (FUSE), 设置新的副本, 分布式文件系统
- 在对象存储中, 对象存储
- 财务数据
- 五特兰, 数据仓库
- FizzBee (specification language), 模型检查与规范语言
- 平面指数(媒介指数), 向量嵌入
- FlatBuffers(数据格式), 编码数据的格式
- Flink(处理框架), 批处理, 数据流引擎
- 流量控制, TCP 的局限性, 消息传递系统, 术语表
- FLP result (on consensus), 共识
- Flyte(工作流调度器), 机器学习
- 追随者, 单主复制, 术语表
- (另见 基于领导者的复制)
- 正式方法, 形式化方法和随机测试-确定性模拟测试
- 转发兼容性, 编码与演化
- 前进衰变(算法), 响应时间指标的应用
- 化石(版本控制系统), 并发控制
- 避免, 不变性的局限性
- FoundationDB(数据库)
- 一致性模式, 什么使系统具有线性一致性?
- 确定性模拟测试, 确定性模拟测试
- 键程硬化, 按键的范围分片
- 进程/核心模式, 分片的利与弊
- 可序列事务, 可串行化快照隔离(SSI), 可串行化快照隔离的性能
- 事务, 事务到底是什么?, 数据库内部的分布式事务
- 分数索引, 何时使用哪种模型
- 碎裂(B树), 磁盘空间使用
- 框架(计算机图形), 同步引擎的利弊
- 前端 (网页开发), 数据系统架构中的权衡
- FrostDB(数据库)
- 确定性模拟测试(DST), 确定性模拟测试
- fsync (系统调用), 使 B 树可靠, 持久性
- 全文检索, 全文检索, 术语表
- Function as a Service (FaaS), 微服务与无服务器
- 职能方案拟订
- inspiration for MapReduce, MapReduce
- 职能要求, 定义非功能性需求
- FUSE(见 filesystem in userspace (FUSE))
- 模糊, 形式化方法和随机测试
- fuzzy search(见 similarity search)
G
- Gallina(特写语言), 模型检查与规范语言
- 游戏开发, 同步引擎的利弊
- 垃圾收集
- 加油站算法定价, 反馈回路
- GDPR (regulation), 数据系统、法律与社会, 不变性的局限性
- GenBank (genome database), 总结
- General Data Protection Regulation(见 GDPR (regulation))
- 基因组分析, 总结
- geographic distribution(见 regions (geographic distribution))
- 地理空间指数, 多维索引与全文索引
- Git(版本控制系统), 并发控制
- 本地第一软件, 实时协作、离线优先和本地优先应用
- 合并冲突, 手动冲突解决
- GitHub, postmortems, 领导者故障:故障转移, 领导者故障:故障转移, 将系统模型映射到现实世界
- 全球二级指数, 全局二级索引, 总结
- globally unique identifiers(见 UUIDs)
- GlusterFS(分布式文件系统), 批处理, 分布式文件系统, 对象存储
- GNU Coreutils (Linux), 排序与内存聚合
- Go(编程语言)
- 垃圾收集, 限制垃圾回收的影响
- GoldenGate (change data capture), 数据变更捕获的实现
- (另见 Oracle)
- 谷歌
- BigQuery(见 BigQuery(数据库))
- Bigtable(见 Bigtable(数据库))
- Chubby(锁服务), 协调服务
- Cloud Storage(对象存储), 设置新的副本, 对象存储
- 请求先决条件, 隔离僵尸进程和延迟请求
- Compute Engine
- 预设实例, 故障处理
- 数据流(流程处理)
- 数据流(流处理器), 流分析, 原子提交再现, 统一批处理和流处理
- (另见 Beam)
- 数据流(变化数据捕获), 变更流的 API 支持
- Docs(协作编辑), 实时协作、离线优先和本地优先应用, CRDT 与操作变换
- 操作转换, CRDT 与操作变换
- Dremel(查询引擎), 列式存储
- Firestore(数据库), 同步引擎的利弊
- MapReduce (batch processing), 批处理
- (另见 MapReduce)
- Percolator(事务系统), 实现线性一致的 ID 生成器
- 持久性磁盘(云服务), 存储与计算的分离
- Pub/Sub(消息系统), 消息代理, 消息代理与数据库的对比, 使用日志进行消息存储
- 响应时间研究, 平均值、中位数与百分位点
- 工作表(协作电子表格), 实时协作、离线优先和本地优先应用, CRDT 与操作变换
- Spanner(见 Spanner(数据库))
- TrueTime (clock API), 带置信区间的时钟读数
- 流言协议, 请求路由
- 治理, 超越数据湖
- 政府对数据的使用, 数据作为资产与权力
- GPS (Global Positioning System)
- 用于时钟同步, 不可靠的时钟, 时钟同步和准确性, 带置信区间的时钟读数, 用于全局快照的同步时钟
- GPT (language model), 向量嵌入
- GPU (graphics processing unit), 云服务的分层, 分布式与单节点系统
- gradual rollout(见 rolling upgrades)
- GraphQL(查询语言), GraphQL
- 验证, 存储过程的利弊
- 图表, 术语表
- 作为数据模型, 图数据模型-GraphQL
- 属性图, 属性图
- RDF and triple-stores, 三元组存储与 SPARQL-SPARQL 查询语言
- DAGs(见 directed acyclic graphs)
- 处理和分析, 机器学习
- 查询语言
- 密码, Cypher 查询语言
- 数据日志, Datalog:递归关系查询-Datalog:递归关系查询
- GraphQL, GraphQL
- 格伦林, 图数据模型
- recursive SQL queries, SQL 中的图查询
- SPARQL, SPARQL 查询语言-SPARQL 查询语言
- 转弯, 属性图
- 作为数据模型, 图数据模型-GraphQL
- 灰色失败, 系统模型与现实
- 无领导复制, 单主与无主复制的性能
- 格勒姆林(图形查询语言), 图数据模型
- grep (Unix 工具) (英语)., 简单日志分析
- gRPC (service calls), 微服务与无服务器, Web 服务
- 前向和后向兼容性, RPC 的数据编码与演化
- GUIDs(见 UUIDs)
H
- Hadoop(数据基础设施)
- HANA(见 SAP HANA(数据库))
- 发生关系前, “先发生"关系与并发
- 硬盘
- 硬件故障, 硬件与软件故障
- 散列函数
- 在 Bloom 过滤器中, 布隆过滤器
- 加入散列
- 在溪流处理中, 流表连接(流扩充)
- 散列变硬, 按键的哈希分片-一致性哈希, 总结
- 散列表格, 日志结构存储
- Hazelcast(模拟数据网)
- FencedLock, 隔离僵尸进程和延迟请求
- Flake ID Generator, ID 生成器和逻辑时钟
- HBase(数据库)
- HDFS (Hadoop Distributed File System), 批处理, 分布式文件系统
- HdrHistogram (numerical library), 响应时间指标的应用
- 头 (Unix 工具), 简单日志分析, 分布式作业编排
- 头顶(财产图), 属性图
- 头部阻塞, 延迟与响应时间
- 堆积文件(数据库), 在索引中存储值
- 多转换并发控制, 多版本并发控制(MVCC)
- 热量管理, 偏斜的工作负载与缓解热点
- 被套期请求, 单主与无主复制的性能
- 分散事务, 跨不同系统的分布式事务, XA 事务的问题
- 启发式决策, 从协调器故障中恢复
- 十六进制(注解本), 机器学习
- 六边形
- 地理空间索引, 多维索引与全文索引
- Hibernate(对象关系映射器), 对象关系映射(ORM)
- 层次模型, 关系模型与文档模型
- 可导航的小世界(媒介指数), 向量嵌入
- hierarchical queries(见 recursive common table expressions)
- high availability(见 fault tolerance)
- 高频事务, 时钟同步和准确性
- high-performance computing (HPC), 云计算与超级计算
- 提示移交, 追赶错过的写入
- 直方图, 响应时间指标的应用
- 蜂窝(数据仓), 云数据仓库
- 查询优化器, 查询语言
- HNSW (vector index), 向量嵌入
- 购物窗口(流程处理), 窗口的类型
- (另见 windows)
- Hoptimator(查询引擎), 一切的元数据库
- 地平线丑闻, 人类与可靠性
- 缺乏事务, 事务
- horizontal scaling(见 scaling out)
- 通过磨损, 分片的利与弊
- HornetQ(消息系统), 消息代理, 消息代理与数据库的对比
- 分布式事务支持, XA 事务
- 热键, 键值数据的分片
- 热点, 键值数据的分片
- 由于名人, 偏斜的工作负载与缓解热点
- 时间序列数据, 按键的范围分片
- 解除武装, 偏斜的工作负载与缓解热点
- hot standbys(见 基于领导者的复制)
- HTAP(见 hybrid transactional/analytic processing)
- HTTP, use in APIs(见 services)
- 人类错误, 人类与可靠性, 实践中的网络故障, 批处理
- 混合逻辑时钟, 混合逻辑时钟
- 混合事务/分析处理, 数据仓库, 分析型数据存储
- hydrating IDs (join), 社交网络案例研究中的反规范化
- 高频图, 属性图
- HyperLogLog (algorithm), 流分析
I
- I/O operations, waiting for, 进程暂停
- IaaS(见 infrastructure as a service (IaaS))
- IBM
- Db2(数据库)
- 分布式事务支持, XA 事务
- 可序列隔离, 快照隔离、可重复读和命名混淆, 两阶段锁定的实现
- MQ(消息系统), 消息代理与数据库的对比
- 分布式事务支持, XA 事务
- System R(数据库), 事务到底是什么?
- WebSphere(消息系统), 消息代理
- Db2(数据库)
- Iceberg(表格式), 云数据仓库
- 幂等性, 远程过程调用(RPC)的问题, 幂等性, 术语表
- by giving operations unique IDs, 多分区请求处理
- by giving requests unique IDs, 操作标识符
- 对于完全的语义, 再谈恰好一次消息处理
- 一元业务, 恰好执行一次操作
- 工作流程引擎中, 持久化执行
- 不可改变性
- 好处, 不可变事件的优点, 为可审计性而设计
- 和清除的权利, 数据系统、法律与社会, 磁盘空间使用
- 删除加密, 事件溯源与 CQRS, 不变性的局限性
- 从事件日志中获取状态, 状态、流和不变性-不变性的局限性
- 事故恢复, 构建和合并 SSTable
- 在B树上, B 树变体, 索引与快照隔离
- 如果来源, 事件溯源与 CQRS, 数据变更捕获与事件溯源
- 限制, 并发控制
- 阻抗不匹配, 对象关系不匹配
- 存疑, 协调器故障
- 模拟数据库, 全内存存储
- 事件
- 导致错误定罪的会计软件错误, 人类与可靠性
- 无咎死后, 人类与可靠性
- 跳跃秒坠机, 时钟同步和准确性
- 数据腐败和货币错误造成的经济损失, 弱隔离级别
- 硬盘上的数据腐败, 持久性
- 数据损失,因最后写成, 用于事件排序的时间戳
- 磁盘上无法读取的数据, 将系统模型映射到现实世界
- 由于重用主钥匙而披露敏感数据, 领导者故障:故障转移
- 事务序列性中的错误, 维护完整性,尽管软件有Bug
- gigabit network interface with 1 Kb/s throughput, 系统模型与现实
- 跳跃第二次崩溃, 软件故障
- 网络断层, 实践中的网络故障
- 网络接口只放下入境包, 实践中的网络故障
- 网络分区和全数据中心故障, 故障与部分失效
- 网络故障处理不当, 实践中的网络故障
- 向前合伙人发送消息, 排序事件以捕获因果关系
- 咬海底电缆的鲨鱼, 实践中的网络故障
- split brain due to 1-minute packet delay, 领导者故障:故障转移, 实践中的网络故障
- SSD failure after 32,768 hours, 软件故障
- 线程争吵导致服务下降, 进程暂停
- 服务器架中的振动, 延迟与响应时间
- 违反独特性限制, 维护完整性,尽管软件有Bug
- incremental view maintenance (IVM), 维护物化视图
- 数据整合, 分拆系统与集成系统
- 索引, OLTP 系统的存储与索引, 术语表
- 并快照隔离, 索引与快照隔离
- 作为衍生数据, 记录系统与派生数据, 组合使用数据存储技术-分拆系统与集成系统
- B树, B 树-B 树变体
- 分组, 在索引中存储值
- comparison of B-trees and LSM-trees, 比较 B 树与 LSM 树-磁盘空间使用
- 覆盖(包括各栏), 在索引中存储值
- 创建, 创建索引
- 全文检索, 全文检索
- 地理空间, 多维索引与全文索引
- 索引范围锁定, 索引范围锁
- 多列(压缩), 多维索引与全文索引
- 中学, 多列索引与二级索引
- 硬化指数和二级指数, 分片与二级索引-全局二级索引, 总结
- 人烟稀少, SSTable 文件格式
- SSTable 与 LSM 树, SSTable 文件格式-压实策略
- 数据变化时更新, 保持系统同步, 维护物化视图
- Industrial Revolution, 回顾工业革命
- InfiniBand (networks), 我们不能简单地使网络延迟可预测吗?
- InfluxDB IOx (storage engine), 列式存储
- information retrieval(见 全文检索)
- infrastructure as a service (IaaS), 云服务与自托管, 云服务的分层
- InnoDB (storage engine)
- 实例(云计算), 云服务的分层
- integrating different data systems(见 数据集成)
- 诚信, 及时性与完整性
- Interface Definition Language (IDL), Protocol Buffers, Avro, Web 服务
- 不变式, 一致性
- (另见 constraints)
- 反向文件索引(向量索引), 向量嵌入
- 倒转索引, 全文检索
- 不可逆转,尽量减少, 可演化性:让变化更容易, 事件溯源与 CQRS, 批处理
- ISDN (Integrated Services Digital Network), 同步与异步网络
- 隔离性
- cgroups(见 cgroups)
- 隔离性, 隔离性, 单对象与多对象操作, 术语表
- 正确性和, 追求正确性
- 用于单对象写入, 单对象写入
- 可串行化, 可串行化-可串行化快照隔离的性能
- 实际执行, 实际串行执行-串行执行总结
- 可串行化快照隔离, 可串行化快照隔离(SSI)-可串行化快照隔离的性能
- 两阶段锁定, 两阶段锁定(2PL)-索引范围锁
- 违反, 单对象与多对象操作
- 薄弱的隔离水平, 弱隔离级别-物化冲突
- IVF (vector index), 向量嵌入
J
- 数据库连接
- Java Enterprise Edition (EE), 远程过程调用(RPC)的问题, 两阶段提交(2PC), XA 事务
- Java Message Service (JMS), 消息代理与数据库的对比
- (另见 messaging systems)
- 比较基于日志的邮件, 日志与传统的消息传递相比, 重播旧消息
- 分布式事务支持, XA 事务
- 消息顺序, 确认与重新传递
- Java Transaction API (JTA), 两阶段提交(2PC), XA 事务
- Java Virtual Machine (JVM)
- 垃圾收集, 进程暂停, 限制垃圾回收的影响
- JIT compilation, 查询执行:编译与向量化
- 批次处理器中的工艺再利用, 数据流引擎
- Jena (RDF framework), RDF 数据模型
- SPARQL 查询语言, SPARQL 查询语言
- Jepsen(过失容忍度测试), 故障注入, 追求正确性
- jitter (网络延迟), 平均值、中位数与百分位点, 网络拥塞和排队
- JMESPath(查询语言), 查询语言
- 合并表格, 多对一与多对多关系, 属性图
- 加入, 术语表
- 作为关系运算符表示, 查询语言
- handling GraphQL query, GraphQL
- 应用程序代码, 规范化、反规范化与连接, 社交网络案例研究中的反规范化
- in DataFrames, 数据框、矩阵与数组
- 关系数据库和文档数据库, 规范化、反规范化与连接
- 二级指数和, 多列索引与二级索引
- 排序合并, JOIN 与 GROUP BY
- 串流连接, 流连接-连接的时间依赖性
- 串流流连接, 流流连接(窗口连接)
- 串行表连接, 流表连接(流扩充)
- 表格连接, 表表连接(维护物化视图)
- 时间的依赖性, 连接的时间依赖性
- 文档数据库中的支持, 文档和关系数据库的融合
- JOTM (transaction coordinator), 两阶段提交(2PC)
- 日记(文件系统), 使 B 树可靠
- JSON
- 管道汇总(用克里语), 文档的查询语言
- Avro 方案说明, Avro
- 二进制变体, 二进制编码
- 数据位置, 读写的数据局部性
- 文档数据模型, 关系模型与文档模型
- 应用数据的问题, JSON、XML 及其二进制变体
- GraphQL response, GraphQL
- 关系数据库, 文档模型中的模式灵活性
- 代表简历(例), 用于一对多关系的文档数据模型
- 模式, JSON 模式
- JSON-LD, 三元组存储与 SPARQL
- JsonPath(查询语言), 查询语言
- JuiceFS(分布式文件系统), 分布式文件系统, 对象存储
- 朱皮特(注解本), 机器学习
- just-in-time (JIT) compilation, 查询执行:编译与向量化
K
- Kafka(消息系统), 消息代理, 使用日志进行消息存储
- 消费者群体, 多个消费者
- 数据整合, 分拆系统与集成系统
- 用于事件源代码, 事件溯源与 CQRS
- Kafka 连接(数据库整合), 数据变更捕获的实现, 变更流的 API 支持, 从同一事件日志中派生多个视图
- 卡夫卡流(流处理器), 流分析, 维护物化视图
- 恰好一次语义, 再谈恰好一次消息处理
- 过失容忍, 失败后重建状态
- ksqlDB (stream database), 维护物化视图
- 基于领导者的复制, 单主复制
- 日志压缩, 日志压缩, 维护物化视图
- 页:1, 使用日志进行消息存储, 幂等性
- 分区, 分片
- 请求路由, 请求路由
- 计划登记, 但什么是写入者模式?
- 服务衍生数据, 对外提供派生数据
- 分层存储, 磁盘空间使用
- 事务, 数据库内部的分布式事务, 原子提交再现
- 不洁领袖选举, 共识的微妙之处
- 使用模型检查, 模型检查与规范语言
- kappa 架构, 统一批处理和流处理
- 关键价值储存, OLTP 系统的存储与索引
- Kinesis(消息系统), 消息代理, 使用日志进行消息存储
- 数据仓集成, 云数据仓库
- Kryo (Java), 特定语言的格式
- ksqlDB (stream database), 维护物化视图
- Kubernetes(集群经理), 云服务与自托管, 微服务与无服务器, 分布式作业编排, 应用代码和状态的分离
- KùzuDB (database), 分布式系统的问题, 图数据模型
- 作为嵌入式存储引擎, 压实策略
- Cypher 查询语言, Cypher 查询语言
L
- labeled property graphs(见 property graphs)
- 羊肉达建筑, 统一批处理和流处理
- Lamport 时间戳, Lamport 时间戳
- Lance(数据格式), 云数据仓库, 列式存储
- (另见 column-oriented storage)
- large language models (LLMs)
- 预处理培训数据, 机器学习
- 最后写入胜利, 最后写入胜利(丢弃并发写入), 检测并发写入, 实现线性一致性系统
- 问题, 用于事件排序的时间戳
- 容易丢失更新, 冲突解决与复制
- 延迟, 延迟与响应时间
- (另见 响应时间)
- 跨区域, 分布式与单节点系统
- 在两阶段锁定下的不稳定, 两阶段锁定的性能
- 网络延迟和资源利用, 我们不能简单地使网络延迟可预测吗?
- 根据请求减少套期保值, 单主与无主复制的性能
- 响应时间对比, 延迟与响应时间
- 尾延迟, 平均值、中位数与百分位点, 响应时间指标的应用, 本地二级索引
- law(见 legal matters)
- (云服务), 云服务的分层
- 基于领导者的复制, 单主复制-逻辑(基于行)日志复制
- (另见 复制)
- 故障切换, 领导者故障:故障转移, 分布式锁和租约
- 处理节点断电, 处理节点故障
- 实施复制日志
- 数据变更捕获, 数据变更捕获-变更流的 API 支持
- (另见 changelogs)
- 基于语句的, 基于语句的复制
- 预写日志(WAL)传输, 预写日志(WAL)传输
- 数据变更捕获, 数据变更捕获-变更流的 API 支持
- 操作的可线性, 实现线性一致性系统
- 锁定和领导者选举, 锁定与领导者选举
- 日志序列号, 设置新的副本, 消费者偏移量
- 读缩放架构, 复制延迟的问题, 单主与无主复制的性能
- 与协商一致的关系, 共识, 从单主复制到共识, 共识的利弊
- 设立新的追随者, 设置新的副本
- 同步对同步, 同步复制与异步复制-同步复制与异步复制
- 无领导复制, 无主复制-版本向量
- 跳跃秒, 软件故障, 时钟同步和准确性
- 时钟, 日历时钟
- 租赁, 进程暂停
- 分类账(会计), 总结
- 不可改变性, 不可变事件的优点
- 遗留系统,维护, 可维护性
- 法律事项, 数据系统、法律与社会-数据系统、法律与社会
- 数据删除, 数据系统、法律与社会, 磁盘空间使用
- 数据存储, 分布式与单节点系统, 面向多租户的分片
- 隐私监管, 数据系统、法律与社会, 立法与自律
- legitimate interest (GDPR), 同意与选择自由
- 平面压缩, 压实策略, 磁盘空间使用
- Levenshtein 自动地图, 全文检索
- 跛脚(部分失败), 系统模型与现实
- 线性(项目管理软件), 实时协作、离线优先和本地优先应用
- 线性代数, 数据框、矩阵与数组
- 线性可缩放性, 描述负载
- 线性一致性, 复制延迟的解决方案, 线性一致性-线性一致性与网络延迟, 术语表
- 和共识, 共识
- 费用, 线性一致性的代价-线性一致性与网络延迟
- CAP定理, CAP 定理
- memory on multi-core CPUs, 线性一致性与网络延迟
- 定义, 什么使系统具有线性一致性?-什么使系统具有线性一致性?
- ID generation, 线性一致的 ID 生成器
- 协调事务, 协调服务
- 数据系统
- 避免协调, 无协调数据系统
- 不同复制方法, 实现线性一致性系统-线性一致性与仲裁
- 使用法定人数, 线性一致性与仲裁
- 在协商一致的制度中读取, 共识的微妙之处
- 依赖, 依赖线性一致性-跨通道时序依赖
- 可序列性, 什么使系统具有线性一致性?
- 链接数据, 三元组存储与 SPARQL
- LinkedIn
- Espresso(数据库), 但什么是写入者模式?
- LIquid(数据库), Datalog:递归关系查询
- 配置文件(例), 用于一对多关系的文档数据模型
- Linux 跳过第二个错误, 软件故障, 时钟同步和准确性
- Litestream (备份工具), 设置新的副本
- 生活属性, 安全性与活性
- LLVM (compiler), 查询执行:编译与向量化
- LMDB (storage engine), 压实策略, B 树变体, 索引与快照隔离
- 负载
- 负载平衡, 描述性能, 负载均衡器、服务发现和服务网格
- 硬件, 负载均衡器、服务发现和服务网格
- 软件, 负载均衡器、服务发现和服务网格
- 使用信件经纪人, 多个消费者
- 装弹, 描述性能
- 本地二级指数, 本地二级索引, 总结
- 本地第一软件, 实时协作、离线优先和本地优先应用
- 局部性, 用于一对多关系的文档数据模型, 读写的数据局部性, 术语表
- 分批处理, 数据流引擎
- 在状态客户端, 同步引擎与本地优先软件, 有状态、可离线的客户端
- 在溪流处理中, 流表连接(流扩充), 失败后重建状态, 流处理器和服务, 基于日志消息传递中的唯一性
- 地点透明度, 远程过程调用(RPC)的问题
- 在演员模式中, 分布式 actor 框架
- 锁定, 云服务的利弊
- 锁, 术语表
- 死锁, 显式锁定, 两阶段锁定的实现
- 分布式锁定, 分布式锁和租约-多副本隔离, 锁定与领导者选举
- 栅栏标志, 隔离僵尸进程和延迟请求
- 与协调处合作执行, 协调服务
- 与协商一致的关系, 单值共识
- 用于事务隔离
- 在快照隔离中, 多版本并发控制(MVCC)
- in two-phase locking (2PL), 两阶段锁定(2PL)-索引范围锁
- 使操作原子化, 原子写操作
- 性能, 两阶段锁定的性能
- 防止肮脏的写作, 实现读已提交
- 防止带有索引范围锁的幽灵, 索引范围锁, 检测影响先前读取的写入
- 读取锁(共享模式), 实现读已提交, 两阶段锁定的实现
- 共享模式和专属模式, 两阶段锁定的实现
- 分布式事务
- 实现冲突, 物化冲突
- 通过明确锁定防止丢失更新, 显式锁定
- 日志序列号, 设置新的副本, 消费者偏移量
- 逻辑时钟, 用于事件排序的时间戳, ID 生成器和逻辑时钟-使用逻辑时钟强制约束, 排序事件以捕获因果关系
- 最后写成的, 最后写入胜利(丢弃并发写入)
- 读后写入一致性, 读己之写
- 混合逻辑时钟, 混合逻辑时钟
- 执行制约因素不足, 使用逻辑时钟强制约束
- Lamport 时间戳, Lamport 时间戳
- 逻辑复制, 逻辑(基于行)日志复制
- 用于获取变化数据, 数据变更捕获的实现
- LogicBlox(数据库), Datalog:递归关系查询
- 日志(数据结构), OLTP 系统的存储与索引, 共享日志作为共识, 术语表
- (另见 shared logs)
- 不可改变性的好处, 不可变事件的优点
- 和清除的权利, 数据系统、法律与社会, 磁盘空间使用
- 压实(Compaction), 构建和合并 SSTable, 压实策略, 日志压缩, 状态、流和不变性
- 流运算符状态, 失败后重建状态
- 执行独特性限制, 基于日志消息传递中的唯一性
- 基于日志的信息, 基于日志的消息代理-重播旧消息
- 比较传统消息, 日志与传统的消息传递相比, 重播旧消息
- 减 减, 消费者偏移量
- 磁盘空间使用情况, 磁盘空间使用
- 重播旧信件, 重播旧消息, 应用演化后重新处理数据, 统一批处理和流处理
- 缓慢的消费者, 当消费者跟不上生产者时
- 使用日志存储信件, 使用日志进行消息存储
- 日志结构存储, OLTP 系统的存储与索引-压实策略
- log-structured merge tree(见 LSM-trees)
- 与协商一致的关系, 共享日志作为共识
- 复制, 单主复制, 复制日志的实现-逻辑(基于行)日志复制
- 数据变更捕获, 数据变更捕获-变更流的 API 支持
- (另见 changelogs)
- 与快照协调, 设置新的副本
- 逻辑(基于row) 复制, 逻辑(基于行)日志复制
- 基于语句的复制, 基于语句的复制
- 预写日志(WAL)传输, 预写日志(WAL)传输
- 数据变更捕获, 数据变更捕获-变更流的 API 支持
- 伸缩性限制, 全序的限制
- 浏览器(商业情报软件), 事务处理与分析的特征, 分析(Analytics)
- 松耦合, 开展分拆工作
- lost updates(见 updates)
- 莲花笔记(同步引擎), 同步引擎的利弊
- LSM-trees (indexes), SSTable 文件格式-压实策略
- 与B树的比较, 比较 B 树与 LSM 树-磁盘空间使用
- Lucene(存储引擎), 全文检索
- 相似性搜索, 全文检索
- 最后写入胜利(见 最后写入胜利)
M
- 机器学习
- 疯狂(决定性模拟测试), 确定性模拟测试
- 万金油, 可伸缩性原则
- 可维护性, 可维护性-可演化性:让变化更容易, 流式系统的哲学
- 可演化性(见 可演化性)
- 可操作性, 可运维性:让运维更轻松
- 简化和管理复杂性, 简单性:管理复杂度
- 多种关系, 多对一与多对多关系
- 模拟为图表, 图数据模型
- 多对一关系, 多对一与多对多关系
- 在恒星计时, 星型与雪花型:分析模式
- MapReduce (batch processing), 批处理, MapReduce-MapReduce
- 用户活动活动分析(实例), JOIN 与 GROUP BY
- 与流处理的比较, 流处理
- 不利条件和限制, MapReduce
- 过失容忍, 故障处理
- 高级工具, 查询语言
- 映射和缩小函数, MapReduce
- 移动数据, 混洗数据
- 排序合并, JOIN 与 GROUP BY
- 工作流程, 工作流调度
- (另见 workflow engines)
- 编组(见 编码)
- MartenDB(数据库), 事件溯源与 CQRS
- 主奴隶复制(过时术语), 单主复制
- 物化, 术语表
- 总价值, 物化视图与数据立方体
- 冲突, 物化冲突
- 实际意见, 物化视图与数据立方体
- 作为衍生数据, 记录系统与派生数据, 组合使用数据存储技术-分拆系统与集成系统
- 如果来源, 事件溯源与 CQRS
- 增量视图维护, 维护物化视图
- (另见 incremental view maintenance (IVM))
- 维护,使用流处理, 维护物化视图, 表表连接(维护物化视图)
- 社会网络时间表实例, 时间线的物化与更新
- 物化, 物化视图与数据立方体
- 增量视图维护, 维护物化视图
- 矩阵, 数据框、矩阵与数组
- 人烟稀少, 数据框、矩阵与数组
- Maxwell(变化数据捕获), 数据变更捕获的实现
- 说, 平均值、中位数与百分位点
- 媒体监测, 在流上搜索
- 中位数, 平均值、中位数与百分位点
- 会议室预订(例), 写偏差的更多例子, 谓词锁, 强制约束
- 调试(调试服务器), 全内存存储
- Memgraph(数据库), 图数据模型
- Cypher 查询语言, Cypher 查询语言
- 内存
- 壁障, 线性一致性与网络延迟
- 腐败, 硬件与软件故障
- 模拟数据库, 全内存存储
- 数据模拟表示, 编码数据的格式
- 内存表, 构建和合并 SSTable
- 随机比特- flips in, 信任但验证
- 索引的使用, 日志结构存储
- 内存表, 构建和合并 SSTable
- 商品(版本控制系统), 并发控制
- 合并, 数据框、矩阵与数组
- 合并排序的文件, 构建和合并 SSTable, 混洗数据
- 默克尔树, 用于可审计数据系统的工具
- Mesos(分组管理器), 应用代码和状态的分离
- message brokers(见 messaging systems)
- message-passing(见 event-driven architecture)
- MessagePack (encoding format), 二进制编码
- 通讯系统, 流处理-重播旧消息
- (另见 streams)
- 后压、缓冲或丢弃信件, 消息传递系统
- 无中介消息, 直接从生产者传递给消费者
- 事件日志, 基于日志的消息代理-重播旧消息
- 作为数据模型, 事件溯源与 CQRS
- 比较传统消息, 日志与传统的消息传递相比, 重播旧消息
- 减 减, 消费者偏移量
- 重播旧信件, 重播旧消息, 应用演化后重新处理数据, 统一批处理和流处理
- 缓慢的消费者, 当消费者跟不上生产者时
- 恰好一次语义, 恰好一次消息处理, 再谈恰好一次消息处理, 容错
- 信件经纪人, 消息代理-确认与重新传递
- 承认和重新交付, 确认与重新传递
- 比较事件日志, 日志与传统的消息传递相比, 重播旧消息
- 同一主题的多个消费者, 多个消费者
- versus RPC, 事件驱动的架构
- 消息丢失, 消息传递系统
- 可靠性, 消息传递系统
- 以日志为基础的信件中的独特性, 基于日志消息传递中的唯一性
- 可调味的失败, 描述性能
- 计票
- 微批次, 微批次与存档点
- 微服务, 微服务与无服务器
- 微软
- Azure Blob Storage(见 Azure Blob Storage)
- Azure managed disks, 存储与计算的分离
- Azure Service Bus(消息系统), 消息代理, 消息代理与数据库的对比
- Azure SQL DB(数据库), 云原生系统架构
- Azure Storage, 对象存储
- Azure Stream Analytics, 流分析
- Azure Synapse Analytics(数据库), 云原生系统架构
- 分布式组件对象模型, 远程过程调用(RPC)的问题
- MSDTC (transaction coordinator), 两阶段提交(2PC)
- SQL Server(见 SQL Server)
- Microsoft Power BI(见 Power BI (business intelligence software))
- 迁移(重写)数据, 文档模型中的模式灵活性, 不同时间写入的不同值, 从同一事件日志中派生多个视图, 应用演化后重新处理数据
- MinIO(对象存储), 分布式文件系统
- 移动应用程序, 数据系统架构中的权衡
- 嵌入式数据库, 压实策略
- 模式检查, 模型检查与规范语言
- 模块操作员(%), 哈希取模节点数
- Mojo(编程语言)
- 内存管理, 限制垃圾回收的影响
- MongoDB(数据库)
- 管道合计, 文档的查询语言
- 原子操作, 原子写操作
- BSON, 读写的数据局部性
- 文档数据模型, 关系模型与文档模型
- 散列变硬, 按键的哈希分片, 按哈希范围分片
- 在云层中, 云原生系统架构
- 加入支持, 文档和关系数据库的融合
- 加入($$ookup 运算符), 规范化、反规范化与连接
- JSON Schema validation, JSON 模式
- 基于领导者的复制, 单主复制
- ObjectIds, ID 生成器和逻辑时钟
- 基于范围的硬化, 按键的范围分片
- 请求路由, 请求路由
- 二级指数, 本地二级索引
- 硬分裂, 再平衡键范围分片数据
- 存储程序, 存储过程的利弊
- 监测, 云时代的运维, 人类与可靠性, 可运维性:让运维更轻松
- 单音钟, 单调时钟
- 单调读, 单调读
- Morel(查询语言), 查询语言
- MSMQ(消息系统), XA 事务
- 多列索引, 多维索引与全文索引
- 多领导复制, 多主复制-处理写入冲突
- (另见 复制)
- 协作编辑, 实时协作、离线优先和本地优先应用
- 冲突检测, 处理写入冲突
- 解决冲突, 处理写入冲突
- 供多区域复制, 跨地域运行, 线性一致性的代价
- 线性,缺少, 实现线性一致性系统
- 可脱机客户端, 同步引擎与本地优先软件
- 复制地形, 多主复制拓扑-不同拓扑的问题
- 多对象事务, 单对象与多对象操作
- 需求, 多对象事务的需求
- Multi-Paxos (consensus algorithm), 共识的实践
- 多读单写锁定, 两阶段锁定的实现
- 多表索引集群表, 读写的数据局部性
- 多版本并发控制, 多版本并发控制(MVCC), 总结
- detecting stale MVCC reads, 检测陈旧的 MVCC 读取
- 索引和快照隔离, 索引与快照隔离
- 使用同步时钟, 用于全局快照的同步时钟
- 多层面阵列, 数据框、矩阵与数组
- 多重租赁, 存储与计算的分离, 网络拥塞和排队
- 相互排斥, 悲观并发控制与乐观并发控制
- (另见 locks)
- MySQL(数据库)
- archiving WAL to object stores, 设置新的副本
- 二进制日志坐标, 设置新的副本
- 数据变更捕获, 数据变更捕获的实现, 变更流的 API 支持
- 循环复制地形, 多主复制拓扑
- 一致的快照, 设置新的副本
- 分布式事务支持, XA 事务
- global transaction identifiers (GTIDs), 设置新的副本
- 在云层中, 云原生系统架构
- InnoDB storage engine(见 InnoDB)
- 基于领导者的复制, 单主复制
- 多领导复制, 跨地域运行
- 基于行的复制, 逻辑(基于行)日志复制
- 分片(见 Vitess(数据库))
- 快速隔离支持, 快照隔离、可重复读和命名混淆
- (另见 InnoDB)
- 基于语句的复制, 基于语句的复制
N
- N+1 query problem, 对象关系映射(ORM)
- 纳米msg(信息库), 直接从生产者传递给消费者
- Narayana(事务协调员), 两阶段提交(2PC)
- NATS(消息系统), 消息代理
- 自然语言处理, 从数据仓库到数据湖
- Neo4j(数据库)
- Cypher 查询语言, Cypher 查询语言
- 图表数据模型, 图数据模型
- Neon(数据库), 设置新的副本
- 侄子(数据流引擎), 数据流引擎
- Neptune(图数据库), 图数据模型
- Cypher 查询语言, Cypher 查询语言
- SPARQL 查询语言, SPARQL 查询语言
- 网码(游戏开发), 同步引擎的利弊
- Network Attached Storage (NAS), 共享内存、共享磁盘与无共享架构, 分布式文件系统
- 网络模型(数据表示), 关系模型与文档模型
- Network Time Protocol(见 网络时间协议)
- 网络
- NewSQL, 关系模型与文档模型, 复制延迟的解决方案
- 事务和, 事务到底是什么?, 数据库内部的分布式事务
- 下键锁定, 索引范围锁
- NFS (network file system), 分布式文件系统
- 在对象存储中, 对象存储
- Nimble(数据格式), 云数据仓库, 列式存储
- (另见 column-oriented storage)
- node (in graphs)(见 vertices)
- 节点(进程), 分布式与单节点系统, 术语表
- 吵闹的邻居, 网络拥塞和排队
- 原子承诺, 三阶段提交
- 非决定性操作, 基于语句的复制
- 不起作用的要求, 定义非功能性需求, 总结
- 不可重复读作, 快照隔离与可重复读
- (另见 读取偏差)
- 规范化, 规范化、反规范化与连接-多对一与多对多关系, 术语表
- 外国关键参考文献, 多对象事务的需求
- 社会网络案例研究, 社交网络案例研究中的反规范化
- 在记录系统中, 记录系统与派生数据
- 相对于非正常化, 从同一事件日志中派生多个视图
- NoSQL, 关系模型与文档模型, 复制延迟的解决方案, 分拆数据库
- 事务和, 事务到底是什么?
- Notation3 (N3), 三元组存储与 SPARQL
- 网络时间协议, 不可靠的时钟
- 准确性, 时钟同步和准确性, 用于事件排序的时间戳
- 对单音钟的调整, 单调时钟
- 多个服务器地址, 弱形式的谎言
- XML 与 JSON 编码中的数字, JSON、XML 及其二进制变体
- NumPy (Python library), 数据框、矩阵与数组, 列式存储
- NVMe (Non-Volatile Memory Express)(见 solid state drives (SSDs))
O
- 对象数据库, 关系模型与文档模型
- 对象存储, 云服务的分层, 对象存储-对象存储
- 对象关系映射(ORM)框架, 对象关系映射(ORM)
- 对象关系不匹配, 对象关系不匹配
- 可观察性, 分布式系统的问题, 人类与可靠性, 可运维性:让运维更轻松
- 观察员模式, 应用代码和状态的分离
- OBT (one big table), 星型与雪花型:分析模式, 星型与雪花型:分析模式
- 离线系统, 批处理
- (另见 batch processing)
- 离线第一应用程序, 实时协作、离线优先和本地优先应用, 有状态、可离线的客户端
- 页:1
- 加工过的原木中的消费者抵消额, 消费者偏移量
- 已磨损日志中的消息, 使用日志进行消息存储
- OLAP, 事务处理与分析的特征, 术语表
- 数据方块, 物化视图与数据立方体
- OLTP, 事务处理与分析的特征, 术语表
- 分析查询与, 分析(Analytics)
- 数据正常化, 规范化的权衡
- 工作量特点, 实际串行执行
- 现场部署, 云服务与自托管
- 数据仓库, 云数据仓库
- 一个大表格(数据仓计划), 星型与雪花型:分析模式, 星型与雪花型:分析模式
- 单热编码, 数据框、矩阵与数组
- 一对夫妇关系, 用于一对多关系的文档数据模型
- 一对多种关系, 用于一对多关系的文档数据模型
- JSON representation, 用于一对多关系的文档数据模型
- 在线系统, 批处理
- (另见 services)
- 相对于科学计算, 云计算与超级计算
- 肿瘤, 三元组存储与 SPARQL
- Oozie(工作流调度器), 批处理
- OpenAPI (service definition format), 微服务与无服务器, Web 服务, Web 服务
- use of JSON Schema, JSON 模式
- openCypher(见 Cypher(查询语言))
- OpenLink Virtuoso(见 Virtuoso(数据库))
- OpenStack
- Swift(对象存储), 对象存储
- 可操作性, 可运维性:让运维更轻松
- 操作系统与数据库, 分拆数据库
- 业务系统, 分析型与事务型系统
- 操作转换, CRDT 与操作变换
- 行动组, 云时代的运维
- 算子, 查询执行:编译与向量化
- 在溪流处理中, 流处理
- 乐观并发控制, 悲观并发控制与乐观并发控制
- 乐观锁定, 条件写入(比较并设置)
- Oracle(数据库)
- 分布式事务支持, XA 事务
- GoldenGate (change data capture), 数据变更捕获的实现
- 等级查询, SQL 中的图查询, SQL 中的图查询
- 缺乏序列性, 隔离性
- 基于领导者的复制, 单主复制
- 多领导复制, 跨地域运行
- 多表索引集群表, 读写的数据局部性
- 无法阻止写入 skew, 写偏差的特征
- PL/SQL language, 存储过程的利弊
- 防止丢失更新, 自动检测丢失的更新
- 读作承诺隔离, 实现读已提交
- Real Application Clusters (RAC), 锁定与领导者选举
- 快速隔离支持, 快照隔离与可重复读, 快照隔离、可重复读和命名混淆
- TimesTen (in-memory database), 全内存存储
- WAL-based replication, 预写日志(WAL)传输
- ORC(数据格式), 云数据仓库, 列式存储
- (另见 column-oriented storage)
- 协调(服务部署), 云服务与自托管, 微服务与无服务器
- 顺序
- 事件日志, 事件溯源与 CQRS
- 总订单的限制, 全序的限制
- 逻辑时间戳, 逻辑时钟
- of auto-incrementing IDs, ID 生成器和逻辑时钟
- 共享日志, 共识的实践-共识的利弊
- Orkes(工作流程引擎), 持久化执行与工作流
- 孤儿页面(B- 树), 使 B 树可靠
- 发件箱图案, 数据变更捕获与事件溯源
- 异常值(响应时间), 平均值、中位数与百分位点
- 外包, 云服务与自托管
- 超载, 描述性能, 处理错误和中止
P
- PACELC principle, CAP 定理
- 软件包管理器, 应用代码和状态的分离
- 包切换, 我们不能简单地使网络延迟可预测吗?
- 数据包
- 腐败, 弱形式的谎言
- sending via UDP, 直接从生产者传递给消费者
- PageRank (algorithm), 图数据模型, 查询语言, 机器学习
- paging(见 virtual memory)
- 大熊猫(蟒蛇图书馆), 从数据仓库到数据湖, 数据框、矩阵与数组, 列式存储, DataFrames
- Parquet(数据格式), 云数据仓库, 列式存储, 归档存储, 查询语言
- 部分失败, 故障与部分失效, 总结
- 跛脚, 系统模型与现实
- 部分同步(系统模型), 系统模型与现实
- 分区键, 分片的利与弊, 键值数据的分片
- 分区(见 分片)
- Paxos(协商一致算法), 共识, 共识的实践
- payment card industry (PCI), 数据系统、法律与社会
- PCI (payment card industry) compliance, 数据系统、法律与社会
- 百分位点, 平均值、中位数与百分位点, 术语表
- Percolator (Google), 实现线性一致的 ID 生成器
- Percona XtraBackup (MySQL tool), 设置新的副本
- 性能
- 作为过失的降解, 系统模型与现实
- 描述, 描述性能
- 分布式事务, 跨不同系统的分布式事务
- 内存数据库, 全内存存储
- 线性, 线性一致性与网络延迟
- 多领导者复制, 跨地域运行
- 权限隔离, 面向多租户的分片
- 永久不一致, 及时性与完整性
- 悲观并发控制, 悲观并发控制与乐观并发控制
- pglogical (PostgreSQL extension), 跨地域运行
- pgvector (矢量指数), 向量嵌入
- 幻读, 导致写偏差的幻读
- physical clocks(见 clocks)
- pick菜(蟒鱼), 特定语言的格式
- Pinot(数据库), 事务处理与分析的特征, 列式存储
- 处理写入, 写入列式存储
- 预汇总, 分析(Analytics)
- 服务衍生数据, 对外提供派生数据, 对外提供派生数据
- 编审中的执行
- 数据仓查询, 查询执行:编译与向量化
- 枢轴表, 数据框、矩阵与数组
- 时间点, 不可靠的时钟
- 点查询, 事务处理与分析的特征
- 极地(数据目录), 云数据仓库
- 投票, 表示用户、帖子与关注关系
- 多边存储器, 一切的元数据库
- POSIX (portable operating system interface)
- 邮政局地平线丑闻, 人类与可靠性
- 缺乏事务, 事务
- PostgreSQL(数据库)
- archiving WAL to object stores, 设置新的副本
- 数据变更捕获, 数据变更捕获的实现, 变更流的 API 支持
- 分布式事务支持, XA 事务
- 外国数据包, 一切的元数据库
- 全文搜索支持, 组合使用派生数据的工具
- 在云层中, 云原生系统架构
- JSON Schema validation, JSON 模式
- 基于领导者的复制, 单主复制
- 日志序列号, 设置新的副本
- 逻辑解码, 逻辑(基于行)日志复制
- 实现视图维护, 维护物化视图
- 多领导复制, 跨地域运行
- MVCC implementation, 多版本并发控制(MVCC), 索引与快照隔离
- 分割对硬化, 分片
- pgvector (矢量指数), 向量嵌入
- PL/pgSQL language, 存储过程的利弊
- PostGIS geospatial indexes, 多维索引与全文索引
- 防止丢失更新, 自动检测丢失的更新
- 防止写入skew, 写偏差的特征, 可串行化快照隔离(SSI)
- 读作承诺隔离, 实现读已提交
- 表示图表, 属性图
- 可串行化快照隔离, 可串行化快照隔离(SSI)
- 分片(见 Citus(数据库))
- 快速隔离支持, 快照隔离与可重复读, 快照隔离、可重复读和命名混淆
- WAL-based replication, 预写日志(WAL)传输
- 倒排列表, 全文检索
- 在硬化指数中, 本地二级索引
- 死后无咎, 人类与可靠性
- PouchDB(数据库), 同步引擎的利弊
- Power BI (business intelligence software), 事务处理与分析的特征, 分析(Analytics)
- 预汇总, 分析(Analytics)
- 服务衍生数据, 对外提供派生数据
- 分享前, 再平衡键范围分片数据
- Precision Time Protocol (PTP), 时钟同步和准确性
- 上游锁定, 谓词锁
- 预测分析, 分析型与事务型系统, 预测分析-反馈回路
- 预设, 资源分配
- Prefect(工作流调度器), 持久化执行与工作流, 批处理, 工作流调度
- 云数据仓集成, 查询语言
- Presto(查询引擎), 云数据仓库
- 主密钥, 多列索引与二级索引, 术语表
- 自动递增, ID 生成器和逻辑时钟
- 对分区键, 按哈希范围分片
- primary-backup replication(见 基于领导者的复制)
- 隐私, 隐私与追踪-立法与自律
- 概率算法, 响应时间指标的应用, 流分析
- 进程暂停, 进程暂停-限制垃圾回收的影响
- 处理时间(事件), 时间推理
- 生产者(信息流), 传递事件流
- 产品分析, 事务处理与分析的特征
- 面向列的存储, 列式存储
- 编程语言
- 用于储存程序, 存储过程的利弊
- 预测(活动来源), 事件溯源与 CQRS
- Prolog(语言), Datalog:递归关系查询
- (另见 Datalog)
- 属性图, 属性图
- Cypher 查询语言, Cypher 查询语言
- Property Graph Query Language (PGQL), SQL 中的图查询
- 基于属性的测试, 人类与可靠性, 形式化方法和随机测试
- Protocol Buffers(数据格式), Protocol Buffers-字段标签与模式演化, Protocol Buffers
- 字段标记和计划演变, 字段标签与模式演化
- 数据来源, 为可审计性而设计
- 发布/订阅模式, 消息传递系统
- 出版社(信息流), 传递事件流
- Pulsar (流线平台), 确认与重新传递
- PyTorch (machine learning library), 机器学习
Q
- Qpid(消息系统), 消息代理与数据库的对比
- quality of service (QoS), 我们不能简单地使网络延迟可预测吗?
- Quantcast File System(分布式文件系统), 对象存储
- 查询引擎
- 汇编和矢量化, 查询执行:编译与向量化
- 在云数据仓库中, 云数据仓库
- 算子, 查询执行:编译与向量化
- 优化申报查询, 数据模型与查询语言
- 查询语言
- 密码, Cypher 查询语言
- 数据日志, Datalog:递归关系查询
- GraphQL, GraphQL
- MongoDB aggregation pipeline, 规范化、反规范化与连接, 文档的查询语言
- recursive SQL queries, SQL 中的图查询
- SPARQL, SPARQL 查询语言
- SQL, 规范化、反规范化与连接
- 查询优化器, 查询语言
- 查询计划, 查询执行:编译与向量化
- 排队延迟, 网络拥塞和排队
- 队列(消息), 消息代理
- QUIC (protocol), TCP 的局限性
- 法定人数, 读写仲裁-多地区操作, 术语表
- 配额, 云时代的运维
R
- R(语言), 从数据仓库到数据湖, 数据框、矩阵与数组, DataFrames
- R树(指数), 多维索引与全文索引
- R2(对象存储), 云服务的分层, 分布式文件系统
- RabbitMQ(消息系统), 消息代理, 消息代理与数据库的对比
- 法定人数队列(复制), 单主复制
- 种族条件, 隔离性
- Raft(协商一致算法), 共识, 共识的实践
- RAID (Redundant Array of Independent Disks), 存储与计算的分离, 通过冗余容忍硬件故障, 分布式文件系统
- 铁路,计划迁移, 应用演化后重新处理数据
- RAM(见 memory)
- RAMCloud (in-memory storage), 全内存存储
- 随机写入(访问模式), 顺序与随机写入
- 区域查询
- 排名算法, 机器学习
- Ray(工作流调度器), 机器学习
- RDF (Resource Description Framework), RDF 数据模型
- querying with SPARQL, SPARQL 查询语言
- 远程直接内存访问, 云服务的分层, 云计算与超级计算
- 反应(用户界面库), 端到端的事件流
- 被动方案拟订, 同步引擎的利弊
- 读取承诺隔离级别, 读已提交-实现读已提交
- 执行, 实现读已提交
- 多版本并发控制, 多版本并发控制(MVCC)
- 没有脏读, 没有脏读
- 没有污秽的文字, 没有脏写
- 读取模型(活动来源), 事件溯源与 CQRS
- 读路径, 观察派生数据状态
- (无铅复制), 追赶错过的写入
- 线性, 线性一致性与仲裁
- 只读副本(见 基于领导者的复制)
- 读取偏差, 快照隔离与可重复读, 总结
- 读取未承诺的隔离级别, 实现读已提交
- 写后读一致性, 读己之写, 及时性与完整性
- 交叉设备, 读己之写
- 在衍生数据系统中, 派生数据与分布式事务
- 读 - 修改 - 写入周期, 防止丢失更新
- 读缩放架构, 复制延迟的问题, 单主与无主复制的性能
- 与磨损, 分片的利与弊
- 读作事件, 读也是事件
- 实时
- analytics(见 product analytics)
- 协作编辑, 实时协作、离线优先和本地优先应用
- 发布/订阅数据流, 端到端的事件流
- 响应时间保障, 响应时间保证
- 每日时钟, 日历时钟
- Realm(数据库), 同步引擎的利弊
- 再平衡困难, 再平衡键范围分片数据-运维:自动/手动再平衡, 术语表
- (另见 分片)
- 自动或人工再平衡, 运维:自动/手动再平衡
- 固定块数, 固定数量的分片
- 每个节点的固定硬度数, 按哈希范围分片
- Hash mod N的问题, 哈希取模节点数
- 新鲜度保证, 线性一致性
- 建议引擎, 分析型与事务型系统
- 重组(协商一致), 共识的微妙之处
- 记录, MapReduce
- 流处理中的事件, 传递事件流
- 递归查询
- 在密钥中, Cypher 查询语言
- 在数据日志中, Datalog:递归关系查询
- in SPARQL, SPARQL 查询语言
- lack of, in GraphQL, GraphQL
- SQL common table expressions, SQL 中的图查询
- Red Hat
- Apicurio Registry, JSON 模式
- 红黑树, 构建和合并 SSTable
- 重新交付(通讯), 确认与重新传递
- Redis(数据库)
- redo log(见 write-ahead log)
- Redpanda(消息系统), 消息代理, 设置新的副本
- 分层存储, 磁盘空间使用
- Redshift(数据库), 云数据仓库
- 冗余
- 硬件组件, 通过冗余容忍硬件故障
- 生成数据, 记录系统与派生数据
- (另见 衍生数据)
- Reed–Solomon codes (error correction), 分布式文件系统
- 重构, 可演化性:让变化更容易
- (另见 可演化性)
- (地理分布), 读己之写
- 区域(硬化), 分片
- 寄存器, 什么使系统具有线性一致性?
- regulation(见 legal matters)
- 关系数据模型, 从数据仓库到数据湖, 关系模型与文档模型-文档和关系数据库的融合
- 与文件模型的比较, 何时使用哪种模型-文档和关系数据库的融合
- graph queries in SQL, SQL 中的图查询
- 模拟数据库, 全内存存储
- 多对多对多的关系, 多对一与多对多关系
- 多对象事务, 需要, 多对象事务的需求
- 对象关系不匹配, 对象关系不匹配
- 代表可重排列表, 何时使用哪种模型
- 对文档模式
- 模式的趋同, 文档和关系数据库的融合
- 数据位置, 读写的数据局部性
- 关系数据库
- 最终一致性, 复制延迟的问题
- 历史, 关系模型与文档模型
- 基于领导者的复制, 单主复制
- 逻辑日志, 逻辑(基于行)日志复制
- 哲学比Unix, 分拆数据库, 一切的元数据库
- 方案变化, 文档模型中的模式灵活性, 编码与演化, 不同时间写入的不同值
- 硬化二级指数, 分片与二级索引
- 基于语句的复制, 基于语句的复制
- B树指数的使用, B 树
- relationships(见 edges)
- 可靠性, 可靠性与容错-人类与可靠性, 流式系统的哲学
- Remote Method Invocation (Java RMI), 远程过程调用(RPC)的问题
- remote procedure calls (RPCs), 远程过程调用(RPC)的问题-RPC 的数据编码与演化
- (另见 services)
- 数据编码和演化, RPC 的数据编码与演化
- 问题, 远程过程调用(RPC)的问题
- 使用 Avro, 但什么是写入者模式?
- 对信件经纪人, 事件驱动的架构
- 可再生能源, 分布式与单节点系统
- 可重复读(切换隔离), 快照隔离、可重复读和命名混淆
- 复制品, 单主复制
- 复制, 复制-总结, 术语表
- 持久性, 持久性
- 解决冲突, 冲突解决与复制
- 一致性属性, 复制延迟的问题-复制延迟的解决方案
- 在分布式文件系统中, 分布式文件系统
- 无主(无领导者), 无主复制-版本向量
- 监测停滞情况, 监控陈旧性
- 多领导者, 多主复制-处理写入冲突
- 使用原因, 分布式与单节点系统, 复制
- 硬化和, 分片
- 单人领导, 单主复制-逻辑(基于行)日志复制
- 故障切换, 领导者故障:故障转移
- 实施复制日志, 复制日志的实现-逻辑(基于行)日志复制
- 与协商一致的关系, 从单主复制到共识, 共识的利弊
- 设立新的追随者, 设置新的副本
- 同步对同步, 同步复制与异步复制-同步复制与异步复制
- 状态机复制, 基于语句的复制, 存储过程的利弊, 使用共享日志, 数据库与流
- 事件溯源, 事件溯源与 CQRS
- 依赖决定性因素, 确定性模拟测试
- 利用协商一致, 共识的利弊
- 使用擦除编码, 分布式文件系统
- 使用对象存储, 设置新的副本
- 相对备份, 复制
- 具有多样化数据系统, 保持系统同步
- replication logs(见 logs)
- representations of data(见 data models)
- 后处理数据, 应用演化后重新处理数据, 统一批处理和流处理
- (另见 可演化性)
- 从基于日志的信件, 重播旧消息
- 请求套期, 单主与无主复制的性能
- 请求标识符, 操作标识符, 多分区请求处理
- 请求路由, 请求路由-请求路由
- 方法, 请求路由
- 数据居住法, 分布式与单节点系统, 面向多租户的分片
- 弹性系统, 可靠性与容错
- (另见 fault tolerance)
- 资源隔离, 云计算与超级计算, 面向多租户的分片
- 资源限制, 云时代的运维
- 响应时间
- 作为业绩计量, 描述性能, 批处理
- 保证, 响应时间保证
- 对用户的影响, 平均值、中位数与百分位点
- 在复制系统中, 单主与无主复制的性能
- 暂时性与, 延迟与响应时间
- 平均值和百分位数, 平均值、中位数与百分位点
- 用户体验, 平均值、中位数与百分位点
- 责任和问责制, 责任与问责
- 表述性状态传递, Web 服务
- (另见 services)
- 重报(工作流程引擎), 持久化执行与工作流
- RethinkDB(数据库)
- 加入支持, 文档和关系数据库的融合
- 键程硬化, 按键的范围分片
- 重试风暴, 描述性能, 软件故障
- reverse ETL, 超越数据湖
- Riak(数据库)
- CRDT support, CRDT 与操作变换, 检测并发写入
- 点版向量, 版本向量
- 流言协议, 请求路由
- 散列变硬, 固定数量的分片
- 无领导复制, 无主复制
- 线性,缺少, 线性一致性与仲裁
- 多区域支助, 多地区操作
- 再平衡, 运维:自动/手动再平衡
- 二级指数, 本地二级索引
- 草率法定人数, 单主与无主复制的性能
- 节点(硬化), 分片
- 环缓冲器, 磁盘空间使用
- RisingWave(数据库)
- 增量视图维护, 维护物化视图
- 火箭弹, 拜占庭故障
- RocksDB (storage engine), 构建和合并 SSTable
- 退缩(事务), 事务
- 滚动升级, 通过冗余容忍硬件故障, 编码与演化, 故障与部分失效
- 在多种租户系统中, 面向多租户的分片
- routing(见 request routing)
- 基于行的复制, 逻辑(基于行)日志复制
- 面向行存储, 列式存储
- 抢劫犯(贪污), 硬件与软件故障
- RPCs(见 remote procedure calls)
- 规则(数据), Datalog:递归关系查询
- Rust(编程语言)
- 内存管理, 限制垃圾回收的影响
S
- S3(对象存储), 云服务的分层, 设置新的副本, 批处理, 分布式文件系统, 对象存储
- SaaS(见 软件即服务(SaaS))
- 安全和生活特性, 安全性与活性
- sagas(见 compensating transactions)
- Samza (流处理器), 流分析
- SAP HANA(数据库), 分析型数据存储
- 可伸缩性, 可伸缩性-可伸缩性原则, 流式系统的哲学
- 自动缩放, 运维:自动/手动再平衡
- 通过磨损, 分片的利与弊
- 描述负载, 描述负载
- 描述性能, 描述性能
- 线性, 描述负载
- 原则, 可伸缩性原则
- 复制和, 复制延迟的问题
- 扩大规模与扩大规模, 共享内存、共享磁盘与无共享架构
- 缩放, 共享内存、共享磁盘与无共享架构
- (另见 shared-nothing architecture)
- 通过磨损, 分片的利与弊
- 扩大规模, 共享内存、共享磁盘与无共享架构
- 缓慢变化的维度, 连接的时间依赖性
- 调度
- 阅读时的图谋, 文档模型中的模式灵活性
- 与可变方案比较, 模式的优点
- 拼写图, 文档模型中的模式灵活性
- schemaless databases(见 schema-on-read)
- 计划, 术语表
- Avro, Avro-动态生成的模式
- 读者决定作家的计划, 但什么是写入者模式?
- 计划演变, 写入者模式与读取者模式
- 动态生成, 动态生成的模式
- 变化, 应用演化后重新处理数据
- 影响应用程序代码, 编码与演化
- 兼容性检查, 但什么是写入者模式?
- 数据库中, 流经数据库的数据流-归档存储
- 服务电话, RPC 的数据编码与演化
- 文件模式的灵活性, 文档模型中的模式灵活性
- 用于分析, 星型与雪花型:分析模式-星型与雪花型:分析模式
- for JSON and XML, JSON、XML 及其二进制变体, JSON 模式
- generation and migration using ORMs, 对象关系映射(ORM)
- 案情, 模式的优点
- 迁移, 文档模型中的模式灵活性
- Protocol Buffers, Protocol Buffers-字段标签与模式演化
- 计划演变, 字段标签与模式演化
- 铁路移民计划, 应用演化后重新处理数据
- 传统的设计方法,谬误, 从同一事件日志中派生多个视图
- Avro, Avro-动态生成的模式
- 科学计算, 云计算与超级计算
- scikit-learn (Python 图书馆), 从数据仓库到数据湖
- ScyllaDB(数据库)
- 集群元数据, 请求路由
- consistency level ANY, 单主与无主复制的性能
- 散列变硬, 按键的哈希分片, 按哈希范围分片
- 最后写成的解决冲突, 检测并发写入
- 无领导复制, 无主复制
- 轻量事务, 单对象写入
- 线性,缺少, 实现线性一致性系统
- 日志结构存储, 构建和合并 SSTable
- 多区域支助, 多地区操作
- 使用时钟, 仲裁一致性的局限, 用于事件排序的时间戳
- 节点(硬化), 分片
- search engines(见 全文检索)
- 搜索流, 在流上搜索
- 备库(见 基于领导者的复制)
- 二级指数, 多列索引与二级索引, 术语表
- 二次排序, JOIN 与 GROUP BY
- sed (Unix 工具) (英语)., 简单日志分析
- 自我托管, 云服务与自托管
- 数据仓库, 云数据仓库
- 自我欢乐, 本章小结
- 自动验证系统, 不要盲目信任承诺
- 语义搜索, 向量嵌入
- 语义相似性, 向量嵌入
- 语义网, 三元组存储与 SPARQL
- 半同步复制, 同步复制与异步复制
- 顺序写(访问模式), 顺序与随机写入
- 可串行化, 隔离性, 弱隔离级别, 可串行化-可串行化快照隔离的性能, 术语表
- 线性比对, 什么使系统具有线性一致性?
- 悲观与乐观的并发控制, 悲观并发控制与乐观并发控制
- 序列执行, 实际串行执行-串行执行总结
- 分片, 分片
- 使用存储程序, 将事务封装在存储过程中, 使用共享日志
- 可串行化快照隔离, 可串行化快照隔离(SSI)-可串行化快照隔离的性能
- detecting stale MVCC reads, 检测陈旧的 MVCC 读取
- 检测影响先前读取的写入, 检测影响先前读取的写入
- 分布式执行, 可串行化快照隔离的性能, 数据库内部的分布式事务
- performance of SSI, 可串行化快照隔离的性能
- 防止写入skew, 基于过时前提的决策-检测影响先前读取的写入
- 严格的序列性, 什么使系统具有线性一致性?
- 及时性与完整性, 及时性与完整性
- 两阶段锁定, 两阶段锁定(2PL)-索引范围锁
- 可串行化, 特定语言的格式
- 序列化, 编码数据的格式
- (另见 编码)
- 无服务器, 微服务与无服务器
- 服务发现, 负载均衡器、服务发现和服务网格, 请求路由, 服务发现
- 登记, 负载均衡器、服务发现和服务网格
- using DNS, 负载均衡器、服务发现和服务网格, 请求路由, 服务发现
- 服务级别协议(SLA), 响应时间指标的应用, 描述负载
- 服务网格, 负载均衡器、服务发现和服务网格
- Service Organization Control (SOC), 数据系统、法律与社会
- 服务时间, 延迟与响应时间
- 面向服务的体系结构, 微服务与无服务器
- (另见 services)
- 服务, 流经服务的数据流:REST 与 RPC-RPC 的数据编码与演化
- 微服务, 微服务与无服务器
- 与批量/流程处理器的关系, 批处理, 流处理器和服务
- remote procedure calls (RPCs), 远程过程调用(RPC)的问题-RPC 的数据编码与演化
- 问题, 远程过程调用(RPC)的问题
- 与数据库相似, 流经服务的数据流:REST 与 RPC
- 网络服务, Web 服务
- 会话窗口(流处理), 窗口的类型
- (另见 windows)
- 分片, 分片-总结, 术语表
- 和共识, 使用共享日志
- 复制, 分片
- 分散事务, 分布式事务
- 热的软糖, 键值数据的分片
- 分批处理, 批处理
- 键程分割, 再平衡键范围分片数据
- 多硬性操作, 多分区数据处理
- 关键值数据, 键值数据的分片-偏斜的工作负载与缓解热点
- 按密钥范围, 按键的范围分片
- 摇摆和热点, 偏斜的工作负载与缓解热点
- 词源, 分片
- 分区键, 分片的利与弊, 键值数据的分片
- 再平衡
- 密钥范围压缩数据, 再平衡键范围分片数据
- 再平衡困难, 再平衡键范围分片数据-运维:自动/手动再平衡
- 自动或人工再平衡, 运维:自动/手动再平衡
- Hash mod N的问题, 哈希取模节点数
- 使用固定的碎片数, 固定数量的分片
- 使用 N 个节点, 按哈希范围分片
- 请求路由, 请求路由-请求路由
- 二级指数, 分片与二级索引-全局二级索引
- 连续执行事务和, 分片
- 正在排序硬化数据, 混洗数据
- 共享日志, 共识的实践-共识的利弊, 全序的限制, 基于日志消息传递中的唯一性
- 共享模式, 两阶段锁定的实现
- 共享磁盘架构, 共享内存、共享磁盘与无共享架构, 分布式文件系统
- 共享内存架构, 共享内存、共享磁盘与无共享架构
- 共享- 无结构, 共享内存、共享磁盘与无共享架构, 术语表
- 鲨鱼
- shredding (deletion)(见 crypto-shredding)
- 粉碎(专栏编码), 列式存储
- 粉碎(相关模型), 何时使用哪种模型
- 混洗, 混洗数据-混洗数据
- 兄弟值, 手动冲突解决, 捕获先发生关系, 冲突解决与复制
- (另见 conflicts)
- 仓, 数据仓库
- 相似性搜索
- 简单, 简单性:管理复杂度
- 歌手, 数据仓库
- single-instruction-multi-data (SIMD) instructions, 查询执行:编译与向量化
- single-leader replication(见 基于领导者的复制)
- 单条执行, 原子写操作, 实际串行执行
- 在溪流处理中, 日志与传统的消息传递相比, 并发控制, 基于日志消息传递中的唯一性
- SingleStore(数据库)
- 内存储, 全内存存储
- 工地可靠性工程师, 云时代的运维
- 大小级紧凑, 压实策略, 磁盘空间使用
- 偏斜, 术语表
- 时钟摇摆, 对同步时钟的依赖-带置信区间的时钟读数, 实现线性一致性系统
- 事务隔离
- 含义, 快照隔离与可重复读
- 不平衡的工作量, 键值数据的分片
- 补偿, 偏斜的工作负载与缓解热点
- 由于名人, 偏斜的工作负载与缓解热点
- 时间序列数据, 按键的范围分片
- 跳过列表, 构建和合并 SSTable
- 服务级别协议(见 服务级别协议)
- Slack(分组聊天)
- GraphQL example, GraphQL
- SlateDB(数据库), 构建和合并 SSTable, 设置新的副本
- 滑动窗口(流处理), 窗口的类型
- (另见 windows)
- 草率法定人数, 单主与无主复制的性能
- 缓慢变化的维度, 连接的时间依赖性
- 涂抹(倾斜秒调整), 时钟同步和准确性
- 快照(数据库)
- 作为备份, 复制
- 计算衍生数据, 创建索引
- 变化数据捕获中, 初始快照
- 可串行化快照隔离, 可串行化快照隔离(SSI)-可串行化快照隔离的性能
- 新建复制品, 设置新的副本
- 快速隔离和可重复读取, 快照隔离与可重复读-快照隔离、可重复读和命名混淆
- implementing with MVCC, 多版本并发控制(MVCC)
- indexes and MVCC, 索引与快照隔离
- 可见度规则, 观察一致快照的可见性规则
- 全球快照同步时钟, 用于全局快照的同步时钟
- Snowflake(数据库), 云原生系统架构, 云服务的分层, 云数据仓库, 批处理
- Snowflake (ID generator), ID 生成器和逻辑时钟
- 雪花计划, 星型与雪花型:分析模式
- SOAP (web services), 远程过程调用(RPC)的问题
- SOC2(见 Service Organization Control (SOC))
- 社会图表, 图数据模型
- 社会
- 的责任, 数据系统、法律与社会, 立法与自律
- 社会技术系统, 人类与可靠性
- 软件即服务(SaaS), 数据系统架构中的权衡, 云服务与自托管
- 软件错误, 软件故障
- 维护诚信, 维护完整性,尽管软件有Bug
- 太阳风暴, 硬件与软件故障
- solid state drives (SSDs)
- Solr (搜索服务器)
- 排序(Unix 工具), 简单日志分析, 简单日志分析, 排序与内存聚合, 分布式作业编排
- 排序归并连接(MapReduce), JOIN 与 GROUP BY
- Sorted String Tables(见 SSTables)
- 排序
- 列存储中的排序顺序, 列存储中的排序顺序
- 真相来源(权威数据源)(见 systems of record)
- Spanner(数据库)
- 一致性模式, 什么使系统具有线性一致性?
- 数据位置, 读写的数据局部性
- 在云层中, 云原生系统架构
- 使用时钟快照隔离, 用于全局快照的同步时钟
- 事务, 事务到底是什么?, 数据库内部的分布式事务
- TrueTime API, 带置信区间的时钟读数
- Spark(处理框架), 从数据仓库到数据湖, 云原生系统架构, 批处理, 数据流引擎
- SPARQL(查询语言), SPARQL 查询语言
- 零星指数, SSTable 文件格式
- 稀疏矩阵, 数据框、矩阵与数组
- 脑裂, 领导者故障:故障转移, 请求路由, 术语表
- 执行限制, 唯一性约束需要达成共识
- 在共识算法中, 共识, 从单主复制到共识
- 预防, 实现线性一致性系统
- 使用栅栏标志来避免, 隔离僵尸进程和延迟请求-多副本隔离
- 现场实例, 故障处理
- 电子表格, 数据系统架构中的权衡, 数据框、矩阵与数组
- SQL (Structured Query Language), 简单性:管理复杂度, 关系模型与文档模型, 云数据仓库
- 用于分析, 数据仓库, 列式存储
- 图表查询, SQL 中的图查询
- 隔离级别标准,问题, 快照隔离、可重复读和命名混淆
- 加入, 规范化、反规范化与连接
- 简历(例), 用于一对多关系的文档数据模型
- 社会网络家庭时间表(例), 表示用户、帖子与关注关系
- SQL injection vulnerability, 拜占庭故障
- 基于语句的复制, 基于语句的复制
- 存储程序, 存储过程的利弊
- 批次处理框架中的支持, 批处理
- 视图, Datalog:递归关系查询
- SQL Server(数据库)
- SQLite(数据库), 分布式系统的问题, 压实策略
- archiving WAL to object stores, 设置新的副本
- SRE (site reliability engineer), 云时代的运维
- SSDs(见 solid state drives)
- SSTables (storage format), SSTable 文件格式-压实策略
- 建造和维护, 构建和合并 SSTable
- making LSM-Tree from, 构建和合并 SSTable
- 阶段发布(见 rolling upgrades)
- 停滞(旧数据), 读己之写
- 跨渠道时间依赖性, 跨通道时序依赖
- 无头数据库中, 当节点故障时写入数据库
- 多转换并发控制, 检测陈旧的 MVCC 读取
- 监测, 监控陈旧性
- 客户端状态, 将状态变更推送给客户端
- 相对线性, 线性一致性
- 相对于及时性, 及时性与完整性
- standbys(见 基于领导者的复制)
- 恒星复制地形, 多主复制拓扑
- 恒星计划, 星型与雪花型:分析模式-星型与雪花型:分析模式
- 星球大战类比(事件时间与处理时间), 事件时间与处理时间
- 饥饿(时间安排), 资源分配
- 国家
- 从不可改变事件日志中得出, 状态、流和不变性
- 状态变化与应用程序代码之间的相互作用, 数据流:应用代码与状态变化的交互
- 保持衍生状态, 维护派生状态
- 由流处理器在流-流连接中维护, 流流连接(窗口连接)
- 观察导出状态, 观察派生数据状态-多分区数据处理
- 流处理器失败后重建, 失败后重建状态
- 应用代码和, 应用代码和状态的分离
- 状态机复制, 基于语句的复制, 存储过程的利弊, 使用共享日志, 数据库与流
- 事件溯源, 事件溯源与 CQRS
- 依赖决定性因素, 确定性模拟测试
- 无国籍人制度, 数据系统架构中的权衡
- 基于语句的复制, 基于语句的复制
- 依赖决定性因素, 确定性模拟测试
- 静态输入语言
- 类比于图案, 文档模型中的模式灵活性
- 统计和数字算法, 数据框、矩阵与数组
- StatsD (metrics aggregator), 直接从生产者传递给消费者
- 股票市场饲料, 直接从生产者传递给消费者
- 爆彼之头, 领导者故障:故障转移
- 问题, 隔离僵尸进程和延迟请求
- 停止所有处理(见 garbage collection)
- 存储
- 构建数据存储技术, 组合使用数据存储技术-分拆系统与集成系统
- 存储区网络, 共享内存、共享磁盘与无共享架构, 分布式文件系统
- 存储引擎, 存储与检索-总结
- 存储程序, 将事务封装在存储过程中-存储过程的利弊, 术语表
- 和共享日志, 使用共享日志
- 利弊因素, 存储过程的利弊
- 类似于流处理器, 应用代码作为派生函数
- 风暴(流处理器), 流分析
- distributed RPC, 事件驱动架构与 RPC, 多分区数据处理
- 三叉戟状态处理, 幂等性
- 斜拉机事件, 处理滞留事件
- Stream Control Transmission Protocol (SCTP), TCP 的局限性
- 流处理, 流处理-本章小结, 术语表
- 在工作范围内获得外部服务, 流表连接(流扩充), 微批次与存档点, 幂等性, 恰好执行一次操作
- 与批量处理相结合, 统一批处理和流处理
- 与批量处理的比较, 流处理
- 复合事件处理, 复合事件处理
- 过失容忍, 容错-失败后重建状态
- 数据整合, 批处理与流处理-统一批处理和流处理
- 用于事件源代码, 事件溯源与 CQRS
- 保持衍生状态, 维护派生状态
- 维持实际意见, 维护物化视图
- messaging systems(见 messaging systems)
- 关于时间的推理, 时间推理-窗口的类型
- relation to databases(见 streams)
- 与服务的关系, 流处理器和服务
- 与批次处理的关系, 批处理
- 在流中搜索, 在流上搜索
- 单条执行, 日志与传统的消息传递相比, 并发控制
- 流式分析, 流分析
- 串流连接, 流连接-连接的时间依赖性
- 串流流连接, 流流连接(窗口连接)
- 串行表连接, 流表连接(流扩充)
- 表格连接, 表表连接(维护物化视图)
- 时间的依赖性, 连接的时间依赖性
- 流程, 流处理-重播旧消息
- 端对端,向客户推进事件, 端到端的事件流
- messaging systems(见 messaging systems)
- processing(见 流处理)
- 与数据库的关系, 数据库与流-不变性的局限性
- (另见 changelogs)
- 变更流的 API 支持, 变更流的 API 支持
- 数据变更捕获, 数据变更捕获-变更流的 API 支持
- 按时间分列的状态衍生物, 状态、流和不变性
- 事件溯源, 数据变更捕获与事件溯源
- 保持系统同步, 保持系统同步-保持系统同步
- 不可改变事件哲学, 状态、流和不变性-不变性的局限性
- 专题, 传递事件流
- 严格的序列性, 什么使系统具有线性一致性?
- 及时性与完整性, 及时性与完整性
- 条纹(列编码), 列式存储
- 强一致性(见 线性一致性)
- 最终的一致性, 自动冲突解决
- 强烈的单份序列性, 什么使系统具有线性一致性?
- 主题、上游和物体(三层), 三元组存储与 SPARQL
- 订阅者, 传递事件流
- (另见 consumers)
- 超级计算机, 云计算与超级计算
- Superset(数据可视化软件), 分析(Analytics)
- 监视, 监视
- (另见 隐私)
- 寿司原则, 从数据仓库到数据湖
- 可持续性, 分布式与单节点系统
- Swagger(服务定义格式), Web 服务
- swapping to disk(见 virtual memory)
- Swift(编程语言)
- 内存管理, 限制垃圾回收的影响
- 同步引擎, 同步引擎与本地优先软件-同步引擎的利弊
- 实例, 同步引擎的利弊
- 用于本地第一软件, 实时协作、离线优先和本地优先应用
- 同步网络, 同步与异步网络, 术语表
- 同步复制, 同步复制与异步复制, 术语表
- 有多个领导, 多主复制
- 系统管理员, 云时代的运维
- 系统模型, 知识、真相和谎言, 系统模型与现实-确定性模拟测试
- 假设, 信任但验证
- 算法的正确性, 定义算法的正确性
- 绘制真实世界的地图, 将系统模型映射到现实世界
- 安全和生活, 安全性与活性
- 记录系统, 记录系统与派生数据, 术语表
- 数据变更捕获, 数据变更捕获的实现, 理解数据流
- 事件日志, 事件溯源与 CQRS
- 事件日志处理为, 状态、流和不变性
- 系统思维, 反馈回路
T
- t- digest(算法), 响应时间指标的应用
- 表格连接, 表表连接(维护物化视图)
- Tableau(数据可视化软件), 事务处理与分析的特征, 分析(Analytics)
- 尾巴 (Unix 工具), 使用日志进行消息存储
- tail latency(见 延迟)
- 尾顶(财产图), 属性图
- task (workflows)(见 workflow engines)
- TCP (Transmission Control Protocol), TCP 的局限性
- 时间(工作流程引擎), 持久化执行与工作流
- Tensorflow (机器学习图书馆), 机器学习
- Teradata(数据库), 云原生系统架构, 云数据仓库
- term-partitioned indexes(见 global secondary indexes)
- 终止(协商一致), 单值共识, 原子提交作为共识
- 测试, 人类与可靠性
- 击打(内存断), 进程暂停
- 线程(并发)
- Actor 模型, 分布式 actor 框架, 事件驱动架构与 RPC
- (另见 event-driven architecture)
- 原子操作, 原子性
- 背景线程, 构建和合并 SSTable
- 执行暂停, 我们不能简单地使网络延迟可预测吗?, 进程暂停-进程暂停
- 内存障碍, 线性一致性与网络延迟
- 预设, 进程暂停
- single(见 single-threaded execution)
- Actor 模型, 分布式 actor 框架, 事件驱动架构与 RPC
- 三阶段承诺, 三阶段提交
- 三方关系, 属性图
- Thrift(数据格式), Protocol Buffers
- 吞吐量, 描述性能, 描述负载, 批处理
- TIBCO, 消息代理
- Enterprise Message Service, 消息代理与数据库的对比
- StreamBase (stream analytics), 复合事件处理
- TiDB(数据库)
- 基于共识的复制, 单主复制
- 区域(硬化), 分片
- 请求路由, 请求路由
- 服务衍生数据, 对外提供派生数据
- 硬化二级指数, 全局二级索引
- 快速隔离支持, 快照隔离与可重复读
- 时间戳, 实现线性一致的 ID 生成器
- 事务, 事务到底是什么?, 数据库内部的分布式事务
- 使用模型检查, 模型检查与规范语言
- 分层存储, 设置新的副本, 磁盘空间使用
- TigerBeetle(数据库), 总结
- 确定性模拟测试, 确定性模拟测试
- TigerGraph(数据库)
- GSQL language, SQL 中的图查询
- Tigris(对象存储), 分布式文件系统
- TileDB(数据库), 数据框、矩阵与数组
- 时间
- 时间序列数据
- 每日时钟, 日历时钟
- 混合逻辑时钟, 混合逻辑时钟
- 及时性, 及时性与完整性
- 超时, 不可靠的网络, 术语表
- 动态配置, 网络拥塞和排队
- 失败, 领导者故障:故障转移
- 长度, 超时和无界延迟
- TimescaleDB(数据库), 列式存储
- 时间戳, 逻辑时钟
- 指定流处理中的事件, 你用的是谁的时钟?
- 读后写入一致性, 读己之写
- 用于事务命令, 用于全局快照的同步时钟
- 执行制约因素不足, 使用逻辑时钟强制约束
- 密钥范围, 按键的范围分片
- 兰波特, Lamport 时间戳
- 逻辑, 排序事件以捕获因果关系
- 命令事件, 用于事件排序的时间戳
- 时间戳, 实现线性一致的 ID 生成器
- TLA+ (specification language), 模型检查与规范语言
- 符号桶(限制重试), 描述性能
- 墓碑, 构建和合并 SSTable, 磁盘空间使用, 日志压缩
- 专题(信息), 消息代理, 传递事件流
- 撕裂的页面(B- 树), 使 B 树可靠
- 全序, 术语表
- 追踪, 分布式系统的问题
- 跟踪行为数据, 隐私与追踪
- (另见 隐私)
- 权衡, 数据系统架构中的权衡-数据系统、法律与社会
- transaction coordinator(见 协调者)
- transaction manager(见 协调者)
- 事务处理, 事务处理与分析的特征-事务处理与分析的特征
- 与分析的比较, 事务处理与分析的特征
- 与数据存储的比较, 分析型数据存储
- 事务, 事务-总结, 术语表
- ACID properties of, ACID 的含义
- 数据完整性, 及时性与完整性
- 复制, 复制延迟的解决方案
- compensating(见 compensating transactions)
- 概念, 事务到底是什么?
- 分布式事务, 分布式事务-再谈恰好一次消息处理
- 避开, 派生数据与分布式事务, 开展分拆工作, 强制约束-无协调数据系统
- 失败放大, 维护派生状态
- 已磨损的系统, 分片的利与弊
- 可疑/不确定状况, 协调器故障, 存疑时持有锁
- 两阶段提交, 两阶段提交(2PC)-三阶段提交
- 使用, 跨不同系统的分布式事务-恰好一次消息处理
- XA 事务, XA 事务-XA 事务的问题
- OLTP versus analytics queries, 分析(Analytics)
- 目标, 事务
- 可串行化, 可串行化-可串行化快照隔离的性能
- 实际执行, 实际串行执行-串行执行总结
- 悲观与乐观的并发控制, 悲观并发控制与乐观并发控制
- 可串行化快照隔离, 可串行化快照隔离(SSI)-可串行化快照隔离的性能
- 两阶段锁定, 两阶段锁定(2PL)-索引范围锁
- 单对象和多对象, 单对象与多对象操作-处理错误和中止
- 快照隔离(见 snapshots)
- 严格的序列性, 什么使系统具有线性一致性?
- 薄弱的隔离水平, 弱隔离级别-物化冲突
- 曲线(图), 属性图
- 三(数据结构), 构建和合并 SSTable, 全文检索
- as SSTable index, SSTable 文件格式
- 触发器(数据库), 传递事件流
- Trino(数据仓库), 云数据仓库
- 联邦数据库, 一切的元数据库
- 查询优化器, 查询语言
- 用于 ETL, 提取-转换-加载(ETL)
- 工作流程示例, 工作流调度
- 三层, 三元组存储与 SPARQL-SPARQL 查询语言
- SPARQL 查询语言, SPARQL 查询语言
- 翻转窗口(流处理), 窗口的类型
- (另见 windows)
- 在微战斗中, 微批次与存档点
- Turbopuffer(种子搜索) Name, 设置新的副本
- Turtle (RDF data format), 三元组存储与 SPARQL
- Twitter(见 X (social network))
- 两阶段提交, 两阶段提交(2PC)-协调器故障, 术语表
- 与双相锁定混淆, 两阶段锁定(2PL)
- 协调员失败, 协调器故障
- 协调员恢复, 从协调器故障中恢复
- 如何运作, 系统性的承诺
- 绩效成本, 跨不同系统的分布式事务
- problems with XA transactions, XA 事务的问题
- 持有锁定的事务, 存疑时持有锁
- 两阶段锁定, 两阶段锁定(2PL)-索引范围锁, 什么使系统具有线性一致性?, 术语表
- 与两阶段提交混淆, 两阶段锁定(2PL)
- 增长和缩小阶段, 两阶段锁定的实现
- 索引范围锁定, 索引范围锁
- 业绩, 两阶段锁定的性能
- 类型检查,动态对静态, 文档模型中的模式灵活性
U
- UDP (User Datagram Protocol)
- comparison to TCP, 网络拥塞和排队
- 多广播, 直接从生产者传递给消费者
- 终极在线(游戏), 分片
- 未绑定的数据集, 流处理, 术语表
- (另见 streams)
- 无限制的延误, 术语表
- 解析数据库, 分拆数据库-多分区数据处理
- 构建数据存储技术, 组合使用数据存储技术-分拆系统与集成系统
- 联邦制与拆分制, 一切的元数据库
- 围绕数据流设计应用程序, 围绕数据流设计应用-流处理器和服务
- 观察导出状态, 观察派生数据状态-多分区数据处理
- 实现视图和缓存, 物化视图和缓存
- 多硬数据处理, 多分区数据处理
- 推动客户端更改状态, 将状态变更推送给客户端
- 构建数据存储技术, 组合使用数据存储技术-分拆系统与集成系统
- uncertain (transaction status)(见 存疑)
- 联盟类型(在 Avro), 模式演化规则
- uniq(Unix 工具), 简单日志分析, 简单日志分析, 分布式作业编排
- 独特性限制
- 同步检查, 宽松地解释约束
- 需要协商一致, 唯一性约束需要达成共识
- 需要线性, 约束与唯一性保证
- 以日志为基础的信件中的独特性, 基于日志消息传递中的唯一性
- 团结(数据目录), 云数据仓库
- universally unique identifiers(见 UUIDs)
- unix 哲学
- unix 管道, 简单日志分析
- 与分布式批量处理相比, 工作流调度
- UPDATE statement (SQL), 文档模型中的模式灵活性
- 更新
- 使用量
- 批量过程调度, 资源分配
- 通过预设增加, 故障处理
- 与暂时取舍, 我们不能简单地使网络延迟可预测吗?
- uTP protocol (BitTorrent), TCP 的局限性
- UUIDs, ID 生成器和逻辑时钟
V
- 有效性(协商一致), 单值共识, 原子提交作为共识
- vBuckets(硬化), 分片
- 矢量时钟, 版本向量
- (另见 版本向量)
- 和 Lamport/hybrid 逻辑钟, Lamport/混合逻辑时钟 vs. 向量时钟
- 和版本向量, 版本向量
- 向量嵌入, 向量嵌入
- 矢量处理, 查询执行:编译与向量化
- 供应商锁定, 云服务的利弊
- Venice(数据库), 对外提供派生数据
- 核查, 信任但验证-用于可审计数据系统的工具
- 避免盲目信任, 不要盲目信任承诺
- 设计可审计性, 为可审计性而设计
- 端对端完整性检查, 端到端原则重现
- 可审计数据系统工具, 用于可审计数据系统的工具
- 版本控制系统
- 版本向量, 不同拓扑的问题, 版本向量
- Vertica(数据库), 云数据仓库
- 处理写入, 写入列式存储
- vertical scaling(见 scaling up)
- 顶点(图), 图数据模型
- 属性图模型, 属性图
- 电子游戏, 同步引擎的利弊
- 视频转码(例如), 跨通道时序依赖
- views (SQL queries), Datalog:递归关系查询
- materialized views(见 物化)
- 视图戳复制, 共识, 共识的实践
- 虚拟块设备, 存储与计算的分离
- 虚拟文件系统, 分布式文件系统
- 比较分布式文件系统, 分布式文件系统
- 虚拟机, 云服务的分层
- 虚拟内存
- Virtuoso(数据库), SPARQL 查询语言
- VisiCalc (spreadsheets), 围绕数据流设计应用
- Vitess(数据库)
- 键程硬化, 按键的范围分片
- 节点(硬化), 分片
- 词汇, 三元组存储与 SPARQL
- Voice over IP (VoIP), 网络拥塞和排队
- VoltDB(数据库)
W
- 预写式日志, 使 B 树可靠
- WAL-G (backup tool), 设置新的副本
- WarpStream(消息系统), 磁盘空间使用
- web services(见 services)
- 网络用户, 直接从生产者传递给消费者
- 网络方法(通讯), 消息代理
- WebSocket (protocol), 将状态变更推送给客户端
- 宽柱数据模型, 读写的数据局部性
- 相对于面向列的存储, 列压缩
- 窗口(流程处理), 流分析, 时间推理-窗口的类型
- 更改日志的无限窗口, 维护物化视图, 流表连接(流扩充)
- 知道所有事件何时到来, 处理滞留事件
- 串流在窗口内连接, 流流连接(窗口连接)
- 窗口类型, 窗口的类型
- WITH RECURSIVE syntax (SQL), SQL 中的图查询
- Word2Vec (language model), 向量嵌入
- 工作流程引擎, 持久化执行与工作流
- Airflow(见 Airflow(工作流调度器))
- 批处理, 工作流调度
- Camunda(见 Camunda (workflow engine))
- Dagster(见 Dagster(工作流调度器))
- 持久执行, 持久化执行与工作流
- 提取-转换-加载(ETL)(见 ETL)
- 执行器, 持久化执行与工作流
- 乐团, 持久化执行与工作流, 批处理
- Orkes(见 Orkes (workflow engine))
- Prefect(见 Prefect(工作流调度器))
- 依赖决定性因素, 确定性模拟测试
- Restate(见 Restate (workflow engine))
- Temporal(见 Temporal (workflow engine))
- 工作设置, 排序与内存聚合
- 写入放大, 写放大
- 写路径, 观察派生数据状态
- 写偏差, 写偏差与幻读-物化冲突
- 预写式日志, 使 B 树可靠, 预写日志(WAL)传输
- 持久执行, 持久化执行
- 写入(数据库)
- 原子写入操作, 原子写操作
- 检测影响前读的写入, 检测影响先前读取的写入
- 防止污秽的写作,, 没有脏写
- WS-* framework, 远程过程调用(RPC)的问题
- WS-AtomicTransaction (2PC), 两阶段提交(2PC)
X
- X (社会网络)
- 建造住房时间表(例如), 案例研究:社交网络首页时间线, 从同一事件日志中派生多个视图, 表表连接(维护物化视图), 物化视图和缓存
- 加入费用, 社交网络案例研究中的反规范化
- 描述负载, 描述负载
- 过失容忍, 容错
- 业绩计量, 描述性能
- DistributedLog (event log), 使用日志进行消息存储
- Snowflake (ID generator), ID 生成器和逻辑时钟
- 建造住房时间表(例如), 案例研究:社交网络首页时间线, 从同一事件日志中派生多个视图, 表表连接(维护物化视图), 物化视图和缓存
- XA 事务, 两阶段提交(2PC), XA 事务-XA 事务的问题
- xargs (Unix 工具) (英语)., 简单日志分析
- XFS (file system), 分布式文件系统
- XGBoost (machine learning library), 机器学习
- XML
- 二进制变体, 二进制编码
- 数据位置, 读写的数据局部性
- encoding RDF data, RDF 数据模型
- 应用数据的问题, JSON、XML 及其二进制变体
- 关系数据库, 文档模型中的模式灵活性
- XML databases, 关系模型与文档模型, 文档的查询语言
- Xorq(查询引擎), 一切的元数据库
- XPath, 文档的查询语言
- XQuery, 文档的查询语言
Y
- 亚虎
- 响应时间研究, 平均值、中位数与百分位点
- YARN (job scheduler), 分布式作业编排, 应用代码和状态的分离
- ApplicationMaster, 分布式作业编排
- Yjs (CRDT library), 同步引擎的利弊
- YugabyteDB(数据库)
- 散列变硬, 按哈希范围分片
- 键程硬化, 按键的范围分片
- 多领导复制, 跨地域运行
- 请求路由, 请求路由
- 硬化二级指数, 全局二级索引
- 平板(硬化), 分片
- 事务, 事务到底是什么?, 数据库内部的分布式事务
- 使用时钟同步, 用于全局快照的同步时钟
Z
- Zab(协商一致算法), 共识, 共识的实践
- use in ZooKeeper, 实现线性一致性系统
- 零拷贝, 编码数据的格式
- zero-disk architecture (ZDA), 设置新的副本
- ZeroMQ (messaging library), 直接从生产者传递给消费者
- 僵尸(分裂的大脑), 隔离僵尸进程和延迟请求
- zones (cloud computing)(见 availability zones)
- ZooKeeper (coordination service), 协调服务-服务发现
- 生成栅栏标志, 隔离僵尸进程和延迟请求, 使用共享日志, 协调服务
- 线性操作, 实现线性一致性系统
- 锁和领袖选举, 锁定与领导者选举
- 观察员, 服务发现
- 用于服务发现, 负载均衡器、服务发现和服务网格, 服务发现
- 用于硬性转让, 请求路由
- 使用 Zab 算法, 共识
后记
关于作者
Martin Kleppmann 是英国剑桥大学副教授,教授分布式系统与密码学协议。2017 年出版的《设计数据密集型应用》第一版确立了他在数据系统领域的权威地位;他在分布式系统方面的研究也推动了 local-first 软件运动。此前他曾在 LinkedIn、Rapportive 等互联网公司担任软件工程师和创业者,负责大规模数据基础设施。
Chris Riccomini 是软件工程师、创业投资人和作者,拥有 15 年以上在 PayPal、LinkedIn、WePay 的工作经验。他运营 Materialized View Capital,专注于基础设施初创企业投资;同时也是 Apache Samza 与 SlateDB 的共同创造者,并合著了 The Missing README: A Guide for the New Software Engineer。
关于译者
冯若航,网名 @Vonng。 PostgreSQL 专家,数据库老司机,云计算泥石流。 PostgreSQL 发行版 Pigsty 作者与创始人。 架构师,DBA,全栈工程师 @ TanTan,Alibaba,Apple。 独立开源贡献者,GitStar Ranking 585,国区活跃 Top20。 DDIA / PG Internal 中文版译者,数据库/云计算 KOL。
后记
《设计数据密集型应用》封面上的动物是印度野猪(Sus scrofa cristatus),它是在印度、缅甸、尼泊尔、斯里兰卡和泰国发现的一种野猪的亚种。与欧洲野猪不同,它们有更高的背部鬃毛,没有体表绒毛,以及更大更直的头骨。
印度野猪有一头灰色或黑色的头发,脊背上有短而硬的毛。雄性有突出的犬齿(称为 T),用来与对手战斗或抵御掠食者。雄性比雌性大,这些物种平均肩高 33-35 英寸,体重 200-300 磅。他们的天敌包括熊、老虎和各种大型猫科动物。
这些动物夜行且杂食 —— 它们吃各种各样的东西,包括根、昆虫、腐肉、坚果、浆果和小动物。野猪经常因为破坏农作物的根被人们所熟知,他们造成大量的破坏,并被农民所敌视。他们每天需要摄入 4,000 ~ 4,500 卡路里的能量。野猪有发达的嗅觉,这有助于寻找地下植物和挖掘动物。然而,它们的视力很差。
野猪在人类文化中一直具有重要意义。在印度教传说中,野猪是毗湿奴神的化身。在古希腊的丧葬纪念碑中,它是一个勇敢失败者的象征(与胜利的狮子相反)。由于它的侵略,它被描绘在斯堪的纳维亚、日耳曼和盎格鲁撒克逊战士的盔甲和武器上。在中国十二生肖中,它象征着决心和急躁。
O’Reilly 封面上的许多动物都受到威胁,这些动物对世界都很重要。要了解有关如何提供帮助的更多信息,请访问 animals.oreilly.com。
封面图片来自 Shaw’s Zoology。封面字体是 URW Typewriter 和 Guardian Sans。文字字体是 Adobe Minion Pro;图中的字体是 Adobe Myriad Pro;标题字体是 Adobe Myriad Condensed;代码字体是 Dalton Maag 的 Ubuntu Mono。
贡献者
译者
冯若航,网名 @Vonng。 PostgreSQL 专家,数据库老司机,云计算泥石流。 Pigsty 作者与创始人。 架构师,DBA,全栈工程师 @ TanTan,Alibaba,Apple。 独立开源贡献者,GitStar Ranking 585,国区活跃 Top20。 DDIA / PG Internal 中文版译者,公众号:《老冯云数》,数据库 KOL。
校订与维护
YinGang @yingang 对本书进行了全文校订,并持续维护。
繁体中文版本
贡献列表
头像墙收录提交过 Issue 或 PR 的朋友;无论是否采纳、合并或关闭,反馈本身即是贡献。
- 全文校订 by @yingang
- 序言初翻修正 by @seagullbird
- 第一章语法标点校正 by @nevertiree
- 第六章部分校正 与第十章的初翻 by @MuAlex
- 第一部分前言,ch2校正 by @jiajiadebug
- 词汇表、后记关于野猪的部分 by @cg-zhou
- 繁體中文版本与转换脚本 by @afunTW
- 多处翻译修正 by @songzhibin97 @MamaShip @FangYuan33
完整记录:Issues · Pull Requests。
截至 2026-09-19(UTC),共收录 212 位贡献者。以下记录保留实际状态,未合并的提议同样计入贡献。
| Issue / PR | 贡献者 | 标题 | 状态 |
|---|---|---|---|
| Issue #420 | @Ice-pumpkin | 图 10-2 的描述错误 | 已关闭 |
| PR #419 | @JYu1999 | fix(tw): scalability 譯名由「可伸縮」改為「可擴展」 | 未合并 |
| PR #418 | @JYu1999 | fix(tw): 修正雲端相關詞彙中誤留簡體「云」的問題 | 已合并 |
| PR #417 | @JYu1999 | chore: replace early release cover with final 2nd edition cover | 已合并 |
| PR #415 | @Waynting | Fix \[…\] bracket escaping parsed as math passthrough (en source + zh/tw footnote) | 已合并 |
| Issue #414 | @Valerie-space | 字体选项建议 | 已关闭 |
| PR #413 | @luchao2424631502 | fix(ch1): 修改错别字 | 已合并 |
| Issue #412 | @chesha1 | 近期网站重构后的两点使用体验反馈 | 已关闭 |
| PR #411 | @Waynting | Fix bracket escaping in GDPR quote rendered as LaTeX math | 未合并 |
| PR #410 | @aha-jansen | fix(epub): 修复 EPUB 导出的封面、目录与导航链接 | 未合并 |
| PR #409 | @Klu5ure | 修复 README 中翻译进度描述的笔误 | 未合并 |
| PR #408 | @hezhengdong | fix(ch8): 删除多余空行,修复有序列表显示问题 | 已合并 |
| PR #407 | @AldenWangExis | fix(ch): normalize zh/tw emphasis formatting | 已合并 |
| Issue #406 | @AldenWangExis | Inconsistent bold/italic emphasis in zh translation | 已关闭 |
| PR #405 | @AldenWangExis | fix(ch1): clarify abbreviation expansions in zh and tw | 未合并 |
| Issue #404 | @AldenWangExis | Some zh-only wording fixes may have drifted from tw | 已关闭 |
| Issue #403 | @AldenWangExis | Some zh-only wording fixes may have drifted from tw | 已关闭 |
| PR #402 | @AldenWangExis | fix(ch1): improve wording in zh and tw | 未合并 |
| PR #401 | @AldenWangExis | fix(epub): 修复生成 EPUB 后目录跳转错误 | 未合并 |
| PR #400 | @SXP-Simon | fix(zh): fix untranslated headings in ch13.md | 未合并 |
| Issue #399 | @1stcoderXiaoLin | 线上网站是不是挂了:http://ddia.vonng.com/ | 已关闭 |
| PR #398 | @c2j | 支持自动生成一整本PDF 电子书 | 未合并 |
| PR #397 | @daihaowxg | fix(ch2): 修正文案中的“观察记录果”笔误 | 已合并 |
| Issue #395 | @ethan-tan-stori | 第六章节复制篇翻译问题 | 已关闭 |
| Issue #394 | @wayne87140 | 專有名詞在括號後面加入原文 | 已关闭 |
| PR #393 | @cg-zhou | 更新贡献者 GitHub 链接:按 PR 作者映射修复失效链接,并同步 README/_index/contrib | 已合并 |
| Issue #391 | @demonkit | 机翻阅读不通顺 | 已关闭 |
| PR #390 | @bearomorphism | Fix typographical errors in chapter 1 | 已合并 |
| PR #389 | @demo-zexuan | 恢复 EPUB 导出功能并修复图片显示问题 | 已合并 |
| Issue #388 | @MintBlue | main 分支现在还支持 导出 epub 这个特性吗 | 已关闭 |
| PR #387 | @ButcherV | Update part-i.md | 已合并 |
| PR #386 | @uncle-lv | improve ch2 translation | 已合并 |
| PR #384 | @PanggNOTlovebean | docs: 优化中文文档的措辞和表达 | 已合并 |
| PR #383 | @PanggNOTlovebean | docs: 修正ch4中的术语和表达错误 | 已合并 |
| PR #382 | @uncle-lv | Improve ch1 translation | 已合并 |
| PR #381 | @Max-Tortoise | fix incomplete term in chapter 4 | 已合并 |
| PR #377 | @huang06 | Refine translation terms | 已合并 |
| Issue #375 | @z-soulx | 对于是否100%全中文翻译的必要性讨论?个人-没必要100%,特别是“名词”,有原单词更加适合it人员 | 已关闭 |
| PR #371 | @lewiszlw | CPU core -> CPU 核心 | 已合并 |
| PR #369 | @bbwang-gl | Update ch7.md 可串行化快照隔离检测一个事务何时修改另一个事务的读取 | 已合并 |
| PR #368 | @yhao3 | update zh-tw.py and zh-tw content | 已合并 |
| PR #367 | @yhao3 | Fix typo, formatting and punctuation | 已合并 |
| PR #366 | @yangshangde | Update ch8.md,电源失败改为电源失效 | 已合并 |
| PR #365 | @xyohn | #364 ch1 - optimize translation about Separation of storage and compute | 已合并 |
| Issue #364 | @xyohn | ch1 - optimize translation about Separation of storage and compute | 已关闭 |
| PR #363 | @xyohn | #362 optimize translation | 已合并 |
| Issue #362 | @xyohn | ch1 - optimize translation | 已关闭 |
| PR #359 | @c25423 | fix: Correct "Usage-Agent" to "User-Agent" in Chapter 10 | 已合并 |
| PR #358 | @lewiszlw | Fix a typo in chapter4 | 已合并 |
| PR #357 | @Gezi-lzq | feat: add Generate GitBook eBooks action | 未合并 |
| PR #356 | @lewiszlw | Fix chapter2 comma typo | 已合并 |
| PR #355 | @duroey | fix: 缺少一个括号 | 已合并 |
| PR #354 | @justlorain | fix: ch7 ref51 broken link | 已合并 |
| PR #353 | @fantasyczl | fix: 修复错误的引用 | 已合并 |
| PR #352 | @fantasyczl | Feature: Convert Markdown to EPUB | 已合并 |
| PR #351 | @fantasyczl | fix: correct list numbering | 未合并 |
| Issue #350 | @674019130 | ch1 - Transaction Processing versus Analytics | 已关闭 |
| PR #349 | @xiyihan0 | Fix typo on ch1.md | 已合并 |
| PR #348 | @omegaatt36 | fix: wrong img src of fig3-12.png | 已合并 |
| PR #347 | @hli988 | Updated ch1.md: Refined translation of 'interfaces' | 已合并 |
| Issue #346 | @Vermouth1995 | 第二版第一章有一处翻译不太妥当 | 已关闭 |
| Issue #345 | @Vonng | DDIA 第二版翻译 | 已关闭 |
| PR #343 | @kehao-chen | 修正不精確的表達方式 | 已合并 |
| PR #342 | @guaidaokakaxi | Update ch9.md | 未合并 |
| PR #341 | @YKIsTheBest | Refine sentences | 已合并 |
| PR #340 | @YKIsTheBest | Refine the chapter 2 sentences | 已合并 |
| Issue #339 | @tigerinus | 关于图9-4的解释 | 已关闭 |
| PR #338 | @YKIsTheBest | Refine sentences for more comprehensible in Chinese | 已合并 |
| PR #337 | @YKIsTheBest | Refine setences in ch1.md | 未合并 |
| Issue #336 | @msxfXF | 目录好像有点问题 | 已关闭 |
| PR #335 | @kimi0230 | fix: zh-tw 日志 to 日誌 | 已合并 |
| PR #334 | @soulrrrrr | fix zh-tw/ch2 typo | 未合并 |
| Issue #333 | @TronYY | 这个翻译和[中国电力出版社]赵军平 吕三平翻译的有什么不同 | 已关闭 |
| PR #332 | @justlorain | fix: ch5 inconsistent translation | 已合并 |
| PR #331 | @Lyianu | fix typo in ch9 | 已合并 |
| PR #330 | @Lyianu | fix ch7 translation | 已合并 |
| Issue #329 | @Lyianu | 第六章似乎存在一处翻译错误 | 已关闭 |
| PR #328 | @justlorain | fix: ch4 missing translation | 已合并 |
| Issue #327 | @avenarius-argus | 关于英语版本文字缺失 | 已关闭 |
| PR #326 | @liangGTY | Resilient: 韧性 -> 回弹性 | 已合并 |
| PR #325 | @SunVdong | 修改 第四章 Field tags and schema evolution 移除字段翻译的问题 | 未合并 |
| Issue #324 | @starsea | 为什么英文原版丢失了很多章节 | 已关闭 |
| PR #323 | @marvin263 | 明确表达:需要如何处理的是“老主库尚未复制的写入” | 已合并 |
| PR #322 | @marvin263 | 经验–>从业经历 | 已合并 |
| Issue #321 | @chlch | 第三章存储与检索,散列索引这章最后一段翻译是不是有问题 | 已关闭 |
| PR #320 | @FangYuan33 | 修正错别字 | 未合并 |
| PR #319 | @FangYuan33 | 修正标点符号 | 已合并 |
| PR #318 | @FangYuan33 | 去掉多余的”在“ | 已合并 |
| PR #317 | @FangYuan33 | 去掉多余的空格 | 已合并 |
| PR #316 | @FangYuan33 | 更正右引号 | 已合并 |
| PR #315 | @FangYuan33 | 成为 -> 称为 | 未合并 |
| PR #314 | @FangYuan33 | 更正右引号 | 已合并 |
| PR #313 | @FangYuan33 | 更正标点符号 | 已合并 |
| PR #312 | @FangYuan33 | 统一上下文名词 | 已合并 |
| PR #311 | @FangYuan33 | 补充谓语 | 已合并 |
| PR #310 | @FangYuan33 | 确定地 -> 确切地 | 已合并 |
| PR #309 | @FangYuan33 | 优化中文表述 | 已合并 |
| PR #308 | @FangYuan33 | 去掉多余的“最” | 已合并 |
| PR #307 | @FangYuan33 | 优化表述 | 已合并 |
| PR #306 | @FangYuan33 | 更正右引号 | 已合并 |
| PR #305 | @FangYuan33 | 更改时间r的位置以增强可读性 | 已合并 |
| PR #304 | @spike014 | refactor(ch11): update #变更数据捕获的实现 | 已合并 |
| Issue #303 | @rabomen | 生成epub无法正确显示公式 | 已关闭 |
| PR #302 | @FangYuan33 | 页面展示加粗失效 | 已合并 |
| PR #301 | @FangYuan33 | 补充省略的宾语以更容易理解 | 已合并 |
| PR #300 | @FangYuan33 | 补充谓语 | 已合并 |
| PR #299 | @FangYuan33 | 去掉多余的句号 | 已合并 |
| PR #298 | @Makonike | docs: fix typo | 已合并 |
| PR #297 | @FangYuan33 | 更正右引号 | 已合并 |
| PR #296 | @FangYuan33 | 优化翻译 | 已合并 |
| PR #295 | @FangYuan33 | 优化表述 | 已合并 |
| PR #294 | @FangYuan33 | 客户 -> 客户端 | 已合并 |
| PR #293 | @FangYuan33 | 并行 -> 并发 | 已合并 |
| Issue #292 | @117503445 | 日期被错误解析为 emoji | 已关闭 |
| PR #291 | @FangYuan33 | 页面内容加粗失效 | 未合并 |
| PR #290 | @FangYuan33 | 页面内容加粗失效 | 未合并 |
| PR #289 | @FangYuan33 | 修改语序 | 已合并 |
| PR #288 | @FangYuan33 | 去掉不必要的量词修饰 | 已合并 |
| PR #287 | @FangYuan33 | 补充谓语 | 已合并 |
| PR #286 | @FangYuan33 | 补充丢失的右括号 | 已合并 |
| PR #284 | @WAangzE | fix a wrong bullet in ch4 | 已合并 |
| PR #283 | @WAangzE | fix a typo in ch3 | 已合并 |
| PR #282 | @WAangzE | Fix a mathematical environment issue. | 已合并 |
| PR #281 | @lyuxi99 | fix some broken anchor links | 已合并 |
| PR #280 | @lyuxi99 | fix a broken anchor link in ch9.md | 已合并 |
| Issue #279 | @codexvn | 第9章 什么使得系统线性一致,列举CAS情况出现两个x=V old | 已关闭 |
| PR #278 | @truenorth-lj | Update ch2.md | 未合并 |
| Issue #277 | @cuprumz | 分支因子为 500 的 4KB 页面的四层树可以存储多达 256TB 的数据 | 已关闭 |
| Issue #276 | @sunzeren | 数据库 | 已关闭 |
| PR #275 | @117503445 | fix: license 404 | 已合并 |
| PR #274 | @uncle-lv | docs: ch7.md 错字修订 最着名 -> 最著名 | 已合并 |
| PR #273 | @quwang123 | [docs] ch7 术语统一,写入偏斜->写入偏差,写偏差->写入偏差 | 已合并 |
| PR #272 | @quwang123 | [docs] 统一ch7中的术语 写入偏斜->写入偏差,写偏差->写入偏差 | 未合并 |
| PR #271 | @Makonike | docs: update ch6.md | 已合并 |
| PR #270 | @Ynjxsjmh | Fix “更新丢失” to “丢失更新” in ch7.md | 已合并 |
| Issue #269 | @auula | GitBook WeChat Group QRcode Expired | 已关闭 |
| PR #268 | @MamaShip | 优化第三章的部分语句 | 已合并 |
| PR #267 | @MamaShip | 调整脚注段落的位置 | 未合并 |
| PR #266 | @MamaShip | 优化第二章后半部分 | 已合并 |
| PR #265 | @MamaShip | 优化第二章的部分文字 | 已合并 |
| PR #264 | @MamaShip | minor fix: 正确区分「可扩展性」与「可伸缩性」 | 已合并 |
| PR #263 | @zydmayday | Update ch5.md | 已合并 |
| Issue #262 | @ccxhwmy | 第二章的 [例 2-1] 链接缺失 | 已关闭 |
| Issue #261 | @ccxhwmy | 十二张思维导图分析 | 已关闭 |
| PR #260 | @haifeiWu | 修改部分翻译不准确的问题 | 已合并 |
| Issue #259 | @SpikeWong | 关于无主复制的疑问 | 已关闭 |
| PR #258 | @bestgrc | Update ch3.md | 已合并 |
| PR #257 | @samwu4166 | Fix: typo nonderterministic | 已合并 |
| PR #256 | @AlphaWang | fix ch7-transaction: serializability | 已合并 |
| PR #255 | @AlphaWang | fix transaction: repeatable read | 已合并 |
| Issue #254 | @2w1nd | 网站404 not found | 已关闭 |
| PR #253 | @AlphaWang | fix ch7-transaction: Read Committed | 已合并 |
| PR #252 | @songzhibin97 | Update ch9.md | 已合并 |
| PR #251 | @songzhibin97 | Update ch9.md | 已合并 |
| PR #250 | @songzhibin97 | Update ch9.md | 已合并 |
| PR #249 | @songzhibin97 | Update ch9.md | 已合并 |
| PR #248 | @songzhibin97 | Update ch9.md | 已合并 |
| PR #247 | @songzhibin97 | Update ch9.md | 已合并 |
| PR #246 | @derekwu0101 | 修正錯字 | 已合并 |
| PR #245 | @skyran1278 | ch12: 修正繁體中文翻譯 討論瞭 => 討論了 | 已合并 |
| PR #244 | @Axlgrep | Update ch9.md | 已合并 |
| PR #243 | @lynkeib | adjust wording for locking and leader election | 未合并 |
| PR #242 | @lynkeib | adjust wording for linearizability vs serializability | 已合并 |
| PR #241 | @lynkeib | Update ch8.md | 已合并 |
| PR #240 | @leo-987 | Update ch9.md | 已合并 |
| PR #239 | @BeBraveBeCurious | Update ch7.md | 已合并 |
| Issue #238 | @bluebear4 | 在线预览网站打不开 | 已关闭 |
| PR #237 | @zhangnew | fix img url in ch3.md | 已合并 |
| PR #236 | @songzhibin97 | Update ch8.md | 已合并 |
| PR #235 | @songzhibin97 | Update ch8.md | 已合并 |
| PR #234 | @songzhibin97 | Update ch8.md | 已合并 |
| PR #233 | @songzhibin97 | Update ch8.md | 已合并 |
| PR #232 | @songzhibin97 | Update ch8.md | 已合并 |
| PR #231 | @songzhibin97 | Update ch8.md | 已合并 |
| PR #230 | @songzhibin97 | Update ch8.md | 未合并 |
| PR #229 | @lis186 | 更正錯字 | 未合并 |
| PR #228 | @songzhibin97 | Update ch7.md | 已合并 |
| PR #227 | @songzhibin97 | Update ch7.md | 已合并 |
| PR #226 | @chroming | Update ch1.md | 已合并 |
| PR #225 | @songzhibin97 | Update ch7.md | 已合并 |
| PR #224 | @songzhibin97 | Update ch7.md | 已合并 |
| PR #223 | @songzhibin97 | Update ch7.md | 已合并 |
| PR #222 | @songzhibin97 | Update ch7.md | 已合并 |
| Issue #221 | @Juude | 建议能增加下英文原文的链接。 | 已关闭 |
| PR #220 | @skyran1278 | fix a zh-tw translation issue | 已合并 |
| Issue #219 | @Style980102 | 很多图都挂了,作者能再配一下吗 | 已关闭 |
| PR #218 | @songzhibin97 | Update ch5.md | 未合并 |
| PR #217 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #216 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #215 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #214 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #213 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #212 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #211 | @songzhibin97 | Update ch5.md | 未合并 |
| PR #210 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #209 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #208 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #207 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #206 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #205 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #204 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #203 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #202 | @songzhibin97 | Update ch5.md | 已合并 |
| PR #201 | @songzhibin97 | Update ch4.md | 已合并 |
| PR #200 | @songzhibin97 | typo:好外->好处 | 已合并 |
| PR #199 | @songzhibin97 | 索引覆盖了查询->索引覆盖了的查询 | 未合并 |
| PR #198 | @songzhibin97 | type:更具->更具有 | 已合并 |
| PR #197 | @songzhibin97 | 地区、地区-> 地区 | 已合并 |
| PR #196 | @songzhibin97 | 够能->能够 | 已合并 |
| Issue #195 | @BeBraveBeCurious | REST 是否是一个协议呢? | 已关闭 |
| PR #194 | @BeBraveBeCurious | Update ch4.md | 已合并 |
| PR #193 | @BeBraveBeCurious | Update ch4.md | 已合并 |
| PR #192 | @BeBraveBeCurious | Update ch4.md | 已合并 |
| PR #191 | @songzhibin97 | typo:时以->是以 | 已合并 |
| PR #190 | @Pcrab | Update ch1.md | 已合并 |
| Issue #189 | @rovernerd | 第一章中的部分图片挂掉了 | 已关闭 |
| Issue #188 | @BeBraveBeCurious | 第四章的 typo 更正后,网页阅读版未更新 | 已关闭 |
| PR #187 | @narojay | fix 感觉原来翻译有点生硬 | 已合并 |
| PR #186 | @narojay | 存在语病 | 已合并 |
| Issue #185 | @leo-987 | 小标题无法跳转 | 已关闭 |
| PR #184 | @DavidZhiXing | Update ch10.md | 已合并 |
| PR #183 | @OneSizeFitsQuorum | Fix typo in ch8 | 已合并 |
| Issue #182 | @lroolle | Feature Request: support change to simple theme | 已关闭 |
| PR #181 | @YunfengGao | fix typo of ch2.md | 已合并 |
| PR #180 | @skyran1278 | fix typo of ch3.md | 未合并 |
| Issue #179 | @goace | 请问能编译成epub或者mobi吗? | 已关闭 |
| PR #178 | @BeBraveBeCurious | 尝试显示 gitbook 多级目录 | 未合并 |
| PR #177 | @exzhawk | use docsify-katex to support latex syntax | 已合并 |
| PR #176 | @haifeiWu | fix some translate confusing place | 已合并 |
| PR #175 | @cwr31 | 不变量->不变式 | 已合并 |
| PR #174 | @BeBraveBeCurious | Update README.md | 已合并 |
| PR #173 | @ZvanYang | Update ch12.md | 已合并 |
| PR #172 | @ZvanYang | Update ch12.md | 未合并 |
| PR #171 | @ZvanYang | Update ch12.md | 已合并 |
| PR #170 | @ZvanYang | Update ch12.md | 未合并 |
| PR #169 | @ZvanYang | Update ch12.md | 已合并 |
| PR #168 | @ZvanYang | Update ch12.md | 未合并 |
| Issue #167 | @yhm138 | gitbook pdf这个命令好像行 | 已关闭 |
| PR #166 | @bp4m4h94 | fix: ch1 request | 已合并 |
| Issue #165 | @yhm138 | where can I download pdf version of https://vonng.gitbook.io/vonng/ | 已关闭 |
| PR #164 | @longjiquan | Fix quatation marks of preface.md | 已合并 |
| PR #163 | @llmmddCoder | ch1 evolability -> evolvability | 已合并 |
| Issue #162 | @yingang | GitBook 的翻译可以整体更新下嘛? | 已关闭 |
| PR #161 | @ZvanYang | Update ch10.md | 未合并 |
| Issue #160 | @Zhayhp | 网络模型(network model)翻译意见 | 已关闭 |
| PR #159 | @1ess | Update ch4.md | 已合并 |
| PR #158 | @ZvanYang | Update ch7.md | 未合并 |
| PR #157 | @ZvanYang | Update ch7.md | 已合并 |
| PR #156 | @ZvanYang | Update ch7.md | 未合并 |
| PR #155 | @ZvanYang | Update ch7.md | 已合并 |
| PR #154 | @ZvanYang | Update ch7.md | 未合并 |
| PR #153 | @DavidZhiXing | typos | 已合并 |
| PR #152 | @ZvanYang | Update ch7.md | 已合并 |
| PR #151 | @ZvanYang | Update ch5.md | 已合并 |
| PR #150 | @ZvanYang | Update ch5.md | 未合并 |
| PR #149 | @ZvanYang | Update ch5.md | 未合并 |
| PR #148 | @ZvanYang | Update ch5.md | 未合并 |
| PR #147 | @ZvanYang | Update ch5.md | 已合并 |
| PR #146 | @ZvanYang | Update ch5.md | 未合并 |
| PR #145 | @ui-HookeyChiang | Fix zh-tw/ch1 typoes | 未合并 |
| Issue #144 | @secret4233 | 间隙锁与next-key locking | 已关闭 |
| Issue #143 | @imcheney | 第三章有很多中文翻译的不通顺 | 已关闭 |
| Issue #142 | @XIJINIAN | 文章每一段开头,为什么有一个空格呢? | 已关闭 |
| Issue #141 | @Flyraty | ch5.md 中有个小小的 markdown 语法错误 | 已关闭 |
| PR #140 | @Bowser1704 | 修复第五章的一些翻译问题 | 已合并 |
| PR #139 | @Bowser1704 | 修复第二章的错误翻译和第三章的一些描述问题 | 已合并 |
| Issue #138 | @wafer-li | Online Preview should enforce HTTPS | 已关闭 |
| PR #137 | @fuxuemingzhu | 修复第 5 章和第 6 章中有歧义的描述 | 已合并 |
| PR #136 | @wangqiim | fix sidebar view order | 未合并 |
| Issue #135 | @shukebeta | 序言中的本书 gitbook 链接失效了。 | 已关闭 |
| PR #134 | @fuxuemingzhu | 修复第 4 章有歧义的内容 | 已合并 |
| PR #133 | @fuxuemingzhu | 修复第三章的错别字以及有歧义描述 | 已合并 |
| PR #132 | @fuxuemingzhu | 把「新值不大于旧值」改为「新值字节数不大于旧值」 | 已合并 |
| PR #131 | @KAKXA | ch6中 密钥->键,zh-tw的ch6中 金鑰->鍵 | 已合并 |
| PR #130 | @fuxuemingzhu | 把「关键」修改为「关键值索引」,更清晰 | 未合并 |
| PR #129 | @anaer | Update ch4.md | 已合并 |
| PR #128 | @meilin96 | 修改链接错误 | 已合并 |
| PR #127 | @guaidaokakaxi | 修改负载偏斜与热点消除章节的翻译 | 未合并 |
| PR #126 | @cwr31 | 功能—>函数 | 已合并 |
| PR #125 | @dch1228 | 最好地 -> 以最佳方式 | 已合并 |
| PR #124 | @yingang | translation updates (chapter 10) | 已合并 |
| PR #123 | @yingang | translation updates (chapter 9, TOC in readme, glossary, etc.) | 已合并 |
| Issue #122 | @yingang | 想问下bookstack/书栈网对此译本的搬运是得到授权的吗? | 已关闭 |
| PR #121 | @yingang | translation updates (chapter 5 to chapter 8) | 已合并 |
| PR #120 | @jiong-han | Typo fix: 呲之以鼻 -> 嗤之以鼻 | 已合并 |
| PR #119 | @cclauss | Streamline file operations in convert() | 已合并 |
| PR #118 | @yingang | translation updates (chapter 2 and 3) | 已合并 |
| PR #117 | @feeeei | 统一每章的标题格式 | 已合并 |
| Issue #116 | 已删除账户 | 有 epub 版本吗 | 已关闭 |
| PR #115 | @NageNalock | 第七章病句修改: 重复词语 | 已合并 |
| PR #114 | @Sunt-ing | Update README.md: correct the book name | 已合并 |
| PR #113 | @lpxxn | 修改语句 | 已合并 |
| PR #112 | @ibyte2011 | Update ch9.md | 已合并 |
| Issue #111 | @mxdljwxx | Ddia | 已关闭 |
| PR #110 | @lpxxn | 读已写入数据 | 未合并 |
| Issue #109 | @sunyiwei24601 | 第八章的开头引用 | 已关闭 |
| Issue #108 | @taco-wang | 来一个pdf版本吧 | 已关闭 |
| PR #107 | @abbychau | 單調鐘和好死还是赖活着 | 已合并 |
| PR #106 | @enochii | typo in ch2: fix braces typo | 已合并 |
| PR #105 | @LiminCode | Chronicle translation error | 已合并 |
| PR #104 | @Sunt-ing | several advice for better translation | 已合并 |
| PR #103 | @Sunt-ing | typo in ch4: should be 完成 rather than 完全 | 已合并 |
| PR #102 | @Sunt-ing | ch4: better-translation: 扼杀 → 破坏 | 已合并 |
| PR #101 | @Sunt-ing | typo in Ch4: should be "改变" rathr than "盖面" | 已合并 |
| PR #100 | @LiminCode | fix missing translation | 已合并 |
| PR #99 | @mrdrivingduck | ch6: fix the word rebalancing | 已合并 |
| PR #98 | @jacklightChen | fix ch7.md: fix wrong references | 已合并 |
| PR #97 | @jenac | 96 | 未合并 |
| PR #96 | @PragmaTwice | ch2: fix typo about 'may or may not be' | 已合并 |
| PR #95 | @EvanMu96 | fix translation of "the battle cry" in ch5 | 未合并 |
| PR #94 | @kemingy | ch6: fix markdown and punctuations | 已合并 |
| PR #93 | @kemingy | ch5: fix markdown and some typos | 已合并 |
| PR #92 | @Gilbert1024 | Merge pull request #1 from Vonng/master | 未合并 |
| Issue #91 | @xiekeyi98 | 事务处理还是分析,语句不通顺问题。 | 已关闭 |
| Issue #90 | @q00218426 | ch4.md 一处翻译错误 | 已关闭 |
| Issue #89 | @brucevoin | 建议将第一章的可扩展性修改为可伸缩性 | 已关闭 |
| PR #88 | @kemingy | fix typo for ch1, ch2, ch3, ch4 | 已合并 |
| PR #87 | @wynn5a | Update ch3.md | 未合并 |
| PR #86 | @northmorn | Update ch1.md | 已合并 |
| PR #85 | @sunbuhui | fix ch2.md: fix ch2 ambiguous translation | 已合并 |
| PR #84 | @ganler | Fix translation: use up | 已合并 |
| PR #83 | @afunTW | Using OpenCC to convert from zh-cn to zh-tw | 已合并 |
| PR #82 | @kangni | fix gitbook url | 已合并 |
| Issue #81 | @atlas927 | gitbook无法打开了 | 已关闭 |
| Issue #80 | @l1t1 | suggest to reduce the picture size | 已关闭 |
| Issue #79 | @TrafalgarRicardoLu | GitHub不支持公式,能否将数学符号转为图片显示 | 已关闭 |
| PR #78 | @hanyu2 | Fix unappropriated translation | 已合并 |
| PR #77 | @Ozarklake | fix typo | 已合并 |
| Issue #76 | @Stephan14 | 图片看不到 | 已关闭 |
| PR #75 | @2997ms | Fix typo | 未合并 |
| PR #74 | @2997ms | Update ch9.md | 未合并 |
| Issue #73 | @vult137 | 第四章的错误翻译 | 已关闭 |
| Issue #72 | @tooloudwind | 疑問:原作者或出版社是否反對這裡的翻譯? | 已关闭 |
| Issue #71 | @huiscool | 建议把第四章 message broker 从 '消息掮客' 译为 '消息代理' | 已关闭 |
| PR #70 | @2997ms | Update ch7.md | 已合并 |
| Issue #69 | @NIL-zhuang | 错误的引用格式 | 已关闭 |
| Issue #68 | @walshzhang | 将 REST 的翻译改为 表述性状态传递 更为确切 | 已关闭 |
| PR #67 | @jiajiadebug | fix issues in ch2 - ch9 and glossary | 已合并 |
| PR #66 | @blindpirate | Fix typo | 已合并 |
| Issue #65 | @jasonlei-chn | MarkDown 粗字体未转换 | 已关闭 |
| Issue #64 | @woodpenker | 第十章似乎存在翻译错误–重复语句 | 已关闭 |
| PR #63 | @haifeiWu | Update ch10.md | 已合并 |
| PR #62 | @ych | fix ch1.md typesetting problem | 已合并 |
| PR #61 | @xianlaioy | docs:钟–>种,去掉ou | 已合并 |
| PR #60 | @Zombo1296 | 否则 -> 或者 | 已合并 |
| PR #59 | @brynne8 | 呼叫->调用,显着->显著 | 已合并 |
| PR #58 | @ibyte2011 | Update ch8.md | 已合并 |
| Issue #57 | @meijies | [第二部分]分布式系统 – 参考文献小节中的第一个参考文献What Every Programmer Should Know About Memory指向的链接错误 | 已关闭 |
| Issue #56 | @amber-moe | 生成pdf | 已关闭 |
| PR #55 | @saintube | ch8: 修改链接错误 | 已合并 |
| PR #54 | @Panmax | Update ch2.md | 已合并 |
| PR #53 | @ibyte2011 | Update ch9.md | 未合并 |
| PR #52 | @hecenjie | Update ch1.md | 已合并 |
| PR #51 | @qig243 | fix 修正ch3 ch4几处翻译 | 已合并 |
| PR #50 | @AlexZFX | 几个疏漏和格式错误 | 已合并 |
| PR #49 | @haifeiWu | Update ch1.md | 已合并 |
| PR #48 | @scaugrated | fix typo | 已合并 |
| PR #47 | @lzwill | Fixed typos in ch2 | 已合并 |
| Issue #46 | @afredlyj | 书上的图怎么搞下来的? | 已关闭 |
| PR #45 | @zenuo | 删除一个多余的右括号 | 已合并 |
| PR #44 | @akxxsb | 修正第7章底部链接错误 | 未合并 |
| PR #43 | @baijinping | "更假简单"->"更加简单" | 已合并 |
| PR #42 | @tisonkun | 修复 ch1 中的无序列表格式 | 未合并 |
| Issue #41 | @shiyiwan | 第10章到第11章的导航链接错误 | 已关闭 |
| Issue #40 | @b7woreo | 第十一章 传递事件流 部分有重复内容 | 已关闭 |
| Issue #39 | @lllliuliu | 第七章到第八章的导航链接错了 | 已关闭 |
| PR #38 | @b7woreo | 纠正多处的翻译小错误 | 已合并 |
| PR #37 | @tankilo | fix translation mistakes in ch4.md | 未合并 |
| PR #36 | @wwek | 1.修复多个链接错误 2.名词优化修订 3.错误修订 | 已合并 |
| PR #35 | @wwek | fix ch7.md to ch8.md link error | 未合并 |
| PR #34 | @wwek | Merge pull request #1 from Vonng/master | 未合并 |
| PR #33 | @wwek | fix part-ii.md link error | 已合并 |
| PR #32 | @JCYoky | Update ch2.md | 已合并 |
| PR #31 | @elsonLee | Update ch7.md | 已合并 |
| Issue #30 | @undeflife | 第七章可商榷的地方 | 已关闭 |
| Issue #29 | @nevertiree | 希望能推出Release版本 | 已关闭 |
| Issue #28 | @krisjin | 刚刚出版的不是该翻译的版本吗 | 已关闭 |
| Issue #27 | @lqbilbo | 每章最后的导航链接都错了 | 已关闭 |
| PR #26 | @yjhmelody | 修复一些明显错误 | 已合并 |
| PR #25 | @lqbilbo | 修复链接错误 | 已合并 |
| PR #24 | @artiship | 修改词语顺序 | 已合并 |
| PR #23 | @artiship | 修正错别字 | 已合并 |
| PR #22 | @artiship | 纠正翻译错误 | 已合并 |
| PR #21 | @zhtisi | 修正目录和本章标题不符的情况 | 已合并 |
| PR #20 | @rentiansheng | Update ch7.md | 已合并 |
| PR #19 | @LHRchina | 修复语句小bug | 已合并 |
| Issue #18 | @patricksuo | 非常感谢翻译,但是会不会有版权问题? | 已关闭 |
| Issue #17 | @KevinZhangt | [建议] GitBook 增加下载功能 | 已关闭 |
| PR #16 | @MuAlex | Master | 已合并 |
| PR #15 | @cg-zhou | Update translation progress | 未合并 |
| PR #14 | @cg-zhou | Translate glossary | 已合并 |
| PR #13 | @cg-zhou | 详细修改了后记中和印度野猪相关的描述 | 已合并 |
| PR #12 | @ibyte2011 | 修改了部分翻译 | 未合并 |
| PR #11 | @jiajiadebug | ch2 100% | 已合并 |
| PR #10 | @jiajiadebug | ch2 20% | 已合并 |
| PR #9 | @jiajiadebug | Preface, ch1, part-i translation minor fixes | 已合并 |
| Issue #8 | @cch123 | QRCode expired | 已关闭 |
| PR #7 | @MuAlex | Ch6 translation pull request | 已合并 |
| PR #6 | @MuAlex | Ch6 change version1 | 已合并 |
| PR #5 | @nevertiree | Chapter 01语法微调 | 已合并 |
| Issue #4 | @nevertiree | GitBook | 已关闭 |
| Issue #3 | @mawenqi | 表3-1标题行的OLTP和OLAP位置反了 | 已关闭 |
| PR #2 | @seagullbird | 序言初翻 | 已合并 |
| Issue #1 | @smallyard | 加油,期待你的完成 | 已关闭 |